ترميم أغاني الذكاء الاصطناعي بأداة رفع جودة الصوت
لإصلاح جودة الصوت في أغاني الذكاء الاصطناعي، أصلحوا المصدر قبل الماسترينغ. تعيد أداة رفع جودة الصوت بالذكاء الاصطناعي بناء الترددات العالية المفقودة وتقلل تشوهات الضغط، ويتيح فصل المسارات إصلاح الغناء أو الطبول أو الباص وحده حين تكون المشكلة في طبقة واحدة.
يمكن لمولّدات الموسيقى بالذكاء الاصطناعي تقديم لازمة جذابة وتوزيع مقنع، لكن جودة الصوت كثيرا ما تكون أقل من المطلوب. عبر سماعات الرأس أو سماعات المراقبة في الاستوديو، تسمعون الفارق في آخر 20%: هسيس في الترددات العالية، غناء معدني، هاي هات حاد، باص ضعيف، تداخل ذيول الصدى، أو قطع للترددات العالية يجعل الأغنية تبدو أقل امتلاء من الإصدارات التجارية.
يوضح هذا الدليل كيفية استخدام ترميم الصوت بالذكاء الاصطناعي مع الأغاني المولّدة بالذكاء الاصطناعي. استوردوا الأغنية، ورمّموا المزيج الكامل إذا كان المصدر كله متضررا، وافصلوا المسارات إذا كانت المشكلة في طبقة واحدة، ثم طبّقوا الماسترينغ على النسخة الأنقى وصدّروا WAV أو FLAC.
للبدء بسرعة، استخدموا أداة رفع جودة الصوت لأغاني الذكاء الاصطناعي. ولأغاني Suno، راجعوا أيضا كيفية تحسين جودة صوت Suno AI.

استمعوا: قبل ترميم أغنية الذكاء الاصطناعي وبعده
يوضح المثال أدناه عيبا شائعا في الموسيقى المولّدة بالذكاء الاصطناعي: الأغنية قابلة للاستخدام، لكن الترددات العالية غير مستقرة. يظهر في الأصل قطع واضح ونطاق علوي غير متوازن. في النسخة المرمّمة، يمتد الطيف إلى ترددات أعلى وتصبح الترددات العالية أسهل في الماسترينغ.
استخدموه مرجعا لما ينبغي أن يحققه الترميم. الهدف ليس أغنية أعلى صوتا فحسب، بل مصدر أكثر اكتمالا قبل تطبيق EQ أو الضغط أو تحديد الذروة أو ماسترينغ Match EQ.
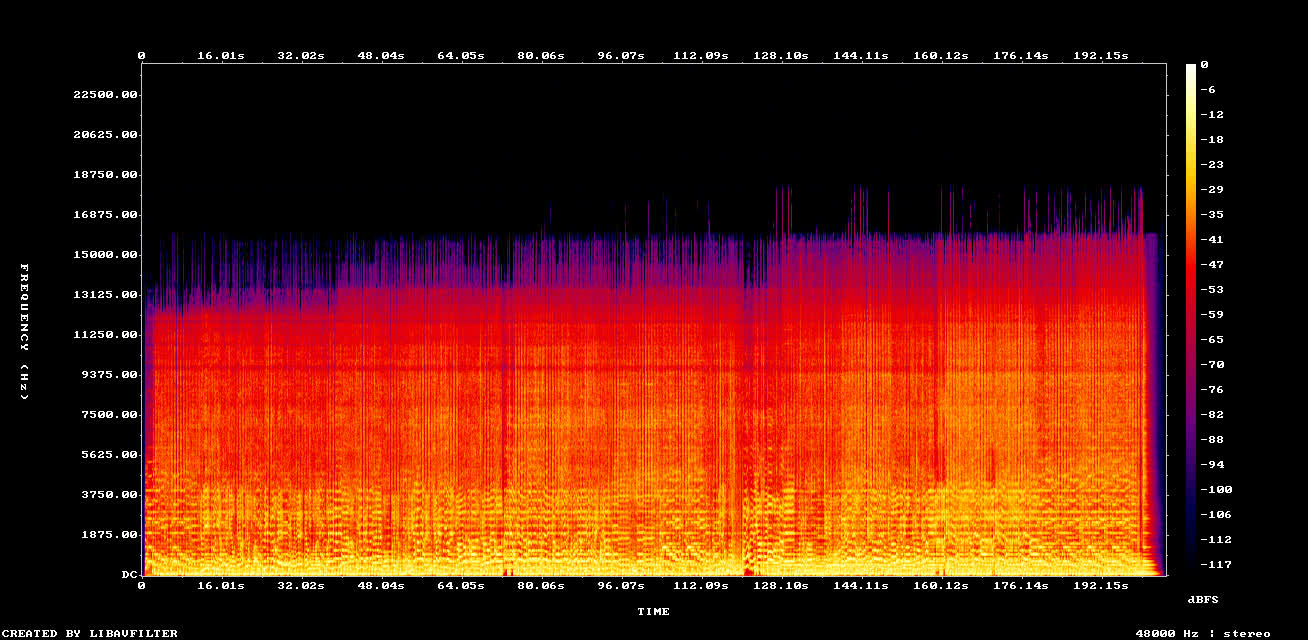
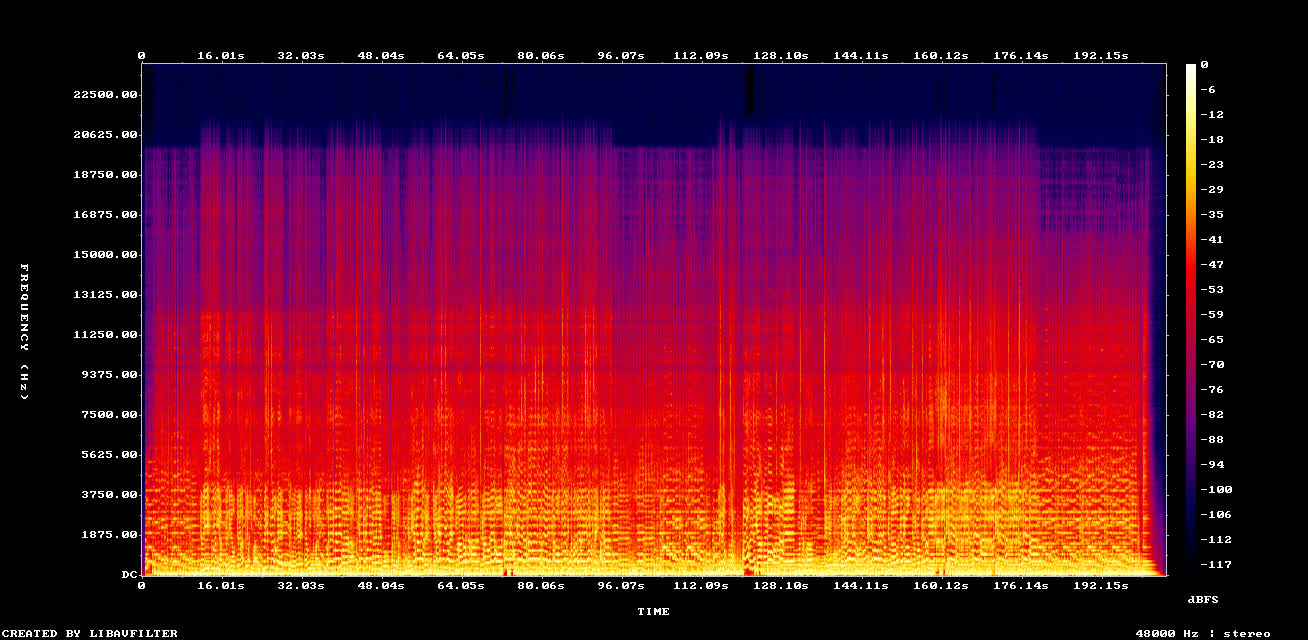
مثال: هاي هات أنعم وترددات منخفضة أغنى في أغنية ذكاء اصطناعي كاملة
ماذا تفعل أداة رفع جودة الصوت بالذكاء الاصطناعي فعليا؟
لا ترفع أداة تحسين جودة الصوت بالذكاء الاصطناعي مستوى الصوت فحسب. بل تحلل المصدر المتضرر وتتنبأ بالمعلومات الموسيقية المفقودة. في الأغاني المولّدة بالذكاء الاصطناعي، يتمثل الإصلاح الأساسي في توسيع عرض النطاق، أي إعادة بناء الترددات العالية المفقودة، وتقليل التشوهات، ليبدأ الماسترينغ من ملف أنقى.
يعرض هذا الدليل المصور القصير الأداة وهي تعالج أغنية Suno v6: تعود الترددات العالية المفقودة ويختفي الهسيس. لسير العمل الكامل مسارا بمسار، راجعوا كيفية تحسين جودة صوت Suno AI.

تصلح نماذج الترميم المختلفة أنواعا مختلفة من الضرر:
- تعيد نماذج ترميم الموسيقى، مثل ترميم موسيقى MP3 وUniverSR وAudioSR، بناء المحتوى المفقود في الترددات العالية وتقلل تشوهات الضغط.
- تزيل مؤثرات التنقية القائمة على الفصل، مثل تقليل الضجيج وإزالة الصدى وإزالة الضجيج والتسرّب وتصحيح التشبّع (Declip) والإبقاء على المركز الأحادي فقط، عيبا محددا دون محاولة إعادة صنع الأغنية. لاستخدام إزالة الضجيج والتسرّب، اختاروا تقليل الضجيج، ثم اختاروا ذلك المتغير ضمن النموذج.
- نماذج الصوت البشري، مثل تحسين الكلام - RE-USE وترميم الغناء بصيغة MP3، مخصصة للمادة الصوتية البشرية المعزولة، وليست للمزيج الكامل.
- نماذج إعادة المزج العصبية، مثل ACEStep 1.5 XL وStable Audio 3، نماذج توليدية. استخدموها عندما يحتاج المسار إلى إعادة بناء أو أداء جديد، ثم امزجوا النتيجة بالأصل عند الحاجة.
تعمل نماذج الدقة الفائقة عادة بالاعتماد على النطاقين المنخفض والمتوسط القابلين للاستخدام، ثم توليد محتوى معقول فوق تردد قطع تختارونه. تردد القطع الأقل يغيّر جزءا أكبر من الصوت. أما الأعلى فيحافظ على قدر أكبر من الأصل ويملأ النطاق العلوي فقط. الطبول ذات الصنوج الحادة، والغناء الذي يفتقد الإحساس بالهواء، والمزيج الكامل المقطوع عند 12 kHz، يحتاج كل منها إلى تردد قطع مختلف.
| المشكلة في أغنية الذكاء الاصطناعي | ما يفعله نموذج الترميم | نقطة بدء مناسبة في Neural Analog |
|---|---|---|
| ترددات عالية مفقودة | يعيد بناء التفاصيل التوافقية فوق تردد القطع | أمثلة ترميم موسيقى MP3، أمثلة UniverSR، أمثلة AudioSR |
| غناء ذكاء اصطناعي معدني | يفصل الغناء ويستخدم ترميم الصوت البشري أو إزالة الصدى بدلا من تفتيح المزيج الكامل | أمثلة نموذج RE-USE، أمثلة مسارين |
| صدى مفرط | يزيل الذيول الطويلة بعد عزل الغناء أو الآلة التي تداخلت أصواتها | أمثلة إزالة الصدى، إزالة الصدى |
| هسيس أو طقطقة أو تشبّع | يستخدم إزالة الضجيج أو تصحيح التشبّع فقط عند وجود ذلك العيب فعليا | أمثلة تقليل الضجيج، أمثلة تصحيح التشبّع (Declip) |
| باص ضعيف أو ترددات منخفضة متداخلة | يفصل المسارات أولا، ثم يصلح الباص والطبول كلّا على حدة باستخراج المركز أو EQ أو إعادة المزج العصبية بدلا من تحسين الترددات العالية | أمثلة 6 مسارات، أمثلة ACEStep |
| جهارة غير كافية | يرمّم المصدر المتضرر أولا، ثم يستخدم الماسترينغ للجهارة والتوازن النغمي | أمثلة الماسترينغ بالذكاء الاصطناعي، الماسترينغ التلقائي |
| مزيج مكتوم لكنه قابل للاستخدام | يرمّم المصدر ثم يطبّق الماسترينغ على النسخة الأنقى | الماسترينغ بالذكاء الاصطناعي، Match EQ |
يأتي الترميم قبل اللمسات النهائية. إذا كانت معلومات المصدر مفقودة، فلا يستطيع الماسترينغ استعادتها. يمكن للماسترينغ جعل أغنية الذكاء الاصطناعي المرمّمة أعلى صوتا وأوسع وأكثر توازنا، لكنه لا يستطيع ابتكار الطيف المفقود.
لماذا تبدو أغاني الذكاء الاصطناعي مكتومة أو معدنية أو مليئة بالهسيس؟
تبدأ معظم مشكلات جودة أغاني الذكاء الاصطناعي في المصدر الصوتي، لا في المزيج.
كثيرا ما تُخرج مولّدات الموسيقى بالذكاء الاصطناعي صوتا مضغوطا أو محدود النطاق أو مليئا بالتشوهات. لبعض الأغاني تردد قطع في حدود 12 kHz إلى 16 kHz. وفي غيرها لمعان علوي غير طبيعي وصنوج حادة هشة وتشوهات في الغناء تزداد سوءا عند تفتيح المزيج. قد يكون التأليف جيدا، لكن الملف المصدّر يفتقر إلى الطيف النقي وتفاصيل الهجمات الصوتية في أغنية مسجلة احترافيا.
تشمل الأعراض الشائعة:
- هسيس أو طقطقة أو ضجيج ساكن حول الغناء والصنوج
- غناء معدني أو أجوف أو آلي
- هاي هات حاد يطغى على بقية الأغنية
- باص ضعيف يختفي عبر السماعات الصغيرة
- ذيول صدى تتداخل مع الغناء
- نطاق علوي مكتوم يفتقد الإحساس بالهواء فوق تردد القطع
- مقاطع لازمة تنهار إلى كتلة صوتية واحدة مشوشة
- أغنيات تبدو أسوأ بعد الماسترينغ المعتاد
الحل هو إصلاح المصدر أولا، ثم إجراء الماسترينغ.
الفرق بين رفع جودة الصوت وتحسينه والماسترينغ بالذكاء الاصطناعي
تُستخدم هذه المصطلحات كثيرا بالتبادل، لكنها تحل مشكلات مختلفة.
أداة رفع جودة الصوت بالذكاء الاصطناعي: تعيد بناء المحتوى الترددي المفقود وتصلح المصدر منخفض الجودة. استخدموها أولا عندما تكون الأغنية المولّدة بالذكاء الاصطناعي مكتومة أو معدنية أو متضررة من الضغط أو مقطوعة الترددات العالية.
أداة تحسين الصوت بالذكاء الاصطناعي: عادة أداة أوسع نطاقا تزيل الضجيج أو تسوّي مستوى الصوت أو تحسّن وضوح الكلام. تُضبط أدوات تحسين كثيرة للتسجيلات الصوتية البشرية أو البودكاست أو حوار الفيديو بدلا من المزيج الموسيقي الكامل.
الماسترينغ بالذكاء الاصطناعي: يعدّل الجهارة وEQ وعرض الستيريو والضغط والتوازن النغمي النهائي. استخدموه بعد الترميم. إذا كان ملف الذكاء الاصطناعي الخام يحتوي على هسيس أو طقطقة، فقد يجعل الماسترينغ أولا هذه التشوهات أعلى صوتا. راجعوا الفرق بين رفع الجودة وماسترينغ أغاني الذكاء الاصطناعي.
إزالة الضجيج بالذكاء الاصطناعي: تزيل الضجيج أو الهسيس، لكنها ليست تقنية دقة صوت فائقة. إذا كان النطاق العلوي مفقودا، فإن إزالة الضجيج وحدها تجعل الأغنية أنقى لكنها أقل امتلاء.
لماذا لا تصلح EQ وإزالة الضجيج وتحويل MP3 إلى WAV أغاني الذكاء الاصطناعي؟
تساعد الحلول التقليدية قليلا، لكنها لا تصلح المصدر المتضرر.
تحويل MP3 إلى WAV يغيّر صيغة الملف ويزيد حجمه. لا يستعيد الطيف: تبقى الفجوة الداكنة في المخطط الطيفي داكنة. راجعوا لماذا لا يحسن تحويل MP3 إلى WAV الجودة لمقارنة المخططات الطيفية.
EQ يمكن أن يفتح صوت الأغنية، لكنه يفتح التشوهات أيضا. إذا كانت الصنوج أو صفير الحروف في الغناء أو لمعان الذكاء الاصطناعي متضررة أصلا، فإن رفع الترددات بمرشح رف علوي يجعلها أوضح.
أدوات إزالة الضجيج العامة قد تقلل الهسيس، لكنها قد تزيل أيضا الإحساس بالهواء في الغناء ونسيج الصنوج وصوت الغرفة. إذا كانت الأغنية تفتقد تفاصيل الترددات العالية، فقد تجعلها إزالة الضجيج وحدها تبدو أقل امتلاء.
سير العمل القائم على الماسترينغ وحده يجعل الأغنية أعلى صوتا وأكثر توازنا، لكنه يرفع أيضا الطقطقة والهسيس والنبرة المعدنية. يعمل الماسترينغ بأفضل شكل بعد الترميم.
أزرار إعادة الماسترينغ بنقرة واحدة مريحة، لكنها عادة لا توفر تحكما على مستوى المسارات المنفصلة. إذا كان الغناء معدنياً والطبول سليمة، فعليكم عزل الغناء ومعالجته بدلا من تطبيق إعداد مسبق عام واحد على المزيج الكامل.
سير عمل رفع جودة الصوت بالذكاء الاصطناعي خطوة بخطوة
الخطوة 1: استيراد أغنية الذكاء الاصطناعي
ابدؤوا باستيراد الأغنية إلى Neural Analog. يمكنكم رفع ملف أو لصق رابط مصدر عام مدعوم. تشمل صيغ الإدخال الشائعة MP3 وWAV وM4A وMP4 وFLAC وAIFF وAAC وOGG وOPUS وWMA وALAC. إذا كان مولّد الموسيقى بالذكاء الاصطناعي يوفر تنزيل WAV، فابدؤوا به بدلا من MP3.
قبل اختيار نموذج، استمعوا لتحديد موضع الضرر. إذا كانت الأغنية كلها مكتومة أو متضررة من الضغط أو مقطوعة النطاق، فابدؤوا بترميم الأغنية كاملة. إذا كان الغناء معدنياً أو الهاي هات متناثرا أو الباص متداخلا بينما بقية الأغنية قابلة للاستخدام، فافصلوا المسارات أولا وأصلحوا تلك الطبقة وحدها.
الخطوة 2: تشغيل ترميم الصوت بالذكاء الاصطناعي
استخدموا ترميم موسيقى MP3 أولا عندما تبدو أغنية الذكاء الاصطناعي مضغوطة أو مكتومة أو كأنها من مصدر منخفض الجودة عبر الإنترنت. إنه مصمم للموسيقى وخيار افتراضي جيد لملفات أغاني الذكاء الاصطناعي الكاملة ذات الضرر المشابه لضغط MP3. يوضح دليل البدء بتحسين الصوت موضع كل نموذج ترميم في Studio.
لإعادة بناء أقوى للترددات العالية، جرّبوا UniverSR أو AudioSR. تساعد نماذج الدقة الفائقة هذه عندما يكون في الأغنية تردد قطع واضح أو نطاق علوي مكتوم. للاختيار بينهما، راجعوا كيف يختلف UniverSR عن AudioSR، أو ثبّتوا AudioSR وشغّلوه من GitHub إذا أردتم تشغيله على وحدة GPU الخاصة بكم. قارنوا الأمثلة المفلترة لـترميم موسيقى MP3 وUniverSR وAudioSR.
الخطوة 3: فصل المسارات لإصلاح محدد
إذا كانت الأغنية كلها مكتومة، فرمموا المزيج الكامل. إذا كانت طبقة واحدة متضررة، فافصلوا المسارات أولا.
استخدموا فصل المسارات بالذكاء الاصطناعي أو أمثلة فصل 6 مسارات لعزل الغناء والطبول والباص والغيتار والبيانو والآلات الأخرى. ثم عالجوا المسار المتضرر وحده. لاختيار أفضل نموذج لكل مسار، راجعوا فصل المسارات بالذكاء الاصطناعي بجودة عالية باستخدام BS-RoFormer وSAM Audio ودليل البدء بفصل المسارات.
- الغناء المعدني: اعزلوا الغناء، ثم قارنوا تحسين الكلام - RE-USE وترميم الغناء بصيغة MP3 وإزالة الصدى وتقليل الضجيج وفقا للعيب
- الطبول الحادة: اعزلوا الطبول، ثم قارنوا UniverSR أو AudioSR لعرض نطاق الصنوج، وإعادة البناء العصبية للهاي هات الإلكتروني الغريب، وتصحيح التشبّع (Declip) للهجمات الصوتية المتكسرة
- الباص الضعيف: اعزلوا الباص، ثم استخدموا الإبقاء على المركز الأحادي فقط لمشكلات الصوت الأحادي أو الطور، أو ACEStep 1.5 XL عندما يحتاج الجزء إلى إعادة بناء توليدية للترددات المنخفضة
- مقاطع اللازمة المزدحمة: افصلوا إلى 6 مسارات قبل المعالجة المكثفة، كي لا تفرض الطبقة المتضررة إعدادا مسبقا عاما على المزيج كله
بهذا تصلحون الطبقة التي تسبب المشكلة بدلا من تفتيح المزيج الكامل.
الخطوة 4: تنقية الصدى والهسيس والطقطقة
تحمل بعض أصوات الغناء بالذكاء الاصطناعي صدى أو تأخيرا أكثر من اللازم. وتحمل بعض المزائج الكاملة هسيسا وطقطقة في النطاق العلوي. استخدموا ترميما موجّها:
- إزالة الصدى عندما تكون ذيول الغناء أو الآلات غير منتظمة
- أمثلة تقليل الضجيج عندما تكون المشكلة الأساسية ضجيجا ساكنا أو هسيسا
- أمثلة UniverSR عندما تبدو المشكلة كهسيس أو طقطقة في النطاق العلوي للملف المصدّر، أو ترددات عالية معدنية، أو لمعان غير طبيعي من الذكاء الاصطناعي
افحصوا النسخة المرمّمة قبل إزالة الضجيج بقوة. الإفراط في إزالة الضجيج يزيل تفاصيل الترددات العالية التي تحاولون استعادتها.
الخطوة 5: ماسترينغ النسخة الأنقى
بعد أن يصبح المصدر والمسارات أنقى، طبّقوا الماسترينغ على الأغنية. استخدموا الماسترينغ التلقائي أو Match EQ لتقريب التوازن من مرجع. لاختيار هدف الجهارة، راجعوا أفضل LUFS لماسترينغ أغاني Suno والذكاء الاصطناعي.
الترتيب مهم. يمنح الترميم الماسترينغ مدخلا أفضل، ويمنح الماسترينغ الأغنية المرمّمة جهارتها النهائية وتوازنها النغمي وقدرتها على الحفاظ على صوت متسق عبر سماعات الرأس والهواتف والسماعات.
إذا تجاوزتم الترميم وطبّقتم الماسترينغ على ملف الذكاء الاصطناعي الخام، فقد يرفع محدد الذروة الهسيس، وقد يبالغ EQ في إبراز الترددات العالية المعدنية، فتبدو الأغنية مشرقة لكنها تبقى منخفضة الجودة.
الخطوة 6: تصدير WAV أو FLAC من الصوت المحسّن
عندما تصبح الأغنية جاهزة، صدّروا WAV أو FLAC. لا يحوّل ذلك ملف MP3 الأصلي المولّد بالذكاء الاصطناعي إلى مصدر دون فقدان بيانات. بل يحفظ النسخة المعالجة، بما فيها الترددات التي أُعيد بناؤها والمسارات الأنقى والماسترينغ، دون إضافة جولة أخرى من الضغط بفقدان البيانات.
استخدموا الملف المصدّر للتحرير في DAW أو مزامنة الفيديو أو التحضير للتوزيع أو أرشفة النسخة المحسّنة.
دليل الترميم مسارا بمسار
يُرتب محدد الترميم وفقا لما يُسمح للنموذج بفعله: ترميم الموسيقى للترميم الذي يحافظ على الأغنية، والمؤثرات الصوتية للتنقية المحددة، والصوت البشري للكلام أو الغناء المعزول، وإعادة المزج بالذكاء الاصطناعي لإعادة البناء التوليدية. ابدؤوا بأقل مجموعة تدخلا إبداعيا تستطيع حل المشكلة. انتقلوا إلى إعادة المزج بالذكاء الاصطناعي فقط عندما يحتاج المسار إلى إعادة صنع، لا إلى تنقية فحسب.
كيفية ترميم أغنية ذكاء اصطناعي كاملة
رمّموا أغنية الذكاء الاصطناعي كاملة عندما تبدو الأغنية كلها متضررة من الضغط أو محدودة النطاق أو أقل امتلاء مما يفترض أن يقدمه التوزيع. في مجموعة ترميم الموسيقى، ابدؤوا بـترميم موسيقى MP3 لضرر يشبه MP3 وتشوهات المصادر عبر الإنترنت والترددات العالية المفقودة فوق 16 kHz وضرر الضغط العام. إنه الخيار الأكثر أمانا للمعالجة الأولى لأنه دُرّب على أزواج من الموسيقى النقية ونسخ MP3 المتدهورة، فيصلح المصدر دون إعادة كتابة الأغنية.
إذا أظهر المخطط الطيفي تردد قطع واضحا أو بقيت الأغنية تبدو مقطوعة النطاق بعد ترميم موسيقى MP3، فقارنوا UniverSR وAudioSR. يكون UniverSR عادة الخيار الأنقى لإعادة بناء نطاق علوي متماسك في الموسيقى والصوت البشري والمؤثرات الصوتية، كما في مؤثرات RPG Maker 2000 الصوتية المرمّمة إلى 48 kHz باستخدام UniverSR. يفيد AudioSR عندما تريدون إعادة توليد أقوى للنطاق العلوي فوق تردد قطع محدد. استخدموا تردد قطع أعلى عندما تكون الأغنية جيدة في معظمها ولا تحتاج إلا إلى الإحساس بالهواء. واستخدموا تردد قطع أقل عندما يكون النطاق العلوي متضررا بشدة وتقبلون تغييرا أكبر.
لا تستخدموا نماذج مخصصة للصوت البشري وحده على المزيج الكامل. ولا تستخدموا إعادة مزج عصبية موجهة للباص لإصلاح ماستر كامل إلا إذا أردتم أداء بديلا إبداعيا. إذا كان المزيج الكامل يحتوي فعليا على تشبّع، فاستخدموا تصحيح التشبّع (Declip) قبل الماسترينغ. وإذا كان في المزيج كله هسيس واسع النطاق، فاستخدموا تقليل الضجيج بحذر، ثم قارنوا ما إذا كانت الأغنية قد فقدت قدرا مفرطا من الإحساس بالهواء.
كيفية ترميم غناء الذكاء الاصطناعي
رمّموا غناء الذكاء الاصطناعي بعد فصل مسار الغناء. قد يساعد ترميم المزيج الكامل ماسترا مكتوما، لكنه لا يستطيع فصل النبرة المعدنية في الغناء عن الصنوج والآلات المركّبة والصدى. بعد عزل الغناء، استخدموا مجموعة الصوت البشري عندما تكون المشكلة خاصة بالغناء. يناسب تحسين الكلام - RE-USE الحالة التي يحتاج فيها الغناء إلى صدى أقل ووضوح أكبر وضجيج أو تقطّع أقل. ويكون ترميم الغناء بصيغة MP3 أنسب عندما يحتاج مسار الغناء المعزول أساسا إلى استعادة الترددات العالية المفقودة وإصلاح تشوهات الضغط. قارنوه بـأمثلة نموذج RE-USE قبل اعتماد معالجة الغناء.
إذا كان الغناء مطمورا في ذيول طويلة، فاستخدموا إزالة الصدى قبل رفع جودة الغناء أو بعده بحسب التشوه. إزالة الصدى مخصصة للارتداد الطويل والتأخير وصدى القاعات، وليست أداة لتحسين الترددات العالية. إذا كان في الغناء هسيس ثابت أو ضجيج خلفي، فاستخدموا تقليل الضجيج برفق وانتبهوا لأي فقدان في تفاصيل النفس والحروف الساكنة. إذا بدا الغناء معدنياً لأن النطاق العلوي كله مفقود، يمكن تجربة نموذج دقة فائقة للموسيقى، لكن ينبغي عادة أن تكون المقارنة الصوتية الأولى مع RE-USE أو ترميم الغناء بصيغة MP3.
كيفية ترميم طبول الذكاء الاصطناعي
رمّموا طبول الذكاء الاصطناعي بعد فصل مسار الطبول عندما تكون الصنوج أو الهاي هات أو السناير أو الهجمات الصوتية مصدر المشكلة. للهاي هات المتناثر أو الصنوج ذات القطع الواضح في الترددات العالية، قارنوا UniverSR وAudioSR. ابدؤوا بتردد قطع أعلى عندما تكون هجمات الطبول قابلة للاستخدام ولا تحتاج إلا إلى إحساس أنعم بالهواء. اخفضوا تردد القطع فقط عندما يكون نطاق الصنوج متضررا بشدة، لأن النموذج سيغيّر جزءا أكبر من نسيج الطبول.
للهاي هات الإلكتروني الغريب أو أنسجة الإيقاع الخارجة عن توزيع بيانات التدريب، قد تعمل إعادة البناء العصبية أفضل من أداة التحسين المعتادة، لأنها تعيد توليد الخصائص الترددية كاملة بدلا من ملء النطاق العلوي وحده. للسناير المتشبّع أو طبلة الركلة المشوهة أو الطقطقة الحادة في الهجمات، يكون تصحيح التشبّع (Declip) أنسب من AudioSR أو UniverSR. لا يفيد تقليل الضجيج إلا عندما يحتوي مسار الطبول على هسيس أو ضجيج خلفي فعلي. ولن يعيد بناء تفاصيل الصنوج المتضررة وحده. إذا كان جزء الطبول نفسه خاطئا، استبدلوا طبول الذكاء الاصطناعي بطقمكم الخاص بدلا من ترميمه.
كيفية ترميم الباص وطبلة الركلة بالذكاء الاصطناعي
ليست مشكلات الباص وطبلة الركلة عادة مشكلات تحسين الترددات العالية. إذا كان الباص عكرا أو يعاني مشكلات طور أو ضعيفا أو يفتقد وضوح النغمات، فإن AudioSR وUniverSR وFlashSR ليست عادة الأدوات الأولى المناسبة، لأنها مصممة لتوسيع النطاق وتفاصيل النطاق العلوي. ابدؤوا بفصل المسارات، ثم أصلحوا الباص والطبول كلّا على حدة، كي لا تُعالج الركلة والباص وهجمات الطبول كمزيج كامل متداخل واحد.
استخدموا الإبقاء على المركز الأحادي فقط عندما يفترض أن يكون الباص أو الركلة في المركز لكن فيه تأثير كورس أو فيزر أو فلانجر أو تداخل ستيريو. يحافظ هذا على المركز الأحادي ويزيل معلومات الجانبين التي تجعل الترددات المنخفضة غير مستقرة. بعد الفصل، عالجوا مسار الباص لمشكلات الصوت الأحادي أو الطور أو إعادة البناء، وعالجوا مسار الطبول بشكل منفصل لقوة الركلة أو التشبّع أو الهاي هات الحاد أو ضرر الهجمات. استخدموا ACEStep 1.5 XL عندما يحتاج الباص إلى إعادة بناء توليدية، مثل نغمات مفقودة أو ترددات منخفضة عكرة أو أداء جديد للجزء المنخفض يمكن مزجه تحت الأصل. يكون Stable Audio 3 أنسب عندما يحتاج نسيج الآلات إلى إعادة تفسير بتوجيه نصي، لا عندما تحتاجون فقط إلى تنقية الباص مع الحفاظ على أدائه.
كيفية ترميم الغيتار والبيانو والآلات المركّبة والآلات الأخرى
تحتاج مسارات الآلات إلى التشخيص نفسه الذي يحتاجه المزيج الكامل، لكن مع تأثيرات جانبية أقل على بقية الأصوات. لمسار غيتار أو بيانو أو آلة مركّبة أو أوتار أو «آلات أخرى» متضرر من الضغط، ابدؤوا بـترميم موسيقى MP3. إذا كان للآلة تردد قطع واضح في النطاق العالي، فقارنوا UniverSR أو AudioSR. قد يفيد FlashSR لتحسين آلة واحدة بسرعة أو تهيئة مسارات 44.1 kHz لسير عمل 48 kHz، لكنه ليس نموذج إصلاح للباص.
استخدموا إزالة الصدى عندما تتداخل الآلة بسبب ذيول طويلة. واستخدموا تقليل الضجيج أو إزالة الضجيج والتسرّب عندما يحتوي المسار على ضجيج خلفي أو تسرّب من مصدر آخر. لا تستخدموا نسخة بالذكاء الاصطناعي - ACEStep 1.5 XL أو Stable Audio 3 إلا عندما تحتاج الآلة إلى إعادة بناء موسيقية أو استكمال موضعي أو أداء بديل. هذا إصلاح إبداعي، لذا احتفظوا بالمسار الأصلي وامزجوا النسختين بدلا من استبداله تماما.
ترتيب استخدام محدد الترميم
استخدموا المحدد بهذا الترتيب:
- ترميم الموسيقى للمزيج الكامل ومسارات الموسيقى التي تحتاج إلى استعادة الترددات العالية أو إصلاح الضغط. قارنوا ترميم موسيقى MP3 وUniverSR وAudioSR.
- فصل المسارات عندما يتضرر الغناء أو الطبول أو الباص أو طبقة أخرى وحدها. راجعوا أمثلة 6 مسارات.
- الصوت البشري للغناء المعزول. قارنوا تحسين الكلام - RE-USE وترميم الغناء بصيغة MP3 وإزالة الصدى وتقليل الضجيج بحسب العيب.
- المؤثرات الصوتية لتشوه محدد: تقليل الضجيج للهسيس، وإزالة الصدى للذيول الطويلة، وتصحيح التشبّع (Declip) للطقطقة الناتجة عن الحمل الزائد، وإزالة الضجيج والتسرّب لتسرّب المصدر، والإبقاء على المركز الأحادي فقط للباص أو الركلة الأحادية.
- إعادة المزج بالذكاء الاصطناعي عندما لا يكفي الترميم المحافظ على الأصل ويحتاج الجزء إلى إعادة بناء. استخدموا ACEStep 1.5 XL للباص والنغمات المفقودة والاستكمال الموضعي للمسارات. واستخدموا Stable Audio 3 لإعادة تفسير أوسع للآلات بتوجيه نصي.
- الماسترينغ التلقائي أو Match EQ فقط بعد أن يصبح المصدر أنقى. راجعوا أمثلة الماسترينغ.
أسئلة شائعة عن رفع جودة الصوت بالذكاء الاصطناعي
ما أداة رفع جودة الصوت بالذكاء الاصطناعي؟
تستخدم أداة رفع جودة الصوت بالذكاء الاصطناعي نماذج ترميم صوت عصبية لتقدير المحتوى الترددي المفقود وتقليل تشوهات الضغط وتحسين الصوت منخفض الجودة قبل الماسترينغ أو التصدير. في أغاني الذكاء الاصطناعي، يعني هذا عادة استعادة الترددات العالية المفقودة وتقليل اللمعان المعدني وإنشاء نسخة WAV أو FLAC أنقى للإنتاج.
هل يختلف ترميم الصوت بالذكاء الاصطناعي عن الماسترينغ بالذكاء الاصطناعي؟
نعم. يصلح ترميم الصوت بالذكاء الاصطناعي المصدر بإعادة بناء التفاصيل المفقودة وتقليل التشوهات. أما الماسترينغ بالذكاء الاصطناعي فيعدّل مستوى الجهارة وEQ والديناميكيات وتوازن الستيريو بعد أن يصبح المصدر أنقى. إذا كانت الأغنية تحتوي أصلا على هسيس أو طقطقة أو تردد قطع، فينبغي إجراء الترميم أولا.
كيف تحسّنون جودة الصوت في أغاني الذكاء الاصطناعي؟
تعاملوا أولا مع الملف الذي صدّره مولّد الذكاء الاصطناعي بوصفه مصدرا صوتيا متضررا. أعيدوا بناء الترددات المفقودة باستخدام ترميم موسيقى MP3 أو AudioSR أو UniverSR، وافصلوا المسارات حين تكون المشكلة محصورة في الغناء أو الطبول أو الباص، ثم طبّقوا الماسترينغ على النسخة الأنقى.
هل يمكن تحسين أغاني الذكاء الاصطناعي بتحويل MP3 إلى WAV؟
لا. تحويل MP3 إلى WAV يغيّر صيغة الملف فقط. لا يعيد إنشاء المحتوى الترددي المفقود ولا يزيل تشوهات الضغط. استخدموا الترميم بالذكاء الاصطناعي قبل تصدير WAV.
هل يمكن إصلاح جودة أغاني الذكاء الاصطناعي باستخدام EQ وحده؟
يساعد EQ أحيانا، لكنه لا يستطيع إعادة إنشاء بيانات الصوت المفقودة. إذا كان في الأغنية تردد قطع أو لمعان معدني أو ضرر ضغط، فرمموا أولا واستخدموا EQ بعد ذلك.
هل ينبغي إجراء الترميم قبل الماسترينغ أم بعده؟
رمّموا قبل الماسترينغ. الماسترينغ هو اللمسة النهائية. إذا كان المصدر متضررا، يميل الماسترينغ إلى تضخيم التشوهات.
أي نموذج ينبغي أن تجرّبوا أولا؟
جرّبوا ترميم موسيقى MP3 أولا لمعظم أغاني الذكاء الاصطناعي التي تنزّلونها. إذا بقيت الأغنية تبدو مقطوعة في النطاق العلوي، فقارنوا AudioSR أو UniverSR. إذا كانت المشكلة في الغناء أو الطبول أو الباص، فافصلوا المسارات وعالجوا تلك الطبقة.
هل ترمّمون أغنية الذكاء الاصطناعي كاملة أولا أم تفصلون المسارات؟
رمّموا أغنية الذكاء الاصطناعي كاملة أولا عندما يتضرر المزيج كله من الضغط أو يبدو مكتوما أو مقطوع الترددات العالية. افصلوا المسارات أولا عندما تأتي المشكلة من طبقة واحدة، مثل الغناء المعدني أو الطبول المتناثرة أو الباص العكر.