تثبيت AudioSR من GitHub وتشغيله محليا
AudioSR نموذج مفتوح المصدر لرفع الدقة الصوتية. يولد التفاصيل عالية التردد المفقودة في الكلام والموسيقى والمؤثرات الصوتية لإنتاج صوت بمعدل أخذ عينات 48 kHz. يمكنكم تثبيته من مستودع GitHub الرسمي أو تشغيل AudioSR عبر الإنترنت مع Neural Analog.
للتثبيت المحلي، استنسخوا المستودع، وأنشئوا بيئة Python 3.10 باستخدام uv، وثبتوا إصدارا متوافقا من PyTorch وAudioSR، ثم شغلوا python -m audiosr على ملف WAV قصير. توضح الخطوات التالية كل أمر.
كيف يعمل AudioSR؟ شرح البنية
كيف يعيد AudioSR بناء الترددات العالية المفقودة
يستخدم الانتشار الكامن المخطط الطيفي mel للمُدخل كشرط لتقدير مخطط mel بنطاق ترددي أكمل. تحل نطاقات mel المنخفضة من المُدخل محل النطاقات المولدة قبل الفوكودر؛ وتحل نطاقات STFT المنخفضة منه محل النطاقات المولدة بعد الفوكودر. يولد النموذج تفاصيل مفقودة معقولة، ولا يستعيد تسجيلا مفقودا مطابقا تماما.
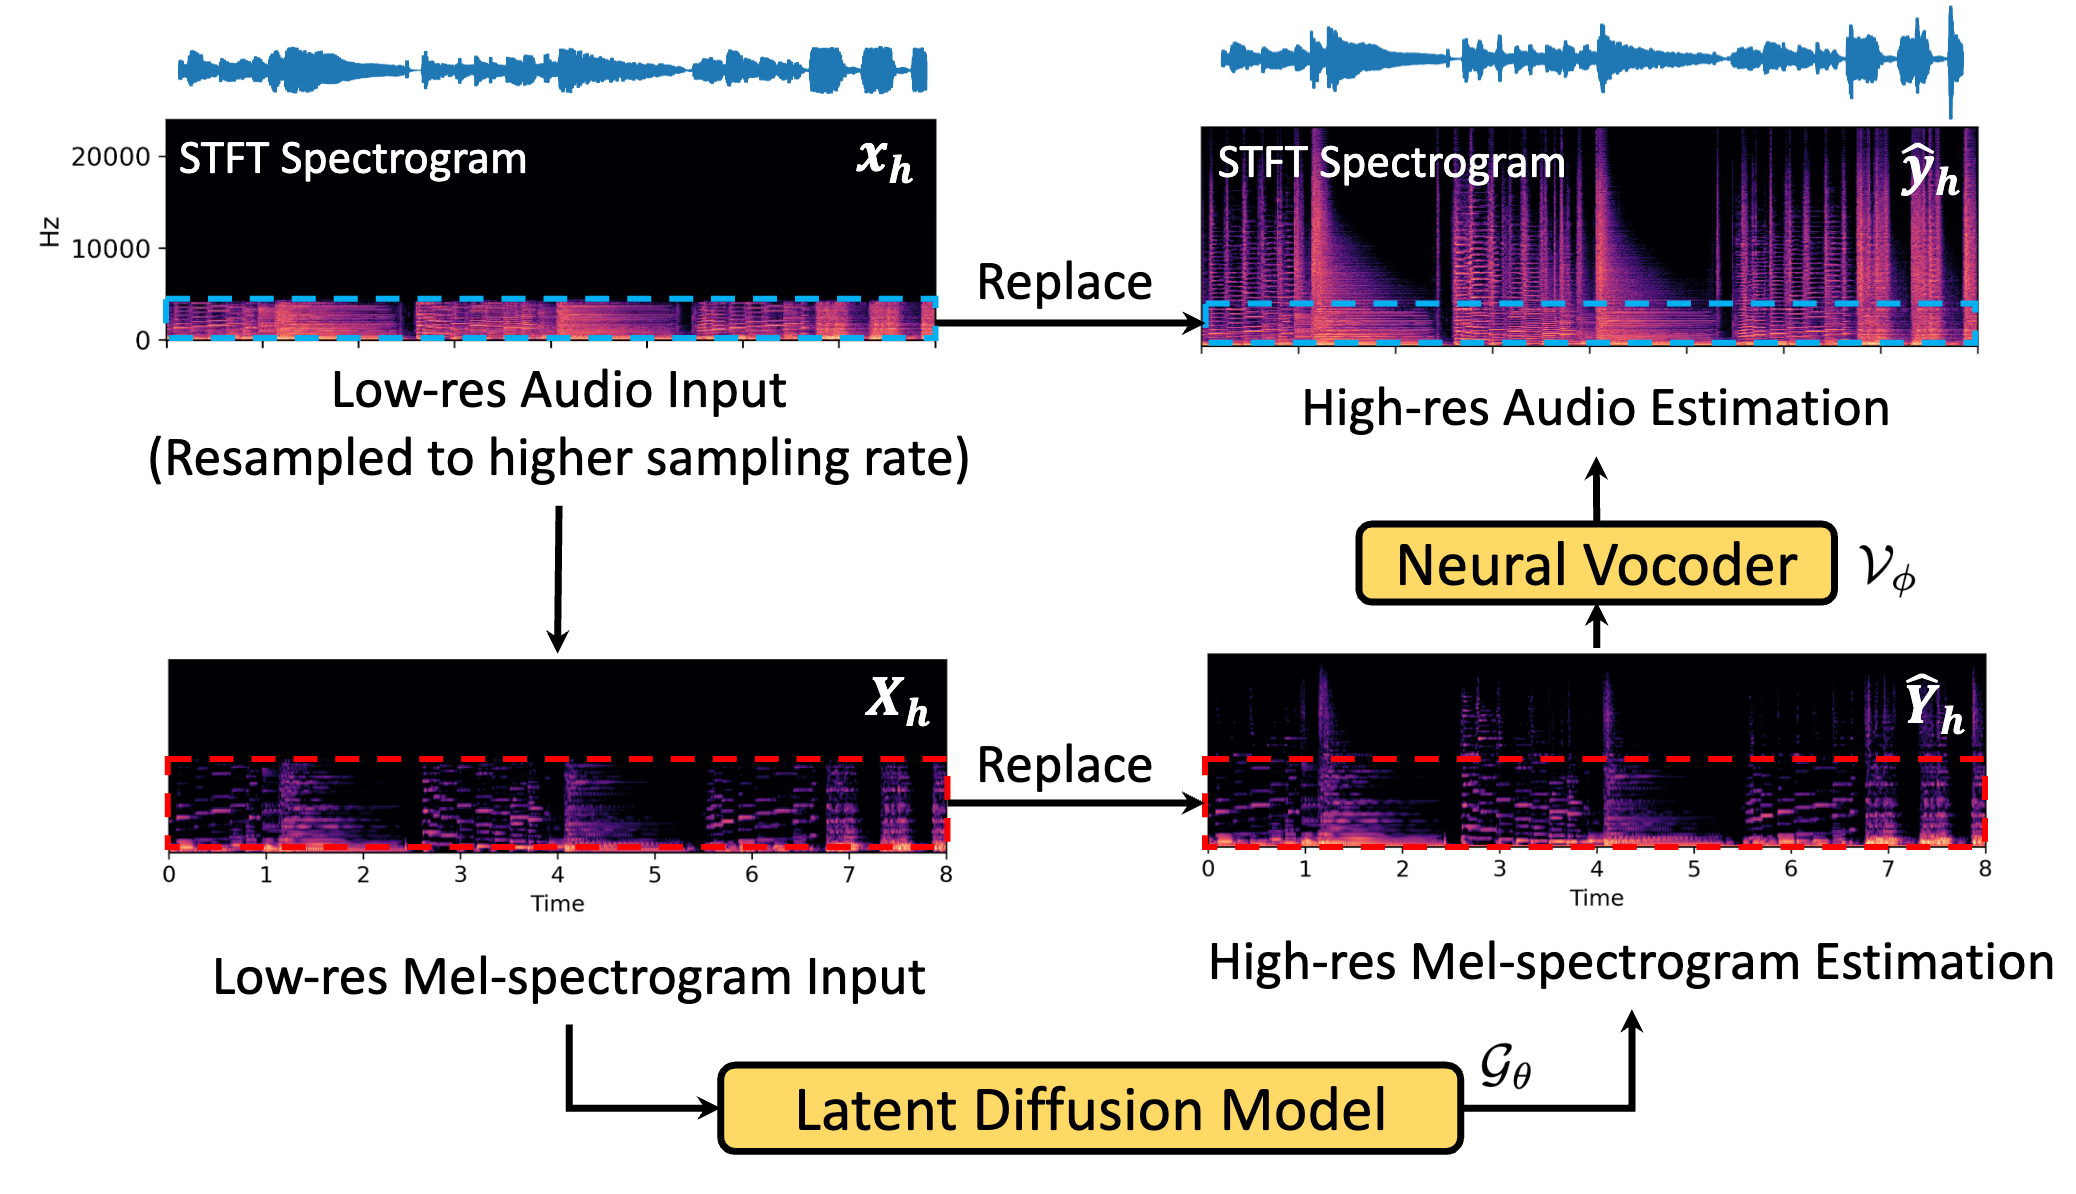
الشكل الأصلي: AudioSR.
يحول AudioSR التسجيل إلى مخطط طيفي mel، ويستخدم نموذج انتشار كامن لتقدير التفاصيل عالية التردد المفقودة، ثم يحول النتيجة إلى موجة صوتية باستخدام فوكودر. تعيد المعالجة اللاحقة الترددات المنخفضة الأصلية من المصدر مكان الترددات المولدة. النتيجة إعادة بناء معقولة، وليست استعادة مطابقة للصوت المفقود، وليست مجرد إضافة ضوضاء.
أين يمكنكم تشغيل AudioSR؟
| الخيار | الاستخدام الأنسب | الإعداد وما ينبغي مراعاته |
|---|---|---|
| AudioSR عبر الإنترنت مع Neural Analog (موصى به) | ترميم صوت ستيريو مع معالجة الإشارة الوسطية والجانبية وتردد قطع قابل للتخصيص | رفع ومعاينة وتصدير عبر الإنترنت. لا حاجة إلى تثبيت Python أو وحدة GPU محلية. |
| مستودع GitHub الرسمي | تجارب محلية وسكربتات Python | ثبتوا الاعتماديات، ونزلوا الأوزان، ووفروا موارد الحوسبة. |
| دفتر AudioSR على Colab | تجارب تستخدم وحدات GPU السحابية من Google | افتحوا دفتر المجتمع واتبعوا تعليماته في المتصفح. |
| Hugging Face Space | عرض تجريبي سريع في المتصفح | نشر يديره المجتمع؛ قد يتغير توفره وحصص GPU. |
| AudioSR على Replicate | استدلال مستضاف وتكامل عبر API | فوترة حسب الاستخدام؛ دون تثبيت النموذج محليا. |
يعالج Neural Analog معلومات الوسط والفرق الجانبي في صوت الستيريو بصورة منفصلة. يمكنكم أيضا ضبط تردد القطع الذي يبدأ عنده AudioSR بإعادة توليد التفاصيل. يغير تردد القطع المنخفض جزءا أكبر من الصوت، بينما يملأ تردد القطع الأعلى الجزء العلوي من الطيف فقط.
متطلبات AudioSR: Python وذاكرة GPU ومساحة القرص
AudioSR نموذج ثقيل، خصوصا للأغاني الكاملة. يبلغ حجم نقطة حفظ النموذج الأساسية الرسمية نحو 6.2 GB على القرص، ويتطلب الاستدلال ذاكرة أكبر من حجم الأوزان المخزنة. تفيد وحدة NVIDIA GPU كبيرة، لكن حجم نقطة حفظ النموذج لا يمثل حدا أدنى لذاكرة VRAM؛ فطول المقطع وطريقة التنفيذ يؤثران أيضا في استهلاك الذاكرة. لا ينشر README الرسمي حدا أدنى لمتطلبات GPU.
قد تستنفد المدخلات الطويلة ذاكرة GPU. ابدؤوا بمقطع قصير، ثم عالجوا التسجيلات الأطول في أجزاء أصغر.
جهزوا الاعتماديات التالية قبل البدء:
- Python في بيئة معزولة. يستخدم المثال الأصلي Python 3.9. يستخدم هذا الدليل Python 3.10، وهو متوافق مع إصدارات NumPy الأقدم التي يتطلبها AudioSR. تبقي البيئة الافتراضية هذه الحزم منفصلة عن Python النظام.
- Git وuv. ثبتوا Git وuv لتنزيل المصدر وإدارة بيئة Python.
- PyTorch وبرنامج تشغيل GPU مناسب. يحتاج مستخدمو NVIDIA إلى إصدار PyTorch متوافق مع CUDA. طابقوا إصدارات PyTorch وTorchAudio وTorchVision باستخدام جدول التثبيت الرسمي.
- FFmpeg، بما في ذلك ffprobe. يستخدم كود حفظ الملفات الأصلي هذين الأمرين. ثبتوهما عبر خيارات تنزيل FFmpeg واجعلوهما متاحين في الطرفية.
- مساحة قرص خالية واتصال بالإنترنت. وفروا مساحة للبيئة وأوزان النموذج المنزلة وملفات الإدخال والإخراج. ينزل التحميل الأول للنموذج نقطة حفظ النموذج الخاصة به.
يتعرف كود اختيار الجهاز الأصلي على CUDA وApple MPS وCPU. قد تكون المعالجة على CPU بطيئة جدا. لا يعني وجود MPS في فحص الجهاز أن كل اعتمادية وعملية تعملان على كل جهاز Mac.
كيفية تثبيت AudioSR من GitHub
1. تنزيل المستودع الرسمي وإنشاء بيئة Python
شغلوا هذه الأوامر في الطرفية:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
فعلوا البيئة على Linux أو macOS:
source .venv/bin/activateعلى Windows PowerShell، استخدموا أمر التفعيل التالي بدلا منه:
.venv\Scripts\Activate.ps12. تثبيت اعتماديات متوافقة وAudioSR
يفرض AudioSR قيودا على إصدارات اعتماديات قديمة، منها NumPy 1.23.5 أو أقدم وTransformers 4.30.2. قد يسبب تثبيت أحدث إصدارات Python وPyTorch أخطاء توافق. توفر متطلبات الحزمة والبيئة المرجعية للمشروع نقطتي بداية مفيدتين.
تجمع البيئة المرجعية مثلا بين PyTorch 2.0.1 وTorchAudio 2.0.2 وTorchVision 0.15.2. على Linux أو Windows مع برنامج تشغيل NVIDIA مناسب، ثبتوا هذه المجموعة الخاصة بـCUDA 11.7، ثم مصدر AudioSR الذي استنسختموه:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
أمر CUDA مخصص لأنظمة NVIDIA. استخدموا تعليمات macOS أو CPU المطابقة في جدول PyTorch للأجهزة الأخرى. هذه إصدارات اعتماديات قديمة، لذا أبقوا هذه البيئة منفصلة عن مشاريع Python الأخرى.
إذا احتجتم إلى الحزمة المنشورة فقط، يوثق README الرسمي أيضا audiosr==0.0.7. قد تختلف ميزات هذا الإصدار عن فرع main الحالي على GitHub، لذا راجعوا python -m audiosr --help للإصدار المثبت.
3. التحقق من تعرف Python على GPU
شغلوا هذا الفحص داخل البيئة المفعلة على جهاز NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
إذا لم تتوفر CUDA، أصلحوا برنامج التشغيل أو تثبيت PyTorch قبل بدء مهمة طويلة. لا تتيح إضافة -d cuda إلى AudioSR استخدام وحدة GPU غير متاحة.
استخدام AudioSR في سطر الأوامر: ابدؤوا بملف WAV قصير
استخدموا ملف WAV قصيرا أحادي القناة للتشغيل الأول. يوصي محمل الصوت الأصلي بمدخلات مدتها 5.12 ثانية ويحذر بشأن الجودة عند تجاوز 10.24 ثانية. تزيد الأغنية الكاملة صعوبة تشخيص مشكلات الإعداد والذاكرة.
ضعوا input.wav في مجلد المستودع، ثم شغلوا:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42يحفظ تنفيذ سطر الأوامر إخراج WAV بمعدل 48 kHz في مجلد يحمل طابعا زمنيا داخل output. استخدموا basic للصوت العام أو speech للتسجيلات الكلامية. تتحكم البذرة في اختلاف النتيجة المولدة؛ وقد تساعد مقارنة بضع بذور في اختيار نتيجة أفضل.
إذا اكتمل التوليد لكن الحفظ أظهر numpy.ndarray has no attribute cpu، استخدموا مثال Python أدناه لكتابة الإخراج مباشرة. في مصدر GitHub الذي جرت مراجعته لهذا الدليل، يعيد الاستدلال مصفوفة NumPy، لكن دالة حفظ الملف تتوقع موترًا. هذا عدم تطابق في نوع الإخراج في المشروع الأصلي، وليس خطأ في ذاكرة GPU.
يوفر كود GitHub الحالي أيضا تقسيم الملفات الأطول إلى أجزاء:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1يعالج التقسيم أجزاء أصغر ويمزج مناطق تداخلها. يقلل استهلاك الذاكرة، لكنه يضيف وصلات يجب فحصها بالسمع. تعتمد هذه الخيارات على الإصدار، ومسار المعالجة المجزأة الأصلي يمزج مدخل الستيريو إلى قناة واحدة، لذا احتفظوا بملف الستيريو الأصلي.
كيفية استخدام AudioSR من Python
استخدموا API الخاص بـPython لاستدعاء AudioSR من سكربتكم. يشغل المثال التالي ملفا قصيرا أحادي القناة، ويزيل الحشو الزائد ليطابق مدة الإدخال، ويكتب WAV بمعدل 48 kHz. احفظوه باسم run_audiosr.py في مجلد المستودع.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyيحمل مسار Python النموذج مرة واحدة، لذا يستطيع سكربت معالجة دفعات إعادة استخدامه. في Neural Analog، تطبق معالجة الدفعات ترميما واحدا على ملفات متعددة دون سكربت. حددوا عدد خطوات أخذ العينات صراحة، فقد تختلف القيم الافتراضية بين API الخاص بـPython وسطر الأوامر.
كيفية تشغيل AudioSR في Google Colab
يتيح Google Colab تشغيل AudioSR على عتاد Google السحابي. افتحوا دفتر AudioSR المجتمعي على Colab، واتبعوا تعليماته لتحميل الصوت وتشغيل النموذج وحفظ النتيجة. يعمل الدفتر في المتصفح، فلا تحتاجون إلى تثبيت Python أو GPU على جهازكم.
الدفتر تعديل مجتمعي لـAudioSR. يتوفر مصدره على GitHub.
أين يمكن تنزيل أوزان نموذج AudioSR؟
نزلوا أوزان نموذج AudioSR من Hugging Face.
تفاصيل نموذج AudioSR: البنية والتدريب والتاريخ
من طور AudioSR؟
AudioSR نموذج توليدي لرفع الدقة الصوتية طوره Haohe Liu وKe Chen وQiao Tian وWenwu Wang وMark D. Plumbley. يتنبأ بالترددات العالية المفقودة في الكلام والموسيقى والمؤثرات الصوتية، وينتج صوتا بمعدل أخذ عينات 48 kHz. تتضمن صفحة أبحاث AudioSR الورقة وأمثلة للاستماع. ظهر العمل أولا في مسودة بحثية في سبتمبر 2023، ونشر في ICASSP 2024.
يولد AudioSR تفاصيل معقولة. لا يمكنه استعادة نسخة مطابقة من نسخة ماستر الاستوديو المفقودة. تحويل MP3 إلى WAV بمعدل 48 kHz لا ينفذ هذا النوع من إعادة البناء إطلاقا. لمعرفة الفرق، راجعوا دليل رفع دقة ملفات MP3 إلى WAV.
رفع الدقة الصوتية وإعادة أخذ العينات وعرض النطاق مفاهيم مختلفة
تغير إعادة أخذ العينات عدد العينات التي تمثل كل ثانية من الصوت. يحاول رفع الدقة الصوتية أو الدقة الفائقة تقدير المحتوى الترددي الذي لم يعد موجودا في التسجيل. مثلا، تزيد إعادة أخذ عينات تسجيل بمعدل 8 kHz إلى 48 kHz عدد العينات، لكنها لا تستعيد وحدها الأصوات فوق حد التردد الأصلي البالغ 4 kHz.
يستهدف AudioSR مدخلات بعرض نطاق من 2 إلى 16 kHz، ويولد إخراجا بعرض نطاق 24 kHz ومعدل أخذ عينات 48 kHz، وفقا لـوصف المشروع الرسمي. يصف عرض النطاق مجال الترددات، بينما يصف معدل أخذ العينات عدد العينات في الثانية. قد يظل ملف يحمل تسمية 48 kHz ضيق النطاق بسبب ضغط أو ترشيح سابق. ينطبق ذلك على كثير من الأغاني المولدة بالذكاء الاصطناعي، وهو سبب شيوع الصوت المكتوم في أغاني Suno.
هل كان AudioSR أول نموذج لرفع الدقة الصوتية؟
لم يكن AudioSR أول نموذج عصبي لرفع الدقة الصوتية. نشر Kuleshov وEnam وErmon بحث رفع الدقة الصوتية باستخدام الشبكات العصبية في 2017، وسبقته أيضا نماذج رفع دقة الكلام القائمة على الانتشار.
مساهمته أضيق من ذلك. تقدم ورقة AudioSR النموذج بوصفه أول نظام يغطي المجال العام للأصوات المسموعة: الموسيقى والكلام والمؤثرات الصوتية. يجمع هذا النطاق الواسع مع مرونة عرض نطاق الإدخال، ولا يقدم مفهوم رفع الدقة الصوتية للمرة الأولى.
من التسجيل المدخل إلى موجة صوتية بمعدل 48 kHz
يجمع AudioSR بين مشفر تلقائي تغايري (VAE)، ونموذج انتشار كامن مشروط، وفوكودر عصبي. يتولى كل مكون مرحلة من إعادة البناء:
| المرحلة | ما يحدث | أهميتها |
|---|---|---|
| التمثيل الصوتي | يتحول الإدخال إلى مخطط طيفي mel: خريطة لطاقة الصوت عبر الزمن والتردد. | يعالج النموذج أنماط المحتوى الترددي. |
| تشفير VAE | يضغط المشفر المخطط الطيفي إلى تمثيل أصغر يسمى تمثيلا كامنا. | يعمل الانتشار على قيم أقل مما في المخطط الطيفي الكامل. |
| الانتشار المشروط | يحسن Transformer U-Net تمثيلا كامنا مشوشا بصورة تكرارية، بتوجيه من التمثيل الكامن للإدخال منخفض الدقة. | يوجه التسجيل التفاصيل المولدة؛ ولا حاجة إلى توجيه نصي. |
| فك التشفير والفوكودر | يفك VAE التمثيل إلى مخطط طيفي mel أعلى دقة. يحوله فوكودر قائم على HiFi-GAN إلى موجة صوتية. | يجب تحويل المخطط الطيفي إلى عينات صوتية مسموعة. |
| استبدال الترددات | تحل معلومات الترددات المنخفضة من الإدخال محل النطاقات المولدة المناظرة. | تساعد المعلومات الموجودة على الحد من تغييرات التسجيل. |
تحدد تهيئة النموذج المنشورة تمثيلا من 256 نطاق mel وVAE وU-Net بوحدات Transformer مكانية. تصل خصائص الإدخال المرمزة بعد ترشيحها منخفض التمرير بالتمثيل الكامن للانتشار. هذا توليد مشروط بالصوت، رغم أن بعض أوصاف سطر الأوامر الموروثة تشير إلى النص.
ما الذي تتحكم فيه خطوات أخذ العينات وقوة التوجيه؟
تحدد خطوات أخذ العينات عدد التكرارات التي يقضيها النموذج في تحسين تمثيله المولد. يستخدم AudioSR آخذ عينات DDIM. تتحكم قوة التوجيه في مدى تأثير شرط الإدخال على التوليد. ليست مقدار EQ، ولا تضمن القيمة الأعلى جودة أفضل. يطبق تنفيذ الاستدلال أخذ العينات وفك التشفير واستبدال الترددات وتطبيع الموجة الصوتية بالترتيب.
تستغرق خطوات أخذ العينات الإضافية والتسجيلات الأطول وقت معالجة أكبر. AudioSR مخصص للمعالجة خارج الزمن الحقيقي، وتعتمد السرعة الفعلية على GPU والإعدادات. يقلل خفض ddim_steps وقت التوليد، لكنه لا يحل أخطاء ذاكرة GPU بصورة موثوقة.
كيف جرى تدريب AudioSR؟
يصف قسم التدريب في الورقة نحو 7,000 ساعة من MUSDB18-HQ وMoisesDB وMedleyDB وFreesound وبيانات كلام OpenSLR. تنشئ مرشحات منخفضة التمرير بترددات قطع متنوعة مدخلات متدهورة تقابلها أهداف أوسع نطاقا. يستخدم نموذج الانتشار جدولا للضوضاء يتبع دالة جيب التمام، وتنبؤ السرعة، وتوجيها دون مصنف. يقوم الفوكودر على HiFi-GAN مع مميز متعدد الدقة.
قد تختلف التسجيلات الحقيقية عن أمثلة التدريب هذه. يوضح المؤلفون أن ترددات القطع غير المنتظمة والضوضاء الشديدة والصدى قد تقلل الجودة. قد يترك ضغط MP3 فجوات قرب تردد القطع. قد يفيد الترشيح منخفض التمرير قبل الاستدلال، لكن تردد قطع منخفضا جدا يزيل تفاصيل مفيدة. للتسجيلات ذات الصدى، يمكن أن تمنح إزالة الصدى قبل رفع الدقة مدخلا أنظف للنموذج.
لا تحتاجون إلى تدريب هذه المكونات لتشغيل AudioSR. يحمل مسار التثبيت أوزانا مدربة مسبقا.
لماذا يستخدم AudioSR المعالجة اللاحقة؟
ينبغي أن يحتفظ الصوت المولد بالمعلومات المفيدة الموجودة في المصدر. يستبدل AudioSR النطاقات المنخفضة مرتين: في مخطط mel الطيفي المقدر قبل الفوكودر، وفي تمثيل تحويل فورييه قصير الزمن (STFT) للموجة الناتجة. يقدر كود الاستبدال تردد القطع ويضبط الإخراج المعاد بناؤه.
تحتاج تسجيلات الستيريو والأغاني الكاملة إلى مسار يتولى القنوات والأجزاء وإعادة البناء. ينتج المسار الافتراضي للمستودع صوتا أحادي القناة: يأخذ المحمل القياسي قناة الإدخال الأولى، بينما يمزج مسار الأجزاء الستيريو إلى قناة واحدة. يتطلب الحفاظ على الستيريو معالجة إضافية للقنوات، مثل معالجة القناتين اليسرى واليمنى كل على حدة في دفتر المجتمع.
تحتاج إعادة البناء إلى فحص بالاستماع. تحذر ملاحظات المسار المجتمعي من أن التداخل المفرط قد يسبب إلغاء طوريا. قارنوا النتيجة عند مستوى جهارة مماثل، وافحصوا الترددات العالية المعاد توليدها والوصلات بين الأجزاء والمدة والصورة الستيريو. يساعد استبدال الترددات على الحفاظ على المصدر، لكنه لا يضمن نطاقا منخفضا لم يتغير أو وصلات نظيفة.
أسئلة شائعة عن أخطاء AudioSR وحلولها
هل يتوفر AudioSR على PyPI؟
نعم. يشرح README الرسمي تثبيت audiosr==0.0.7 باستخدام pip، أو أحدث كود مباشرة من GitHub. يحتوي فرع main على GitHub على ميزات مثل التقسيم إلى أجزاء قد لا تتوفر في إصدار PyPI.
كم يحتاج AudioSR من ذاكرة GPU؟
لا يذكر README حدا أدنى. تبلغ نقطة حفظ النموذج الأساسية وحدها نحو 6.2 GB على القرص، ويزيد استهلاك الذاكرة مع طول المقطع. ابدؤوا بمقطع مدته نحو 5 ثوان، ثم استخدموا التقسيم للأجزاء مع الملفات الأطول.
لماذا يفشل AudioSR بالرسالة numpy.ndarray has no attribute cpu؟
اكتمل الاستدلال، لكن مرحلة الحفظ تتوقع موتر PyTorch وتتلقى مصفوفة NumPy. استخدموا سكربت Python أعلاه، الذي يكتب الإخراج باستخدام soundfile.
لماذا يكون إخراج AudioSR أحادي القناة؟
يقرأ المحمل الافتراضي القناة الأولى فقط، ويمزج مسار الأجزاء الستيريو إلى قناة واحدة. عالجوا القناتين اليسرى واليمنى بصورة منفصلة، أو استخدموا AudioSR عبر الإنترنت، الذي يعالج القناة الوسطية وقناة الفرق الجانبي لكم.
هل يتوفر كود تدريب AudioSR؟
نعم. يربط سجل تغييرات README بتاريخ 31 ديسمبر 2024 بكود التدريب، الذي يصفه المؤلف بأنه مرجع فقط وغير منظم بعناية.
تشغيل AudioSR مع Neural Analog دون إدارة الإعداد المحلي
لتجاوز الإعداد المحلي، افتحوا AudioSR عبر الإنترنت، وارفعوا ملفا أو استوردوا رابط موسيقى مدعوما، ثم اضبطوا إعدادات الترميم. بالنسبة إلى Udio، احفظوا الصوت أو سجلوا تشغيله أولا، ثم ارفعوا الملف. يمكنكم اختيار تردد القطع ومعاينة النتيجة المعالجة وتصدير الصوت من الواجهة نفسها.
يتولى Neural Analog معالجة النموذج عبر الإنترنت، فيمكنكم استخدام جهاز دون GPU كبيرة وتجاوز تثبيت Python وتنزيل نقاط حفظ النموذج وصيانة الدفاتر. ما زلتم تحتاجون إلى الاستماع النقدي، فالاستضافة لا تزيل حدود جودة النموذج. بعد الترميم، اتبعوا دليل تحسين الصوت للخطوات التالية. للموسيقى المولدة بالذكاء الاصطناعي، يشرح تحسين جودة أغاني الذكاء الاصطناعي إصلاح المسارات المنفصلة والماسترينغ بعد رفع الدقة.
يمكنكم أيضا مقارنة AudioSR بنماذج رفع دقة صوتية أحدث متوفرة في Neural Analog، منها UniverSR وFlashSR. توضح بطاقات النماذج كيفية عملها، وتلخص الأسئلة الشائعة الفرق بين UniverSR وAudioSR. للاطلاع على مثال عملي، راجعوا ترميم جميع مؤثرات RPG Maker 2000 الصوتية البالغ عددها 203 إلى 48 kHz باستخدام UniverSR. شغلوها على التسجيل نفسه وقارنوا المعاينات لاختيار أفضل نتيجة.