AudioSR GitHub導入ガイド:AudioSRをローカルで動かす方法
AudioSRは、オープンソースの音声超解像モデルです。話し声、音楽、効果音で欠けている高域の細部を生成し、48 kHzの音声を出力します。公式GitHubリポジトリからインストールするか、Neural AnalogでAudioSRをオンライン実行できます。
ローカルに導入するには、リポジトリをクローンし、uvでPython 3.10環境を作り、互換性のあるPyTorchビルドとAudioSRをインストールします。その後、短いWAVファイルに対してpython -m audiosrを実行します。以下で各コマンドを説明します。
AudioSRの仕組み:モデル構成を解説
AudioSRによる欠けた高域の再構成
入力メルスペクトログラムを潜在拡散の条件にして、帯域幅がより広いメルスペクトログラムを推定します。ボコーダーの前で、生成した低域メル帯域を入力の帯域に置き換え、ボコーダーの後で、生成した低域STFT帯域を入力の帯域に置き換えます。モデルは欠けた細部をもっともらしく生成しますが、失われた録音を正確に取り戻すわけではありません。
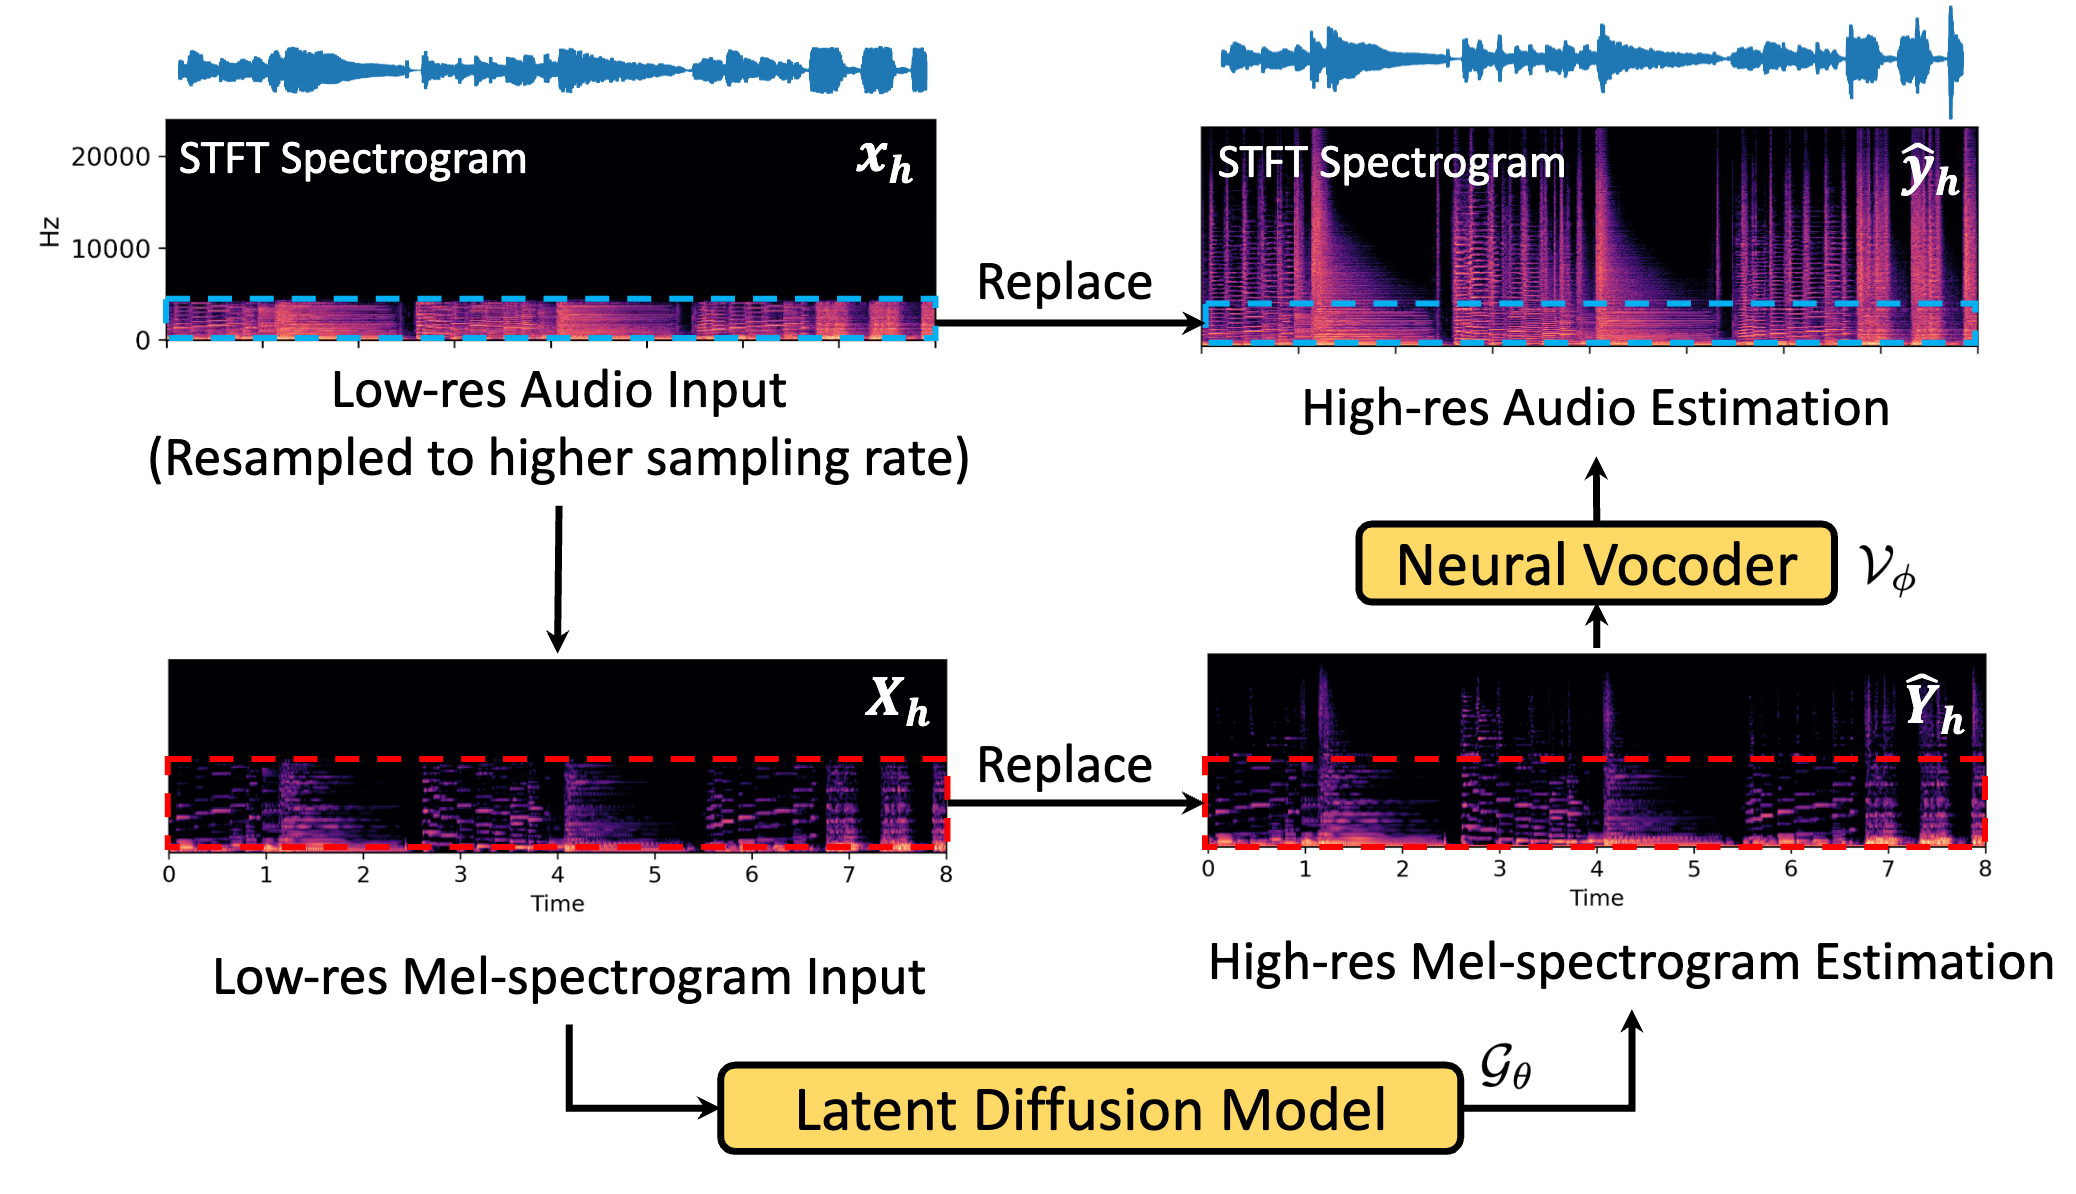
原図: AudioSR。
AudioSRは録音をメルスペクトログラムに変換し、潜在拡散モデルで欠けた高域の細部を推定してから、ボコーダーで波形に戻します。後処理では、生成した低域を元の音源にある低域に置き換えます。結果はもっともらしい再構成であり、失われた音声の正確な復元ではありません。また、単にノイズを加えるものでもありません。
AudioSRはどこで実行できますか?
| 選択肢 | 向いている用途 | 導入と注意点 |
|---|---|---|
| Neural AnalogのオンラインAudioSR(推奨) | Mid/Side処理と調整可能なカットオフ周波数によるステレオ修復 | オンラインでアップロード、試聴、書き出しができます。PythonのインストールやローカルGPUは不要です。 |
| 公式GitHubリポジトリ | ローカルでの実験とPythonスクリプト | 依存関係のインストール、重みのダウンロード、計算資源の用意が必要です。 |
| AudioSR Colabノートブック | GoogleのクラウドGPUを使った実験 | コミュニティーのノートブックを開き、ブラウザーで手順に従います。 |
| Hugging Face Space | ブラウザーで手軽に試すデモ | コミュニティーによる公開環境です。利用可否やGPUの割り当ては変わることがあります。 |
| ReplicateのAudioSR | ホストされた推論とAPI連携 | 従量課金で、ローカルへのモデル導入は不要です。 |
Neural Analogは、ステレオ音声の中央成分とサイド成分を別々に処理します。AudioSRが細部の再生成を始めるカットオフ周波数も設定できます。カットオフを下げると音のより広い範囲が変わり、上げると最も高い帯域だけを補います。
AudioSRの要件:Python、GPUメモリー、ディスク容量
AudioSRは、特に曲全体を扱う場合に負荷の大きいモデルです。公式の基本チェックポイントはディスク上で約6.2 GBを占め、推論には保存された重み以上のメモリーが必要です。大容量メモリーのNVIDIA GPUは役立ちますが、チェックポイントのサイズは最低VRAM要件ではありません。クリップの長さと実装もメモリー使用量に影響します。公式READMEは最低GPU要件を公表していません。
長い入力ではGPUメモリーを使い切る場合があります。短いクリップから始め、長い録音は小さな区間に分割して処理してください。
始める前に、次を用意します。
- **独立した環境のPython。**元のプロジェクトの例はPython 3.9を使います。このガイドでは、AudioSRが要求する古いNumPyのバージョンに対応するPython 3.10を使います。仮想環境なら、これらのパッケージをシステムのPythonから分離できます。
- **Gitとuv。**ソースのダウンロードとPython環境の管理のために、Gitとuvをインストールしてください。
- **PyTorchと適切なGPUドライバー。**NVIDIAではCUDA対応のPyTorchビルドが必要です。公式のインストール対応表で、PyTorch、TorchAudio、TorchVisionのバージョンを合わせてください。
- **ffprobeを含むFFmpeg。**元のプロジェクトのファイル保存コードがこれらのコマンドを使います。FFmpegのダウンロード方法から導入し、ターミナルで実行できるようにしてください。
- **空きディスク容量とインターネット接続。**環境、ダウンロードするモデルの重み、入力ファイル、出力用の容量を確保してください。最初のモデル読み込み時にチェックポイントをダウンロードします。
元のプロジェクトのデバイス選択コードはCUDA、Apple MPS、CPUを認識します。CPU処理は非常に遅くなることがあります。デバイス確認にMPS対応があっても、すべての依存関係と演算がすべてのMacで動くとは限りません。
GitHubからAudioSRをインストールする方法
1.公式リポジトリを取得し、Python環境を作る
ターミナルで次のコマンドを実行します。
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
LinuxまたはmacOSで環境を有効にします。
source .venv/bin/activateWindows PowerShellでは、代わりに次の有効化コマンドを使います。
.venv\Scripts\Activate.ps12.対応する依存関係とAudioSRをインストールする
AudioSRには、NumPy 1.23.5以前やTransformers 4.30.2など、古い依存関係に関する制約があります。最新のPythonやPyTorchを導入すると、互換性エラーが起こる場合があります。プロジェクトのパッケージ要件と参照環境が参考になります。
例えば参照環境では、PyTorch 2.0.1、TorchAudio 2.0.2、TorchVision 0.15.2を組み合わせています。適切なNVIDIAドライバーがあるLinuxまたはWindowsで、このCUDA 11.7の組み合わせを導入し、チェックアウトしたAudioSRのソースをインストールします。
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
CUDAのコマンドはNVIDIAシステム用です。その他のデバイスでは、PyTorchの対応表にあるmacOS用またはCPU用の手順を使ってください。古い依存関係なので、この環境は他のPythonプロジェクトから分離してください。
公開パッケージだけが必要なら、公式READMEにaudiosr==0.0.7の説明もあります。このリリースとGitHubの現在のmainブランチでは機能が異なる場合があるので、導入したバージョンのpython -m audiosr --helpを確認してください。
3.PythonがGPUを認識するか確認する
NVIDIAのマシンで、有効にした環境内から次を実行します。
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -versionCUDAが使えなければ、長い処理を始める前にドライバーかPyTorchの導入を修正してください。AudioSRに-d cudaを追加しても、使えないGPUが動くようにはなりません。
AudioSRのコマンドライン操作:短いWAVから始める
最初は短いモノのWAVを使います。元のプロジェクトの音声ローダーは5.12秒の入力を推奨し、10.24秒を超えると品質に問題が生じる可能性があると警告しています。曲全体を使うと、設定やメモリーの問題を切り分けにくくなります。
input.wavをリポジトリのディレクトリに置き、実行します。
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42コマンドラインの実装は、outputの下にあるタイムスタンプ付きフォルダーへ48 kHzのWAVを保存します。一般的な音声にはbasic、話し声の録音にはspeechを使います。シードは生成結果の変化を制御します。いくつかのシードを比較すると、より良い結果を選ぶのに役立ちます。
生成が終わっても保存時にnumpy.ndarray has no attribute cpuが出る場合は、以下のPythonの例で出力を直接書き込んでください。このガイドで確認したGitHubのソースでは、推論がNumPy配列を返す一方、ファイル保存関数はテンソルを要求します。これは元のプロジェクトの出力型の不一致であり、GPUメモリーのエラーではありません。
現在のGitHubコードには、長いファイルを分割する機能もあります。
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1分割処理では小さな区間を処理し、重複部分を混ぜ合わせます。メモリー使用量は減りますが、つなぎ目が生まれるので耳で確認してください。これらのフラグはバージョンによって異なり、元の分割経路はステレオ入力をモノにダウンミックスするため、元のステレオファイルを残しておきます。
PythonからAudioSRを使う方法
Python APIで自分のスクリプトからAudioSRを呼び出します。以下の例は短いモノファイルを処理し、パディングを入力の長さに合わせて切り、48 kHzのWAVを保存します。リポジトリのディレクトリにrun_audiosr.pyとして保存してください。
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPythonのパイプラインはモデルを1度だけ読み込むので、一括処理スクリプトで再利用できます。Neural Analogの一括処理なら、スクリプトなしで複数ファイルに同じ修復を適用できます。Python APIとCLIは標準値が異なる場合があるため、サンプリングステップ数を明示してください。
Google ColabでAudioSRを動かす方法
Google Colabでは、GoogleのクラウドハードウェアでAudioSRを実行できます。コミュニティーのAudioSR Colabノートブックを開き、手順に従って音声を読み込み、モデルを実行し、結果を保存します。ブラウザーで動くため、自分のコンピューターにPythonやGPUは不要です。
このノートブックは、コミュニティーによるAudioSRの改変版です。ソースはGitHubで公開されています。
AudioSRのモデルの重みはどこから取得できますか?
Hugging FaceにあるAudioSRのモデルの重みをダウンロードしてください。
AudioSRの詳細:構成、学習、歴史
AudioSRを作ったのは誰ですか?
AudioSRはHaohe Liu、Ke Chen、Qiao Tian、Wenwu Wang、Mark D. Plumbleyが開発した生成型の音声超解像モデルです。話し声、音楽、効果音で欠けた高域を予測し、48 kHzの音声を出力します。AudioSRの研究ページには、論文と試聴例があります。この研究は2023年9月のプレプリントとして初めて公開され、ICASSP 2024で発表されました。
AudioSRは、もっともらしい細部を生成します。失われたスタジオマスターの正確なコピーを取り戻すことはできません。MP3を48 kHzのWAVに変換するだけでは、この再構成は一切行われません。違いについては、MP3をWAVへ修復するガイドをご覧ください。
音声超解像、リサンプリング、帯域幅は別のもの
リサンプリングは、音声の1秒を表すサンプル数を変えます。音声の高解像度化、つまり超解像は、録音から失われた周波数成分を推定しようとする処理です。例えば8 kHzの録音を48 kHzにリサンプリングするとサンプルは増えますが、元の4 kHzという周波数上限を超える音は、それだけでは復元されません。
公式プロジェクトの説明によれば、AudioSRは2から16 kHzの入力帯域幅を対象とし、48 kHzのサンプルレートで24 kHzの帯域幅を持つ出力を生成します。帯域幅は周波数範囲、サンプルレートは1秒あたりのサンプル数を表します。48 kHzと表示されたファイルでも、以前の圧縮やフィルタリングによって帯域幅が狭い場合があります。AI生成曲にもよく見られ、Sunoの曲がこもって聴こえやすい理由でもあります。
AudioSRは最初の音声超解像モデルですか?
AudioSRは、最初のニューラル音声超解像モデルではありません。Kuleshov、Enam、Ermonは2017年にニューラルネットワークを用いた音声超解像を発表し、拡散を使った話し声の超解像もAudioSRより前にありました。
貢献は、より限定されたものです。AudioSRの論文は、音楽、話し声、効果音という一般的な可聴領域を扱う初のシステムとして紹介しています。音声超解像そのものを初めて提案したのではなく、広い適用範囲と柔軟な入力帯域幅を組み合わせたものです。
入力録音から48 kHzの波形へ
AudioSRは、変分オートエンコーダー(VAE)、条件付き潜在拡散モデル、ニューラルボコーダーを組み合わせます。それぞれが再構成の1段階を担当します。
| 段階 | 処理内容 | 重要な理由 |
|---|---|---|
| 音声の表現 | 入力を、時間と周波数に沿った音のエネルギーを示すメルスペクトログラムに変換します。 | モデルが周波数成分のパターンを扱えます。 |
| VAEの符号化 | エンコーダーがスペクトログラムを、潜在表現という小さな表現へ圧縮します。 | 完全なスペクトログラムより少ない値で拡散を行えます。 |
| 条件付き拡散 | Transformer U-Netが、低解像度の入力潜在表現に導かれ、ノイズのある潜在表現を反復的に調整します。 | 録音が生成する細部を導き、テキストプロンプトは不要です。 |
| 復号とボコーダー | VAEが高解像度のメルスペクトログラムへ復号します。HiFi-GANを基にしたボコーダーが波形へ変換します。 | スペクトログラムを、聴けるサンプルへ戻す必要があります。 |
| 周波数の置換 | 入力の低域情報で、対応する生成帯域を置き換えます。 | 既存の情報が、録音への変更を制限します。 |
公開されたモデル設定は、256帯域のメル表現、VAE、空間Transformerを持つU-Netを指定しています。入力から符号化したローパス特徴を、拡散の潜在表現と連結します。一部の引き継がれたCLI説明にテキストの記述があっても、音声を条件とする生成です。
サンプリングステップとガイダンスは何を調整しますか?
サンプリングステップは、生成表現を調整する反復回数を決めます。AudioSRはDDIMサンプラーを使います。ガイダンスは、入力条件が生成を導く強さを決めます。EQの量ではなく、値を上げても品質が良くなるとは限りません。推論の実装は、サンプリング、復号、周波数置換、波形の正規化を順番に行います。
サンプリングステップが多く、録音が長いほど、処理時間が増えます。AudioSRは非リアルタイム処理向けで、実際の速度はGPUと設定によって異なります。ddim_stepsを減らすと生成は速くなりますが、GPUメモリーのエラーを確実に解消するわけではありません。
AudioSRはどのように学習しましたか?
論文の学習に関する節では、MUSDB18-HQ、MoisesDB、MedleyDB、Freesound、OpenSLRの話し声データから得た約7,000時間を説明しています。カットオフを変えたローパスフィルターで劣化した入力を作り、より広い帯域幅の対象と対にします。拡散モデルは、コサインのノイズスケジュール、速度予測、分類器不要ガイダンスを使います。ボコーダーはHiFi-GANを基にし、複数解像度の識別器を使います。
実際の録音は、これらの学習例とは異なる場合があります。著者は、不規則な周波数カットオフ、強いノイズ、リバーブが品質を下げる可能性を説明しています。MP3圧縮は、カットオフ付近に欠けを残すことがあります。推論前のローパスフィルタリングは役立つ場合がありますが、カットオフを下げすぎると有用な細部が消えます。リバーブがある録音では、超解像の前にリバーブを除くと、よりクリアな入力を用意できます。
AudioSRを実行するために、これらの構成要素を学習させる必要はありません。導入手順では、学習済みの重みを読み込みます。
AudioSRが後処理を使う理由
生成した音声は、元の音源にある有用な情報を残す必要があります。AudioSRは低域を2回置き換えます。ボコーダー前の推定メルスペクトログラムと、生成波形の短時間フーリエ変換(STFT)表現です。置換コードはカットオフを推定し、再構成した出力を調整します。
ステレオ録音や曲全体には、チャンネル、分割、再構成を扱う工程が必要です。リポジトリの標準手順はモノ音声を出力します。標準ローダーは入力の最初のチャンネルを取り、分割パイプラインはステレオをモノにダウンミックスします。ステレオを残すには、コミュニティーのノートブックのように左右を別々に処理するなど、追加のチャンネル処理が必要です。
再構成した結果は聴いて確認してください。コミュニティーのパイプラインの注意点は、過剰な重なりが位相の打ち消しを起こす可能性を警告しています。同程度のラウドネスで比べ、再生成した高域、つなぎ目、長さ、ステレオイメージを確認します。周波数置換は元の音源を保つ助けになりますが、低域が変わらないことや、つなぎ目がきれいなことを保証しません。
AudioSRのトラブル対処FAQ
AudioSRはPyPIにありますか?
はい。公式READMEは、pipでaudiosr==0.0.7を導入する方法と、GitHubから最新コードを直接導入する方法を案内しています。GitHubのmainブランチには分割処理などの機能があり、PyPIリリースでは使えない場合があります。
AudioSRにはどれだけのGPUメモリーが必要ですか?
READMEは最低要件を示していません。基本チェックポイントだけで、ディスク上で約6.2 GBを占め、メモリー使用量はクリップが長いほど増えます。約5秒のクリップから始め、長いファイルは分割処理を使ってください。
AudioSRでnumpy.ndarray has no attribute cpuが出るのはなぜですか?
推論は終わっていますが、保存段階がPyTorchテンソルを想定しているのに、NumPy配列を受け取ったためです。上のPythonスクリプトを使い、soundfileで出力を保存してください。
AudioSRの出力がモノになるのはなぜですか?
標準ローダーは最初のチャンネルだけを読み、分割経路はステレオをモノへダウンミックスします。左右を別々に処理するか、ミッドとサイドのチャンネルを処理するオンラインAudioSRを使ってください。
AudioSRの学習コードは公開されていますか?
はい。READMEの2024年12月31日の変更履歴に学習コードへのリンクがあります。著者は、参考用であり、十分に整理したものではないと説明しています。
導入環境を管理せず、Neural AnalogでAudioSRを使う
ローカル設定を省くには、オンラインAudioSRを開き、ファイルをアップロードするか、対応する音楽リンクを読み込み、修復設定を調整します。Udioは先に音声を保存または録音してから、ファイルをアップロードしてください。カットオフ周波数の選択、処理結果の試聴、音声の書き出しを同じ画面で行えます。
Neural Analogがオンラインでモデル処理を行うので、大きなGPUがないコンピューターを使い、Pythonの導入、チェックポイントのダウンロード、ノートブックの管理を省けます。ただし、ホストされた手順でもモデルの品質上の限界はなくならないため、注意深く聴く必要があります。修復後は、音質改善ガイドに従って次の処理を行ってください。AI生成音楽については、AI楽曲の音質を修正する方法で、超解像後のステム修復とマスタリングを説明しています。
Neural Analogにある新しい音声超解像モデル、UniverSRやFlashSRとも比較できます。モデルカードはそれぞれの仕組みを説明し、FAQはUniverSRとAudioSRの違いをまとめています。実例として、RPG Maker 2000の効果音全203個をUniverSRで48 kHzに修復した記事をご覧ください。同じ録音に適用し、試聴結果を比較して最良のものを選んでください。