Installare AudioSR da GitHub: come eseguirlo in locale
AudioSR è un modello open source di super-risoluzione audio. Genera i dettagli ad alta frequenza mancanti in parlato, musica ed effetti sonori per produrre audio a 48 kHz. Puoi installarlo dal repository GitHub ufficiale oppure usare AudioSR online con Neural Analog.
Per installarlo in locale, clona il repository, crea un ambiente Python 3.10 con uv, installa una versione compatibile di PyTorch e AudioSR, poi esegui python -m audiosr su un file WAV breve. I passaggi seguenti spiegano ogni comando.
Come funziona AudioSR? L'architettura spiegata
Come AudioSR ricostruisce le alte frequenze mancanti
Lo spettrogramma mel in ingresso condiziona la diffusione latente per stimare uno spettrogramma mel con una banda più ampia. Le bande mel basse dell'ingresso sostituiscono quelle generate prima del vocoder; le sue bande STFT basse sostituiscono quelle generate dopo il vocoder. Il modello genera dettagli mancanti plausibili, senza recuperare una copia esatta di una registrazione perduta.
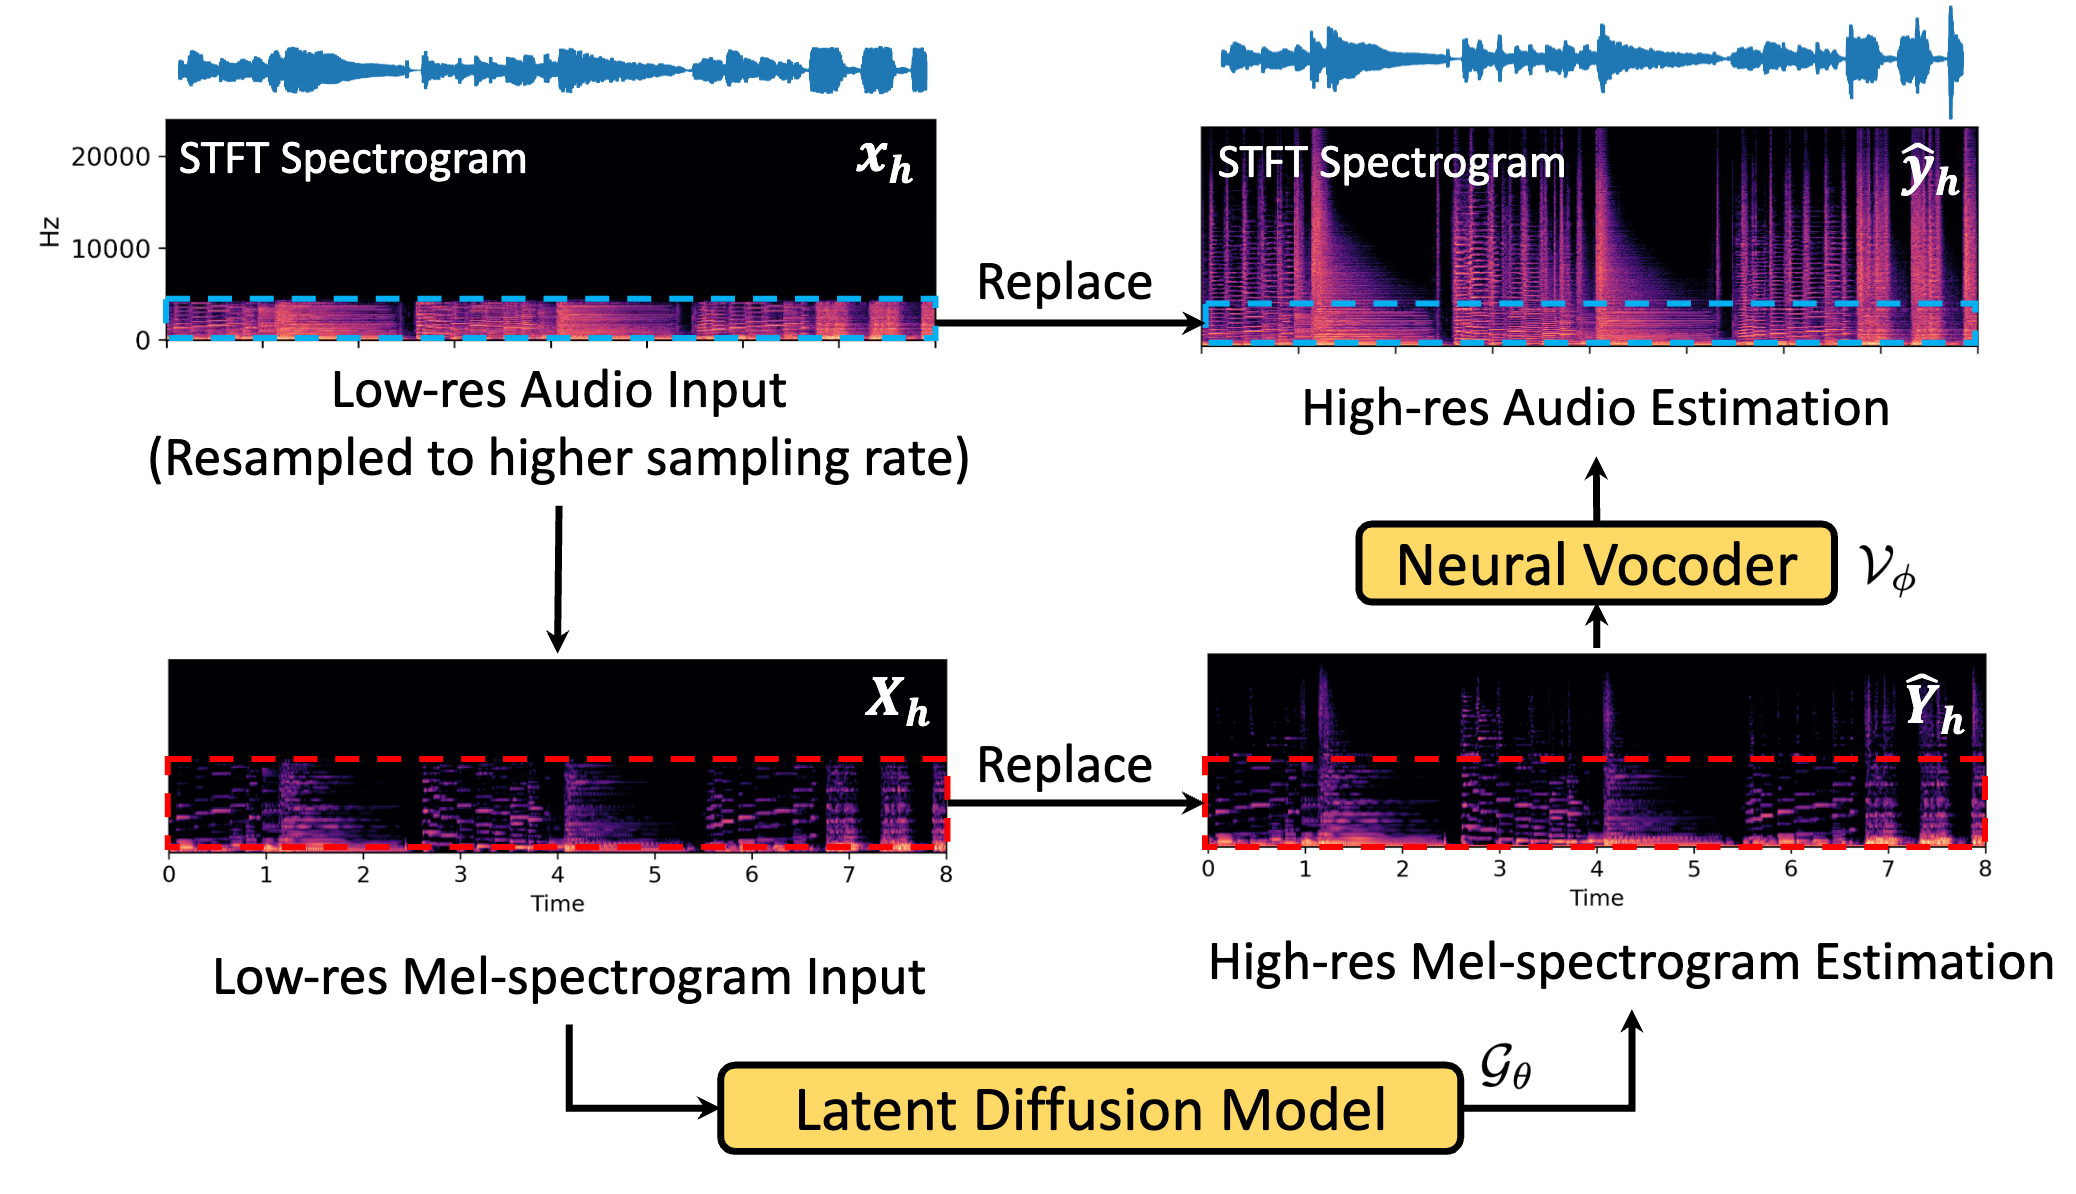
Figura originale: AudioSR.
AudioSR converte la registrazione in uno spettrogramma mel, usa un modello di diffusione latente per stimare i dettagli ad alta frequenza mancanti e trasforma il risultato in una forma d'onda con un vocoder. Il post-processing rimette poi le basse frequenze originali della sorgente al posto di quelle generate. Il risultato è una ricostruzione plausibile, non il recupero esatto dell'audio perduto, e non è semplicemente rumore aggiunto.
Dove puoi eseguire AudioSR?
| Opzione | Uso più adatto | Configurazione e compromessi |
|---|---|---|
| Neural Analog AudioSR Online (consigliato) | Restauro stereo con elaborazione centro/differenza e frequenza di taglio personalizzabile | Carica, ascolta l'anteprima ed esporta online. Non servono un'installazione Python o una GPU locale. |
| Repository GitHub ufficiale | Esperimenti locali e script Python | Installa le dipendenze, scarica i pesi e fornisci le risorse di calcolo. |
| Notebook AudioSR Colab | Esperimenti con le GPU cloud di Google | Apri il notebook della community e segui le istruzioni nel browser. |
| Space Hugging Face | Una dimostrazione rapida nel browser | Distribuzione della community; disponibilità e quote GPU possono cambiare. |
| AudioSR su Replicate | Predizioni ospitate e integrazione API | Fatturazione a consumo; nessuna installazione locale del modello. |
Neural Analog elabora separatamente le informazioni di centro e differenza dell'audio stereo. Puoi anche impostare la frequenza di taglio da cui AudioSR inizia a rigenerare i dettagli. Un taglio più basso cambia una parte maggiore del suono, mentre uno più alto completa solo l'estremo acuto.
Requisiti di AudioSR: Python, memoria GPU e spazio su disco
AudioSR è un modello pesante, soprattutto per brani completi. Il checkpoint di base ufficiale occupa circa 6,2 GB su disco, e l'inferenza richiede più memoria dei pesi archiviati. Una GPU NVIDIA con molta memoria aiuta, ma la dimensione del checkpoint non è un valore minimo di VRAM: la durata del segmento e l'implementazione influiscono anch'esse sull'uso della memoria. Il README ufficiale non pubblica un requisito GPU minimo.
Input lunghi possono esaurire la memoria GPU. Inizia con un breve segmento, poi elabora le registrazioni più lunghe in parti più piccole.
Prepara queste dipendenze prima di iniziare:
- Python in un ambiente isolato. L'esempio del progetto originale usa Python 3.9. Questa guida usa Python 3.10, che funziona con le vecchie versioni di NumPy richieste da AudioSR. Un ambiente virtuale tiene questi pacchetti separati dal Python di sistema.
- Git e uv. Installa Git e uv per scaricare il codice sorgente e gestire l'ambiente Python.
- PyTorch e un driver GPU adeguato. Gli utenti NVIDIA devono usare una versione di PyTorch compatibile con CUDA. Abbina le versioni di PyTorch, TorchAudio e TorchVision mediante la matrice ufficiale di installazione.
- FFmpeg, incluso ffprobe. Il codice originale di salvataggio dei file usa questi comandi. Installali tramite le opzioni di download di FFmpeg e rendili disponibili nel terminale.
- Spazio libero su disco e connessione internet. Prevedi spazio per l'ambiente, i pesi scaricati, i file di input e le uscite. Il primo caricamento del modello scarica il suo checkpoint.
Il codice originale di selezione del dispositivo riconosce CUDA, Apple MPS e CPU. L'elaborazione su CPU può essere molto lenta. Il riconoscimento di MPS nel controllo del dispositivo non garantisce che ogni dipendenza e operazione funzioni su tutti i Mac.
Come installare AudioSR da GitHub
1. Scarica il repository ufficiale e crea un ambiente Python
Esegui questi comandi in un terminale:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Attiva l'ambiente su Linux o macOS:
source .venv/bin/activateSu Windows PowerShell usa invece questo comando di attivazione:
.venv\Scripts\Activate.ps12. Installa dipendenze compatibili e AudioSR
AudioSR impone vincoli su vecchie dipendenze, tra cui NumPy 1.23.5 o precedente e Transformers 4.30.2. Installare le versioni più recenti di Python e PyTorch può causare errori di compatibilità. I requisiti del pacchetto e l'ambiente di riferimento del progetto sono utili punti di partenza.
Per esempio, l'ambiente di riferimento abbina PyTorch 2.0.1, TorchAudio 2.0.2 e TorchVision 0.15.2. Su Linux o Windows con un driver NVIDIA adeguato, installa questa combinazione per CUDA 11.7, poi il codice sorgente di AudioSR che hai scaricato:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
Il comando CUDA è per i sistemi NVIDIA. Per macOS o CPU, usa le istruzioni corrispondenti della matrice PyTorch. Queste sono versioni datate delle dipendenze, quindi tieni questo ambiente separato dagli altri progetti Python.
Se ti serve solo il pacchetto pubblicato, il README ufficiale documenta anche audiosr==0.0.7. Questa versione e l'attuale ramo main di GitHub possono avere funzionalità diverse, quindi controlla python -m audiosr --help per la versione che hai installato.
3. Verifica che Python rilevi la tua GPU
Esegui questo controllo nell'ambiente attivato su una macchina NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Se CUDA non è disponibile, correggi l'installazione del driver o di PyTorch prima di avviare un'elaborazione lunga. Aggiungere -d cuda ad AudioSR non può far funzionare una GPU non disponibile.
AudioSR da riga di comando: inizia con un WAV breve
Usa un WAV mono breve per la prima esecuzione. Il caricatore audio originale consiglia input di 5,12 secondi e avverte della qualità oltre 10,24 secondi. Un brano completo rende più difficile diagnosticare problemi di configurazione e memoria.
Metti input.wav nella directory del repository, poi esegui:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42L'implementazione della riga di comando salva un WAV a 48 kHz in una cartella con data e ora sotto output. Usa basic per l'audio generale o speech per le registrazioni di parlato. Il seed controlla le variazioni generate; confrontare alcuni seed può aiutarti a scegliere un risultato migliore.
Se la generazione termina ma il salvataggio restituisce numpy.ndarray has no attribute cpu, usa l'esempio Python seguente per scrivere direttamente l'uscita. Nel codice GitHub verificato per questa guida, l'inferenza restituisce un array NumPy, ma la funzione di salvataggio si aspetta un tensore. È un'incompatibilità del tipo di uscita nel progetto originale, non un errore di memoria GPU.
Il codice GitHub attuale offre anche la suddivisione in segmenti per file più lunghi:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1La suddivisione elabora parti più piccole e miscela le loro sovrapposizioni. Riduce l'uso della memoria, ma aggiunge giunzioni che devi controllare all'ascolto. Questi parametri dipendono dalla versione, e il percorso originale a segmenti miscela l'input stereo in mono, quindi conserva il file stereo originale.
Come usare AudioSR da Python
Usa l'API Python per chiamare AudioSR dal tuo script. L'esempio seguente elabora un file mono breve, taglia il riempimento aggiuntivo fino alla durata dell'input e scrive un WAV a 48 kHz. Salvalo come run_audiosr.py nella directory del repository.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyLa pipeline Python carica il modello una volta sola, quindi uno script di elaborazione in batch può riutilizzarlo. In Neural Analog, l'elaborazione in batch applica un restauro a molti file senza script. Imposta esplicitamente il numero di passi di campionamento, perché l'API Python e la CLI possono usare valori predefiniti diversi.
Come eseguire AudioSR in Google Colab
Google Colab permette di eseguire AudioSR sull'hardware cloud di Google. Apri il notebook AudioSR Colab della community e segui le istruzioni per caricare l'audio, eseguire il modello e salvare il risultato. Il notebook gira nel browser, quindi non devi installare Python o avere una GPU nel computer.
Il notebook è un adattamento di AudioSR realizzato dalla community. Il suo codice sorgente è disponibile su GitHub.
Dove puoi scaricare i pesi del modello AudioSR?
Scarica i pesi del modello AudioSR su Hugging Face.
Dettagli del modello AudioSR: architettura, addestramento e storia
Chi ha creato AudioSR?
AudioSR è un modello generativo di super-risoluzione audio di Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang e Mark D. Plumbley. Predice le alte frequenze mancanti in parlato, musica ed effetti sonori e produce audio a 48 kHz. La pagina di ricerca di AudioSR include il paper ed esempi da ascoltare. Il lavoro è apparso inizialmente come preprint nel settembre 2023 ed è stato pubblicato a ICASSP 2024.
AudioSR genera dettagli plausibili. Non può recuperare una copia esatta di un master di studio perduto. Convertire un MP3 in WAV a 48 kHz non esegue affatto questa ricostruzione. Per capire la differenza, consulta la guida al restauro di file MP3 in WAV.
Restauro, ricampionamento e larghezza di banda sono diversi
Il ricampionamento cambia il numero di campioni che rappresentano ogni secondo di audio. Il restauro audio, o super-risoluzione, cerca di stimare il contenuto in frequenza che la registrazione non contiene più. Per esempio, ricampionare una registrazione da 8 kHz a 48 kHz le dà più campioni, ma non ripristina da solo i suoni sopra il suo limite originale di frequenza di 4 kHz.
AudioSR lavora con larghezze di banda in ingresso da 2 a 16 kHz e genera un'uscita con larghezza di banda di 24 kHz a una frequenza di campionamento di 48 kHz, secondo la descrizione ufficiale del progetto. La larghezza di banda descrive l'intervallo di frequenze; la frequenza di campionamento descrive i campioni al secondo. Un file indicato come 48 kHz può comunque avere una banda stretta a causa di compressione o filtraggio precedenti. È il caso di molti brani generati con l'IA, e per questo i brani Suno suonano spesso ovattati.
AudioSR è stato il primo modello di restauro audio?
AudioSR non è stato il primo modello neurale di super-risoluzione audio. Kuleshov, Enam ed Ermon hanno pubblicato Super-risoluzione audio mediante reti neurali nel 2017, e anche la super-risoluzione del parlato basata sulla diffusione precede AudioSR.
Il suo contributo è più specifico. Il paper di AudioSR lo presenta come il primo sistema a coprire il dominio udibile generale: musica, parlato ed effetti sonori. Combina questa ampiezza con una banda di ingresso flessibile, senza aver introdotto la super-risoluzione audio in sé.
Dalla registrazione in ingresso a una forma d'onda a 48 kHz
AudioSR combina un autoencoder variazionale (VAE), un modello di diffusione latente condizionale e un vocoder neurale. Ogni componente gestisce una fase della ricostruzione:
| Fase | Cosa succede | Perché conta |
|---|---|---|
| Rappresentazione audio | L'input diventa uno spettrogramma mel: una mappa dell'energia sonora nel tempo e nella frequenza. | Il modello lavora su schemi di contenuto in frequenza. |
| Codifica VAE | Un encoder comprime lo spettrogramma in una rappresentazione più piccola chiamata latente. | La diffusione opera su meno valori rispetto a uno spettrogramma completo. |
| Diffusione condizionale | Un Transformer U-Net affina iterativamente un latente rumoroso, guidato dal latente di ingresso a bassa risoluzione. | La registrazione guida i dettagli generati; non serve un prompt testuale. |
| Decodifica e vocoder | Il VAE decodifica uno spettrogramma mel a risoluzione maggiore. Un vocoder basato su HiFi-GAN lo trasforma in una forma d'onda. | Uno spettrogramma deve essere riconvertito in campioni udibili. |
| Sostituzione delle frequenze | Le informazioni a bassa frequenza dell'input sostituiscono le bande generate corrispondenti. | Le informazioni esistenti aiutano a limitare i cambiamenti alla registrazione. |
La configurazione pubblicata del modello specifica una rappresentazione mel a 256 bande, un VAE e un U-Net con transformer spaziali. Concatena le caratteristiche passa-basso codificate dell'input con il latente di diffusione. È generazione condizionata dall'audio, anche se alcune descrizioni ereditate della CLI menzionano il testo.
Cosa controllano i passi di campionamento e la guida?
I passi di campionamento controllano quante iterazioni il modello dedica ad affinare la rappresentazione generata. AudioSR usa un campionatore DDIM. La guida controlla quanto il condizionamento dell'input orienta la generazione. Non è una quantità di EQ, e un valore più alto non garantisce una qualità maggiore. L'implementazione dell'inferenza applica in sequenza campionamento, decodifica, sostituzione delle frequenze e normalizzazione della forma d'onda.
Più passi di campionamento e registrazioni più lunghe richiedono più tempo di elaborazione. AudioSR è pensato per l'elaborazione non in tempo reale, e la velocità dipende dalla GPU e dalle impostazioni. Ridurre ddim_steps accelera la generazione, ma non risolve in modo affidabile gli errori di memoria GPU.
Come è stato addestrato AudioSR?
La sezione di addestramento del paper descrive circa 7.000 ore da MUSDB18-HQ, MoisesDB, MedleyDB, Freesound e dati di parlato OpenSLR. Filtri passa-basso con tagli variabili creano input degradati abbinati a obiettivi con una banda più ampia. Il modello di diffusione usa una programmazione cosinusoidale del rumore, la predizione della velocità e la guida senza classificatore. Il vocoder è basato su HiFi-GAN con un discriminatore multirisoluzione.
Le registrazioni reali possono differire da questi esempi di addestramento. Gli autori spiegano che tagli di frequenza irregolari, rumore forte e riverbero possono ridurre la qualità. La compressione MP3 può lasciare vuoti vicino al taglio. Il filtraggio passa-basso prima dell'inferenza può aiutare, ma un taglio troppo basso rimuove dettagli utili. Per registrazioni riverberanti, rimuovere il riverbero prima del restauro può dare al modello un input più pulito.
Non devi addestrare questi componenti per eseguire AudioSR. Il procedimento di installazione carica pesi preaddestrati.
Perché AudioSR usa il post-processing?
L'audio generato deve conservare le informazioni utili già presenti nella sorgente. AudioSR sostituisce le bande basse due volte: nello spettrogramma mel stimato prima del vocoder e nella rappresentazione con trasformata di Fourier a breve termine (STFT) della forma d'onda risultante. Il codice di sostituzione stima un taglio e regola l'uscita ricostruita.
Le registrazioni stereo e i brani completi richiedono una pipeline che gestisca canali, segmenti e ricostruzione. Il procedimento predefinito del repository produce audio mono: il caricatore standard prende il primo canale di ingresso, mentre la pipeline a segmenti miscela lo stereo in mono. Mantenere lo stereo richiede un'ulteriore gestione dei canali, come l'elaborazione separata di sinistra e destra nel notebook della community.
La ricostruzione va controllata all'ascolto. Le note della pipeline della community avvertono che una sovrapposizione eccessiva può causare cancellazioni di fase. Confronta il risultato a un volume simile e controlla gli acuti rigenerati, le giunzioni dei segmenti, la durata e l'immagine stereo. La sostituzione delle frequenze aiuta a conservare la sorgente, ma non garantisce una banda bassa invariata o giunzioni pulite.
Domande frequenti sugli errori di AudioSR
AudioSR è su PyPI?
Sì. Il README ufficiale installa audiosr==0.0.7 con pip oppure il codice più recente direttamente da GitHub. Il ramo main di GitHub ha funzionalità, come la suddivisione in segmenti, che la versione PyPI potrebbe non avere.
Quanta memoria GPU serve ad AudioSR?
Il README non indica un minimo. Il solo checkpoint di base occupa circa 6,2 GB su disco, e l'uso della memoria cresce con la durata del segmento. Inizia con un segmento di circa 5 secondi, poi usa la suddivisione per i file più lunghi.
Perché AudioSR fallisce con numpy.ndarray has no attribute cpu?
L'inferenza è terminata, ma il salvataggio si aspetta un tensore PyTorch e riceve un array NumPy. Usa lo script Python sopra, che scrive l'uscita con soundfile.
Perché l'uscita di AudioSR è mono?
Il caricatore predefinito legge solo il primo canale, e il percorso a segmenti miscela lo stereo in mono. Elabora separatamente i canali sinistro e destro oppure usa AudioSR Online, che elabora i canali di centro e differenza per te.
Il codice di addestramento di AudioSR è disponibile?
Sì. Il registro delle modifiche del README del 31 dicembre 2024 contiene un link al codice di addestramento, che l'autore descrive come solo per riferimento e non organizzato con cura.
Usa AudioSR con Neural Analog senza gestire l'installazione
Per evitare la configurazione locale, apri AudioSR Online, carica un file o importa un link musicale supportato e regola il restauro. Per Udio, salva o registra prima l'audio, poi carica il file. Puoi scegliere una frequenza di taglio, ascoltare l'anteprima del risultato elaborato ed esportare audio dalla stessa interfaccia.
Neural Analog gestisce l'elaborazione del modello online, quindi puoi usare un computer senza una GPU grande ed evitare l'installazione Python, il download dei checkpoint e la manutenzione dei notebook. Devi comunque ascoltare con attenzione critica, perché un servizio ospitato non elimina i limiti qualitativi del modello. Dopo il restauro, segui la guida al miglioramento audio per i passaggi successivi. Per la musica generata con l'IA, correggere la qualità audio dei brani IA tratta la riparazione degli stem e il mastering dopo il restauro.
Puoi anche confrontare AudioSR con modelli di restauro audio più recenti disponibili su Neural Analog, tra cui UniverSR e FlashSR. Le loro schede spiegano come funziona ciascuno, e la FAQ riassume come UniverSR differisce da AudioSR. Per un esempio completo, consulta tutti i 203 effetti sonori di RPG Maker 2000 restaurati a 48 kHz con UniverSR. Usali sulla stessa registrazione e confronta le anteprime per scegliere il risultato migliore.