AudioSR GitHub kurulum rehberi: AudioSR'ı yerel olarak çalıştırma
AudioSR, açık kaynaklı bir ses süper çözünürlük modelidir. Konuşma, müzik ve ses efektlerinde eksik yüksek frekans ayrıntılarını üreterek 48 kHz örnekleme hızında ses oluşturur. Resmî GitHub deposundan kurabilir veya Neural Analog ile AudioSR'ı online çalıştırabilirsiniz.
Yerel kurulum için depoyu klonlayın, uv ile Python 3.10 ortamı oluşturun, uyumlu bir PyTorch sürümü ve AudioSR kurun, ardından kısa bir WAV dosyasında python -m audiosr çalıştırın. Aşağıdaki adımlar her komutu açıklar.
AudioSR nasıl çalışır? Mimarinin açıklaması
AudioSR eksik yüksek frekansları nasıl yeniden oluşturur?
Giriş mel spektrogramı, daha geniş bantlı bir mel spektrogramı tahmin etmek için gizil difüzyonu koşullandırır. Girişin alt mel bantları vokoderden önce üretilen bantların yerini alır; alt STFT bantları ise vokoderden sonra üretilen bantların yerini alır. Model, kayıp kaydın tam kopyasını geri getirmek yerine makul eksik ayrıntılar üretir.
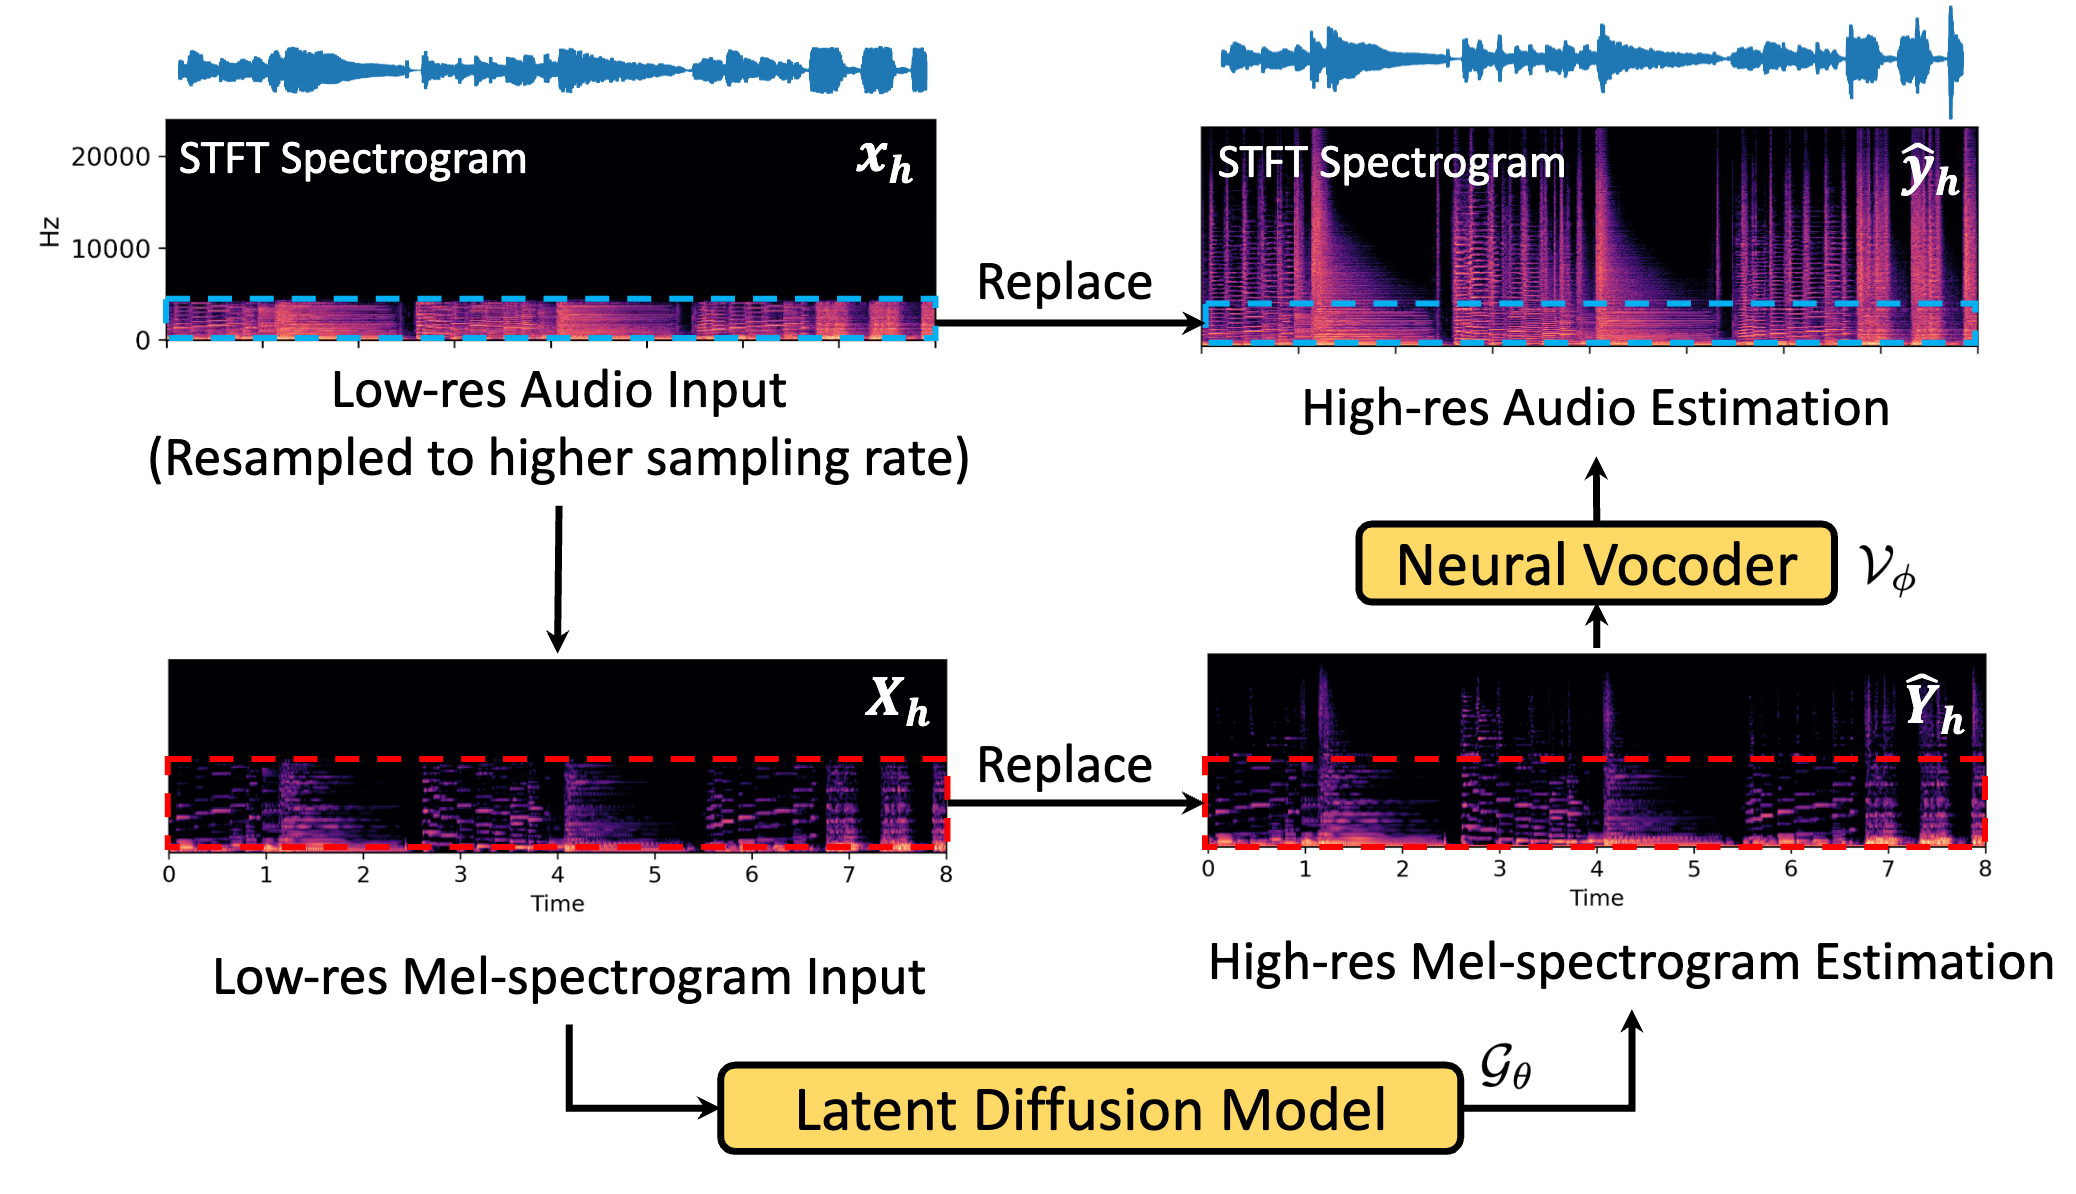
Orijinal şema: AudioSR.
AudioSR kaydı mel spektrogramına dönüştürür, gizil difüzyon modeliyle eksik yüksek frekans ayrıntılarını tahmin eder ve vokoderle sonucu yeniden dalga biçimine çevirir. Son işleme, üretilen alt frekansların yerine kaynağın özgün alt frekanslarını geri koyar. Sonuç, kayıp sesi birebir geri getirmek yerine makul bir yeniden oluşturmadır; yalnızca eklenen gürültü değildir.
AudioSR nerede çalıştırılabilir?
| Seçenek | En uygun kullanım | Kurulum ve ödünleşim |
|---|---|---|
| Neural Analog AudioSR Online (önerilir) | Merkez/fark işleme ve ayarlanabilir kesim frekansı ile stereo restorasyonu | Online yükleme, ön dinleme ve dışa aktarma. Python kurulumu veya yerel GPU gerekmez. |
| Resmî GitHub deposu | Yerel deneyler ve Python betikleri | Bağımlılıkları kurun, ağırlıkları indirin ve hesaplama kaynağını sağlayın. |
| AudioSR Colab not defteri | Google'ın bulut GPU'larıyla deneyler | Topluluk not defterini açın ve tarayıcınızda yönergeleri izleyin. |
| Hugging Face Space | Hızlı bir tarayıcı demosu | Topluluk dağıtımı; kullanılabilirlik ve GPU kotaları değişebilir. |
| Replicate üzerinde AudioSR | Barındırılan model çalıştırma ve API entegrasyonu | Kullanım bazlı ücretlendirme; yerel model kurulumu yoktur. |
Neural Analog stereo sesin merkez ve fark bilgilerini ayrı işler. AudioSR'ın ayrıntıları yeniden üretmeye başladığı kesim frekansını da ayarlayabilirsiniz. Düşük kesim, sesin daha büyük bölümünü değiştirirken yüksek kesim yalnızca üst frekansları tamamlar.
AudioSR gereksinimleri: Python, GPU belleği ve disk alanı
AudioSR özellikle tam şarkılar için ağır bir modeldir. Resmî temel kontrol noktası diskte yaklaşık 6,2 GB yer kaplar ve çıkarım, saklanan ağırlıklardan daha fazla bellek gerektirir. Büyük bir NVIDIA GPU yardımcı olur, ancak kontrol noktası boyutu minimum VRAM değeri değildir: klip uzunluğu ve uygulama da bellek kullanımını etkiler. Resmî README minimum GPU gereksinimi yayımlamaz.
Uzun girdiler GPU belleğini tüketebilir. Kısa bir kliple başlayın, ardından uzun kayıtları küçük parçalarda işleyin.
Başlamadan önce şu bağımlılıkları hazırlayın:
- Yalıtılmış ortamda Python. Özgün örnek Python 3.9 kullanır. Bu rehber, AudioSR'ın gerektirdiği eski NumPy sürümleriyle çalışan Python 3.10 kullanır. Sanal ortam bu paketleri sistem Python'undan ayrı tutar.
- Git ve uv. Kaynak kodunu indirmek ve Python ortamını yönetmek için Git ve uv kurun.
- PyTorch ve uygun GPU sürücüsü. NVIDIA kullanıcıları için CUDA uyumlu bir PyTorch sürümü gerekir. PyTorch, TorchAudio ve TorchVision sürümlerini resmî kurulum tablosuyla eşleştirin.
- ffprobe dâhil FFmpeg. Özgün dosya kaydetme kodu bu komutları kullanır. FFmpeg indirme seçenekleriyle kurun ve terminalde erişilebilir olmalarını sağlayın.
- Boş disk alanı ve internet bağlantısı. Ortam, indirilen model ağırlıkları, giriş dosyaları ve çıktılar için alan ayırın. Model ilk yüklendiğinde kontrol noktası indirilir.
Özgün cihaz seçme kodu CUDA, Apple MPS ve CPU'yu tanır. CPU işleme çok yavaş olabilir. Cihaz kontrolünde MPS desteği bulunması, her bağımlılık ve işlemin her Mac'te çalışacağını garanti etmez.
AudioSR GitHub'dan nasıl kurulur?
1. Resmî depoyu indirin ve Python ortamı oluşturun
Şu komutları terminalde çalıştırın:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Linux veya macOS'ta ortamı etkinleştirin:
source .venv/bin/activateWindows PowerShell'de bunun yerine şu etkinleştirme komutunu kullanın:
.venv\Scripts\Activate.ps12. Uyumlu bağımlılıkları ve AudioSR'ı kurun
AudioSR'ın NumPy 1.23.5 veya öncesi ve Transformers 4.30.2 dâhil eski bağımlılık kısıtları vardır. En yeni Python ve PyTorch sürümlerini kurmak uyumluluk hatalarına yol açabilir. Projenin paket gereksinimleri ve referans ortamı yararlı başlangıç noktalarıdır.
Örneğin referans ortamı PyTorch 2.0.1, TorchAudio 2.0.2 ve TorchVision 0.15.2'yi eşleştirir. Uygun NVIDIA sürücüsü olan Linux veya Windows'ta bu CUDA 11.7 birleşimini, ardından indirdiğiniz AudioSR kaynak kodunu kurun:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
CUDA komutu NVIDIA sistemleri içindir. macOS veya CPU için PyTorch tablosundaki eşleşen yönergeleri kullanın. Bunlar eski bağımlılık sürümleridir; bu nedenle ortamı diğer Python projelerinden ayrı tutun.
Yalnızca yayımlanan paket gerekiyorsa resmî README, audiosr==0.0.7 kurulumunu da belgeler. Bu sürüm ile GitHub'ın mevcut main dalı farklı özelliklere sahip olabilir; bu nedenle kurduğunuz sürüm için python -m audiosr --help kontrol edin.
3. Python'un GPU'nuzu gördüğünü kontrol edin
Bu kontrolü NVIDIA bilgisayarda etkinleştirilmiş ortamın içinde çalıştırın:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
CUDA kullanılamıyorsa uzun bir işe başlamadan önce sürücüyü veya PyTorch kurulumunu düzeltin. AudioSR'a -d cuda eklemek, kullanılamayan GPU'yu çalıştıramaz.
AudioSR komut satırı kullanımı: kısa bir WAV ile başlayın
İlk çalıştırma için kısa bir mono WAV kullanın. Özgün ses yükleyicisi 5,12 saniyelik girdileri önerir ve 10,24 saniyenin üzerinde kalite konusunda uyarır. Tam şarkı, kurulum ve bellek sorunlarını tanılamayı zorlaştırır.
input.wav dosyasını depo dizinine koyun, ardından çalıştırın:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42Komut satırı uygulaması, 48 kHz örnekleme hızındaki WAV çıktısını output altında zaman damgalı klasöre kaydeder. Genel ses için basic, konuşma kayıtları için speech kullanın. Rastgele sayı üretecinin başlangıç değeri üretilen çeşitliliği kontrol eder; birkaç başlangıç değerini karşılaştırmak daha iyi sonuç seçmenize yardımcı olabilir.
Üretim tamamlanıp kaydetme sırasında numpy.ndarray has no attribute cpu hatası oluşursa çıktıyı doğrudan yazmak için aşağıdaki Python örneğini kullanın. Bu rehber için kontrol edilen GitHub kaynağında çıkarım NumPy dizisi döndürür, ancak dosya kaydetme işlevi tensör bekler. Bu, özgün projenin çıktı türü uyuşmazlığıdır; GPU belleği hatası değildir.
Mevcut GitHub kodu, uzun dosyalar için parçalara bölmeyi de sunar:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Parçalı işleme küçük bölümleri işler ve örtüşen alanları harmanlar. Bellek kullanımını azaltır, ancak dinleyerek kontrol etmeniz gereken birleşim noktaları ekler. Bu bayraklar sürüme özeldir ve özgün parçalı yol stereo girdiyi monoya indirger; bu nedenle özgün stereo dosyayı koruyun.
AudioSR Python'dan nasıl kullanılır?
AudioSR'ı kendi betiğinizden çağırmak için Python API'sini kullanın. Aşağıdaki örnek kısa bir mono dosyayı işler, dolgu kısmını giriş süresine göre keser ve 48 kHz örnekleme hızında WAV yazar. Depo dizininde run_audiosr.py olarak kaydedin.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPython işlem zinciri modeli bir kez yükler; böylece toplu işleme betiği modeli yeniden kullanabilir. Neural Analog'da toplu işleme betik olmadan birçok dosyada aynı restorasyonu çalıştırır. Python API ve CLI farklı varsayılanlar kullanabildiği için örnekleme adımı sayısını açıkça ayarlayın.
AudioSR Google Colab'de nasıl çalıştırılır?
Google Colab, AudioSR'ı Google'ın bulut donanımında çalıştırmanızı sağlar. Topluluk AudioSR Colab not defterini açın ve sesi yüklemek, modeli çalıştırmak ve sonucu kaydetmek için yönergeleri izleyin. Not defteri tarayıcınızda çalışır; bilgisayarınızda Python kurulumu veya GPU gerekmez.
Not defteri AudioSR'ın topluluk uyarlamasıdır. Kaynağı GitHub'da bulunur.
AudioSR model ağırlıkları nereden indirilir?
Hugging Face'teki AudioSR model ağırlıklarını indirin.
AudioSR model ayrıntıları: mimari, eğitim ve tarihçe
AudioSR'ı kim geliştirdi?
AudioSR, Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang ve Mark D. Plumbley tarafından geliştirilen üretken bir ses süper çözünürlük modelidir. Konuşma, müzik ve ses efektlerinde eksik yüksek frekansları tahmin eder ve 48 kHz örnekleme hızında ses üretir. AudioSR araştırma sayfasında makale ve dinleme örnekleri bulunur. Çalışma önce Eylül 2023 ön baskısı olarak çıktı ve ICASSP 2024'te yayımlandı.
AudioSR makul ayrıntılar üretir. Kayıp stüdyo master'ının tam kopyasını geri getiremez. MP3'ü 48 kHz WAV'a dönüştürmek bu yeniden oluşturmayı hiç yapmaz. Bu ayrım için MP3 dosyalarını WAV'a restore etme rehberine bakın.
Ses restorasyonu, yeniden örnekleme ve bant genişliği farklıdır
Yeniden örnekleme, sesin her saniyesini temsil eden örnek sayısını değiştirir. Ses restorasyonu veya süper çözünürlük, kayıtta artık bulunmayan frekans içeriğini tahmin etmeye çalışır. Örneğin 8 kHz kaydı 48 kHz'e yeniden örneklemek daha çok örnek verir, ancak tek başına özgün 4 kHz frekans sınırının üzerindeki sesleri geri oluşturmaz.
Resmî proje açıklamasına göre AudioSR 2 ile 16 kHz arasındaki giriş bant genişliklerini hedefler ve 48 kHz örnekleme hızında 24 kHz bant genişliğinde çıktı üretir. Bant genişliği frekans aralığını, örnekleme hızı saniyedeki örnek sayısını anlatır. 48 kHz etiketli bir dosya, önceki sıkıştırma veya filtreleme nedeniyle hâlâ dar bantlı olabilir. Birçok AI şarkı böyledir; bu da Suno şarkılarının neden sıkça boğuk duyulduğunu açıklar.
AudioSR ilk ses restorasyonu modeli miydi?
AudioSR ilk sinir ağı tabanlı ses restorasyonu modeli değildi. Kuleshov, Enam ve Ermon 2017'de “Sinir Ağları Kullanarak Ses Süper Çözünürlüğü” çalışmasını yayımladı; difüzyon tabanlı konuşma restorasyonu da AudioSR'dan önce vardı.
Katkısı daha sınırlıdır. AudioSR makalesi, modeli genel işitilebilir alanı kapsayan ilk sistem olarak sunar: müzik, konuşma ve ses efektleri. Ses süper çözünürlüğünü ilk kez ortaya koymak yerine bu kapsamı esnek giriş bant genişliğiyle birleştirir.
Giriş kaydından 48 kHz dalga biçimine
AudioSR bir varyasyonel otokodlayıcı (VAE), koşullu gizil difüzyon modeli ve sinir ağı tabanlı vokoderi birleştirir. Her bileşen yeniden oluşturmanın bir aşamasını işler:
| Aşama | Ne olur? | Neden önemlidir? |
|---|---|---|
| Ses temsili | Girdi mel spektrogramına dönüşür: zaman ve frekans boyunca ses enerjisi haritası. | Model frekans içeriği örüntüleriyle çalışır. |
| VAE kodlama | Kodlayıcı spektrogramı gizil adı verilen küçük bir temsile sıkıştırır. | Difüzyon tam spektrogramdan daha az değerle çalışır. |
| Koşullu difüzyon | Transformer U-Net, düşük çözünürlüklü girişin gizil temsiliyle yönlendirilerek gürültülü gizil temsili yinelemeli olarak iyileştirir. | Kayıt üretilen ayrıntıyı yönlendirir; metin istemi gerekmez. |
| Kod çözme ve vokoder | VAE daha yüksek çözünürlüklü mel spektrogramını çözer. HiFi-GAN tabanlı vokoder bunu dalga biçimine dönüştürür. | Spektrogramın yeniden duyulabilir örneklere dönüştürülmesi gerekir. |
| Frekans değiştirme | Girişteki alt frekans bilgisi, karşılık gelen üretilmiş bantların yerini alır. | Mevcut bilgi, kayıttaki değişiklikleri sınırlamaya yardımcı olur. |
Yayımlanan model yapılandırması, 256 bantlı mel temsili, VAE ve uzamsal transformer'lar içeren U-Net belirtir. Girişin kodlanmış alçak geçiren özelliklerini difüzyonun gizil temsiliyle birleştirir. Bazı devralınmış CLI açıklamaları metinden söz etse de bu, ses koşullu üretimdir.
Örnekleme adımları ve yönlendirme gücü neyi kontrol eder?
Örnekleme adımları modelin ürettiği temsili iyileştirmek için harcadığı yineleme sayısını kontrol eder. AudioSR DDIM örnekleyicisi kullanır. Yönlendirme gücü, giriş koşulunun üretimi ne kadar güçlü yönlendirdiğini kontrol eder. EQ miktarı değildir ve yüksek değer daha yüksek kaliteyi garanti etmez. Çıkarım uygulaması örnekleme, kod çözme, frekans değiştirme ve dalga biçimi normalizasyonunu sırayla uygular.
Daha çok örnekleme adımı ve uzun kayıtlar daha çok işleme zamanı alır. AudioSR gerçek zaman dışında işleme için tasarlanmıştır; gerçek hız GPU ve ayarlarınıza bağlıdır. ddim_steps azaltmak üretimi hızlandırır, ancak GPU bellek hatalarını güvenilir biçimde çözmez.
AudioSR nasıl eğitildi?
Makalenin eğitim bölümü, MUSDB18-HQ, MoisesDB, MedleyDB, Freesound ve OpenSLR konuşma verilerinden yaklaşık 7.000 saat anlatır. Farklı kesim frekanslı alçak geçiren filtreler, daha geniş bantlı hedeflerle eşleştirilmiş bozulmuş girdiler oluşturur. Difüzyon modeli kosinüs gürültü çizelgesi, hız tahmini ve sınıflandırıcısız yönlendirme kullanır. Vokoder, çok çözünürlüklü bir ayırt edici kullanan HiFi-GAN'a dayanır.
Gerçek kayıtlar bu eğitim örneklerinden farklı olabilir. Yazarlar düzensiz frekans kesimleri, ağır gürültü ve yankılanmanın kaliteyi düşürebileceğini açıklar. MP3 sıkıştırması kesim yakınında boşluk bırakabilir. Çıkarımdan önce alçak geçiren filtreleme yardımcı olabilir, ancak çok düşük kesim yararlı ayrıntıyı kaldırır. Yankılanmalı kayıtlarda restorasyondan önce yankılanmayı gidermek modele daha temiz bir girdi verebilir.
AudioSR çalıştırmak için bu bileşenleri eğitmeniz gerekmez. Kurulum önceden eğitilmiş ağırlıkları yükler.
AudioSR neden son işleme kullanır?
Üretilen ses kaynakta zaten bulunan yararlı bilgiyi korumalıdır. AudioSR alt bantları iki kez değiştirir: vokoderden önce tahmin edilen mel spektrogramında ve ortaya çıkan dalga biçiminin kısa zamanlı Fourier dönüşümü (STFT) temsilinde. Değiştirme kodu kesim frekansı tahmin eder ve yeniden oluşturulan çıktıyı ayarlar.
Stereo kayıtlar ve tam şarkılar, kanalları, parçaları ve yeniden oluşturmayı yöneten işlem zinciri gerektirir. Deponun varsayılan iş akışı mono ses üretir: standart yükleyici ilk giriş kanalını alır; parçalı işlem zinciri ise stereoyu monoya indirger. Stereoyu korumak, topluluk not defterindeki sol ve sağ kanalların ayrı işlenmesi gibi ek kanal yönetimi gerektirir.
Yeniden oluşturma dinleme kontrolü gerektirir. Topluluk işlem zinciri notları, aşırı örtüşmenin faz iptallerine neden olabileceği konusunda uyarır. Sonucu benzer algılanan ses yüksekliğinde karşılaştırın; yeniden üretilen yüksek frekansları, parça birleşimlerini, süreyi ve stereo görüntüyü kontrol edin. Frekans değiştirme kaynağı korumaya yardımcı olur, ancak alt bandın değişmemesini veya temiz birleşimleri garanti etmez.
AudioSR sorun giderme hakkında sık sorulan sorular
AudioSR PyPI'da var mı?
Evet. Resmî README, pip ile audiosr==0.0.7 veya doğrudan GitHub'dan en yeni kodun kurulumunu anlatır. GitHub main dalında, PyPI sürümünde bulunmayabilen parçalı işleme gibi özellikler vardır.
AudioSR ne kadar GPU belleği gerektirir?
README minimum belirtmez. Temel kontrol noktası tek başına diskte yaklaşık 6,2 GB'dır ve bellek kullanımı klip uzunluğuyla artar. Yaklaşık 5 saniyelik bir kliple başlayın, ardından uzun dosyalarda parçalı işleme kullanın.
AudioSR neden numpy.ndarray has no attribute cpu hatası verir?
Çıkarım tamamlanmıştır, ancak kaydetme adımı PyTorch tensörü beklerken NumPy dizisi alır. Çıktıyı soundfile ile yazan yukarıdaki Python betiğini kullanın.
AudioSR çıktım neden mono?
Varsayılan yükleyici yalnızca ilk kanalı okur, parçalı yol ise stereoyu monoya indirger. Sol ve sağ kanalları ayrı işleyin veya sizin için merkez ve fark kanallarını işleyen AudioSR Online kullanın.
AudioSR eğitim kodu mevcut mu?
Evet. README'nin 31 Aralık 2024 değişiklik günlüğü eğitim koduna bağlantı verir; yazar bunu yalnızca referans amaçlı ve özenle düzenlenmemiş olarak tanımlar.
Kurulumla uğraşmak yerine AudioSR'ı Neural Analog ile çalıştırın
Yerel kurulumu atlamak için AudioSR Online açın, bir dosya yükleyin veya desteklenen müzik bağlantısını içe aktarın ve restorasyon ayarlarını düzenleyin. Udio için önce sesi kaydedin veya bir ses kaydı alın, ardından dosyayı yükleyin. Kesim frekansı seçebilir, işlenmiş sonucu ön dinleyebilir ve aynı arayüzden sesi dışa aktarabilirsiniz.
Neural Analog modeli online işler; böylece büyük GPU'su olmayan bilgisayar kullanabilir ve Python kurulumu, kontrol noktası indirme ve not defteri bakımını atlayabilirsiniz. Barındırılan iş akışı modelin kalite sınırlamalarını ortadan kaldırmadığı için yine eleştirel dinlemeniz gerekir. Restorasyondan sonra sonraki adımlar için ses iyileştirme rehberini izleyin. AI müzik için AI şarkılarının ses kalitesini düzeltme, restorasyon sonrası stem onarımı ve mastering'i anlatır.
AudioSR'ı Neural Analog'daki UniverSR ve FlashSR dâhil yeni ses restorasyonu modelleriyle de karşılaştırabilirsiniz. Model kartları her birinin nasıl çalıştığını açıklar; SSS ise UniverSR'ın AudioSR'dan farkını özetler. Uygulanmış örnek için UniverSR ile 48 kHz'e restore edilen 203 RPG Maker 2000 ses efektinin tamamına bakın. En iyi sonucu seçmek için modelleri aynı kayıtta çalıştırın ve ön dinlemeleri karşılaştırın.