AudioSR GitHub 安装指南:如何在本地运行 AudioSR
AudioSR 是开源音频超分辨率模型。它为语音、音乐与音效生成缺失的高频细节,输出 48 kHz 音频。您可以从官方 GitHub 仓库安装,或通过 Neural Analog 在线运行 AudioSR。
本地安装时,先克隆仓库,用 uv 创建 Python 3.10 环境,安装兼容的 PyTorch 构建版本与 AudioSR,再对短 WAV 文件运行 python -m audiosr。下面逐一介绍各条命令。
AudioSR 如何工作?架构说明
AudioSR 如何重建缺失高频
输入梅尔频谱图作为潜空间扩散的条件,用于估计带宽更完整的梅尔频谱图。声码器处理前,用输入的梅尔低频带替换生成频带;声码器处理后,用输入的 STFT 低频带替换生成频带。模型生成合理的缺失细节,并不能精确还原丢失的录音。
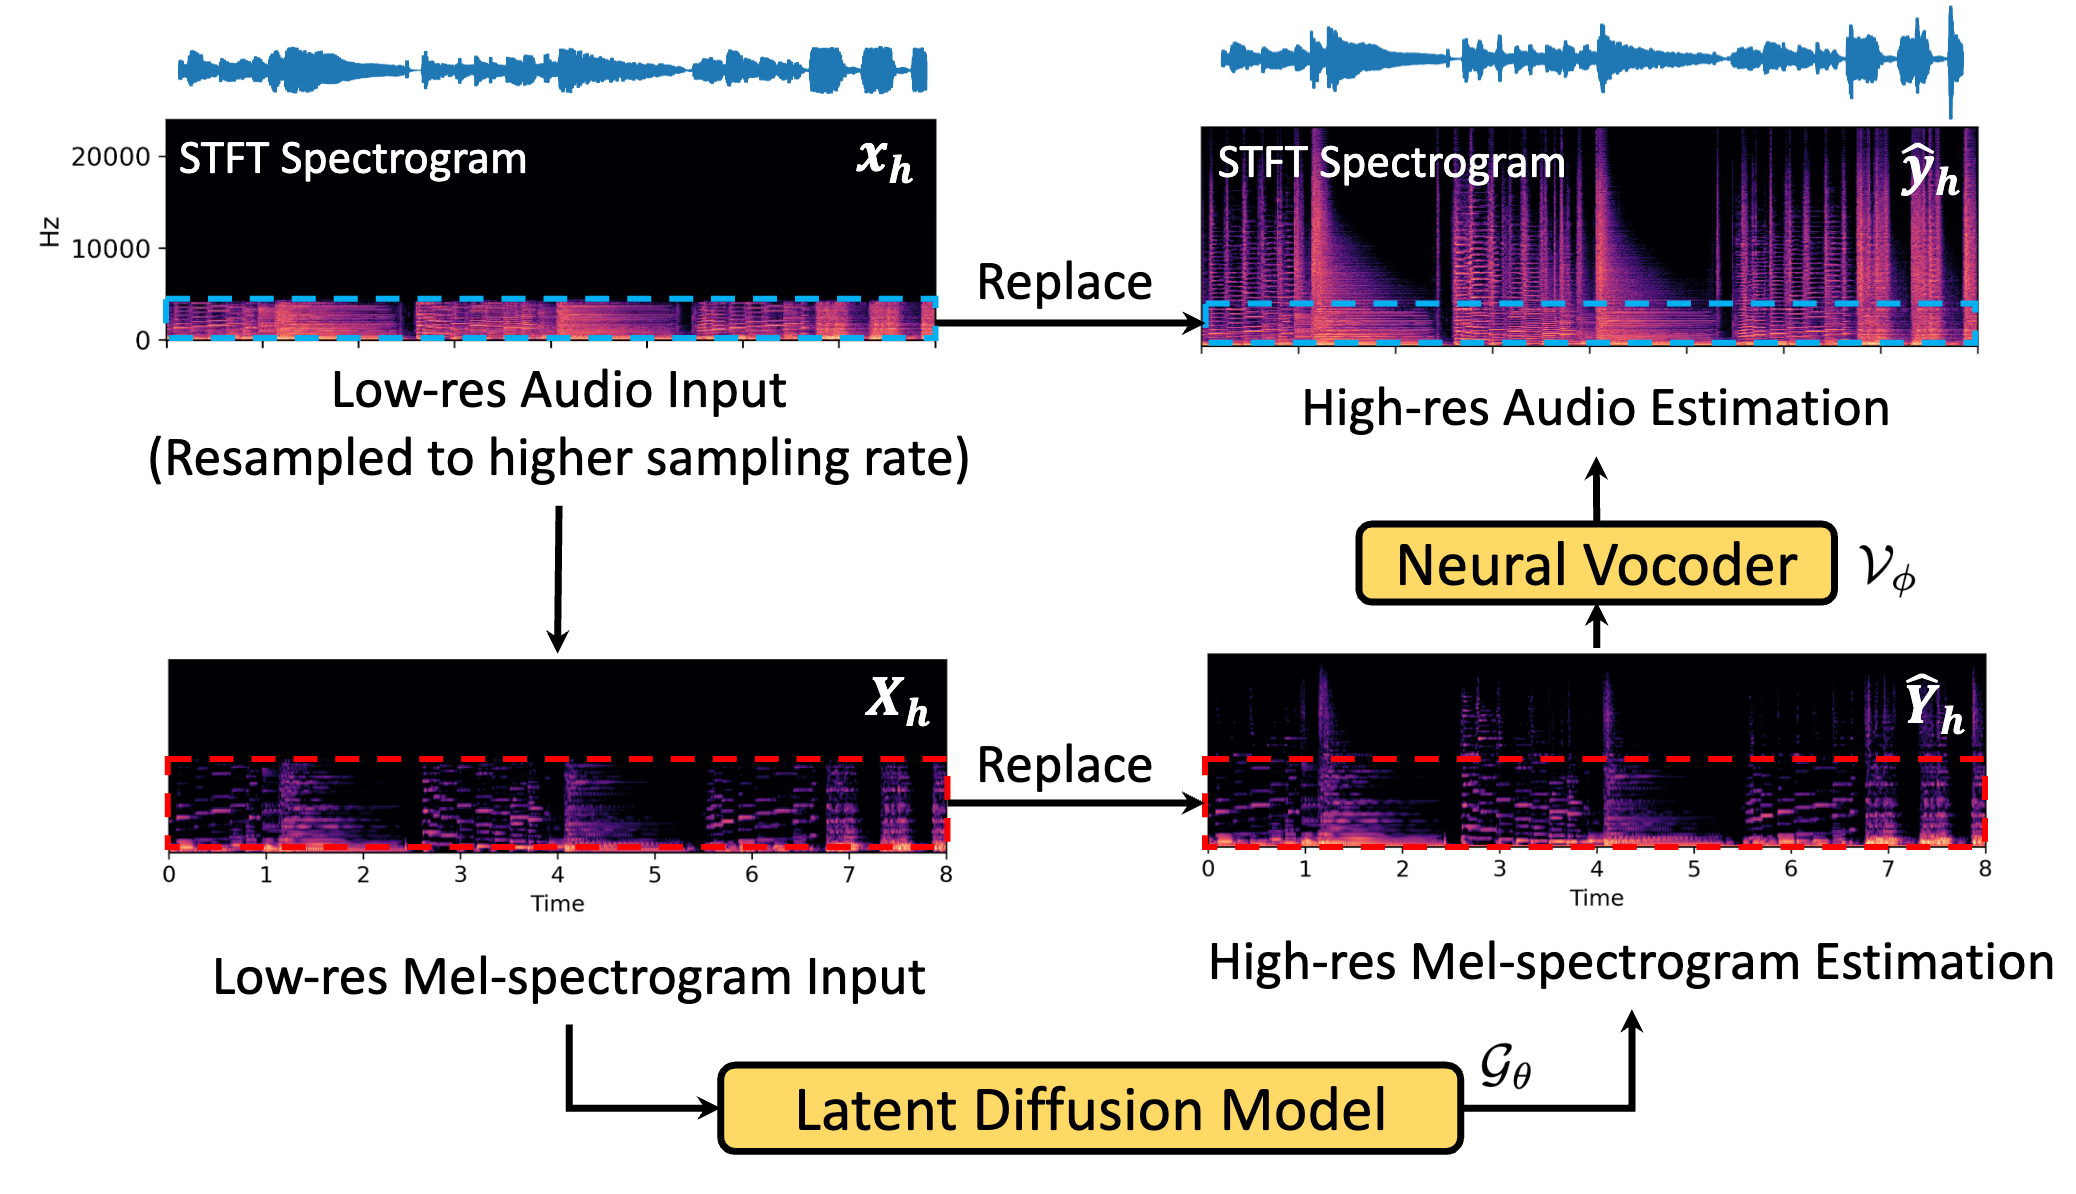
原始图示: AudioSR。
AudioSR 将录音转换成梅尔频谱图,用潜空间扩散模型估计缺失的高频细节,再通过声码器将结果转回波形。后处理会用源音频原有的低频替换生成的对应频率。结果是合理的重建,并非精确找回丢失的音频,而且并不只是添加噪声。
可以在哪里运行 AudioSR?
| 选项 | 适合用途 | 配置与取舍 |
|---|---|---|
| Neural Analog 在线 AudioSR(推荐) | 具有 Mid/Side 处理与可自定义截止频率的立体声修复 | 在线上传、试听与导出。无需安装 Python 或配备本地 GPU。 |
| 官方 GitHub 仓库 | 本地实验与 Python 脚本 | 安装依赖、下载权重并提供算力。 |
| AudioSR Colab 笔记本 | 使用 Google 云端 GPU 做实验 | 打开社区笔记本,在浏览器中按说明操作。 |
| Hugging Face Space | 快速浏览器演示 | 社区部署;可用性与 GPU 额度可能变化。 |
| Replicate 上的 AudioSR | 托管推理与 API 集成 | 按使用量计费;无需本地安装模型。 |
Neural Analog 分别处理立体声音频的中心与侧向差分信息。您还可以设置 AudioSR 开始重新生成细节的截止频率。较低截止频率会改变更多声音,较高截止频率则只填补最高频部分。
AudioSR 要求:Python、GPU 显存与磁盘空间
AudioSR 是较重的模型,尤其在处理完整歌曲时。官方基础检查点在磁盘上约占 6.2 GB,推理所需内存比存储的权重更多。大显存 NVIDIA GPU 会有帮助,但检查点大小并不是最低显存要求:片段长度与实现方式也会影响内存使用。官方 README 没有公布最低 GPU 要求。
长输入可能耗尽 GPU 显存。请从短片段开始,再将较长录音分成小块处理。
开始前准备以下依赖:
- **隔离环境中的 Python。**上游示例使用 Python 3.9。本指南使用 Python 3.10,它兼容 AudioSR 所需的较旧 NumPy 版本。虚拟环境可避免这些包影响系统 Python。
- **Git 与 uv。**安装 Git 与 uv,用于下载源码与管理 Python 环境。
- **PyTorch 与合适的 GPU 驱动。**NVIDIA 用户需要兼容 CUDA 的 PyTorch 构建版本。根据官方安装版本对照表,匹配 PyTorch、TorchAudio 与 TorchVision 的版本。
- **FFmpeg,包括 ffprobe。**上游文件保存代码会使用这些命令。通过 FFmpeg 下载选项安装,并确保终端能调用它们。
- **空闲磁盘空间与互联网连接。**为环境、下载的模型权重、输入文件与输出预留空间。首次加载模型时会下载检查点。
上游设备选择代码识别 CUDA、Apple MPS 与 CPU。CPU 处理可能非常慢。设备检查支持 MPS,并不保证每项依赖与操作在每台 Mac 上都正常运行。
如何从 GitHub 安装 AudioSR
1. 下载官方仓库并创建 Python 环境
在终端运行以下命令:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
在 Linux 或 macOS 上激活环境:
source .venv/bin/activateWindows PowerShell 则使用以下激活命令:
.venv\Scripts\Activate.ps12. 安装兼容依赖与 AudioSR
AudioSR 对较旧依赖有版本限制,包括 NumPy 1.23.5 或更早版本,以及 Transformers 4.30.2。安装最新 Python 与 PyTorch 可能导致兼容性错误。项目的包依赖要求与参考环境是有用的起点。
例如,参考环境将 PyTorch 2.0.1、TorchAudio 2.0.2 与 TorchVision 0.15.2 配套使用。在具有合适 NVIDIA 驱动的 Linux 或 Windows 上,安装该 CUDA 11.7 组合,再安装已检出的 AudioSR 源码:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
CUDA 命令适用于 NVIDIA 系统。其他设备请使用 PyTorch 版本对照表中对应的 macOS 或 CPU 安装说明。这些是旧版依赖,因此请让此环境与其他 Python 项目分开。
如果只需要已发布的包,官方 README还介绍了 audiosr==0.0.7。该发布版与 GitHub 当前 main 分支的功能可能不同,因此请通过 python -m audiosr --help检查已安装版本。
3. 检查 Python 能否识别 GPU
在 NVIDIA 机器已激活的环境中运行以下检查:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
若 CUDA 不可用,请先修复驱动或 PyTorch 安装,再开始长任务。给 AudioSR 添加 -d cuda不能让不可用的 GPU 工作。
AudioSR 命令行用法:先用短 WAV
首次运行请使用短单声道 WAV。上游音频加载器推荐 5.12 秒输入,并警告超过 10.24 秒可能影响质量。完整歌曲会让配置与内存问题更难排查。
将 input.wav放入仓库目录,然后运行:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42命令行实现将 48 kHz WAV 输出保存在 output下带时间戳的文件夹中。一般音频使用 basic,说话录音使用 speech。种子控制生成结果的变化;比较几个种子有助于选择更好的结果。
若生成完成,但保存时报 numpy.ndarray has no attribute cpu,请用下方 Python 示例直接写入输出。本指南检查的 GitHub 源码中,推理返回 NumPy 数组,而文件保存函数期望张量。这是上游输出类型不匹配,并非 GPU 显存错误。
当前 GitHub 代码也提供长文件分块处理:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1分块处理较小片段,并混合重叠部分。它能减少内存使用,但引入的接缝需要试听检查。这些参数取决于版本,而且上游分块流程会将立体声输入混合为单声道,因此请保留原始立体声文件。
如何通过 Python 使用 AudioSR
用 Python API 从自己的脚本调用 AudioSR。下例运行短单声道文件,将填充裁剪至输入时长,并写入 48 kHz WAV。在仓库目录将其保存为 run_audiosr.py。
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPython 流程只加载模型一次,因此批处理脚本可以复用模型。Neural Analog 的批处理无需脚本,就能将一次修复操作应用到多个文件。请显式设置采样步数,因为 Python API 与 CLI 的默认值可能不同。
如何在 Google Colab 中运行 AudioSR
Google Colab让您在 Google 云端硬件上运行 AudioSR。打开社区 AudioSR Colab 笔记本,按说明加载音频、运行模型并保存结果。笔记本在浏览器中运行,因此电脑无需安装 Python 或配备 GPU。
该笔记本是 AudioSR 的社区改编版本。其源码可在 GitHub 查看。
在哪里下载 AudioSR 模型权重?
下载 Hugging Face 上的 AudioSR 模型权重。
AudioSR 模型详解:架构、训练与历史
谁开发了 AudioSR?
AudioSR 是 Haohe Liu、Ke Chen、Qiao Tian、Wenwu Wang 与 Mark D. Plumbley 开发的生成式音频超分辨率模型。它预测语音、音乐与音效缺失的高频,输出 48 kHz 音频。AudioSR 研究页面包含论文与试听示例。这项工作先以 2023 年 9 月预印本出现,后发表于 ICASSP 2024。
AudioSR 生成合理的细节,无法精确找回丢失的录音室母带副本。将 MP3 转成 48 kHz WAV 完全不会执行这种重建。要了解区别,请参阅 MP3 转 WAV 修复指南。
音频修复增强、重采样与带宽并不相同
重采样改变每秒音频由多少采样表示。音频修复增强或超分辨率则试图估计录音已不含的频率内容。例如,将 8 kHz 录音重采样为 48 kHz 会增加采样数,却不会自行恢复原有 4 kHz 频率上限以上的声音。
根据官方项目说明,AudioSR 针对带宽为 2 到 16 kHz 的输入,并以 48 kHz 采样率输出 24 kHz 带宽的音频。带宽描述频率范围,采样率描述每秒采样数。标为 48 kHz 的文件仍可能因先前压缩或滤波而带宽狭窄。许多 AI 生成歌曲都有这种情况,这也是 Suno 歌曲经常听起来闷的原因。
AudioSR 是第一款音频超分辨率模型吗?
AudioSR 不是第一款神经音频超分辨率模型。Kuleshov、Enam 与 Ermon 在 2017 年发表了使用神经网络实现音频超分辨率,基于扩散的语音超分辨率也早于 AudioSR。
它的贡献更具体。AudioSR 论文将其称为第一个覆盖一般可听声音领域的系统,包括音乐、语音与音效。它将这种广泛覆盖与灵活输入带宽结合,而非首次提出音频超分辨率本身。
从输入录音到 48 kHz 波形
AudioSR 结合变分自编码器(VAE)、条件潜空间扩散模型与神经声码器。每个组件负责重建的一个阶段:
| 阶段 | 发生什么 | 为何重要 |
|---|---|---|
| 音频表示 | 输入变成梅尔频谱图,即声音能量随时间与频率变化的映射。 | 模型处理频率内容的模式。 |
| VAE 编码 | 编码器将频谱图压缩成较小的表示,称为潜变量。 | 扩散处理的数值少于完整频谱图。 |
| 条件扩散 | Transformer U-Net 以低分辨率输入潜变量为引导,迭代改进带噪潜变量。 | 录音引导生成细节;无需文本提示。 |
| 解码与声码器 | VAE 解码出更高分辨率的梅尔频谱图。基于 HiFi-GAN 的声码器将其变成波形。 | 必须将频谱图转回可听的音频采样。 |
| 频率替换 | 用输入的低频信息替换对应生成频带。 | 已有信息有助于限制录音变化。 |
已发布的模型配置指定 256 个梅尔频带的表示、VAE,以及带空间 Transformer 的 U-Net。它将输入编码后的低通特征与扩散潜变量拼接。尽管部分继承的 CLI 描述提到文本,这仍是以音频为条件的生成。
采样步数与引导控制什么?
采样步数决定模型用多少次迭代改进生成表示。AudioSR 使用 DDIM 采样器。引导决定输入条件对生成过程的影响程度。它不是 EQ 强度,提高值也不保证提高音质。推理实现依次执行采样、解码、频率替换与波形归一化。
更多采样步数与更长录音需要更多处理时间。AudioSR 面向非实时处理,实际速度取决于 GPU 与设置。减少 ddim_steps可加快生成,但不能可靠解决 GPU 显存错误。
AudioSR 如何训练?
论文训练部分介绍了约 7,000 小时数据,来自 MUSDB18-HQ、MoisesDB、MedleyDB、Freesound 与 OpenSLR 语音数据。截止频率不同的低通滤波器生成劣化输入,并与带宽更完整的目标配对。扩散模型使用余弦噪声调度、速度预测与无分类器引导。声码器基于 HiFi-GAN,使用多分辨率判别器。
真实录音可能不同于这些训练样本。作者说明,不规则频率截止、严重噪声与混响可能降低质量。MP3 压缩可能在截止频率附近留下缺口。推理前低通滤波可能有帮助,但截止频率设得过低会移除有用细节。对于含混响的录音,超分辨率处理前移除混响可为模型提供更干净的输入。
运行 AudioSR 不需要训练这些组件。安装流程加载预训练权重。
AudioSR 为何使用后处理?
生成音频应保留源音频已有的有用信息。AudioSR 两次替换低频带:一次在声码器前的估计梅尔频谱图中,另一次在输出波形的短时傅里叶变换(STFT)表示中。替换代码估计截止频率,并调整重建输出。
立体声录音与完整歌曲需要能够处理声道、分块与重建的流程。仓库默认流程输出单声道音频:标准加载器取输入第一声道,而分块流程将立体声混合为单声道。保留立体声需要额外声道处理,例如社区笔记本分别处理左右声道的方法。
重建结果需要试听检查。社区流程说明警告,过度重叠可能导致相位抵消。在相近响度下比较结果,检查重新生成的高频、分块接缝、时长与立体声声像。频率替换有助于保留源音频,但不保证低频带完全不变或接缝干净。
AudioSR 故障排查常见问题
PyPI 上有 AudioSR 吗?
有。官方 README介绍了通过 pip 安装 audiosr==0.0.7,或直接安装 GitHub 最新代码。GitHub main 分支有分块等功能,PyPI 发布版可能没有。
AudioSR 需要多少 GPU 显存?
README 没有给出最低要求。仅基础检查点就在磁盘上约占 6.2 GB,内存使用会随片段长度增加。请从约 5 秒片段开始,再对较长文件使用分块。
AudioSR 为何报 numpy.ndarray has no attribute cpu 错误?
推理已完成,但保存阶段期望 PyTorch 张量,却收到 NumPy 数组。请用上面的 Python 脚本,通过 soundfile写入输出。
AudioSR 输出为何是单声道?
默认加载器只读取第一声道,而分块流程将立体声混合为单声道。请分别处理左右声道,或使用会为您处理中间与侧向差分声道的在线 AudioSR。
AudioSR 训练代码公开了吗?
公开了。README 中 2024 年 12 月 31 日的更新日志链接了训练代码,作者说明它仅供参考,没有经过细致整理。
用 Neural Analog 运行 AudioSR,无需维护配置
若要跳过本地配置,请打开在线 AudioSR,上传文件或导入受支持的音乐链接,再调整修复设置。Udio 音频请先保存或录制,再上传文件。您可以选择截止频率、试听处理结果,并在同一界面导出音频。
Neural Analog 在线处理模型,因此您可以使用没有大显存 GPU 的电脑,无需安装 Python、下载检查点或维护笔记本。仍需仔细聆听,因为托管流程不会消除模型的质量限制。修复后按音频改善指南进行后续处理。对于 AI 生成音乐,修复 AI 歌曲音质介绍了超分辨率后的分轨修复与母带处理。
您也可以在 Neural Analog 比较 AudioSR 与更新的音频超分辨率模型,包括 UniverSR 与 FlashSR。模型卡片解释了各模型的工作原理,常见问题汇总了 UniverSR 与 AudioSR 的区别。完整案例请参阅用 UniverSR 将全部 203 个 RPG Maker 2000 音效修复为 48 kHz。请对同一录音运行模型,比较试听结果,选择最好的一版。