如何将有损 MP3 文件修复为高音质 WAV
要将 MP3 提升为音质真正更好的 WAV,需要 AI 修复,而不是格式转换器。将 MP3 转为 WAV 只会让文件变大,声音完全不变,因为 MP3 压缩为了节省空间,会永久删除部分音频信息。传统工具无法逆转这一过程。
AI 修复可以重建部分丢失的内容。Neural Analog 等采用 GPU 加速的服务会重建缺失的高频,去除压缩伪影,恢复谐波细节,而非只是重新封装同一份数据。这就像单纯放大一张像素化照片,与用 AI 补全缺失细节之间的区别。
本指南解释为什么简单转换不起作用,神经网络修复如何工作,以及它何时能真正改善音乐。想用自己的文件试试,可以打开 MP3 转 WAV 音质提升工具。
为什么将 MP3 转为 WAV 不会提升音质
MP3 压缩会丢弃编码器认为你察觉不到的声音。它会删除被掩蔽的细节,引入量化噪声,并使用截止频率取决于比特率的低通滤波器。128 kbps MP3 通常会切掉 16 kHz 以上的全部内容。根据编码器设置,甚至 320 kbps MP3 也可能切掉 20.5 kHz 以上的频率。结果就是谐波细节丢失,还增加了伪影。
在 Audacity 或 iTunes 中将 MP3 转为 WAV 时,只是将 MP3 解码为未压缩的 PCM。如果还提高了采样率,重采样器会在现有采样点之间进行插值。这两个步骤都不会增加细节,也无法恢复编码器删掉的内容。频谱图上的高频空白区域依然相同,只是文件更大了。
这就是专业人士保留无损母带的原因。音频一旦经过有损编码,单纯转换就无法找回丢失的内容。
什么时候普通 MP3 转 WAV 就已足够
如果只是因为 DAW、视频编辑器或发行商要求 WAV,普通转换就可以。它会保持声音不变,并避免在再次编辑和导出时继续增加压缩。用 FFmpeg 一条命令即可完成:
ffmpeg -i input.mp3 output.wav只有想让声音变得更好时才需要 AI 修复;只是更换格式则不需要。
如何检查 MP3 是否缺少高频
在免费在线频谱图工具中打开文件。有损 MP3 往往会在高频截止处显示一道明显的水平线,128 kbps 文件通常在约 16 kHz。如果这条线以上的频谱是暗的,就有内容可供修复重建。
真正影响音质的音频参数
这些参数解释了什么决定音质,以及为什么修复后的文件听起来更好。
采样率:44.1 kHz 与 48 kHz
44.1 kHz(每秒 44,100 个采样)是 CD 标准。它可以表示最高 22.05 kHz 的频率,超过人类听觉约 20 kHz 的上限。48 kHz 常用于视频制作,提供稍大的频率余量。
大多数音乐流媒体使用 44.1 kHz,通常还会进行有损压缩。提升 MP3 音质时,修复模型会重建缺失的频率细节,并导出适合制作的文件。根据所选模型,Neural Analog 会将 44.1 kHz 音源保持为 44.1 kHz,或生成 48 kHz 的超分辨率输出。实际示例可参阅用 UniverSR 将 203 个 RPG Maker 2000 音效从 22.05 kHz 修复至 48 kHz。
位深:16 位与 24 位 WAV
位深决定动态范围,也就是文件能够容纳的最轻与最响声音之间的差值。
- 16 位:96 dB 动态范围,适合最终发行(CD、流媒体)。
- 24 位:理论动态范围为 144 dB,更适合制作、混音和修复。
16 位文件中的安静段落更接近量化噪声底,因此之后提高音量,也会将这些噪声一起提高。24 位提供更多余量,让你在处理时调整电平,而不引入可闻噪声。
为什么最高 20 kHz 的高频很重要
大多数音频设备能重放 20 Hz 至 20 kHz 的声音,这也是年轻人可听到的频率范围。随着年龄增长,或长期接触嘈杂环境(汽车、机械、演唱会、餐厅的大声音乐),听觉上限通常会降到 16 至 18 kHz。
试试免费在线听力测试,检查这些频率中哪些你还能听到。
人类也不会觉得所有频率的响度都一样。在相同信号电平下,接近人声频段的声音,会比极低频或极高频听起来更响。
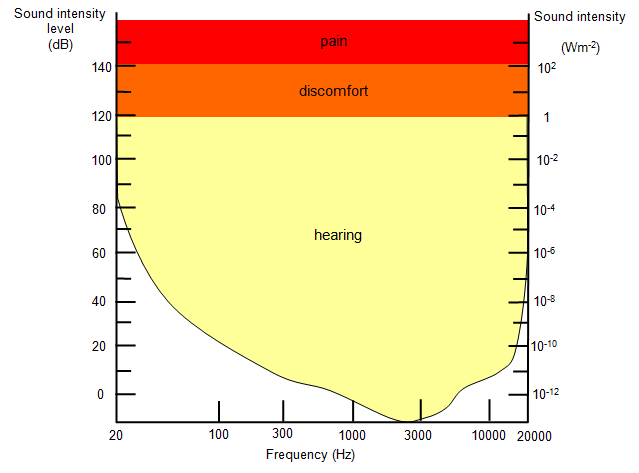
即使你听不到 15 kHz 以上的纯音,高频内容仍然重要。它影响空间感和瞬态响应:镲片、弦乐的光泽,以及人声的「空气感」都位于这个范围。它还会改变压缩器、限制器、EQ 和混响对信号的反应。
MP3 会删除这一区域中的大量内容,尤其在低比特率下。频谱恢复会根据学到的规律重建这些频率。即使你听不到 18 kHz 的纯音,仍然能感受到修复后的「空气感」和空间感,因此修复后的歌曲听起来更宽、更通透。
为什么流媒体和 AI 音乐听起来经过压缩
Spotify、Apple Music 和 YouTube 向大多数听众提供有损音频。即使是「高音质」有损设置,也会丢弃数据。Suno 等 AI 音乐生成器往往导出带宽受限的 MP3,部分原因在于它们的模型使用压缩音频训练。Udio 已不再提供下载,请改为保存播放录音。
这限制了音质上限:出色的歌曲也可能听起来发闷。音质提升通过修复缺失的频率范围,提高这个上限。
AI 音频修复如何工作?
下面简要说明 Neural Analog 修复模型的工作方式。
学习信号统计特征
模型用数百万组歌曲进行训练:原始录音室母带及其 MP3 版本。它会学习压缩破坏了什么,以及自然音乐的特征。例如,吉他扫弦会产生特定谐波,人声具有可预测的共振峰,而鼓声需要相位一致性。
分频段重建
频谱会被划分为多个子频段。低频大多被保留,因为压缩很少破坏它们;中高频则根据学到的谐波结构重新构建。这样既能保留完好的低频,也能将处理重点放在受损范围。
时域一致性
模型会让新增细节保持相位一致:补充的高频与原始波形的时间对齐。这能避免镶边效应和声音模糊,让结果听起来自然,而没有明显处理感。
针对听感优化
模型输出会用客观音质指标和真人试听测试评估。目标是音乐保真度,而不只是技术准确性:更清晰的高频、更利落的瞬态和更大的声场。
MP3 修复前后示例
许多 AI 音乐生成器会输出在约 16 kHz 处截止的 MP3 文件,因为训练数据经过压缩。它们听起来不错,却缺少专业母带中的高频细节。
Neural Analog 会将它们修复为 高频修复至 20 kHz 的 WAV。区别在高频和没有鼓声的段落中最明显。请留意镲片、混响尾音和数字啾声。
修复缺失的高频
低采样率音乐、老录音和 AI 生成的歌曲经常缺少高频。Neural Analog 会重建这些内容。
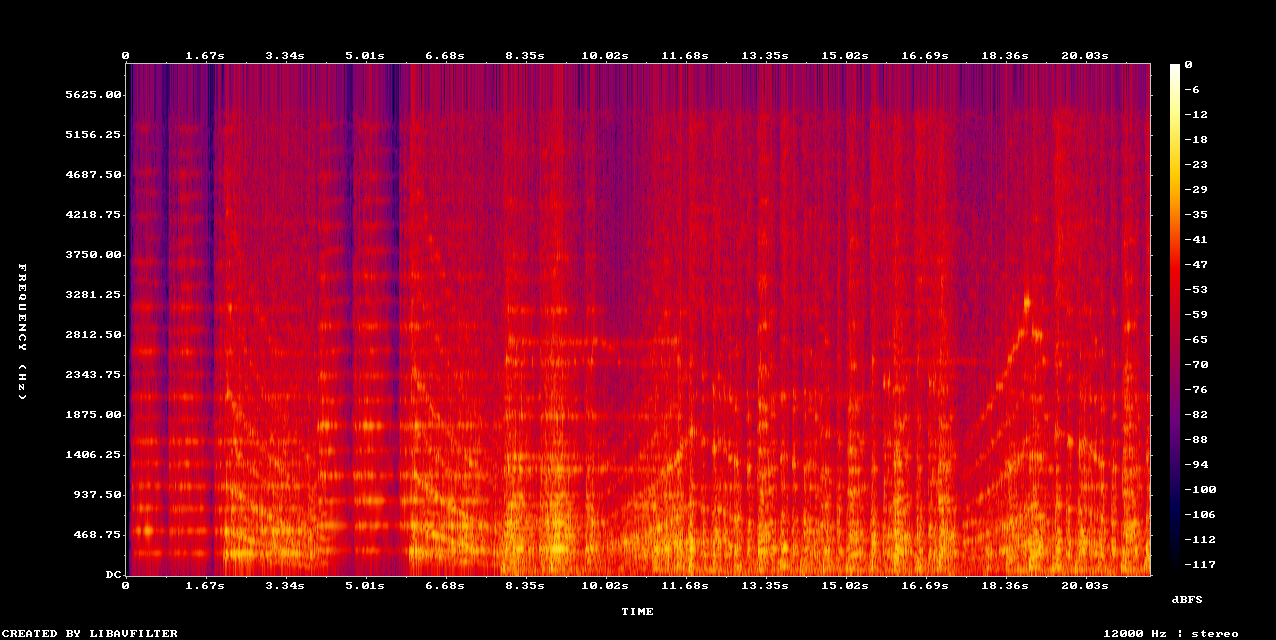
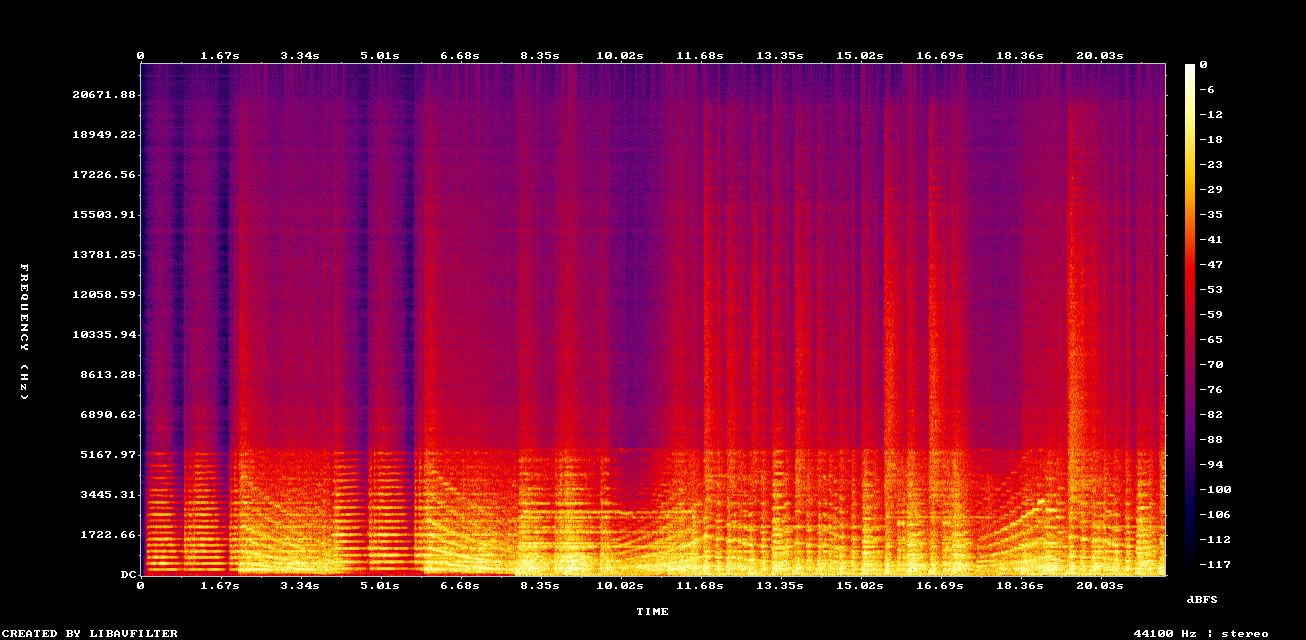
示例:用 Music Upscaler 处理低音质 MP3 录音
去除劣质录音中的削波
当信号超过文件可存储的最大电平时,会发生削波,波形峰顶因此被削平。Neural Analog 会去除削波伪影,同时保持歌曲响度。
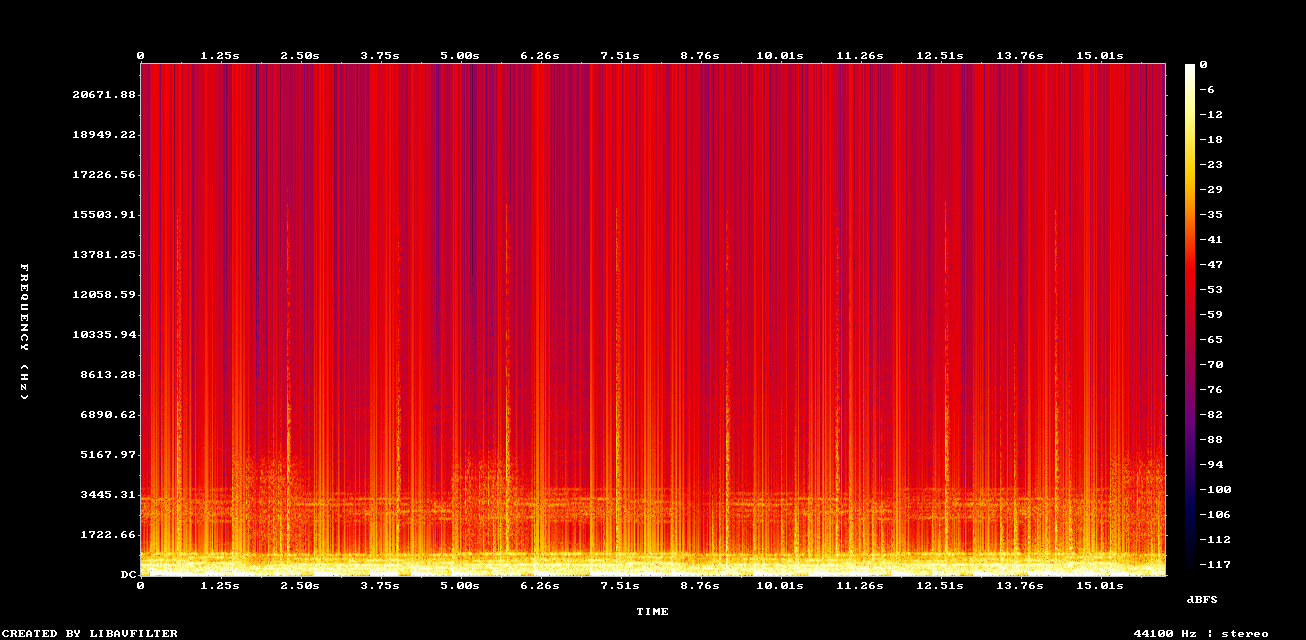
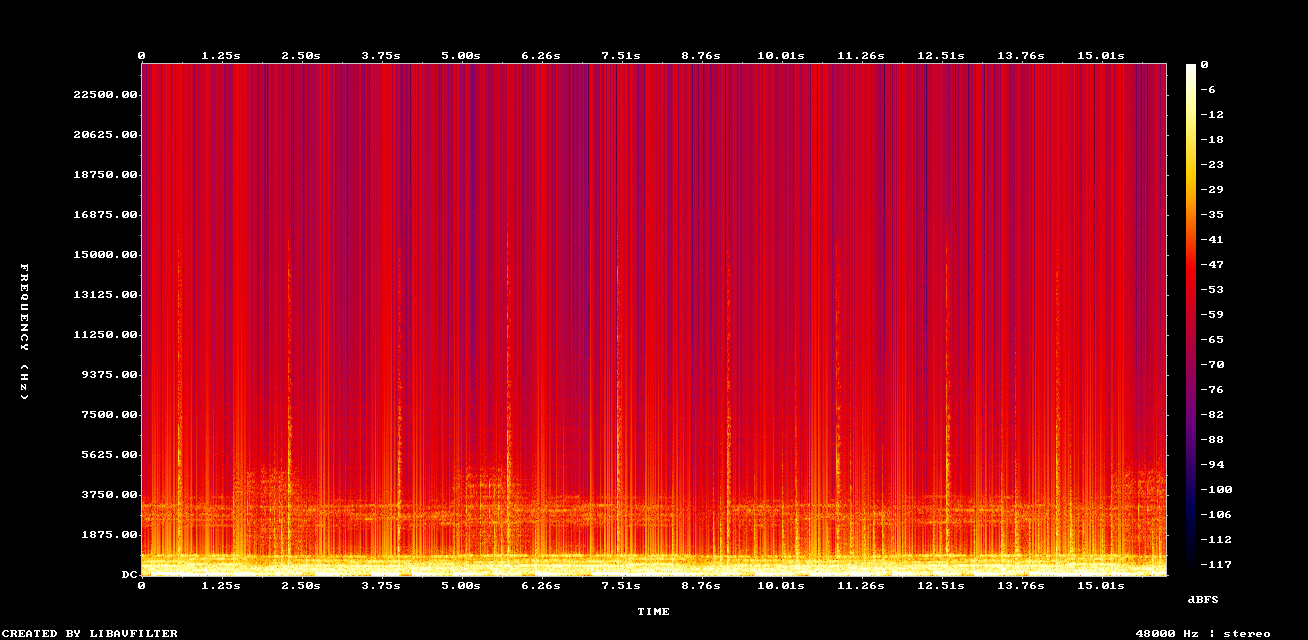
示例:用 Remove Clipping + DACVAE 提升旧 MP3 文件音质
提升英语语音音质
NovaSR 模型可提升人声轨、歌唱和语音的音质。
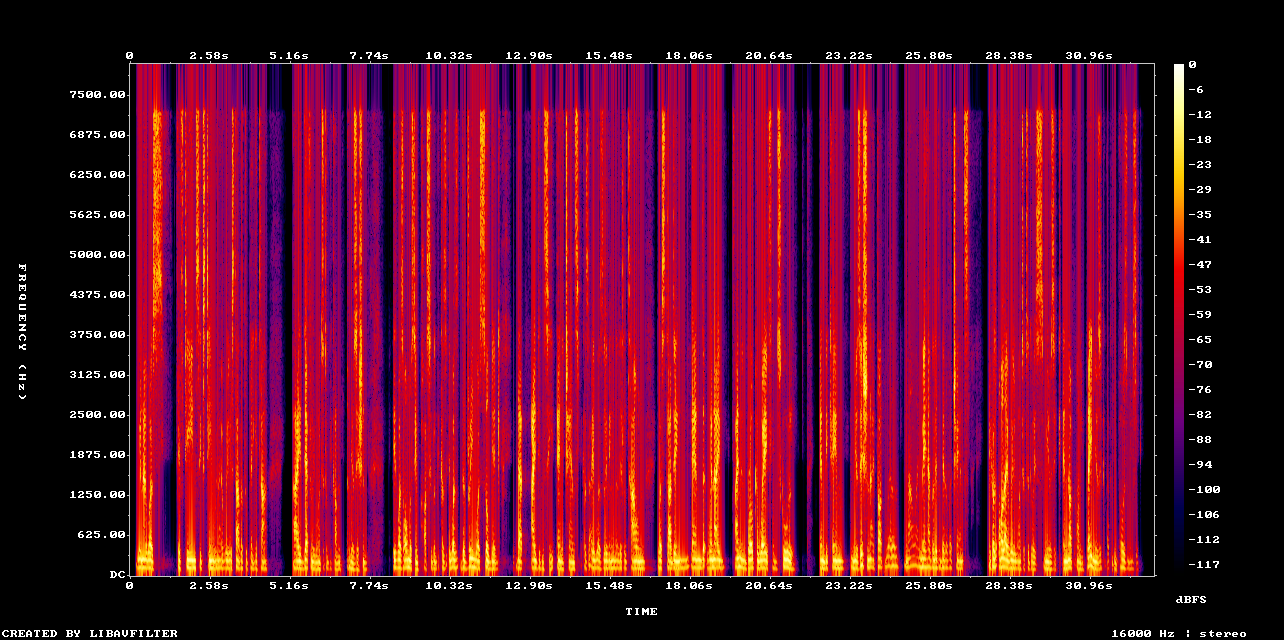
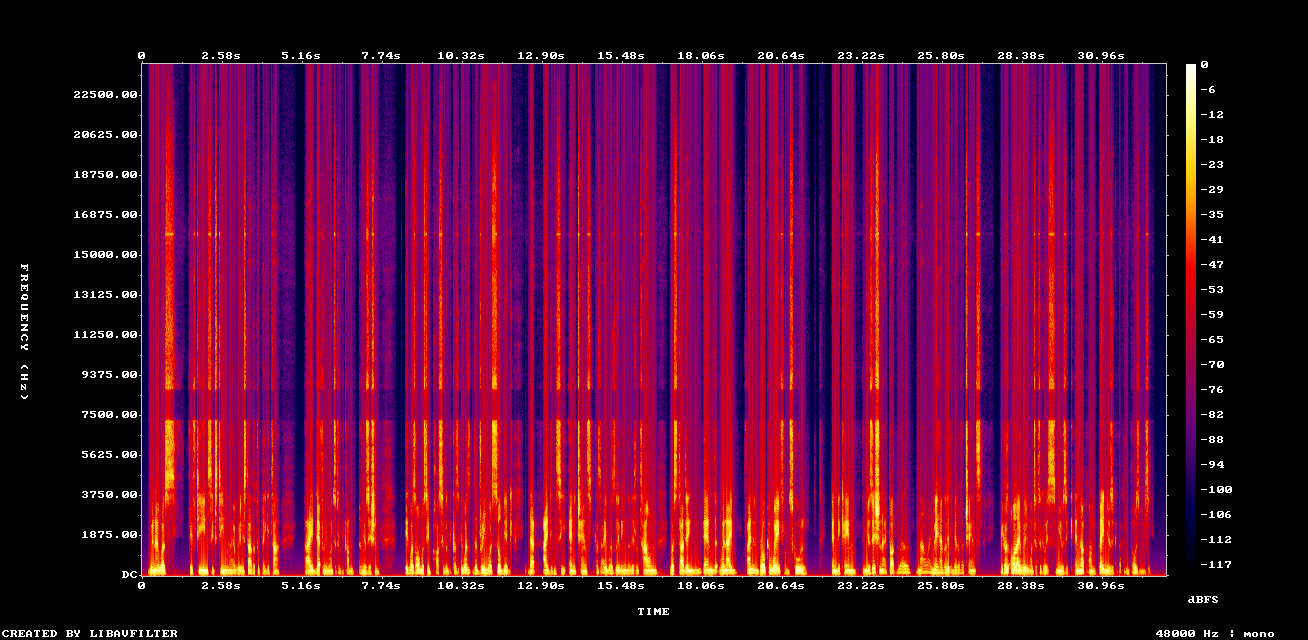
示例:用 NovaSR 提升语音音质(单声道)
什么时候应该提升 MP3 音质?
改善 AI 音乐音质
使用 Suno、Udio、FlowMusic / Producer.ai 或其他 AI 音乐生成器时,你的起点可能是压缩音频。如果音源带宽受限或充满伪影,应在生成后立即提升音质,以更好的素材开始混音。对于 Suno 歌曲,改善 Suno AI 音质介绍完整的修复、分轨和母带处理流程;逐分轨修复 AI 歌曲音质则说明哪些修复模型适合人声、鼓声和贝斯。
将音乐商店下载的 MP3 提升为 WAV
Beatport、Bandcamp 等商店有时因授权原因销售 MP3。提取采样、混音或存档之前,先将它们提升为 WAV,详见为什么应先提升 MP3 采样音质,再用于歌曲。
为再版母带恢复高频
2000 年代的旧 MP3 音乐库中有大量 128 kbps 文件。修复后,可用于高端系统播放。在好耳机或录音室监听音箱上,差别很明显。
为母带处理准备音频
不要直接对 MP3 做母带处理。先修复,因为母带处理在完整频谱的音频上效果最好(可以对 MP3 文件做母带处理吗?)。然后通过 AI 音乐母带处理 LUFS 指南选择目标响度。
用 Neural Analog 将 MP3 提升为 WAV 的三个步骤
你无需安装 Python、管理 GPU 驱动或下载数 GB 的模型。如果确实想在自己的电脑上运行模型,请遵循 AudioSR GitHub 安装指南。改善音频的入门指南介绍在 Studio 中完成相同步骤的方法。
步骤 1:导入音频 上传 MP3,或粘贴来自 Suno、YouTube、FlowMusic、TopMediaAI 或其他支持来源的链接。
步骤 2:神经网络重建 打开增强,选择 MP3 音乐修复,再点击开始模型执行。Neural Analog 会用生成式 AI 处理音频。短任务通常在几分钟内完成;文件更长、模型更重时,需要更长时间。
步骤 3:下载 WAV 选择修复后的结果,点击导出,选择 WAV、FLAC 或 MP3。下载文件后,导入 DAW,使用音质更好的版本进行制作。导出指南介绍各种格式和下载选项。
无需命令行或本地 GPU 配置。
MP3 转 WAV 音质提升常见问题
修复后的 16 kHz 以上频率真的能听到吗?
能,但取决于年龄和听力状况。例如,许多较年轻的听众能听到称为「Mosquitone」的 17.4 kHz 音调。
试试免费听力测试,看看你是否能听到这些频率。
这些频率还会影响空间感知和瞬态清晰度。即使听不到 18 kHz 的纯正弦波,你也能感受到修复后的「空气感」和深度,因此高分辨率音频会显得更通透。
MP3 转 WAV 音质提升与普通转换有什么区别?
普通转换只会解码 MP3(重采样时还会进行插值),不会增加细节。Neural Analog 会进行生成式重建,类似于 AI 图像放大:预测并补入缺失的谐波内容。
模型只是添加噪声吗?
不是。有些增强工具会叠加白噪声,让声音显得「更饱满」;神经网络修复则会重建具有一致性的信号。模型会学习区分音乐内容与压缩伪影,去除伪影并重建音乐。重建后的频谱图能显示出这种结构。
修复能解决混音不好的问题吗?
修复会去除伪影并扩展带宽,可以修补部分削波或压缩损伤,但无法解决混响平衡、贝斯浑浊或编曲问题。这些属于混音问题。要处理它们,先用 Neural Analog 的 AI 分轨分离工具拆分歌曲,分别修复或调整各条分轨的平衡,再对完成的混音做母带处理。高质量 AI 分轨分离介绍各条分轨该选用什么分离模型。
修复免费吗?
Neural Analog 支持免费修复短音频片段,以便测试音质。较长音频会消耗处理分钟额度:先使用套餐中包含的分钟额度,再使用另行购买的额外分钟额度。
应该提升为 48 kHz 还是 44.1 kHz?
大多数 AI 生成器和音乐流媒体服务使用 44.1 kHz,这通常也是你的发行采样率。Neural Analog 的 MP3 修复会将 44.1 kHz 音源保持为 44.1 kHz,而超分辨率模型输出 48 kHz。与压缩音频和修复音频之间的差距相比,44.1 kHz 与 48 kHz 的差别很小,因此应关注修复质量,而不是采样率。
音质提升、格式转换与母带处理对比
| 功能 | 普通转换 | 母带处理(EQ/压缩) | Neural Analog 修复 |
|---|---|---|---|
| 方法 | 解码与插值 | 调整频率和动态 | 生成式 AI 重建 |
| 扩展带宽 | 否 | 否 | 是(修复至 20 kHz) |
| 去除伪影 | 否 | 往往会加重伪影 | 是(去量化) |
| 处理内容 | 格式更换或重采样 | 润色 | 修复 |
| 最适合 | 快速转换格式 | 最终润色 | 恢复音质 |
流媒体压缩会抵消修复效果吗?
Spotify 的「非常高」音质使用 320 kbps Ogg Vorbis,Apple Music 的标准流使用 256 kbps AAC。两者均为有损格式。YouTube 也会大量压缩全部内容。
最终播放流仍会经过压缩,但如果上传的是已修复的 WAV,平台会从完整频谱的音频开始编码。对已经压缩的 MP3 再次编码,则会在第一轮伪影之上叠加第二轮伪影。
对于制作人,处理顺序是:修复 → 混音 → 母带处理 → 发行。跳过修复,就像用脏镜头拍摄:后期可以调色,模糊仍然存在。
提升音质后如何保留修复效果
MP3 诞生于拨号上网和 5 GB iPod 的时代。如今的带宽和 AI 工具,让我们没有多少理由继续用有缺损的音频制作。
使用 Neural Analog,上传 MP3 即可下载高频修复至 20 kHz 的 WAV。将修复后的 WAV 保留为混音、母带处理、存档和发行的音源,直到最终交付时再按需转回 MP3。将你的第一个 MP3 提升为 WAV。