高质量 AI 分轨:如何用 SAM Audio 与 BS-RoFormer 提取干净分轨
**高质量 AI 分轨取决于三点:为任务选择合适模型、处理完整长度的立体声,以及在源音频出现压缩损伤时进行修复。**人声、鼓与贝斯可使用 BS-RoFormer 等专用固定分轨模型,其他乐器则使用 Meta 的 SAM Audio。所得分轨比 Spleeter 或早期 Demucs 等旧工具更干净。
制作人、DJ 与内容创作者经常遇到相同问题:需要干净清唱用于混音、不含鼓的曲目用于练习,或单独的吉他乐句用于采样。旧分轨工具留下的往往是浑浊人声与若隐若现的鼓声伪影。
本指南解释什么是分轨、为什么大多数分轨工具会引入伪影,以及如何获得真正可用于制作的分轨,包括 Suno 歌曲的分轨。
什么是分轨?理解音频分离基础
**分轨是从混合完成的歌曲中提取的独立音频轨道。**您不再只有一个包含所有声音的立体声文件,而是分别获得人声、鼓、贝斯、钢琴及其他乐器的文件。每条分轨只包含对应元素。
分轨有干音分轨(不含效果)与湿音分轨(已施加混响、压缩等效果)之分。干音分轨像烹饪前的食材,湿音分轨像完成的菜肴。本文中的模型只提取湿音分轨,因此每条分轨保留其在混音中的效果。
分轨为何对现代音乐制作重要
分轨将静态的立体声混音变成可灵活处理的部分。有了高质量分轨,您可以:
- 移除人声,制作卡拉 OK 伴奏
- 用干净的清唱分离结果制作拼接混音
- 围绕原始人声制作重混音,这也是 Spotify 计划中的 AI 重混音功能的思路
- 调整各乐器电平,重新平衡混音
- 单独聆听特定声部,学习歌曲
- 采样某个元素,不夹带其他乐器
- 修复独立音轨中的问题频率
在 AI 出现前,分轨依赖 EQ 滤波与相位抵消,既会产生伪影,也无法彻底分离声部。AI 模型通过学习识别音色与谐波结构改进了这一点,而不再仅仅过滤频率。
大多数分轨服务的问题
AI 分轨工具并不相同。许多服务承诺“高质量”,却在基础环节上省事:
演示平台与制作工具
Meta 的 SAM Audio 演示平台只处理30 秒单声道片段。演示足够,但需要完整的立体声歌曲时就不适用。请参阅 Neural Analog 与 SAM Audio 演示平台的区别。
单一模型的局限
许多服务只使用一个模型,因此必须取舍。Demucs 或 BS-RoFormer 等固定分轨模型擅长预设分离(人声、鼓、贝斯、其他),却不能提取萨克斯或合成器等自定义乐器。另一些模型支持自定义提取,但标准分轨不如专用工具干净。
没有音频修复流程
分离 MP3 或流媒体录制等压缩音源,会暴露原有伪影。低码率 MP3 通常切掉约 16 kHz 以上的内容,并加入模糊瞬态的量化噪声。忽视这些问题的分轨工具,只是更清楚地分离出受损音频。
SAM Audio 如何推动分轨技术
Meta 的 SAM Audio是通用声源分离模型,而非专用人声移除器。Meta 将它描述为一个接受文本、视觉与时间区间提示的模型,基于流匹配 Transformer,并以覆盖语音、音乐与一般声音的大规模混合音频训练。
听听区别:SAM Audio 与行业常用工具
下面是真实场景比较。我们从一段密集的古典混音中,分别用 SAM Audio(Neural Analog)和一家主要竞品提取钢琴分轨。
示例:钢琴提取效果比较
使用提示词 'piano',从密集的立体声混音中分离一种乐器。
SAM Audio 背后的技术
SAM Audio 使用流匹配 Transformer,从混合录音预测目标声源。在 Neural Analog Studio 中,您可以用文字描述声源,并标记它出现的时间区间。视觉提示属于研究模型,不是当前 Studio 音频界面的控件。对制作人而言,关键是控制能力:模型可针对人声、鼓、贝斯与其他这几种固定类别以外的声音。
神经音频编码器:模型架构为何决定音质
每款 AI 分轨工具都以神经音频编码器为核心。它将原始波形变成紧凑的音色、音高、节奏与立体声位置表示。可将它视为模型的“耳朵”:分辨军鼓与人声的能力,取决于编码器训练得多好。
Spleeter 等早期分离模型使用 CNN 编码器,将频谱图视为二维图像。它们能处理基本的人声与鼓分离,但难以保持细微音色与时间上的一致性。Demucs v4(Hybrid Transformer Demucs)同时处理波形与频谱图,有助于保留瞬态与相位,听感更自然。BS-RoFormer将频谱图分成频带,用 Transformer 层建模。其论文报告,在 MUSDB18-HQ 基准上平均 SDR 为 9.8 dB,高于 Demucs v4。Spleeter 与 Demucs 比较详细介绍了旧模型。
SAM Audio凭借在超过 1 亿段视频上训练的 **Perception Encoder Audiovisual(PE-AV)**更进一步。由于从视频学习,它会将声音与产生声音的乐器和动作关联。这有助于使用“guitar”等提示,尤其当吉他与其他乐器处于相近频率范围时。
SAM Audio 研究架构
dog barking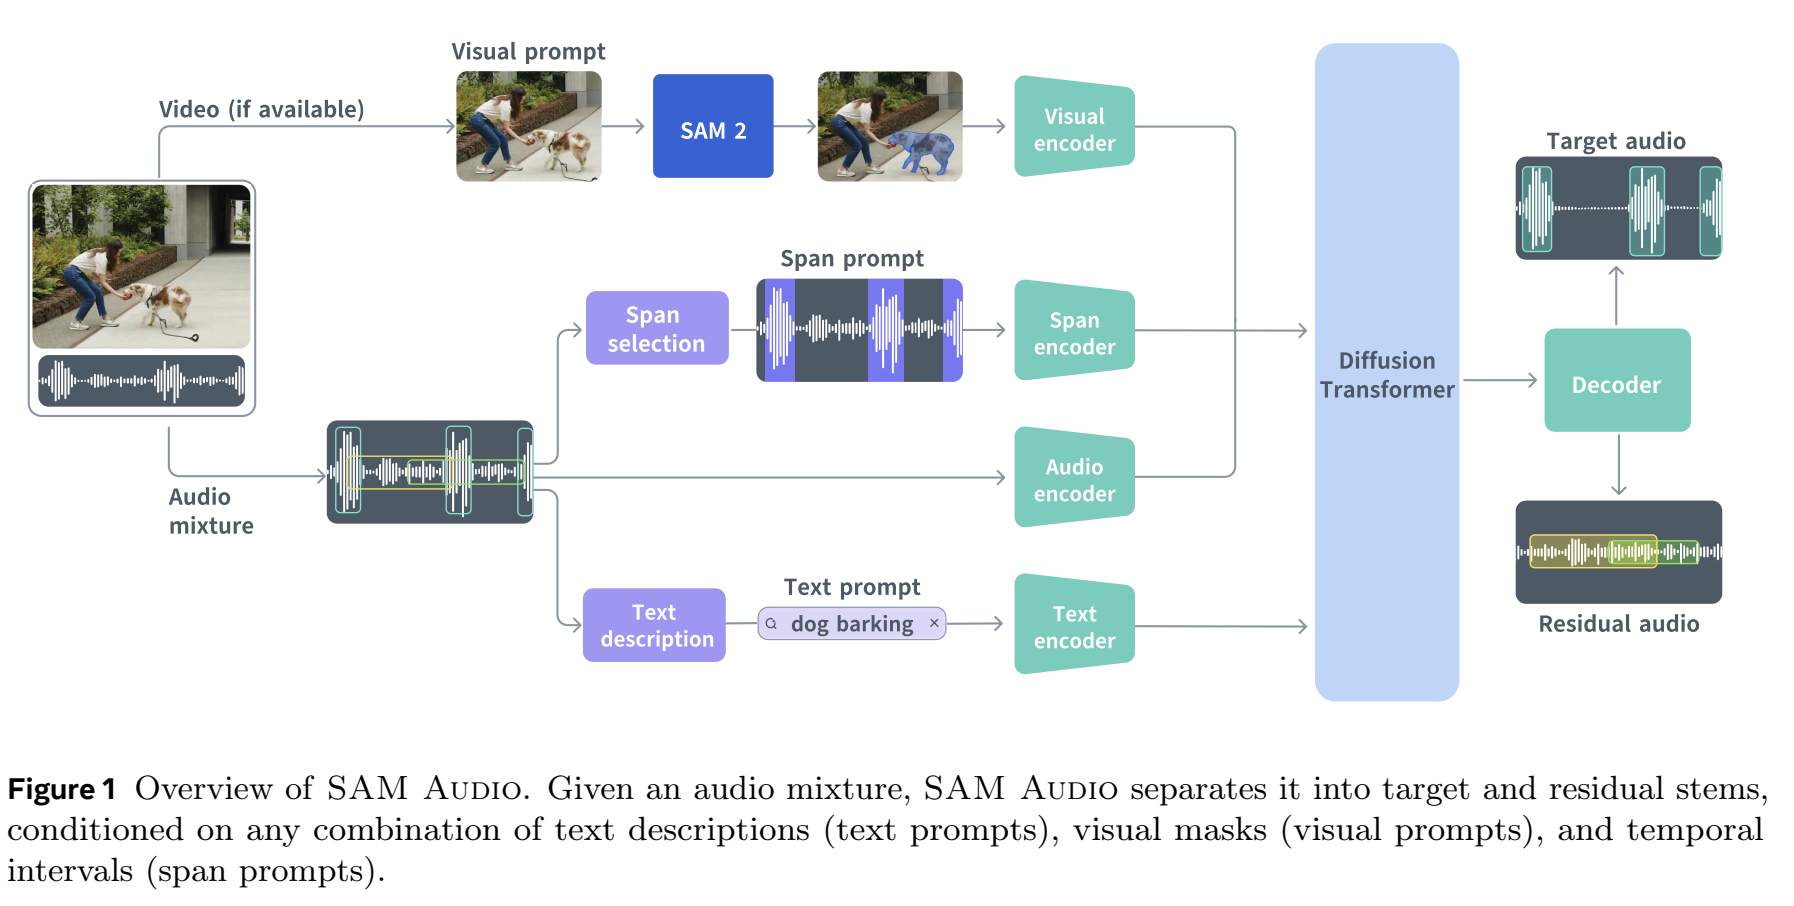
原始图示: SAM Audio 研究架构。
编码器的质量通过三个方面直接影响分轨:
- 音色分辨能力:更好的编码器区分谐波与噪声,让乐器保留特色
- 时间一致性:更强的编码器保持分离随时间稳定,避免廉价工具常见的快速断续伪影
- 细节:更大的编码器捕捉琴弦摩擦声、呼吸声与房间环境声
比较分轨服务时,**请问它使用哪个模型,而不只看营销说法。**后期处理无法彻底弥补旧编码器的不足。
Neural Analog 如何使用 SAM Audio 与 BS-RoFormer
Neural Analog 的 AI 分轨工具将 SAM Audio 与 BS-RoFormer 变成音乐人可实际使用的工具。
与 30 秒单声道演示不同,Neural Analog 以完整立体声处理整首曲目,让分轨保留原始混音的宽度与深度。
您可以选择 SAM Audio 或成熟的固定分轨预设:
- SAM Audio用于自定义乐器提取,例如萨克斯、合成器与弦乐
- 预设用于更快、更可靠的分离:4 条分轨包含人声、鼓、贝斯、其他;6 条分轨增加吉他与钢琴。这些由 BS-RoFormer 模型驱动,是比 Demucs 更新一代的固定分轨工具
使用在线 SAM Audio,当目标声音只出现在曲目某些部分时,您可以写提示并在波形上标记区间。有问题或想分享结果?加入 Neural Analog Discord。
集成音频修复流程
您可以对提取的分轨运行音频修复,扩展频率范围并清理一些伪影。请试听结果:修复无法纠正所有分离错误。
更好的 Suno 分轨:AI 生成音乐为何需要特别处理
Suno 与 Udio、FlowMusic / Producer.ai 等其他 AI 音乐生成器,经常输出压缩或带宽受限的文件。这在分轨前就设定了质量上限。若要直接从 Suno 歌曲链接分离,请使用 Suno 分轨工具。Udio 已不再提供下载或分轨,因此请先将 Udio 歌曲保存为音频文件。
双重压缩问题
用基础工具分离 Suno MP3,处理的是已受损音频。分轨会继承:
- 严重高频缺失,通常 15 kHz 以上没有内容
- 嵌入信号中的量化噪声
- 缩减的立体声宽度与深度
- 数字“振铃”伪影
修复如何改善 AI 生成音乐
流程逐步针对这些限制:
- 提取:SAM Audio 或预设模型分离分轨
- 伪影清理:神经音频修复可减轻 MP3 压缩噪声
- 频率重建:模型预测并重新生成最高至 20 kHz 的谐波内容
- 立体声处理:修复细节时保留立体声信号,再与源音频比较试听宽度与相位
所得 Suno 分轨听起来更接近专业录制的多轨音频。
逐步操作:如何用 Neural Analog 获得高质量分轨
按以下步骤获得一致结果。Studio 分轨指南更详细地介绍各控件。
步骤 1:上传音频
拖放文件,或粘贴 Suno、FlowMusic、TopMediaAI、Treblo、Mureka、YouTube 等受支持来源的公开链接。支持上传 MP3、WAV、FLAC、M4A 与 OGG。最长时长取决于您的套餐与所选模型。
步骤 2:选择分离策略
若希望结果可预测,打开分离,选择4 轨道以提取人声、鼓、贝斯与其他,或选择6 轨道加入吉他与钢琴。检查所选输入。这些预设运行专用固定分轨模型,提供稳定分离。
若要提取自定义乐器,选择自定义 Prompt,使用 SAM Audio。检查所选模型,再描述声音。请具体表达:electric guitar solo with distortion 比 guitar 效果更好。SAM Audio 返回两条互补分轨:匹配提示的声音与录音的其余部分。
步骤 3:配置处理
SAM Audio 立体声处理:默认的立体声(Mid/Sides)分别处理中间(中心)与侧向信号,再重新组合。选择立体声(L/R)可分别处理左、右声道;选择单声道则将两者平均为一个声道。这些控件适用于 SAM Audio;固定分轨预设使用各自的立体声模型。请参阅何时使用 Mid/Side 处理。
步骤 4:处理并下载
若只做分离,请保持增强分轨关闭。查看预计从余额中扣除的处理分钟额度,再点击开始提取并等待。短曲目通常几分钟完成;较长曲目与较重模型需要更多时间。在 Studio 中检查每条分轨,再打开导出,选择独立分轨获取分别的文件,或选择合并分轨获取当前混音。
步骤 5:修复提取的分轨
如果分轨缺失高频,或有可听的压缩损伤,请在增强中将其选为输入。器乐选择MP3 音乐修复,人声选择歌声增强,再点击开始模型执行。导出前比较结果。MP3 转 WAV 修复指南介绍了模型选择。若希望提取后自动处理符合条件的分轨,则启用增强分轨,选择修复模型,并在开始提取前查看额外处理分钟额度估算。干净分轨不需要修复。
制作流程中的技术考虑
将分轨提取加入制作流程时,请检查以下因素:
源文件质量
修复可重建压缩文件,但无损源音频(WAV、FLAC)仍能提供更准确的分离。编码器有更多原始信息可用,因此需要重建的内容更少。
如果目标乐器只在长文件中出现几秒,请在 Studio 标记区间,或上传前裁剪文件。模型会得到更清楚的目标,处理也更快。
分轨相位一致性
同一歌曲的分轨相加后,应大致还原原始混音。如果相位漂移,重新合并会导致梳状滤波或抵消。Neural Analog 的模型以保留相位关系为设计目标,这对分轨母带处理与重混音很重要。可在 DAW 中将分轨相加,再与原始版本比较。
伪影的可听程度
请聆听常见分离伪影:
- 串音:某种乐器在错误分轨中隐约出现
- 快速断续:提取时迅速切换有声与无声
- 瞬态模糊:瞬态失去清晰轮廓
- 高频缺失:缺乏空气感与细节
修复可纠正其中许多问题,但干净音源能在提取阶段减少问题。之后在 DAW 中,只保留每条分轨里听感合适的部分。
何时使用各类模型
以下情况使用固定分轨预设(BS-RoFormer):
- 需要标准人声、鼓或贝斯分离
- 处理速度很重要
- 源混音比较干净
- 希望结果可预测且经过验证
以下情况使用 SAM Audio(自定义):
- 标准预设未覆盖目标乐器
- 混音密集且声音重叠
- 需要分离相近声音,例如主奏吉他与节奏吉他
- 源音频包含不常见乐器或合成声音
以下情况按需修复:
- MP3 或流媒体音源有可听压缩损伤
- 原始文件低于 320 kbps,且缺失高频细节
- AI 生成音乐存在带宽截止或压缩伪影
- 经过耳朵检查,分轨在商业发行前需要修复
如何选择最佳 AI 分轨流程
先用一首熟悉的曲目测试。将提取分轨与原始混音比较,检查相位一致性与伪影程度。标准分离使用预设,其他任务使用 SAM Audio,而压缩或 AI 生成音源需要修复时再进行修复。
采用当前 AI 模型与修复技术,提取的分轨可接近原始多轨工程,适合重混音、采样与混音分析。
高质量分轨常见问题
哪种 AI 分轨模型最好?
对于人声、鼓、贝斯与器乐,BS-RoFormer 与 Mel-Band RoFormer 模型目前在公开基准上评分最高。若乐器不在这些固定分轨中,SAM Audio 等基于提示的模型更灵活。请查看最佳人声分离模型与最佳器乐分离模型排名。
Neural Analog 用 Demucs 分轨吗?
不用。4 条分轨与 6 条分轨预设使用 BS-RoFormer 模型,自定义乐器提取使用 SAM Audio。
为什么分轨听起来单薄或有水声感?
通常是源音频为低码率 MP3,或工具使用较旧模型。请从能获得的最佳音源开始,使用较新模型,再修复分轨。阅读 MP3 音质增强能否修复闷声分轨,了解修复能解决什么、不能解决什么。
相关指南
- 从完成的 Suno 歌曲中移除鼓声:通过鼓分轨分离,获取不含鼓的曲目。
- 用自己的鼓组替换 Suno 鼓声:移除 AI 鼓,再编写新的律动。
- 将立体声歌曲转换为 Dolby Atmos:将分轨放入 Atmos 声床与音频对象。