Качественное ИИ-разделение на стемы: как извлечь чистые стемы с SAM Audio и BS-RoFormer
Качественное ИИ-разделение на стемы зависит от трёх вещей: подходящей модели, обработки полной записи в стерео и восстановления источника при заметных повреждениях от сжатия. Для вокала, ударных и баса используйте специализированную модель с фиксированными стемами, например BS-RoFormer, а для других инструментов — SAM Audio от Meta. Стемы получаются чище, чем у старых инструментов разделения, таких как Spleeter или ранние версии Demucs.
Продюсеры, диджеи и создатели контента сталкиваются с одной проблемой. Нужна чистая аккапелла для ремикса, трек без ударных для практики или отдельный гитарный рифф для сэмплирования. Старые инструменты разделения оставляют мутный вокал и призрачные остатки ударных.
Руководство объясняет, что такое стемы, почему большинство инструментов разделения создаёт артефакты и как получить стемы для настоящего продакшена, в том числе из песен Suno.
Что такое стемы? Основы разделения аудио
Стемы — отдельные аудиодорожки, извлечённые из сведённой песни. Вместо одного стереофайла со всем содержимым вы получаете отдельные файлы вокала, ударных, баса, фортепиано и других инструментов. Каждый стем содержит только соответствующий элемент.
Есть сухие стемы (без эффектов) и стемы с эффектами (с применённой реверберацией, компрессией и другими эффектами). Сухие стемы — ингредиенты до готовки; стемы с эффектами — готовое блюдо. Модели из этой статьи извлекают только стемы с эффектами, поэтому каждый стем сохраняет обработку, которая была у него в миксе.
Почему стемы важны для современного музыкального продакшена
Стемы превращают неизменный стереомикс в гибкие составляющие. Со стемами высокого качества можно:
- Создавать караоке, удаляя вокал
- Делать мэшапы с чисто выделенной аккапеллой
- Строить ремиксы вокруг исходного вокала — идея планируемой функции ИИ-ремиксов Spotify
- Менять баланс микса, регулируя уровни отдельных инструментов
- Разучивать песни, слушая нужные партии соло
- Сэмплировать элементы без проникновения других инструментов
- Исправлять проблемные частоты на отдельных дорожках
До ИИ разделение на стемы опиралось на EQ-фильтрацию и фазовое вычитание, которые создавали артефакты и никогда полностью не выделяли партию. ИИ-модели улучшили результат, научившись распознавать тембр и гармоническую структуру вместо простой фильтрации частот.
Проблема большинства сервисов разделения на стемы
ИИ-инструменты разделения неравноценны. Многие сервисы обещают «высокое качество», но экономят на основе:
Демонстрационные площадки и инструменты для продакшена
Демонстрационная площадка SAM Audio от Meta обрабатывает только 30-секундные фрагменты в моно. Это подходит для демонстрации, но не когда нужна полная песня в стерео. Посмотрите, чем Neural Analog отличается от площадки SAM Audio.
Ограничения одной модели
Многие сервисы используют единственную модель и вынуждены идти на компромиссы. Модели с фиксированными стемами, такие как Demucs или BS-RoFormer, хорошо справляются с заданными вариантами разделения (вокал, ударные, бас, остальное), но не могут выделять произвольные инструменты, например саксофон или синтезатор. Другие модели дают произвольное извлечение, но стандартные стемы разделяют менее чисто, чем специализированные инструменты.
Нет цепочки восстановления аудио
Разделение сжатых источников, например MP3 или записей стриминга, выявляет уже имеющиеся артефакты. MP3 с низким битрейтом часто обрезают всё выше примерно 16 kHz и добавляют шум квантования, размывающий транзиенты. Инструмент, игнорирующий это, просто яснее выделяет повреждённое аудио.
Как SAM Audio развивает разделение на стемы
SAM Audio от Meta — универсальная модель разделения источников, а не специализированный инструмент удаления вокала. Meta описывает её как единую модель, принимающую текстовые, визуальные промпты и временные интервалы, построенную на трансформере flow-matching и обученную на масштабных смесях аудио с речью, музыкой и общими звуками.
Услышьте разницу: SAM Audio и стандартные инструменты
Ниже практическое сравнение. Мы взяли плотный классический микс и выделили стем фортепиано с SAM Audio (Neural Analog) и у ведущего конкурента.
Пример: сравнение извлечения фортепиано
Выделение одного инструмента из плотного стереомикса с промптом 'piano'.
Технология SAM Audio
SAM Audio использует трансформер flow-matching, чтобы предсказать целевой источник по смешанной записи. В Neural Analog Studio можно описать источник текстом и отметить временной интервал, где он появляется. Визуальные промпты относятся к исследовательской модели и не являются элементом управления в текущем аудиоинтерфейсе Studio. Для продюсеров отличие заключается в управляемости: модель может выделять звуки вне фиксированных категорий вокала, ударных, баса и остального.
Нейросетевой аудиоэнкодер: почему архитектура определяет качество
Любой ИИ-инструмент разделения строится вокруг нейросетевого аудиоэнкодера. Он превращает исходную волновую форму в компактное представление тембра, высоты тона, ритма и размещения в стерео. Представьте его «ушами» модели: способность отличить малый барабан от вокала зависит от качества обучения энкодера.
Ранние модели, например Spleeter, использовали CNN-энкодеры, обрабатывающие спектрограммы как двумерные изображения. Они справлялись с простым разделением вокала и ударных, но испытывали трудности с тонкими деталями тембра и стабильностью во времени. Demucs v4 (Hybrid Transformer Demucs) обрабатывает и волновую форму, и спектрограмму, что помогает сохранить транзиенты и фазу для естественного звучания. BS-RoFormer делит спектрограмму на частотные полосы и моделирует их слоями Transformer. Его статья сообщает о среднем SDR 9,8 dB на бенчмарке MUSDB18-HQ, выше Demucs v4. Наше сравнение Spleeter и Demucs подробно рассматривает старые модели.
SAM Audio идёт дальше с Perception Encoder Audiovisual (PE-AV), обученным на более чем 100 миллионах видеоклипов. Обучение по видео позволяет связывать звуки с инструментами и действиями, которые их создают. Это помогает с промптами вроде "guitar", особенно когда гитара занимает тот же частотный диапазон, что и другие инструменты.
Исследовательская архитектура SAM Audio
dog barking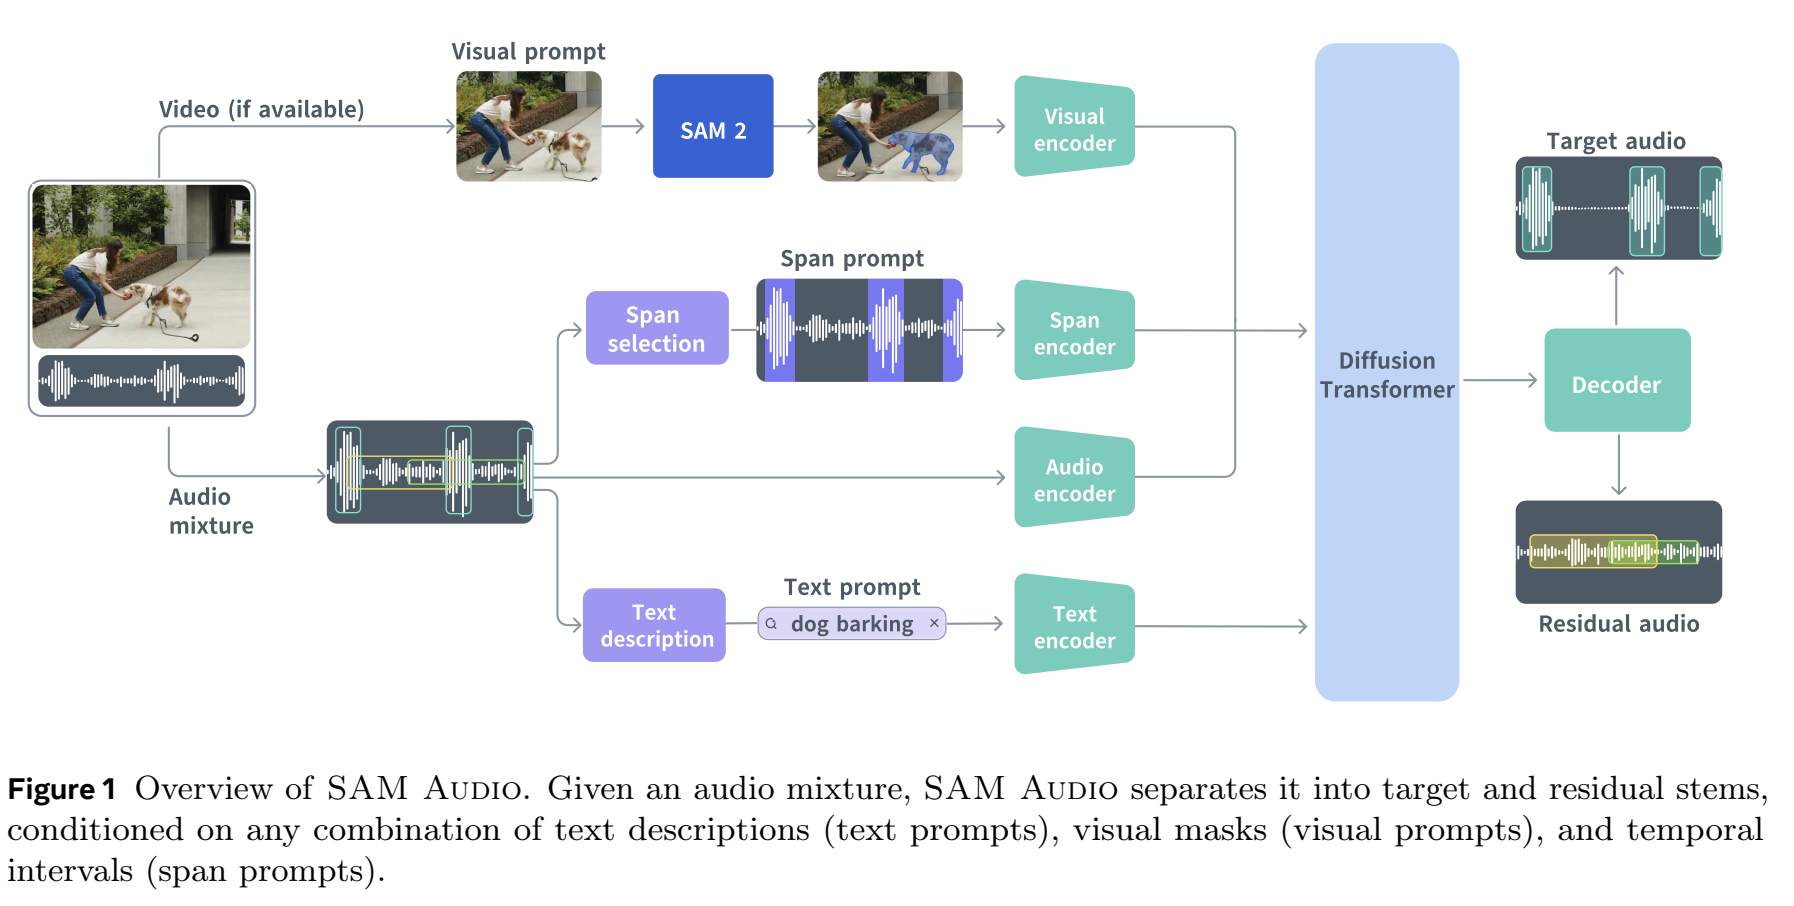
Оригинальная иллюстрация: Исследовательская архитектура SAM Audio.
Качество энкодера напрямую влияет на стемы тремя способами:
- Разрешение тембра: лучшие энкодеры отделяют гармоники от шума, сохраняя характер инструментов
- Временная согласованность: сильные энкодеры поддерживают стабильное разделение во времени, избегая частых в дешёвых инструментах артефактов прерывистого включения и выключения
- Детали: большие энкодеры захватывают скрипы струн, дыхание и акустику комнаты
Сравнивая сервисы, спрашивайте, какую модель они используют, а не доверяйте рекламе. Постобработка не может полностью компенсировать старый энкодер.
Как Neural Analog использует SAM Audio и BS-RoFormer
ИИ-инструмент разделения на стемы Neural Analog превращает SAM Audio и BS-RoFormer в практический инструмент для музыкантов.
В отличие от демонстрационной площадки с 30-секундным моно Neural Analog обрабатывает полные треки в полноценном стерео, поэтому стемы сохраняют ширину и глубину исходного микса.
Можно выбрать SAM Audio или проверенные пресеты с фиксированными стемами:
- SAM Audio для извлечения произвольных инструментов (саксофон, синтезатор, струнные)
- Пресеты для быстрого и надёжного разделения: 4 стема (вокал, ударные, бас, остальное) или 6 стемов (с добавлением гитары и фортепиано), работающие на BS-RoFormer, более новом поколении моделей с фиксированными стемами, чем Demucs
В SAM Audio онлайн можно написать промпт и отметить интервалы на волновой форме, если нужный звук появляется только в части трека. Есть вопросы или результаты, которыми хотите поделиться? Присоединяйтесь к Discord Neural Analog.
Встроенная цепочка восстановления аудио
Извлечённые стемы можно пропустить через восстановление аудио, чтобы расширить частотный диапазон и убрать часть артефактов. Послушайте результат: восстановление исправляет не все ошибки разделения.
Более качественные стемы Suno: почему ИИ-музыке нужен особый подход
Suno и другие генераторы ИИ-музыки, включая Udio и FlowMusic / Producer.ai, часто создают сжатые файлы или файлы с ограниченной полосой частот. Это ограничивает качество ещё до разделения на стемы. Для разделения песни Suno прямо по ссылке используйте инструмент стемов Suno. Udio больше не предлагает скачивание или стемы, поэтому сначала сохраните песни Udio как аудиофайлы.
Проблема двойного сжатия
Разделение MP3 Suno простыми инструментами работает с уже повреждённым аудио. Стемы наследуют:
- Сильную потерю высоких частот (часто ничего выше 15 kHz)
- Шум квантования в самом сигнале
- Уменьшенную ширину и глубину стерео
- Артефакты цифрового «звона»
Как восстановление улучшает ИИ-музыку
Процесс поэтапно устраняет эти ограничения:
- Извлечение: SAM Audio или модель пресета разделяет стемы
- Удаление артефактов: нейросетевое восстановление может уменьшить шум сжатия MP3
- Реконструкция частот: модель предсказывает и заново создаёт гармоническое содержимое до 20 kHz
- Работа со стерео: сохраняйте стереосигналы при восстановлении деталей, затем сравните ширину и фазу с источником на слух
Полученные стемы Suno звучат ближе к профессиональной многодорожечной записи.
Пошагово: как получить качественные стемы в Neural Analog
Следуйте этим шагам для стабильного результата. Руководство Studio по разделению стемов подробнее описывает каждый элемент управления.
Шаг 1: загрузите аудио
Перетащите файл или вставьте общедоступную ссылку поддерживаемого источника, например Suno, FlowMusic, TopMediaAI, Treblo, Mureka или YouTube. Для загрузки поддерживаются MP3, WAV, FLAC, M4A и OGG. Максимальная длительность зависит от вашего тарифа и выбранной модели.
Шаг 2: выберите способ разделения
Для предсказуемого результата откройте Разделение на стемы и выберите 4 стема для вокала, ударных, баса и остального либо 6 стемов, чтобы добавить гитару и фортепиано. Проверьте выбранный Вход. Эти пресеты запускают специализированные модели с фиксированными стемами и дают стабильное разделение.
Для произвольных инструментов выберите Свой промпт, чтобы использовать SAM Audio. Проверьте выбранную Модель, затем опишите звук. Будьте точны: electric guitar solo with distortion работает лучше, чем guitar. SAM Audio возвращает два взаимодополняющих стема: звук, соответствующий промпту, и остальную запись.
Шаг 3: настройте обработку
Обработка стерео SAM Audio: режим по умолчанию Стерео (центр/разность) обрабатывает центральный (Mid) и разностный (Side) сигналы отдельно, затем снова объединяет их. Выберите Стерео (L/R) для отдельной обработки левого и правого каналов или Моно, чтобы усреднить их в один канал. Эти настройки относятся к SAM Audio; пресеты с фиксированными стемами используют собственные стереомодели. Посмотрите, когда применять обработку Mid/Side.
Шаг 4: обработайте и скачайте
Для одного только разделения оставьте Улучшить стемы выключенным. Проверьте оценку минут обработки, которые спишутся с баланса, затем нажмите Начать извлечение и подождите. Короткие треки часто завершаются за несколько минут; длинным трекам и более тяжёлым моделям нужно больше времени. Прослушайте каждый стем в Studio, затем откройте Экспорт и выберите Отдельные стемы для отдельных файлов или Сведённые стемы для текущего микса.
Шаг 5: восстановите извлечённые стемы
Если у стема отсутствуют высокие частоты или слышны повреждения от сжатия, выберите его в поле Вход раздела Улучшить, выберите Восстановление музыки MP3 для инструментов или Улучшение пения для вокала и нажмите Запустить модель. Сравните результат перед экспортом. Руководство по восстановлению MP3 в WAV объясняет выбор моделей. Для автоматической обработки подходящих стемов после извлечения включите Улучшить стемы, выберите модель восстановления и проверьте дополнительный расход минут обработки до запуска извлечения. Чистым стемам восстановление не нужно.
Технические аспекты рабочего процесса продакшена
Добавляя извлечение стемов в свой рабочий процесс, проверьте следующие факторы:
Качество исходного файла
Восстановление может реконструировать сжатые файлы, но источники без потерь (WAV, FLAC) всё равно дают более точное разделение. У энкодера больше исходной информации, поэтому реконструировать приходится меньше.
Если инструмент появляется лишь на несколько секунд в длинном файле, отметьте этот интервал в Studio или обрежьте файл перед загрузкой. Модель получает более ясную цель, и обработка ускоряется.
Фазовая согласованность стемов
Стемы одной песни должны при сложении примерно восстанавливать исходный микс. Если их фаза смещается, объединение создаёт гребенчатую фильтрацию или взаимное подавление. Модели Neural Analog разработаны для сохранения фазовых соотношений, что важно для мастеринга стемов и ремиксов. Проверьте это, сложив стемы в DAW и сравнив с оригиналом.
Слышимость артефактов
Прислушайтесь к распространённым артефактам разделения:
- Проникновение: инструменты тихо слышны в чужом стеме
- Прерывистость: быстрое включение и выключение во время извлечения
- Размытие: потеря чёткости транзиентов
- Потеря высоких частот: нехватка воздуха и деталей
Восстановление исправляет многие такие проблемы, но чистый источник уменьшает их уже на этапе извлечения. После этого в DAW оставьте только те части каждого стема, которые звучат правильно.
Когда использовать каждый тип моделей
Используйте пресеты с фиксированными стемами (BS-RoFormer), когда:
- Нужно стандартное выделение вокала, ударных или баса
- Критична скорость обработки
- Исходный микс относительно чистый
- Нужны предсказуемые, проверенные результаты
Используйте SAM Audio для произвольного разделения, когда:
- Инструмент не охвачен стандартными пресетами
- Микс плотный, а звуки накладываются
- Нужно разделить похожие звуки (например, соло-гитару и ритм-гитару)
- Источник содержит необычные инструменты или синтезированные звуки
Используйте восстановление при необходимости:
- У MP3 или записи стриминга слышны повреждения от сжатия
- Битрейт исходного файла ниже 320 kbps и не хватает высокочастотных деталей
- У ИИ-музыки обрезана полоса частот или есть артефакты сжатия
- Стемы требуют восстановления перед коммерческим релизом после проверки на слух
Как выбрать лучший процесс ИИ-разделения на стемы
Начните с хорошо знакомого тестового трека. Сравните извлечённые стемы с исходным миксом, проверяя фазовую согласованность и уровень артефактов. Для стандартного разделения используйте пресеты, для остального SAM Audio, а восстановление — когда сжатый или созданный ИИ источник требует исправления.
С современными ИИ-моделями и восстановлением извлечённые стемы могут приблизиться к исходной многодорожечной сессии для ремиксов, сэмплов и анализа микса.
Вопросы о качественном разделении на стемы
Какая ИИ-модель лучше всего разделяет стемы?
Для вокала, ударных, баса и инструментальных партий модели BS-RoFormer и Mel-Band RoFormer сейчас получают высшие оценки в открытых бенчмарках. Для инструментов вне фиксированных стемов модели с промптами, такие как SAM Audio, гибче. Посмотрите наши рейтинги лучших моделей для вокала и лучших моделей для инструментов.
Использует ли Neural Analog Demucs для стемов?
Нет. Пресеты на 4 и 6 стемов используют модели BS-RoFormer, а извлечение произвольных инструментов — SAM Audio.
Почему стемы звучат тонко или словно под водой?
Обычно причина в MP3 с низким битрейтом или старой модели инструмента. Начните с лучшего доступного источника, используйте более новую модель и затем восстановите стемы. Прочитайте, исправляет ли улучшение MP3 глухо звучащие стемы, чтобы понять возможности и ограничения восстановления.
Связанные руководства
- Уберите ударные из готовой песни Suno: разделите стем ударных, чтобы получить трек без них.
- Замените ударные Suno собственным набором: удалите ИИ-ударные, затем запрограммируйте новый грув.
- Преобразуйте стереопесню в Dolby Atmos: разместите отдельные стемы в bed и объектах Atmos.