高品質AIステム分離:SAM AudioとBS-RoFormerでクリアなステムを抽出する方法
**高品質なAIステム分離には、目的に合ったモデル、曲全体のステレオ処理、圧縮による劣化がある音源の修復という3つの要素が重要です。**ボーカル、ドラム、ベースにはBS-RoFormerなどの専用固定ステムモデルを、その他の楽器にはMetaのSAM Audioを使います。Spleeterや初期のDemucsなど、古いステム分離ツールよりもクリアなステムを得られます。
プロデューサー、DJ、コンテンツ制作者は、同じような問題に直面します。リミックス用のクリアなアカペラ、練習用のドラムなし音源、サンプリング用に分離したギターリフが必要でも、古いステム分離ツールでは、こもったボーカルや、かすかに残るドラムのアーティファクトが生じます。
このガイドでは、ステムとは何か、多くの分離ツールがアーティファクトを生む理由、Sunoの曲も含めて実際の音楽制作に使えるステムを得る方法を説明します。
ステムとは?音源分離の基本
**ステムは、ミックスされた曲から抽出する個別の音声トラックです。**すべての音が入った1つのステレオファイルではなく、ボーカル、ドラム、ベース、ピアノ、その他の楽器を別々のファイルとして得られます。各ステムには、その要素だけが含まれます。
ステムにはドライステム(エフェクトなし)とウェットステム(リバーブやコンプレッションなどのエフェクトを適用済み)があります。ドライステムが調理前の材料なら、ウェットステムは完成した料理です。この記事のモデルが抽出するのはウェットステムのみなので、各ステムにはミックス時のエフェクトが残ります。
現代の音楽制作でステムが重要な理由
ステムは、固定されたステレオミックスを柔軟に扱えるパートへと変えます。高品質なステムがあれば、次のような作業ができます。
- ボーカルを除去してカラオケ音源を作る
- クリアに分離したアカペラでマッシュアップを作る
- 元のボーカルを軸にリミックスを作る。Spotifyが計画しているAIリミックス機能も、この考え方に基づいています
- 楽器ごとのレベルを調整してミックスのバランスを整える
- 特定のパートをソロで聴いて曲を覚える
- 他の楽器の音が混ざらないように要素をサンプリングする
- 分離したトラックで問題のある周波数を修正する
AI以前のステム分離は、EQによるフィルタリングと位相の打ち消しに頼っていました。アーティファクトが生じ、パートを完全には分離できませんでした。AIモデルは、単に周波数を除くのではなく、音色と倍音構造を認識するように学習することで、これを改善しました。
多くのステム分離サービスが抱える問題
AIステム分離ツールの性能は同じではありません。「高品質」をうたいながら、基本的な部分を省略するサービスも多くあります。
お試し環境と制作用ツール
MetaのSAM Audioのお試し環境で処理できるのは、30秒のモノ音声クリップだけです。デモには十分ですが、曲全体をステレオで処理したい場合には向きません。Neural AnalogとSAM Audioのお試し環境の違いをご覧ください。
単一モデルの限界
1つのモデルだけを使うサービスでは、トレードオフが生じます。DemucsやBS-RoFormerなどの固定ステムモデルは、決められた分離(ボーカル、ドラム、ベース、その他)には適していますが、サックスやシンセサイザーなど、任意の楽器は抽出できません。他のモデルには任意の音を抽出できるものもありますが、標準的なステムの分離は専用ツールほどクリアではありません。
音声修復の工程がない
MP3やストリーミングの録音など、圧縮された音源を分離すると、元からあるアーティファクトが目立ちます。低ビットレートのMP3では、およそ16 kHzを超える成分が失われ、トランジェントをぼかす量子化ノイズが加わることがよくあります。これを考慮しない分離ツールは、劣化した音声をよりはっきり分離するだけです。
SAM Audioがステム分離を進化させる仕組み
MetaのSAM Audioは、専用のボーカル除去モデルではなく、汎用の音源分離モデルです。Metaは、テキスト、視覚情報、時間区間のプロンプトを受け付ける単一モデルと説明しています。フローマッチングTransformerを基盤とし、話し声、音楽、一般的な音を含む大規模な混合音声で学習しています。
違いを聴く:SAM Audioと代表的な分離ツール
以下は実際の比較例です。音が密に重なったクラシックのミックスから、SAM Audio(Neural Analog)と主要な競合ツールを使ってピアノのステムを分離しました。
例:ピアノ抽出の比較
プロンプト 'piano' を使い、音が密に重なったステレオミックスから1つの楽器を分離します。
SAM Audioを支える技術
SAM AudioはフローマッチングTransformerで、混合録音から対象の音源を予測します。Neural Analog Studioでは、音源をテキストで説明し、その音が現れる時間区間を指定できます。視覚プロンプトは研究モデルの機能であり、現在のStudioの音声画面にある操作項目ではありません。制作における違いは、対象を指定できる範囲です。ボーカル、ドラム、ベース、その他という固定カテゴリ以外の音も抽出できます。
ニューラル音声エンコーダー:モデル構造が品質を左右する理由
すべてのAIステム分離ツールは、ニューラル音声エンコーダーを中心に構成されています。生の波形を、音色、音高、リズム、ステレオ位置のコンパクトな表現に変換します。モデルの「耳」と考えると分かりやすいでしょう。スネアとボーカルをどれだけ正確に聞き分けられるかは、このエンコーダーの学習にかかっています。
Spleeterなどの初期の分離モデルは、スペクトログラムを2D画像として扱うCNNエンコーダーを使っていました。基本的なボーカルとドラムの分離はできても、細かな音色の表現や時間方向の一貫性には課題がありました。Demucs v4(Hybrid Transformer Demucs)は、波形とスペクトログラムの両方を処理し、トランジェントと位相を保つことで、より自然な音を得ます。BS-RoFormerはスペクトログラムを周波数帯域に分け、Transformer層でモデル化します。その論文では、MUSDB18-HQベンチマークの平均SDRが9.8 dBで、Demucs v4を上回ると報告されています。古いモデルについては、SpleeterとDemucsの比較で詳しく説明しています。
SAM Audioは、1億本を超える動画クリップで学習した**Perception Encoder Audiovisual(PE-AV)**により、さらに進化しています。動画から学んでいるため、音を、その音を生む楽器や動作と結び付けます。これは「guitar」のようなプロンプトに役立ち、特にギターと他の楽器が似た周波数範囲にあるときに有効です。
SAM Audioの研究モデルの構成
dog barking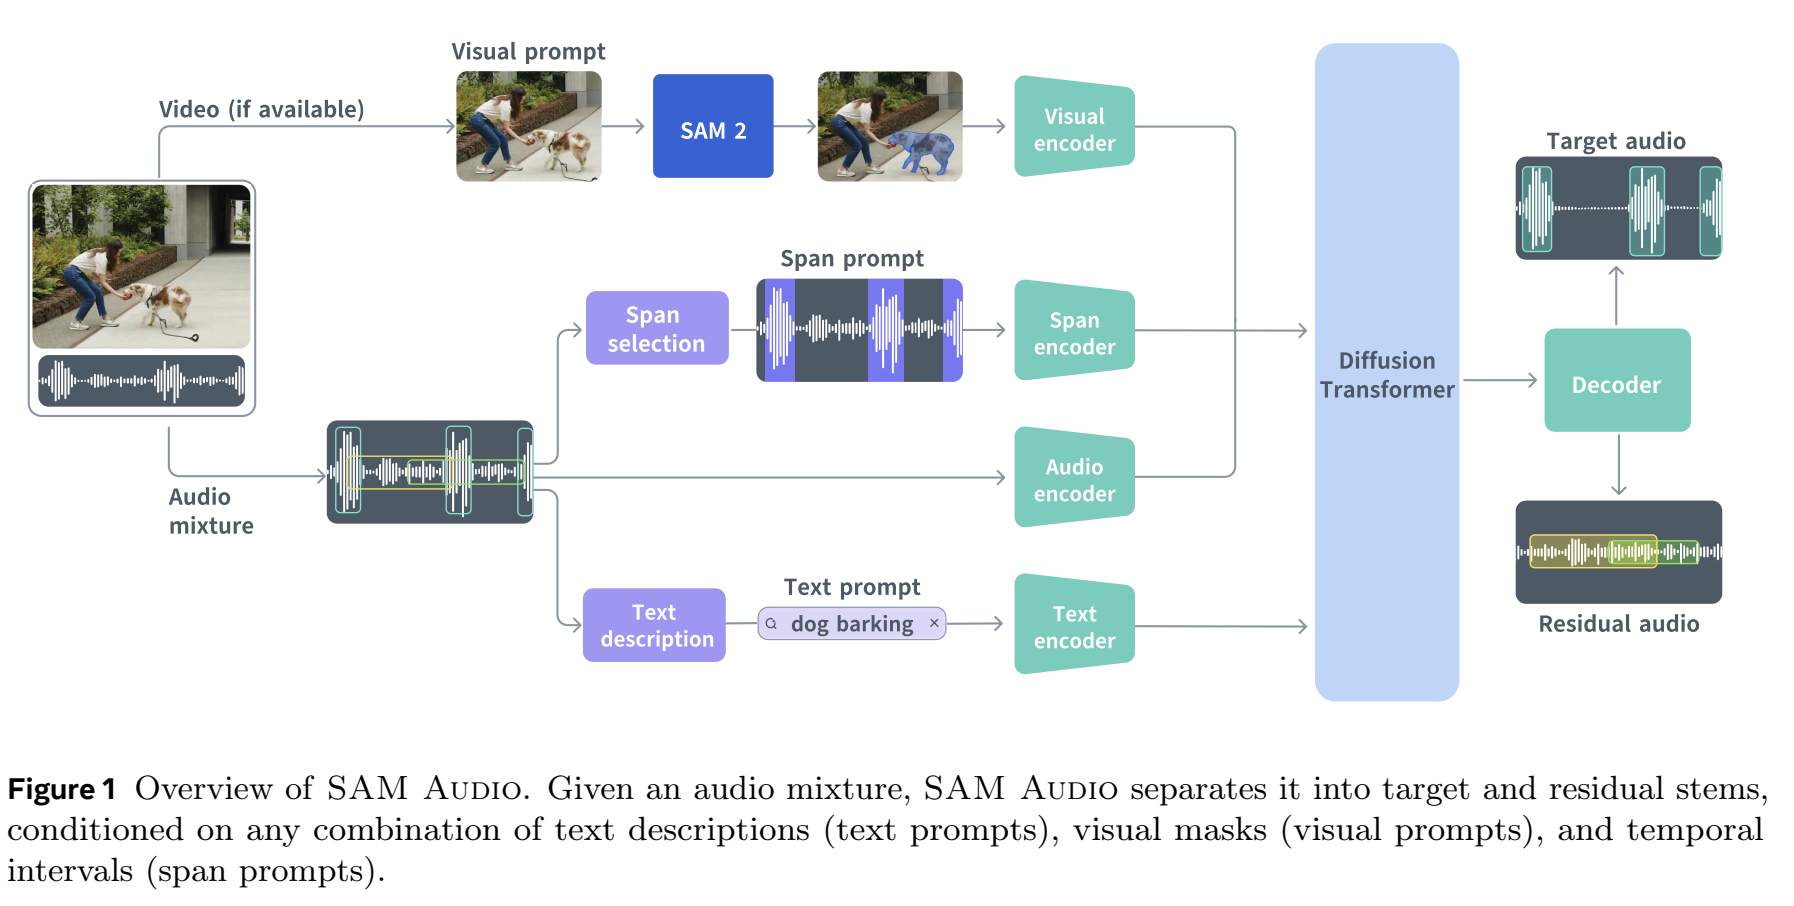
原図: SAM Audioの研究モデルの構成。
エンコーダーの品質は、次の3つの面でステムの品質に直接影響します。
- 音色の分解能力:優れたエンコーダーは倍音とノイズを区別し、楽器の個性を保ちます
- 時間方向の一貫性:より強力なエンコーダーは分離を時間的に安定させ、安価なツールに多い細かく音が途切れるアーティファクトを避けます
- 細部:大きなエンコーダーは、弦のきしみ、息遣い、室内の響きを捉えます
ステム分離サービスを比較するときは、**宣伝文句だけでなく、使っているモデルを確認してください。**後処理で古いエンコーダーの限界を完全に埋め合わせることはできません。
Neural AnalogでのSAM AudioとBS-RoFormerの使い分け
Neural AnalogのAIステム分離ツールは、SAM AudioとBS-RoFormerを、音楽家が実際に使える形で提供します。
30秒のモノ音声を扱うお試し環境とは異なり、Neural Analogは曲全体をフルステレオで処理するため、ステムに元のミックスの広がりと奥行きが残ります。
SAM Audioと、実績のある固定ステムのプリセットから選べます。
- SAM Audio:サックス、シンセサイザー、弦楽器など、任意の楽器の抽出に使います
- プリセット:速く安定した分離に使います。4つのステムはボーカル、ドラム、ベース、その他で、6つのステムではギターとピアノが加わります。Demucsより新しい世代の固定ステム分離モデル、BS-RoFormerを使用します
オンラインのSAM Audioでは、対象の音が曲の一部にだけ現れる場合に、プロンプトを書き、波形上で区間を指定できます。質問や共有したい結果があれば、Neural Analog Discordに参加してください。
統合された音声修復の工程
抽出したステムに音声修復を適用すると、周波数範囲を広げ、一部のアーティファクトを軽減できます。結果を試聴してください。修復で、分離の誤りをすべて直せるわけではありません。
より良いSunoステム:AI生成音楽に特別な処理が必要な理由
Sunoや、Udio、FlowMusic / Producer.aiなどのAI音楽生成ツールは、圧縮されたファイルや帯域幅が制限されたファイルを出力することがよくあります。ステム分離の前から品質に上限があるということです。Sunoの曲のリンクから直接分離するには、Sunoステム分離ツールを使ってください。Udioは現在、ダウンロードもステムも提供していないため、まずUdioの曲を音声ファイルとして保存してください。
二重の圧縮の問題
基本的なツールでSunoのMP3を分離すると、すでに劣化した音声を扱うことになります。ステムにも次の問題が引き継がれます。
- 大きな高域の損失。15 kHzを超える成分がないことも多くあります
- 信号に含まれる量子化ノイズ
- 狭くなったステレオの広がりと奥行き
- デジタルの「リンギング」アーティファクト
修復でAI生成音楽を改善する仕組み
この工程は、こうした制限に段階的に対処します。
- 抽出:SAM Audioまたはプリセットのモデルでステムを分離します
- アーティファクト除去:ニューラル音声修復でMP3の圧縮ノイズを軽減できます
- 周波数の再構成:モデルが20 kHzまでの倍音成分を予測して再生成します
- ステレオ処理:ステレオ信号を保ちながら細部を修復し、元の音源と広がりや位相を聴き比べます
こうして得られるSunoのステムは、専門的に録音されたマルチトラックに近い音になります。
手順:Neural Analogで高品質なステムを得る方法
安定した結果を得るには、次の手順に従ってください。Studioのステム分離ガイドで、各操作項目を詳しく説明しています。
手順1:音声をアップロードする
ファイルをドラッグ&ドロップするか、Suno、FlowMusic、TopMediaAI、Treblo、Mureka、YouTubeなど、対応するサービスの公開リンクを貼り付けます。アップロード対応形式はMP3、WAV、FLAC、M4A、OGGです。最大の長さは、プランと選択したモデルによって異なります。
手順2:分離方法を選ぶ
予測しやすい結果を求める場合は、分離を開き、ボーカル、ドラム、ベース、その他を得る4つのステムか、ギターとピアノも加わる6つのステムを選びます。選択されている入力を確認してください。これらのプリセットは専用の固定ステムモデルで、安定した分離を行います。
任意の楽器を抽出する場合は、カスタムプロンプトを選んでSAM Audioを使います。選択されているモデルを確認し、音を説明してください。具体的に書きましょう。electric guitar solo with distortionのほうが、guitarよりも効果的です。SAM Audioは、互いを補完する2つのステムを返します。プロンプトに一致する音と、録音の残りの部分です。
手順3:処理を設定する
SAM Audioのステレオ処理:標準の**ステレオ(Mid/Sides)**では、ミッド(中央)とサイドの信号を別々に処理してから再結合します。**ステレオ(L/R)**を選ぶと左右のチャンネルを個別に処理し、モノを選ぶと平均して1つのチャンネルにまとめます。これらの操作項目はSAM Audioに適用され、固定ステムのプリセットはそれぞれのステレオモデルを使います。Mid/Side処理を使う場面をご覧ください。
手順4:処理してダウンロードする
分離だけを行う場合は、ステムの音質を改善をオフにしておきます。残高から差し引かれる処理分数の見積もりを確認してから、抽出を開始をクリックして待ちます。短い曲は数分で終わることが多く、長い曲や負荷の大きなモデルでは時間がかかります。Studioで各ステムを確認し、書き出しを開きます。別々のファイルには個別のステム、現在のミックスには合成したステムを選んでください。
手順5:抽出したステムを修復する
ステムに高域が欠けていたり、圧縮による劣化が聴こえたりする場合は、音質改善の入力でそのステムを選びます。楽器にはMP3音楽の修復、ボーカルには歌声の改善を選び、モデルの実行を開始をクリックしてください。書き出す前に結果を比較します。MP3からWAVへの修復ガイドでモデルの選び方を説明しています。抽出後に対象となるステムを自動処理する場合は、ステムの音質を改善を有効にして修復モデルを選び、抽出を始める前に追加の処理分数の見積もりを確認します。クリアなステムに修復は不要です。
制作工程で確認したい技術的なポイント
制作工程にステム抽出を取り入れる際は、次の点を確認してください。
元ファイルの品質
修復で圧縮ファイルを再構成できますが、WAVやFLACのようなロスレス音源のほうが、より正確に分離できます。エンコーダーが使える元の情報が多く、再構成する部分が少なくなるためです。
長いファイルの中で、対象の楽器が数秒しか鳴らない場合は、Studioでその区間を指定するか、アップロード前にファイルを切り出してください。モデルの対象が明確になり、処理も速くなります。
ステムの位相の一貫性
同じ曲のステムを足し合わせると、おおむね元のミックスに戻るはずです。位相がずれると、再結合した際にコムフィルター効果や打ち消しが生じます。Neural Analogのモデルは位相関係を保つよう設計されており、ステムのマスタリングやリミックスでは重要です。DAWでステムを足し合わせ、元の音源と比較して確認してください。
アーティファクトの聴こえ方
一般的な分離アーティファクトがないか確認します。
- 音の漏れ:別のステムに楽器の音がかすかに入る
- 細かい途切れ:抽出した音が短い間隔で出たり消えたりする
- にじみ:トランジェントの鋭さが失われる
- 高域の損失:空気感や細部が足りなくなる
修復で多くの問題を改善できますが、良い音源を使えば抽出段階で問題を減らせます。その後、DAWで各ステムの適切に聴こえる部分だけを残してください。
モデルの種類を使い分ける場面
固定ステムのプリセット(BS-RoFormer)が向く場合
- 一般的なボーカル、ドラム、ベースの分離が必要
- 処理速度が重要
- 元のミックスが比較的クリア
- 予測しやすく、検証された結果が欲しい
SAM Audio(任意の音の分離)が向く場合
- 標準のプリセットにない楽器を抽出する
- ミックスが密で、音が重なっている
- リードギターとリズムギターなど、似た音を分けたい
- 珍しい楽器や合成音が含まれている
必要に応じて修復を使う場合
- MP3やストリーミング音源に、圧縮による劣化が聴こえる
- 元ファイルが320 kbps未満で、高域の細部が失われている
- AI生成音楽に帯域幅の制限や圧縮アーティファクトがある
- 耳で確認したうえで、商用リリース前にステムを修復する必要がある
最適なAIステム分離の工程を選ぶ方法
よく知っているテスト曲から始めましょう。抽出したステムと元のミックスを比べ、位相の一貫性とアーティファクトの程度を確認します。標準的な分離にはプリセット、それ以外にはSAM Audioを使い、圧縮音源やAI生成音源に修復が必要なときに修復を加えます。
現在のAIモデルと修復を使えば、リミックス、サンプリング、ミックス分析に使う抽出ステムを、元のマルチトラックセッションに近づけることができます。
高品質ステム分離のFAQ
ステム分離に最適なAIモデルは何ですか?
ボーカル、ドラム、ベース、インストゥルメンタルでは、現在、BS-RoFormerとMel-Band RoFormerのモデルが公開ベンチマークで最も高いスコアを記録しています。固定ステム以外の楽器には、SAM Audioのようなプロンプト型モデルのほうが柔軟です。ボーカルに最適なモデルと楽器に最適なモデルのランキングをご覧ください。
Neural Analogはステム分離にDemucsを使っていますか?
いいえ。4つのステムと6つのステムのプリセットはBS-RoFormerを使い、任意の楽器の抽出にはSAM Audioを使います。
ステムの音が薄く、水の中のように揺らいで聴こえるのはなぜですか?
多くの場合、元の音源が低ビットレートのMP3か、ツールが古いモデルを使っているためです。手元で最も良い音源から始め、新しいモデルを使い、その後ステムを修復してください。MP3の音質改善でこもったステムを直せるかを読んで、修復で直せることと直せないことを確認してください。
関連ガイド
- 完成したSunoの曲からドラムを除去する:ドラムのステム分離で、ドラムなしの音源を得ます。
- Sunoのドラムを自分のキットに置き換える:AIのドラムを除去し、新しいグルーヴを打ち込みます。
- ステレオの曲をDolby Atmosに変換する:分離したステムをAtmosのベッドとオブジェクトに配置します。