2026年SpleeterとDemucs比較:性能と両者を上回るモデル
SpleeterとDemucsの選択は、速度と品質のどちらを優先するかに行き着きます。Demucsはステムをよりクリーンに分離します。微調整したDemucs v4のSDRは9.0 dBで、Spleeterは5.9 dBです。一方、Spleeterははるかに高速で、控えめな性能のCPUでも快適に動きます。2026年には、BS-RoFormerなどの新しいモデルが両者を上回るスコアを出しています。
| Spleeter | Demucs v4(HT Demucs) | |
|---|---|---|
| 開発元 | Deezer、2019年 | Meta AI Research、2022年 |
| 仕組み | スペクトログラムにマスクを適用(U-Net) | Transformerを使う波形とスペクトログラムの分岐 |
| 品質(MUSDB18のSDR) | 5.9 dB | 9.0 dB(微調整後) |
| 速度 | 非常に高速、CPUでも十分 | 遅めで、GPUが最適 |
| ステム | 2、4、または5 | 4、またはギターとピアノを含む6 |
| 適した用途 | 素早い試聴、カラオケ、バッチ処理 | リミックスやリリース用のクリーンなステム |
ボーカルを抽出したり、リミックス用の伴奏を作ったりしたことがあれば、どちらかを基盤とするツールを使った可能性があります。両方のオープンソースモデルがステム分離の基準となり、今でも比較すると速度、アーティファクト、品質のトレードオフが分かります。
ステムとは?分離はなぜ難しいのでしょうか?
ステムは、ミックスされた曲の個々の構成要素です。一般にはボーカル、ドラム、ベース、それ以外の音を指します。プロデューサーはスタジオでそれぞれを扱い、最終ミックスですべてを組み合わせます。
ミックス後に分離するのは、焼いたケーキを元の材料に戻そうとするようなものです。楽器は同じ周波数帯域を共有します。ボーカルの倍音はギターの周波数と重なり、キックのトランジェントはベースの音を覆い、クラッシュシンバルはステレオ音場全体に広がります。従来の信号処理では、音が揺らぎ、アーティファクトが多く残る結果になりました。
深層学習は、従来の信号処理が見逃していたパターンを認識するようニューラルネットワークを学習させ、これを改善しました。SpleeterとDemucsは2つの代表モデルになりましたが、採っている方法は大きく異なります。
歴史:Spleeter、Demucsとパリとの関係
Spleeter:Deezerの高速スペクトログラムマスキング
2019年11月、フランスのストリーミングサービスDeezerは、無料のオープンソースツールとしてSpleeterを公開しました。Romain Hennequin率いるチームは、振幅スペクトログラム(音声の時間と周波数の表現)を処理するU-Net畳み込みニューラルネットワークを中心に、TensorFlowで構築しました。
Spleeterは分離を画像のセグメンテーションのように扱います。時間と周波数の各ビンにソフトマスクを予測し、その成分のどれだけがボーカル、ドラム、ベース、その他に属するかを推定します。任意のウィーナーフィルタリングでマスクを改善し、元のミックスの位相を使ってステムを再構成します。
Spleeterの強みは速度です。4分の曲を数秒で分離し、GPUでは実時間の100倍の速度に達します。性能を抑えたCPUでも快適に動きます。2ステム(ボーカル/伴奏)、4ステム、5ステムの構成があり、研究のベースラインとして、また数多くのYouTubeリミックスチャンネルの基盤として使われました。
Demucs:Metaの波形領域での分離
Spleeterが速度を重視した一方、Meta AI Research(当時のFacebook AI Research)は品質に注力しました。同じくフランス人のAlexandre Défossezとチームが、2019年に異なる方法を採るDemucsを発表しました。名前はDeep Extractor for MUlti-Channel Sourcesの略で、多チャンネル音源の深層抽出器を意味します。
Demucsはスペクトログラムではなく生の波形を直接扱い、分離を時間領域での再構成問題と捉えます。Wave-U-Netを参考にしたU-Net型の畳み込みエンコーダーとデコーダーに、ボトルネックとなる双方向LSTMを組み合わせます。これにより、長期的な音楽構造を捉え、位相の一貫性を保てます。
Demucsは4つの主要バージョンを経て発展しました。
- v1(2019年):波形のみを扱う方法で、すでにスペクトログラム方式に匹敵
- v2(2020年):学習方法を洗練し、効率を改善
- v3「Hybrid Demucs」(2021年):スペクトログラム分岐を追加し、MUSDB18でSDR 7.7 dBを達成してMusic Demixing Challengeで優勝
- v4「Hybrid Transformer Demucs」(2022年):最も内側の層を領域間Transformerに置き換え、微調整でSDR 9.0 dB、論文の最良構成では最大9.2 dBに到達
Sound Demixing Challengeと新たな始まり
Sound Demixing Challenge 2023は、研究の焦点を変えました。MetaやSonyなどが主催したこの大会では、ロバストな音楽音源分離を導入しました。ノイズを含むラベルやステム間の音漏れがあるデータでモデルを学習させるものです。Alexandre Défossezは中心的な主催者で、大会の設計とベースラインモデルに貢献しました。
主な発見は、学習データを増やしても結果がよくなるとは限らないことでした。データの品質とロバスト性を高める戦略のほうが重要です。損失の切り捨てや反復的な改善などの手法により、ノイズのあるデータでSDRが0.89 dB向上しました。
その後間もなく、DéfossezはMetaを離れ、フランスのAI研究所Kyutaiを共同設立しました。Demucsリポジトリは今も公開されていますが、READMEには本人が積極的な開発を続けていないと記載されているため、新機能は期待しないでください。
性能:速度と品質のトレードオフ
アーキテクチャーの考え方
**Spleeterはスペクトログラムにマスクを適用し、Demucsは波形を再構成します。**この本質的な違いが、ほかの違いを生みます。
Spleeterの周波数領域の方法は効率的です。STFTの各フレームが数千のサンプルをまとめるため、畳み込みが処理する時間ステップは大幅に少なくなります。代わりに、モデルは位相を考慮せず、ミックスの位相を再利用します。また、STFTの固定された時間周波数分解能では、鋭いトランジェントと安定した音をどちらもうまく表現することはできません。
Demucsの時間領域の方法は、1D畳み込みを通じて独自のフィルターバンクを学習します。位相を保ち、サンプル単位の精度でトランジェントを扱います。v4ではTransformer層が数秒にわたる音声の文脈を維持し、フレームベースの方法に多い「ピンポン」アーティファクトを減らします。
Hybrid Demucs v3:波形とスペクトログラムの分岐
エンコーダーとデコーダーのスキップ接続
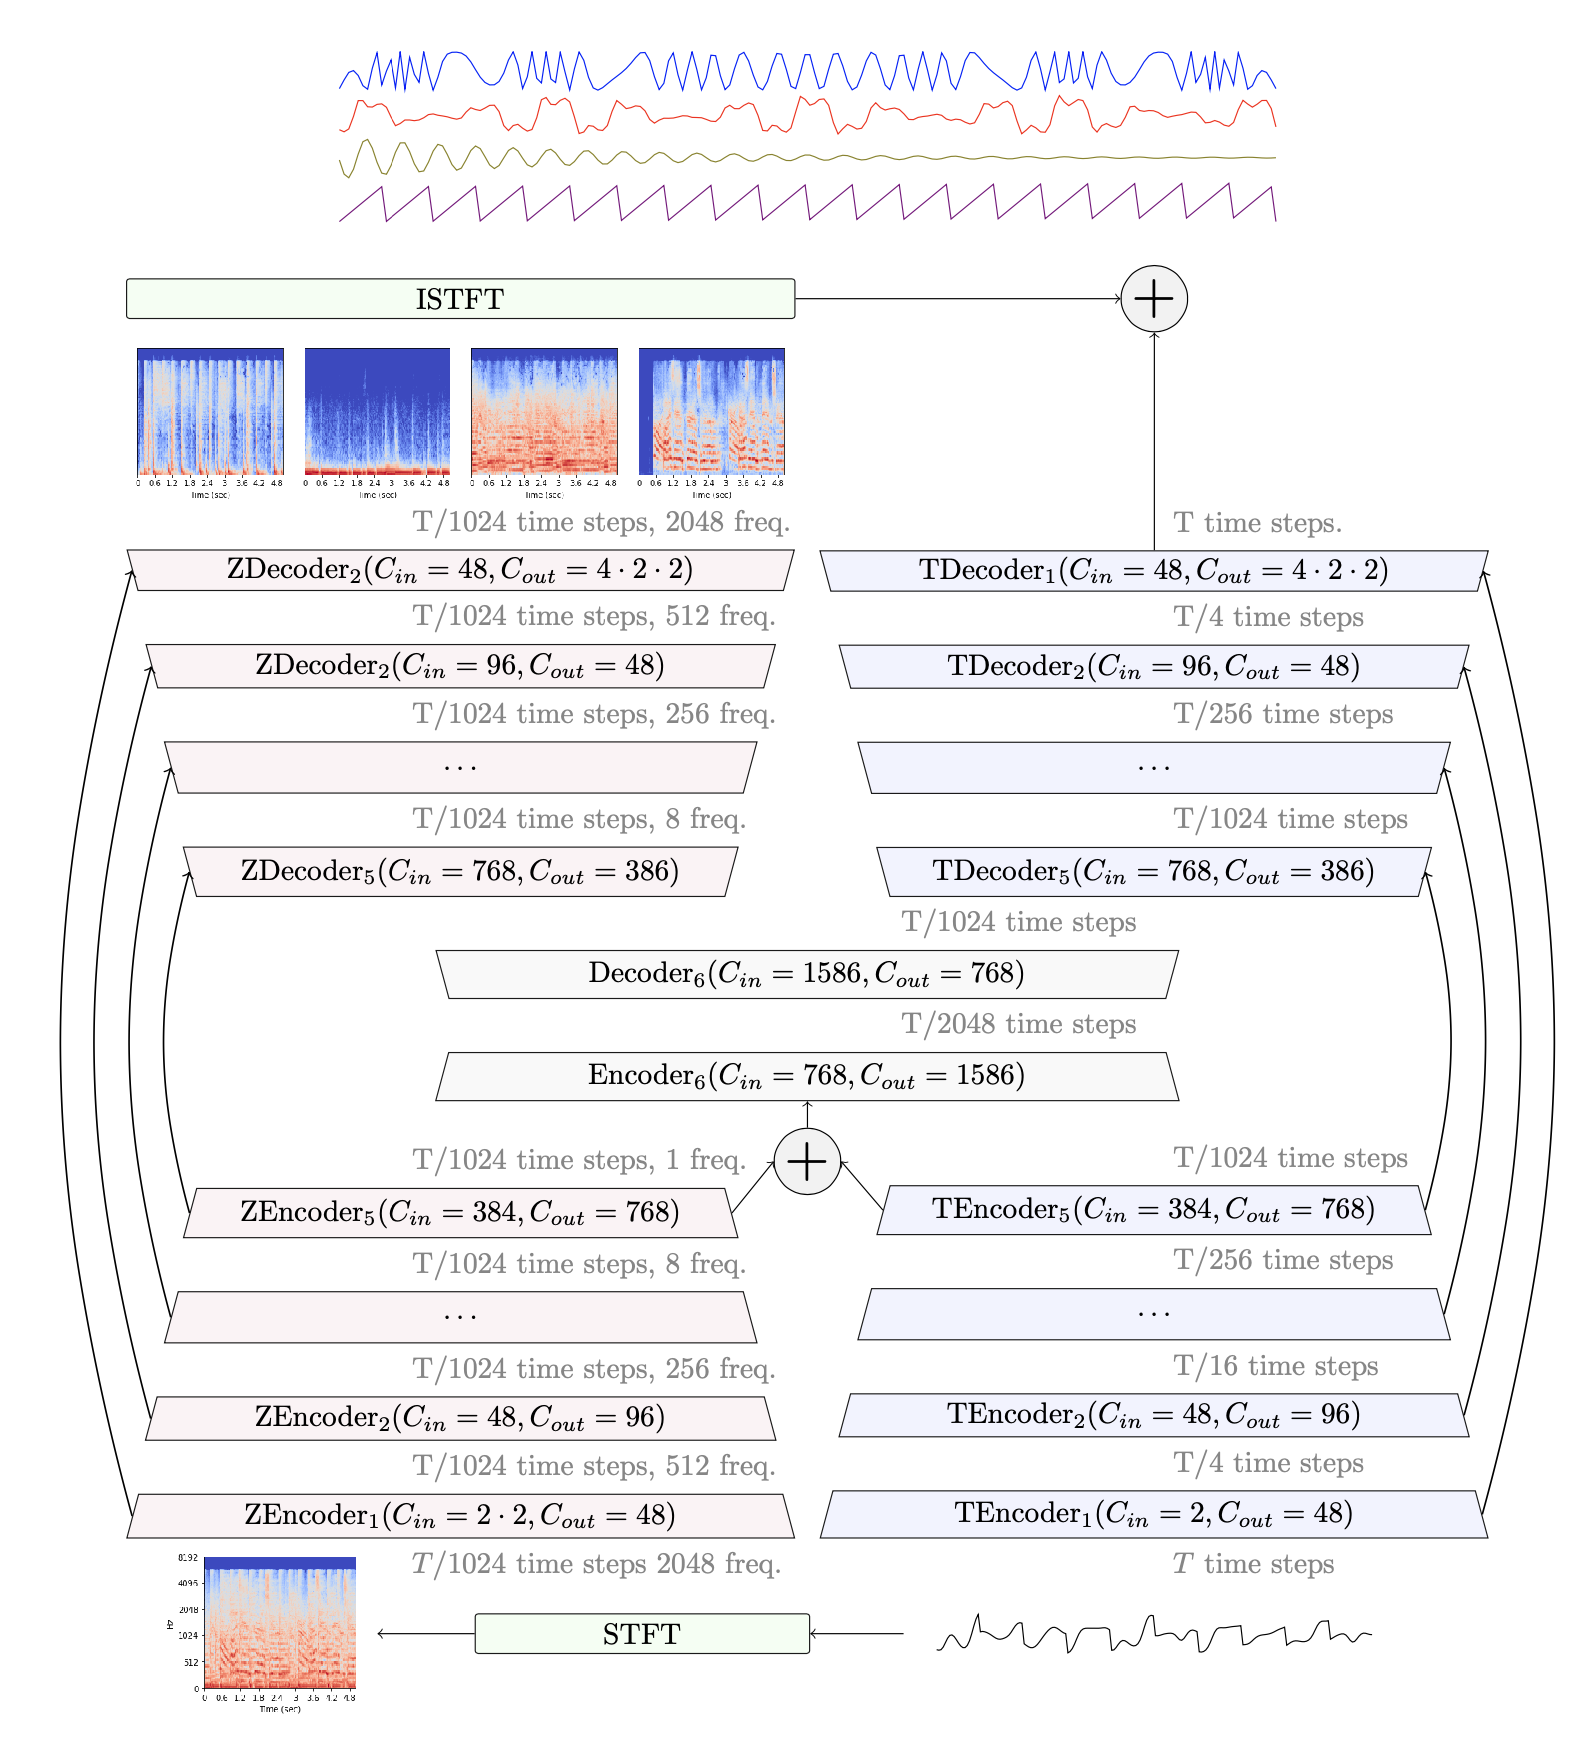
原図: 音源分離の入門解説、図2 (Woosung Choi, Alexandre Defossez, Haohe Liu)。
SpleeterとDemucsのベンチマーク数値
以下のMUSDB18テストセットのスコアは、Demucs公式GitHubリポジトリに基づきます。
| モデル | 領域 | 追加学習データ | 総合SDR | MOS品質 |
|---|---|---|---|---|
| Spleeter | スペクトログラム | 25,000曲 | 5.9 dB | データなし |
| Demucs v2 | 波形 | なし(MUSDB18のみ) | 6.3 dB | 2.37 |
| Hybrid Demucs v3 | ハイブリッド | なし(MUSDB18のみ) | 7.7 dB | 2.83 |
| 微調整したHT Demucs v4 | ハイブリッド | 800曲 | 9.0 dB | データなし |
信号対歪み比(SDR)は、モデルがミックスから音源をどれほどクリーンに分離するかを測る指標です。高いほどよいですが、試聴の代わりにはなりません。実際のAIステムに期待できる品質については、現在のAIステム分離の品質を参照してください。SpleeterとDemucs v4の約3 dBの差はベンチマーク上では大きく、Demucsはすべてのステム、特にドラムとボーカルで高いスコアを出しています。
下の比較動画で違いを聴けます。Demucsのステムはアーティファクトが少なく自然ですが、Spleeterは複雑な素材で金属的な響きを生じることがあります。

実際の作業での性能の違い
**速度:**GPUでは、Spleeterは3分の曲を約2秒で処理します。Demucs v4は約20〜30秒かかります。CPUでは、Spleeterはおよそ30〜60秒、Demucsは5分以上かかることがあります。
**ハードウェア:**SpleeterはRAM 8GBのノートPCでCPUだけでも動きます。Demucs v4を適切な速度で使うには、VRAM 4〜8GBのGPUが必要です。Transformer層はアテンション行列のため、はるかに多くのメモリを使います。
**アーティファクト:**Spleeterはミックスの位相を再利用するため、「幽霊のような」ぼんやりしたボーカルや、にじんだトランジェントが生じることがあります。Demucs v4はより自然ですが、無音部分に低レベルのノイズが残ることがあります。
**ロバスト性:**SDX'23では、Demucs型のアーキテクチャーが損なわれた学習データによりよく対応することが示されました。Spleeterの単純な構造では、選別したデータセットや損失の切り捨てなどの手法から容易に恩恵を得られません。
SpleeterとDemucs:どちらを使うべきでしょうか?
多くのプロデューサーは作業に応じて両方を使います。
Spleeterを使う場面
速度が重要な場合にSpleeterを使ってください。DJセット用のアカペラを素早く作る、練習用のカラオケ伴奏を作る、サンプルライブラリー全体をバッチ処理するといった用途です。実時間の100倍という速度と控えめなハードウェア要件は大きな強みで、ステムをさらに加工するリミックスには十分な品質です。
Demucsを使う場面
公式リミックス用のステム、商用リリースのサンプル、演奏の詳細な分析など、アーティファクトを許容できない場合はDemucs v4を選んでください。3 dBのSDR向上と位相の一貫性は、待つ価値があります。特定ジャンルの素材なら、追加データで微調整してください。Demucsのアーキテクチャーは、クリーンなデータを増やしたときの効果が高いためです。
SpleeterとDemucsを組み合わせる
楽曲カタログ全体をSpleeterで処理して有望な曲を探し、最後に選んだ曲をDemucsで処理します。ライブ演奏にはSpleeterで事前に分離し、スタジオ作業にはDemucsで最もクリーンなステムを作ります。Ultimate Vocal Removerなどのツールは、簡単なGUIにDemucsとほかの分離モデルをまとめています。
GPUは必要ですか?
SpleeterはCPUでも問題なく動きますが、高品質なDemucsの処理を実用的な速度で行うにはGPUの利用を推奨します。オフラインやノートPC向けのバッチ処理では、Spleeter型のモデルもまだ役立ちます。よりクリーンなステムには、Demucsや新しいハイブリッドTransformerモデルを使い、クラウド処理や強力なローカルマシンを用意する価値がある場合が多いです。
2026年の更新:SpleeterとDemucsを上回るモデル
SpleeterとDemucsは今でも有用な比較基準ですが、ステム分離の品質の上限ではなくなっています。
BS-RoFormer(Band-Split RoPE Transformer)は、スペクトログラムを周波数帯域に分け、Transformer層でモデル化します。論文では、追加の学習データなしでMUSDB18-HQの平均SDRが9.80 dBと報告されています。これは800曲を追加して微調整したDemucs v4の9.0 dBを上回ります。500曲の追加データで学習した版は、Sound Demixing Challenge 2023の音楽分離部門で1位を獲得しました。
| モデル | 年 | 総合SDR(MUSDB18) | 追加学習データ |
|---|---|---|---|
| Spleeter | 2019 | 5.9 dB | 25,000曲 |
| 微調整したHT Demucs(v4) | 2022 | 9.0 dB | 800曲 |
| BS-RoFormer | 2023 | 9.8 dB | なし |
Mel-Band RoFormerは近縁のモデルで、メル尺度で周波数をまとめます。両モデルのコミュニティ製チェックポイントは、現在ほとんどの高品質なボーカルや伴奏の分離ツールを支えています。ボーカル分離モデル比較では実際の曲で順位を付け、楽器分離モデル比較ではほかの楽器を同様に比較しています。
Neural AnalogのAIステム分離ツールは、4ステムと6ステムのプリセットにBS-RoFormerモデルを使います。サックスやシンセリードなど、プリセットに含まれない楽器を抽出したい場合はSAM Audioを使います。全一覧は、Neural Analogのステム分離に使われるモデルを参照してください。
SpleeterとDemucsのよくある質問
DemucsはSpleeterより優れていますか?
品質ならそうです。Demucs v4はMUSDB18ベンチマークでSpleeterよりSDRが約3 dB高く、ボーカルやドラムのアーティファクトが少なくなります。速度やCPUしかない環境を品質より優先する場合だけ、Spleeterのほうが適しています。
ボーカルにはSpleeterとDemucsのどちらが適していますか?
Demucsです。Spleeterは元のミックスの位相を再利用するため、ボーカルが薄く、あるいは「水っぽく」聞こえることがあります。最もクリーンなボーカルと伴奏を求めるなら、BS-RoFormerやMel-Band RoFormerモデルが通常は両者を上回ります。
Spleeterは今も保守されていますか?
Spleeterは今もGitHubで入手できますが、TensorFlowで作られた2019年のモデルで、READMEにはApple M1チップ上のTensorFlowの問題について警告があります。新しいツールの多くはDemucsやRoFormerモデルに移行しています。
Ultimate Vocal Remover(UVR)は何を使っていますか?
UVRは単一のモデルではなく、無料のデスクトップアプリです。Demucs、MDX-Net、独自のVR Architectureモデルなど複数のモデル群を含むため、品質は選んだモデルによって変わります。
GPUなしでDemucsを使えますか?
はい。ただし低速です。CPUでは1曲に数分かかると考えてください。オンラインのステム分離ツールは、代わりにサーバーのGPUでモデルを動かします。Studioのステム分離ガイドに手順を載せています。
関連ガイド
- Sunoの曲からドラムを除去する:ドラムステム分離の実用例です。
- AIドラムを自分のキットに置き換える:ドラムを分離し、ボーカルに合わせて新しいグルーヴを作ります。
- MP3ステムをWAV品質に修復する:圧縮音源と分離で失われた高域を再構成します。
- ステレオ曲をDolby Atmosに変換する:分離したステムをAtmosミックスに配置します。
- GitHubからAudioSRをインストールして実行する:PythonとPyTorchの設定を含む、ローカルで動かせる別のオープンソース音声モデルです。