Spleeter vs Demucs en 2026 : scores et modèles qui les dépassent
Le choix entre Spleeter et Demucs se résume à la vitesse face à la qualité. Demucs sépare les pistes plus proprement (9,0 dB SDR pour Demucs v4 affiné contre 5,9 dB pour Spleeter), tandis que Spleeter est bien plus rapide et fonctionne sans difficulté sur un CPU modeste. En 2026, des modèles plus récents comme BS-RoFormer obtiennent de meilleurs scores que les deux.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Développé par | Deezer, 2019 | Meta AI Research, 2022 |
| Fonctionnement | Masque un spectrogramme (U-Net) | Branches de forme d'onde et de spectrogramme avec un Transformer |
| Qualité (SDR sur MUSDB18) | 5,9 dB | 9,0 dB (après affinage) |
| Vitesse | Très rapide, fonctionne bien sur CPU | Plus lent, préférable avec un GPU |
| Pistes | 2, 4 ou 5 | 4, ou 6 avec guitare et piano |
| Usage idéal | Aperçus rapides, karaoké, traitements par lot | Pistes propres pour les remixes et les sorties musicales |
Si vous avez déjà essayé d'extraire une voix ou de créer un instrumental pour un remix, vous avez probablement utilisé un outil fondé sur l'un de ces modèles. Tous deux sont devenus des références open source de la séparation de pistes. Les comparer montre encore les compromis entre vitesse, artefacts et qualité.
Que sont les pistes séparées et pourquoi est-il si difficile de les isoler ?
Les pistes séparées, ou stems, sont les éléments individuels d'un morceau mixé, généralement la voix, la batterie, la basse et tout le reste. Les producteurs travaillent avec elles en studio avant que le mixage final ne rassemble le tout.
Les séparer après le mixage revient à vouloir défaire un gâteau déjà cuit. Les instruments partagent les mêmes plages de fréquences. Les harmoniques d'une voix chevauchent les fréquences de la guitare. Les transitoires de la grosse caisse empiètent sur les notes de basse. Les coups de cymbale se répartissent dans tout le champ stéréo. Le traitement du signal traditionnel produisait des résultats aux fluctuations peu naturelles et riches en artefacts.
L'apprentissage profond a amélioré les choses en entraînant des réseaux neuronaux à reconnaître des motifs que le traitement classique du signal ne repérait pas. Spleeter et Demucs sont devenus les deux modèles de référence, avec des approches très différentes.
Histoire : Spleeter, Demucs et leur lien avec Paris
Spleeter : le masquage rapide de spectrogrammes par Deezer
En novembre 2019, le service de streaming français Deezer a publié Spleeter, un outil gratuit et open source. L'équipe dirigée par Romain Hennequin l'a construit sur TensorFlow autour d'un réseau neuronal convolutif U-Net travaillant sur des spectrogrammes d'amplitude, des représentations temps-fréquence de l'audio.
Spleeter aborde la séparation comme une segmentation d'image. Il prédit un masque souple pour chaque cellule temps-fréquence, en estimant la part qui appartient à la voix, à la batterie, à la basse ou au reste. Une étape facultative de filtrage de Wiener affine les masques, puis les pistes sont reconstruites avec la phase du mixage original.
La force de Spleeter, c'est sa vitesse. Il sépare un morceau de quatre minutes en quelques secondes, jusqu'à 100 fois la vitesse du temps réel sur GPU, et fonctionne sans difficulté sur des CPU modestes. Il propose des configurations à 2 pistes (voix/accompagnement), 4 pistes et 5 pistes. Il est devenu une référence pour la recherche et a alimenté d'innombrables chaînes YouTube de remix.
Demucs : la séparation dans le domaine de la forme d'onde par Meta
Alors que Spleeter privilégiait la vitesse, Meta AI Research, alors Facebook AI Research, privilégiait la qualité. Alexandre Défossez, lui aussi français, et son équipe ont présenté Demucs en 2019, un nom tiré de Deep Extractor for MUlti-Channel Sources, avec une approche très différente.
Plutôt que les spectrogrammes, Demucs traite directement les formes d'onde brutes et considère la séparation comme un problème de reconstruction dans le domaine temporel. Son architecture combine un encodeur-décodeur convolutif de type U-Net, inspiré de Wave-U-Net, et un goulot d'étranglement LSTM bidirectionnel. Le réseau peut ainsi saisir la structure musicale à long terme et préserver la cohérence de phase.
Demucs a évolué en quatre versions majeures :
- v1 (2019) : approche fondée uniquement sur la forme d'onde, rivalisant déjà avec les méthodes par spectrogramme
- v2 (2020) : entraînement affiné et gains d'efficacité
- v3 « Hybrid Demucs » (2021) : ajout d'une branche de spectrogramme, victoire au Music Demixing Challenge avec 7,7 dB SDR sur MUSDB18
- v4 « Hybrid Transformer Demucs » (2022) : remplacement des couches les plus internes par un Transformer interdomaines, atteignant 9,0 dB SDR après affinage et jusqu'à 9,2 dB dans la meilleure configuration de l'article de recherche
Le Sound Demixing Challenge et un nouveau départ
Le Sound Demixing Challenge 2023 a déplacé les priorités. Organisé par Meta, Sony et d'autres, il a introduit la séparation robuste de sources musicales : entraîner les modèles sur des données aux étiquettes bruitées et avec des repisses entre pistes. Alexandre Défossez a été l'un des principaux organisateurs et a contribué à la conception du défi et aux modèles de référence.
Le principal constat était que davantage de données d'entraînement ne garantit pas de meilleurs résultats. La qualité des données et les stratégies de robustesse comptent davantage. Des techniques comme la troncature de la fonction de coût et l'affinage itératif ont amélioré le SDR de 0,89 dB sur des données bruitées.
Peu après, Défossez a quitté Meta pour cofonder Kyutai, un laboratoire français de recherche en IA. Le dépôt Demucs est toujours en ligne, mais son README indique qu'il n'y travaille plus activement : ne vous attendez donc pas à de nouvelles fonctionnalités.
Performances : compromis entre vitesse et qualité
Philosophie des architectures
Spleeter masque les spectrogrammes. Demucs reconstruit les formes d'onde. Cette différence fondamentale détermine tout le reste.
L'approche fréquentielle de Spleeter est efficace parce que chaque trame STFT résume des milliers d'échantillons : les convolutions portent donc sur bien moins de pas temporels. Le prix à payer : le modèle ignore la phase et réutilise celle du mixage. La résolution temps-fréquence fixe de la STFT ne représente pas bien à la fois les transitoires nets et les sons stables.
La méthode temporelle de Demucs apprend ses propres banques de filtres avec des convolutions 1D. Elle préserve la phase et traite les transitoires avec une précision à l'échantillon près. Dans v4, les couches Transformer maintiennent le contexte sur plusieurs secondes d'audio, réduisant les artefacts de « ping-pong » fréquents dans les méthodes par trame.
Hybrid Demucs v3 : branches de forme d'onde et de spectrogramme
Connexions de saut encodeur-décodeur
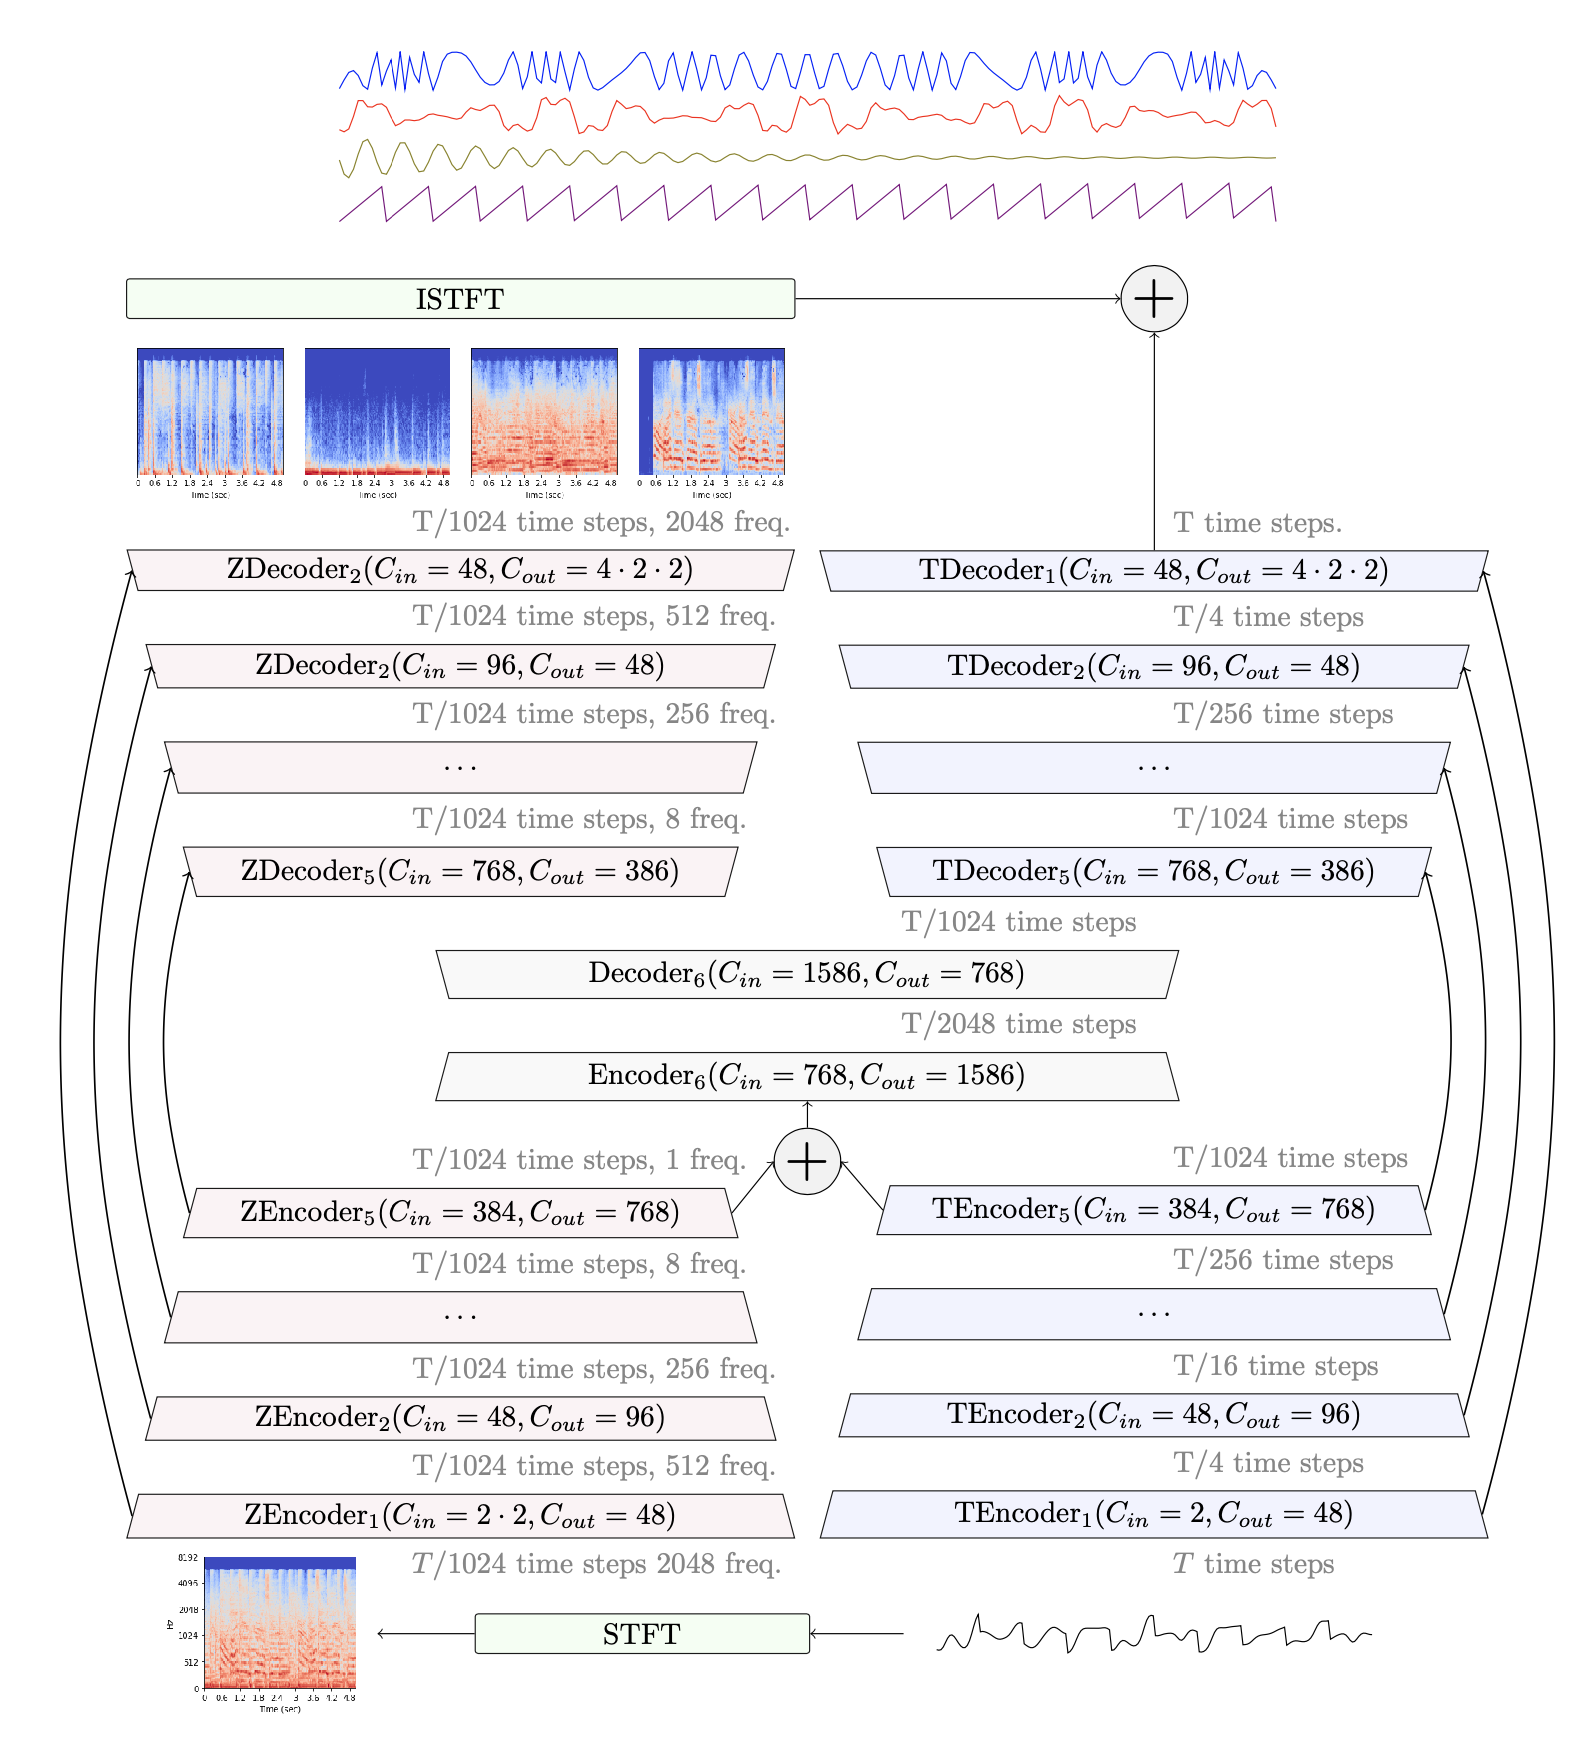
Figure originale: Introduction à la séparation de sources, figure 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Les scores comparatifs de Spleeter et Demucs
Ces scores sur le jeu de test MUSDB18 proviennent du dépôt GitHub officiel de Demucs :
| Modèle | Domaine | Données d'entraînement supplémentaires | SDR global | Qualité MOS |
|---|---|---|---|---|
| Spleeter | Spectrogramme | 25 000 morceaux | 5,9 dB | n/d |
| Demucs v2 | Forme d'onde | Aucune (MUSDB18 uniquement) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Hybride | Aucune (MUSDB18 uniquement) | 7,7 dB | 2,83 |
| HT Demucs fine-tuned v4 | Hybride | 800 morceaux | 9,0 dB | n/d |
Le rapport signal/distorsion (SDR) mesure la propreté avec laquelle un modèle sépare une source du mixage. Plus il est élevé, mieux c'est, mais le SDR ne remplace pas un test d'écoute. Pour savoir à quoi vous attendre en pratique avec les pistes IA, consultez la qualité actuelle de la séparation de pistes IA. L'écart d'environ 3 dB entre Spleeter et Demucs v4 est important dans les comparatifs. Demucs obtient de meilleurs scores pour chaque piste, surtout la batterie et la voix.
Vous pouvez entendre la différence dans la vidéo comparative ci-dessous. Les pistes Demucs sonnent plus naturellement, avec moins d'artefacts, tandis que Spleeter peut produire des résonances métalliques sur des sources complexes.

Conséquences en pratique
Vitesse : Spleeter traite un morceau de 3 minutes en environ 2 secondes sur GPU. Demucs v4 prend environ 20 à 30 secondes. Sur CPU, Spleeter demande environ 30 à 60 secondes, tandis que Demucs peut dépasser 5 minutes.
Matériel : Spleeter fonctionne uniquement sur CPU sur un ordinateur portable doté de 8 Go de RAM. Pour une vitesse raisonnable, Demucs v4 a besoin d'un GPU avec 4 à 8 Go de VRAM. Ses couches Transformer utilisent beaucoup plus de mémoire à cause des matrices d'attention.
Artefacts : comme Spleeter réutilise la phase du mixage, il peut produire des voix « fantomatiques » et des transitoires étalés. Demucs v4 sonne plus naturellement, mais peut laisser un bruit faible dans les passages silencieux.
Robustesse : le défi SDX'23 a montré que les architectures de type Demucs résistent mieux aux données d'entraînement corrompues. L'architecture plus simple de Spleeter ne profite pas facilement de techniques comme les jeux de données filtrés et la troncature de la fonction de coût.
Spleeter ou Demucs : lequel utiliser ?
De nombreux producteurs utilisent les deux selon la tâche.
Quand utiliser Spleeter
Utilisez Spleeter quand la vitesse compte : a cappella rapides pour des sets DJ, pistes de karaoké pour s'entraîner ou traitement par lot d'une bibliothèque entière d'échantillons. Sa vitesse de 100 fois le temps réel et ses besoins matériels modestes sont difficiles à battre. La qualité suffit pour des remixes où vous retravaillerez les pistes.
Quand utiliser Demucs
Choisissez Demucs v4 quand les artefacts sont inacceptables : pistes pour des remixes officiels, échantillons pour des sorties commerciales ou analyse fine d'une interprétation. Le gain de qualité de 3 dB et la cohérence de phase justifient l'attente. Si votre contenu appartient à un genre précis, affinez le modèle avec des données supplémentaires, car l'architecture de Demucs bénéficie davantage de données propres à plus grande échelle.
Combiner Spleeter et Demucs
Exécutez Spleeter sur tout votre catalogue pour repérer les morceaux prometteurs, puis traitez les finalistes avec Demucs. Pour la scène, séparez les pistes à l'avance avec Spleeter. Pour le studio, utilisez Demucs pour obtenir les pistes les plus propres. Des outils comme Ultimate Vocal Remover regroupent Demucs et d'autres modèles de séparation dans une interface graphique simple.
Avez-vous besoin d'un GPU ?
Spleeter fonctionne bien sur CPU, tandis que les traitements Demucs de haute qualité bénéficient vraiment d'un GPU. Pour le traitement par lot hors ligne ou sur un ordinateur portable, les modèles de type Spleeter restent utiles. Pour des pistes plus propres, Demucs et les modèles Transformer hybrides plus récents justifient généralement un traitement dans le cloud ou une machine locale plus puissante.
Mise à jour 2026 : les modèles qui dépassent Spleeter et Demucs
Spleeter et Demucs restent des références utiles, mais ne représentent plus le plafond de qualité de la séparation de pistes.
BS-RoFormer (Band-Split RoPE Transformer) divise le spectrogramme en bandes de fréquences et les modélise avec des couches Transformer. Son article de recherche rapporte 9,80 dB SDR moyen sur MUSDB18-HQ sans données d'entraînement supplémentaires, plus que les 9,0 dB atteints par Demucs v4 affiné avec 800 morceaux supplémentaires. Une version entraînée avec 500 morceaux supplémentaires a remporté la première place de l'épreuve de séparation musicale du Sound Demixing Challenge 2023.
| Modèle | Année | SDR global (MUSDB18) | Données d'entraînement supplémentaires |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25 000 morceaux |
| HT Demucs fine-tuned (v4) | 2022 | 9,0 dB | 800 morceaux |
| BS-RoFormer | 2023 | 9,8 dB | Aucune |
Mel-Band RoFormer est un proche parent qui regroupe les fréquences selon l'échelle mel. Les checkpoints communautaires des deux modèles alimentent désormais la plupart des séparateurs de voix et d'instrumentaux haut de gamme. Notre comparatif des modèles de séparation vocale les classe sur des morceaux réels, et le comparatif des modèles de séparation instrumentale fait de même pour les autres instruments.
Le séparateur de pistes IA de Neural Analog utilise des modèles BS-RoFormer pour ses préréglages à 4 et 6 pistes, et SAM Audio pour extraire un instrument absent de ces préréglages, comme un saxophone ou un synthé solo. Consultez les modèles utilisés par Neural Analog pour séparer les pistes pour la liste complète.
FAQ Spleeter et Demucs
Demucs est-il meilleur que Spleeter ?
Oui, pour la qualité. Demucs v4 obtient un SDR supérieur d'environ 3 dB à celui de Spleeter sur le comparatif MUSDB18, avec moins d'artefacts sur la voix et la batterie. Spleeter n'est préférable que si la vitesse ou une machine uniquement équipée d'un CPU comptent plus que la qualité.
Lequel est meilleur pour la voix, Spleeter ou Demucs ?
Demucs. Les voix Spleeter sonnent souvent minces ou comme « sous l'eau », car Spleeter réutilise la phase du mixage original. Pour les voix et les instrumentaux les plus propres, un modèle BS-RoFormer ou Mel-Band RoFormer dépasse généralement les deux.
Spleeter est-il encore maintenu ?
Spleeter reste disponible sur GitHub, mais c'est un modèle de 2019 fondé sur TensorFlow. Son README signale des problèmes de TensorFlow sur les puces Apple M1. La plupart des outils plus récents sont passés à Demucs ou aux modèles RoFormer.
Que contient Ultimate Vocal Remover (UVR) ?
UVR est une application de bureau gratuite, pas un modèle unique. Elle regroupe plusieurs familles de modèles, dont Demucs, MDX-Net et ses propres modèles VR Architecture. Sa qualité dépend donc du modèle choisi.
Puis-je utiliser Demucs sans GPU ?
Oui, mais c'est lent. Comptez plusieurs minutes par morceau sur CPU. Un séparateur de pistes en ligne exécute plutôt le modèle sur le GPU d'un serveur. Le guide Studio de séparation des pistes décrit les étapes.
Guides associés
- Retirer la batterie d'un morceau Suno : une application pratique de la séparation de la piste de batterie.
- Remplacer une batterie IA par votre propre kit : séparez la batterie, puis construisez un nouveau groove autour de la voix.
- Restaurer des pistes MP3 en qualité WAV : reconstruisez les aigus perdus dans les sources compressées et lors de la séparation.
- Convertir un morceau stéréo en Dolby Atmos : placez les pistes séparées dans un mixage Atmos.
- Installer et exécuter AudioSR depuis GitHub : un autre modèle audio open source à exécuter en local, avec la configuration de Python et PyTorch.