2026 年 Spleeter 与 Demucs 对比:基准与更优模型
Spleeter 与 Demucs 的选择,归根结底是速度与音质的权衡。Demucs 分离出的分轨更干净:微调后的 Demucs v4 为 9.0 dB SDR,而 Spleeter 为 5.9 dB。Spleeter 则快得多,在普通 CPU 上也能轻松运行。到了 2026 年,BS-RoFormer 等较新模型的得分已高于两者。
| Spleeter | Demucs v4(HT Demucs) | |
|---|---|---|
| 开发者 | Deezer,2019 年 | Meta AI Research,2022 年 |
| 工作方式 | 为频谱图生成掩码(U-Net) | 波形与频谱分支,结合 Transformer |
| 质量(MUSDB18 上的 SDR) | 5.9 dB | 9.0 dB(微调后) |
| 速度 | 很快,CPU 上也适用 | 较慢,最好使用 GPU |
| 分轨数量 | 2、4 或 5 | 4,或包含吉他和钢琴的 6 条 |
| 最适合 | 快速预览、卡拉 OK、批量处理 | 用于重混和发行的干净分轨 |
如果您尝试过提取人声,或为重混制作伴奏,很可能已经用过基于其中一个模型的工具。这两个开源模型都成了分轨领域的参照,比较它们仍能说明速度、伪影和音质之间的取舍。
什么是分轨?为什么分离这么难?
分轨是混音歌曲中的各个组成部分,通常包括人声、鼓、贝斯和其他声音。制作人在录音室中处理这些分轨,最后通过混音将其组合在一起。
在混音后再分离,就像试图把烤好的蛋糕拆回原料。乐器共享相同的频率范围,人声谐波会与吉他频率重叠,底鼓瞬态会干扰贝斯音符,镲片的声音则铺满整个立体声声场。传统信号处理方法得到的结果往往声音发颤,并带有大量伪影。
深度学习通过训练神经网络识别传统信号处理遗漏的模式,改善了这一情况。Spleeter 与 Demucs 成为了两种代表性模型,但采用了非常不同的方法。
历史:Spleeter、Demucs 与巴黎的联系
Spleeter:Deezer 的快速频谱掩码方法
2019 年 11 月,法国流媒体服务 Deezer 发布了免费开源工具 Spleeter。Romain Hennequin 领导的团队基于 TensorFlow,使用处理幅度频谱图(音频的时频表征)的 U-Net 卷积神经网络构建了它。
Spleeter 将分离视为类似图像分割的问题。它为每个时频单元预测软掩码,估计该单元中有多少属于人声、鼓、贝斯或其他声音。可选的维纳滤波步骤会优化掩码,再利用原始混音的相位重建分轨。
Spleeter 的优势是速度。它能在几秒内分离一首四分钟的曲目,在 GPU 上达到实时速度的 100 倍,普通 CPU 也能轻松运行。它提供 2 条分轨(人声/伴奏)、4 条分轨和 5 条分轨配置。它成了研究基线,也为无数 YouTube 重混频道提供了支持。
Demucs:Meta 的波形域分离方法
Spleeter 注重速度,而 Meta AI Research(当时名为 Facebook AI Research)注重音质。同样来自法国的 Alexandre Défossez 和他的团队在 2019 年推出了 Demucs,其名称是 Deep Extractor for MUlti-Channel Sources 的缩写,意为多通道声源深度提取器,采用了截然不同的方法。
Demucs 不依赖频谱图,而是直接处理原始波形,将分离视为时域重建问题。其架构结合了受 Wave-U-Net 启发的 U-Net 式卷积编码器与解码器,以及作为瓶颈的双向 LSTM。这让网络能够捕捉长期音乐结构,并保持相位连贯。
Demucs 经历了四个主要版本:
- v1(2019 年):纯波形方法,已经能与频谱方法相抗衡
- v2(2020 年):改进训练方法和运行效率
- v3“Hybrid Demucs”(2021 年):加入频谱分支,以 MUSDB18 上 7.7 dB SDR 的成绩赢得 Music Demixing Challenge
- v4“Hybrid Transformer Demucs”(2022 年):用跨域 Transformer 替换最内层网络层,微调后达到 9.0 dB SDR,论文中的最佳配置最高达到 9.2 dB
Sound Demixing Challenge 与新的起点
Sound Demixing Challenge 2023改变了研究重点。这项由 Meta、Sony 等组织的挑战引入了鲁棒音乐声源分离:使用带有噪声标签和分轨间串音的数据训练模型。Alexandre Défossez 是主要组织者之一,参与了挑战设计和基线模型开发。
主要发现是,更多训练数据并不保证更好的结果。数据质量和鲁棒性策略更加重要。损失截断和迭代优化等技术,让噪声数据上的 SDR 提高了 0.89 dB。
不久后,Défossez 离开 Meta,联合创立了法国 AI 研究实验室 Kyutai。Demucs 仓库仍然在线,但 README 表示他已不再积极维护,因此不要期待新功能。
性能:速度与音质的权衡
架构思路
**Spleeter 对频谱图施加掩码,Demucs 重建波形。**这一核心差异影响着其他各方面。
Spleeter 的频域方法效率很高,因为每个 STFT 帧概括了数千个采样点,卷积只需处理少得多的时间步。代价是模型忽略相位,直接复用混音的相位,而 STFT 固定的时频分辨率无法同时很好地表征尖锐瞬态和稳定音调。
Demucs 的时域方法通过 1D 卷积学习自己的滤波器组。它保留相位,以采样点级精度处理瞬态。在 v4 中,Transformer 层维持跨越数秒音频的上下文,减少了基于帧的方法中常见的“乒乓式”跳变伪影。
Hybrid Demucs v3:波形与频谱分支
编码器与解码器的跳跃连接
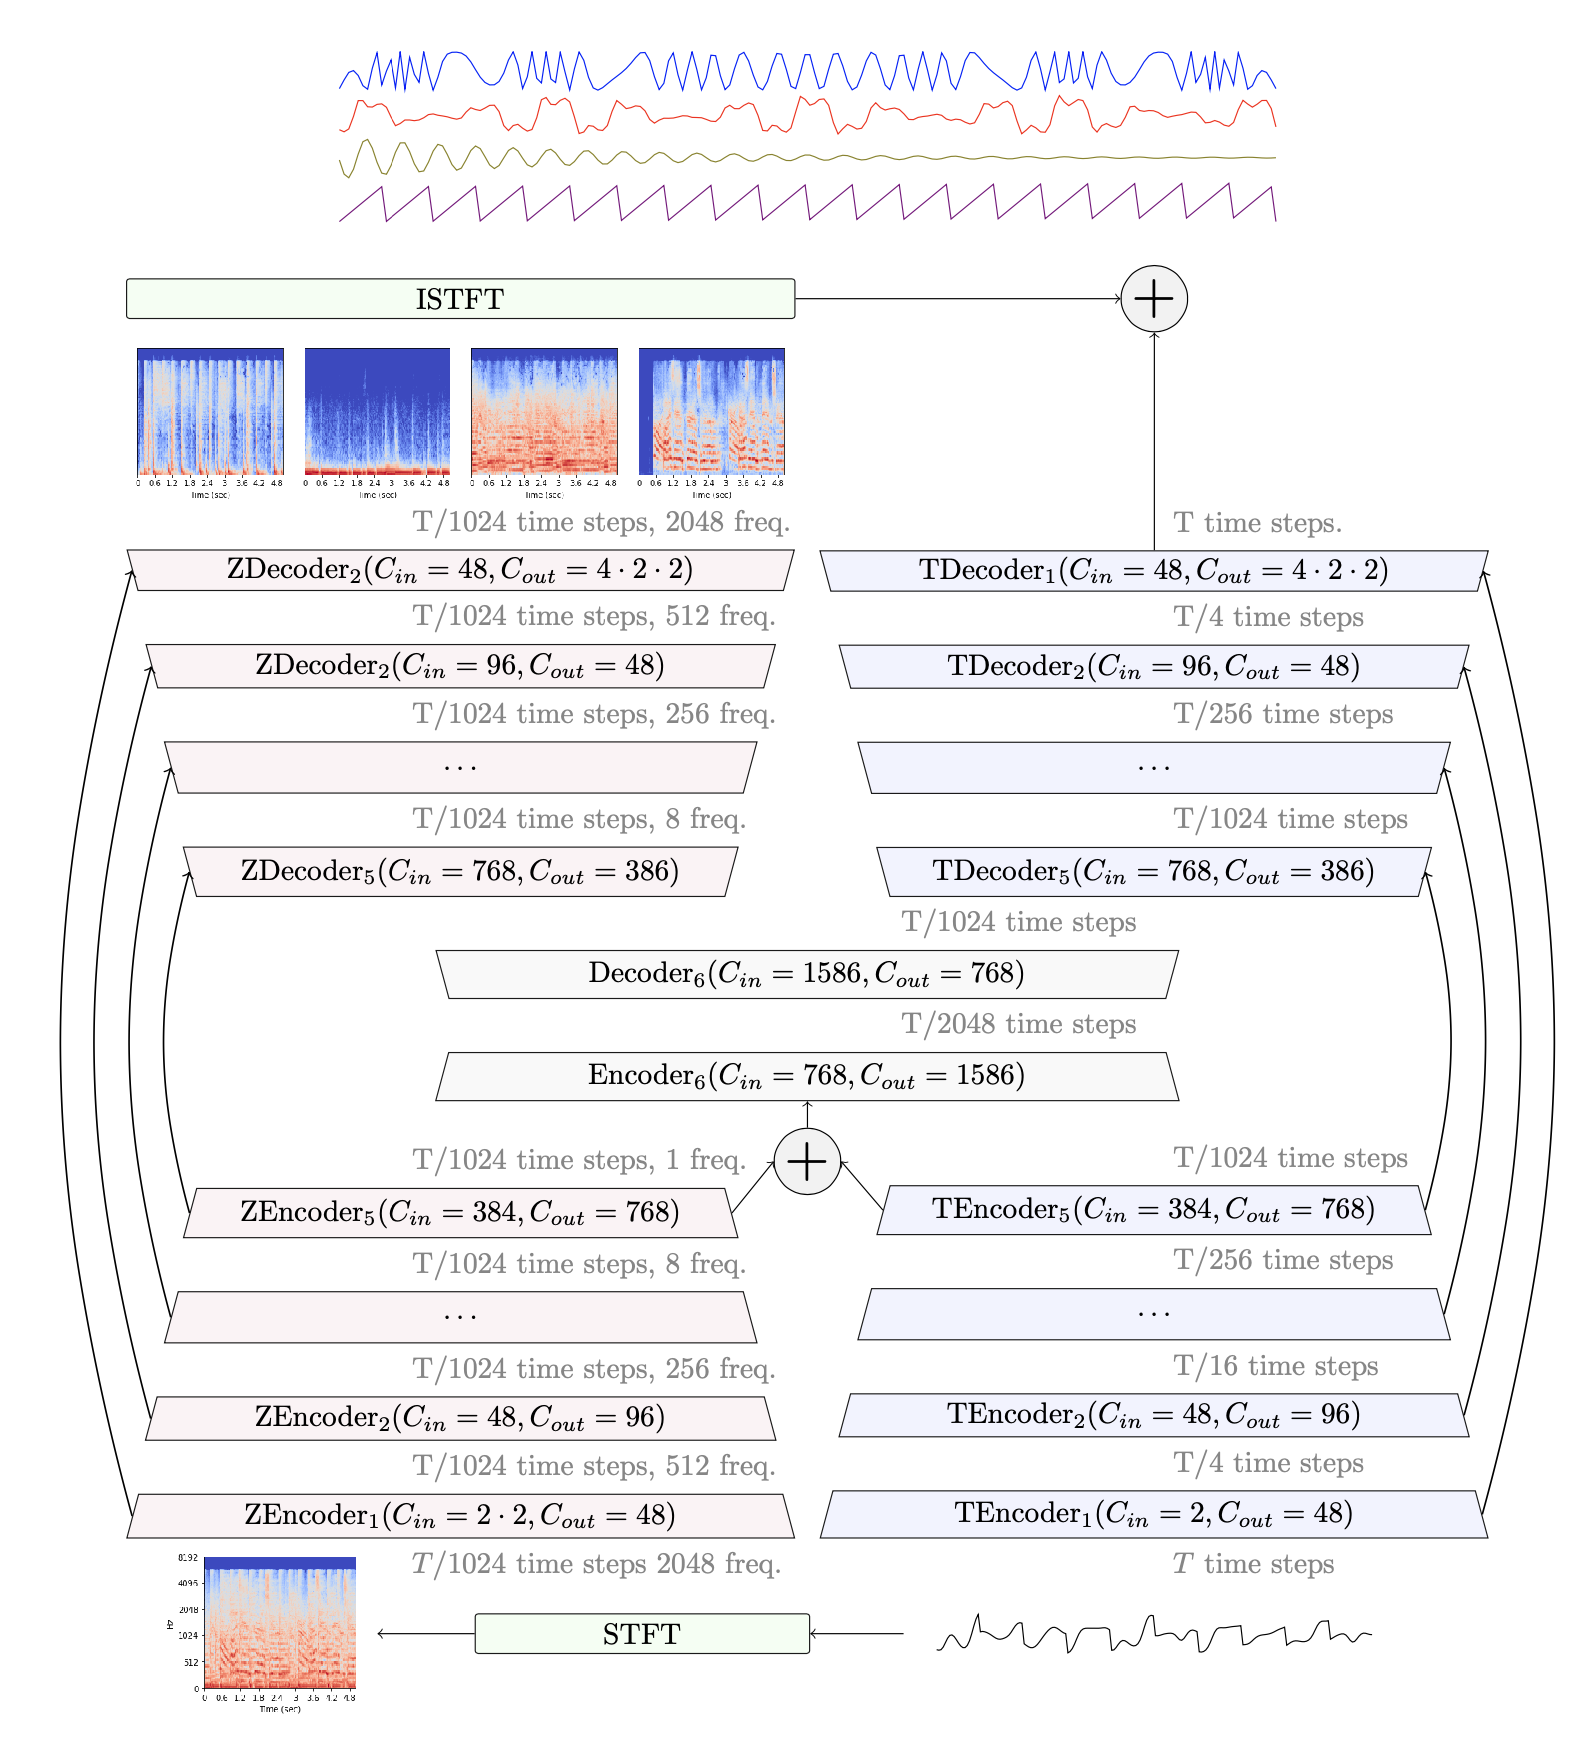
原始图示: 《声源分离入门》,图 2 (Woosung Choi, Alexandre Defossez, Haohe Liu)。
Spleeter 与 Demucs 的基准数据
下列 MUSDB18 测试集得分来自 Demucs 官方 GitHub 仓库:
| 模型 | 处理域 | 额外训练数据 | 总体 SDR | MOS 质量评分 |
|---|---|---|---|---|
| Spleeter | 频谱 | 25,000 首歌曲 | 5.9 dB | 无数据 |
| Demucs v2 | 波形 | 无(仅 MUSDB18) | 6.3 dB | 2.37 |
| Hybrid Demucs v3 | 混合 | 无(仅 MUSDB18) | 7.7 dB | 2.83 |
| HT Demucs 微调版 v4 | 混合 | 800 首歌曲 | 9.0 dB | 无数据 |
**信号失真比(SDR)**衡量模型将一个声源从混音中分离得有多干净。越高越好,但 SDR 不能代替试听。关于 AI 分轨在实际使用中的表现,请参阅如今 AI 分轨的质量如何。Spleeter 与 Demucs v4 之间约 3 dB 的差距在基准测试中相当显著,Demucs 在每种分轨上的得分都更高,尤其是鼓和人声。
您可以在下方对比视频中听出差别。Demucs 分轨听起来更自然,伪影更少;Spleeter 在复杂素材上可能产生金属般的振铃声。

实际使用中的性能影响
**速度:**Spleeter 在 GPU 上处理一首 3 分钟曲目约需 2 秒,Demucs v4 约需 20 至 30 秒。在 CPU 上,Spleeter 约需 30 至 60 秒,Demucs 则可能超过 5 分钟。
**硬件:**Spleeter 可以仅使用 CPU,在配备 8GB 内存的笔记本电脑上运行。Demucs v4 若要获得合理速度,需要显存为 4 至 8GB 的 GPU;由于注意力矩阵,其 Transformer 层占用的内存更多。
**伪影:**由于 Spleeter 复用混音的相位,可能产生若隐若现的“幽灵般”人声和被抹开的瞬态。Demucs v4 更自然,但可能在静音片段中留下低电平噪声。
**鲁棒性:**SDX'23 挑战表明,Demucs 式架构更能应对受污染的训练数据。Spleeter 的架构更简单,难以充分利用经过筛选的数据集和损失截断等技术。
该选 Spleeter 还是 Demucs?
许多制作人会根据任务搭配使用两者。
什么时候使用 Spleeter
当速度重要时,使用 Spleeter:为 DJ 演出快速制作纯人声、制作练习用卡拉 OK 伴奏,或批量处理整套采样库。它达到实时速度 100 倍,硬件要求也不高,这些优势难以超越;如果之后还会进一步处理分轨,音质也足以用于重混。
什么时候使用 Demucs
当无法接受伪影时,选择 Demucs v4:例如官方重混的分轨、商业发行的采样,或对演奏进行细致分析。约 3 dB 的 SDR 提升和相位连贯性值得等待。若素材属于特定音乐风格,请用额外数据微调,因为 Demucs 的架构能更好地从更多干净数据中获益。
搭配使用 Spleeter 与 Demucs
先用 Spleeter 处理整个曲库,找出有潜力的曲目,再用 Demucs 处理最终入选的曲目。现场演出可先用 Spleeter 预先分离;录音室工作则用 Demucs 获得最干净的分轨。Ultimate Vocal Remover 等工具将 Demucs 和其他分离模型整合在简洁的图形界面中。
需要 GPU 吗?
Spleeter 在 CPU 上就能很好地运行,而运行高质量 Demucs 处理流程时,推荐使用 GPU 以获得更实用的处理速度。对于离线或适合笔记本的批量处理,Spleeter 式模型仍然有用。若想获得更干净的分轨,Demucs 和较新的混合 Transformer 模型通常值得使用云端处理或更强大的本地设备。
2026 年更新:哪些模型超越了 Spleeter 和 Demucs
Spleeter 和 Demucs 仍然是有用的参照,但已经不再代表分轨质量的上限。
BS-RoFormer(Band-Split RoPE Transformer,频带分割 RoPE Transformer)将频谱图拆分成频带,再用 Transformer 层建模。其论文报告,在不使用额外训练数据的情况下,MUSDB18-HQ 上的平均 SDR 达到 9.80 dB,高于 Demucs v4 使用 800 首额外歌曲微调后得到的 9.0 dB。使用 500 首额外歌曲训练的版本,获得了 Sound Demixing Challenge 2023 音乐分离赛道第一名。
| 模型 | 年份 | 总体 SDR(MUSDB18) | 额外训练数据 |
|---|---|---|---|
| Spleeter | 2019 | 5.9 dB | 25,000 首歌曲 |
| HT Demucs 微调版(v4) | 2022 | 9.0 dB | 800 首歌曲 |
| BS-RoFormer | 2023 | 9.8 dB | 无 |
Mel-Band RoFormer 是一种密切相关的模型,按梅尔尺度对频率进行分组。这两种模型的社区权重如今为大多数高端人声与伴奏分离工具提供支持。我们的人声分离模型对比在真实曲目上为它们排名,乐器分离模型对比则对其他乐器进行同样的比较。
Neural Analog 的 AI 分轨工具在 4 条分轨和 6 条分轨预设中使用 BS-RoFormer 模型;如果要提取预设未涵盖的乐器,例如萨克斯或主奏合成器,则使用 SAM Audio。完整列表请参阅 Neural Analog 分轨使用哪些模型。
Spleeter 与 Demucs 常见问题
Demucs 比 Spleeter 更好吗?
如果看音质,是的。Demucs v4 在 MUSDB18 基准上的 SDR 比 Spleeter 高约 3 dB,人声和鼓的伪影也更少。只有当速度或仅使用 CPU 的设备比音质更重要时,Spleeter 才更合适。
分离人声,Spleeter 和 Demucs 哪个更好?
Demucs。Spleeter 复用原始混音的相位,因此人声常常显得单薄,或带有“水波般”的伪影。若追求最干净的人声与伴奏,BS-RoFormer 或 Mel-Band RoFormer 模型通常优于两者。
Spleeter 仍在维护吗?
Spleeter 仍可从 GitHub 获取,但它是基于 TensorFlow 的 2019 年模型,README 也警告了 Apple M1 芯片上的 TensorFlow 问题。大多数较新的工具已经转向 Demucs 或 RoFormer 模型。
Ultimate Vocal Remover(UVR)使用什么模型?
UVR 是免费桌面应用,而非单一模型。它整合了多个模型家族,包括 Demucs、MDX-Net 和自身的 VR Architecture 模型,因此音质取决于您选择哪个模型。
没有 GPU 也能使用 Demucs 吗?
可以,但速度慢。CPU 上每首歌曲预计需要几分钟。在线分轨工具改用服务器 GPU 运行模型。Studio 分轨指南介绍了操作步骤。
相关指南
- 去除 Suno 歌曲中的鼓声:鼓分轨分离的一种实际用途。
- 用自己的鼓组替换 AI 鼓声:先分离鼓声,再围绕人声制作新的律动。
- 将 MP3 分轨修复至 WAV 音质:重建压缩音源和分离过程中损失的高频。
- 将立体声歌曲转换为 Dolby Atmos:把分离后的分轨放入 Atmos 混音。
- 从 GitHub 安装并运行 AudioSR:另一种可在本地运行的开源音频模型,包含 Python 与 PyTorch 配置说明。