Spleeter vs Demucs nel 2026: risultati e modelli che superano entrambi
La scelta tra Spleeter e Demucs si riduce a velocità contro qualità. Demucs separa gli stem in modo più pulito (9,0 dB SDR per Demucs v4 con affinamento contro 5,9 dB di Spleeter), mentre Spleeter è molto più veloce e funziona bene su una CPU modesta. Nel 2026, modelli più recenti come BS-RoFormer ottengono risultati migliori di entrambi.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Sviluppato da | Deezer, 2019 | Meta AI Research, 2022 |
| Come funziona | Applica maschere a uno spettrogramma (U-Net) | Rami di forma d'onda e spettrogramma con un Transformer |
| Qualità (SDR su MUSDB18) | 5,9 dB | 9,0 dB (con affinamento) |
| Velocità | Molto veloce, funziona bene su CPU | Più lento, meglio con una GPU |
| Stem | 2, 4 o 5 | 4, oppure 6 con chitarra e pianoforte |
| Ideale per | Anteprime rapide, karaoke, elaborazioni in batch | Stem puliti per remix e pubblicazioni |
Se hai provato a estrarre la voce o creare una base strumentale per un remix, probabilmente hai usato uno strumento basato su uno dei due. Entrambi i modelli open source sono diventati riferimenti per la separazione di stem, e confrontarli mostra ancora i compromessi tra velocità, artefatti e qualità.
Cosa sono gli stem e perché è così difficile separarli?
Gli stem sono i singoli componenti di un brano mixato, solitamente voce, batteria, basso e tutto il resto. I produttori ci lavorano in studio prima che il mix finale riunisca tutto.
Separarli dopo il mix è come cercare di disfare una torta già cotta. Gli strumenti condividono le stesse gamme di frequenza. Le armoniche della voce si sovrappongono alle frequenze della chitarra. I transienti della cassa si sovrappongono alle note del basso. I colpi dei piatti si diffondono nell'intero campo stereo. L'elaborazione tradizionale dei segnali lasciava risultati oscillanti e pieni di artefatti.
Il deep learning ha migliorato questo aspetto addestrando reti neurali a riconoscere schemi che l'elaborazione classica dei segnali non rilevava. Spleeter e Demucs sono diventati i due modelli di riferimento, con approcci molto diversi.
Storia: Spleeter, Demucs e il legame con Parigi
Spleeter: mascheramento rapido degli spettrogrammi di Deezer
Nel novembre 2019, il servizio di streaming francese Deezer ha pubblicato Spleeter come strumento gratuito e open source. Il team guidato da Romain Hennequin lo ha costruito su TensorFlow attorno a una rete neurale convoluzionale U-Net che lavora su spettrogrammi di magnitudine, rappresentazioni tempo-frequenza dell'audio.
Spleeter tratta la separazione come segmentazione delle immagini. Prevede una maschera morbida per ogni cella tempo-frequenza, stimando quanta parte appartenga a voce, batteria, basso o altro. Un passaggio opzionale di filtraggio di Wiener affina le maschere, e gli stem vengono ricostruiti usando la fase del mix originale.
La forza di Spleeter è la velocità. Separa un brano di quattro minuti in pochi secondi, raggiungendo 100 volte la velocità del tempo reale su GPU, e funziona bene su CPU modeste. Offre configurazioni a 2 stem (voce/accompagnamento), 4 stem e 5 stem. È diventato un riferimento per la ricerca e ha alimentato innumerevoli canali YouTube di remix.
Demucs: separazione nel dominio della forma d'onda di Meta
Mentre Spleeter puntava sulla velocità, Meta AI Research, allora Facebook AI Research, puntava sulla qualità. Alexandre Défossez, anch'egli francese, e il suo team hanno presentato Demucs nel 2019, abbreviazione di Deep Extractor for MUlti-Channel Sources, con un approccio molto diverso.
Invece degli spettrogrammi, Demucs lavora direttamente sulle forme d'onda grezze e tratta la separazione come un problema di ricostruzione nel dominio temporale. La sua architettura combina un encoder-decoder convoluzionale di tipo U-Net, ispirato a Wave-U-Net, con un collo di bottiglia LSTM bidirezionale. Questo permette alla rete di cogliere la struttura musicale a lungo termine e mantenere la coerenza di fase.
Demucs si è evoluto attraverso quattro versioni principali:
- v1 (2019): approccio basato solo sulla forma d'onda, già competitivo con i metodi a spettrogramma
- v2 (2020): addestramento affinato e miglioramenti di efficienza
- v3 «Hybrid Demucs» (2021): aggiunta di un ramo dello spettrogramma, vincendo il Music Demixing Challenge con 7,7 dB SDR su MUSDB18
- v4 «Hybrid Transformer Demucs» (2022): sostituzione degli strati più interni con un Transformer tra domini, raggiungendo 9,0 dB SDR con affinamento e fino a 9,2 dB nella migliore configurazione del paper
Il Sound Demixing Challenge e un nuovo inizio
Il Sound Demixing Challenge 2023 ha spostato l'attenzione. Organizzato da Meta, Sony e altri, ha introdotto la separazione robusta delle sorgenti musicali: addestrare modelli su dati con etichette rumorose e contaminazioni tra stem. Alexandre Défossez è stato un organizzatore importante e ha contribuito alla progettazione della sfida e ai modelli di riferimento.
Il risultato principale è che più dati di addestramento non garantiscono risultati migliori. La qualità dei dati e le strategie di robustezza contano di più. Tecniche come il troncamento della funzione di perdita e l'affinamento iterativo hanno migliorato l'SDR di 0,89 dB su dati rumorosi.
Poco dopo, Défossez ha lasciato Meta per cofondare Kyutai, un laboratorio francese di ricerca sull'IA. Il repository Demucs è ancora online, ma il README indica che non ci lavora più attivamente, quindi non aspettarti nuove funzioni.
Prestazioni: compromessi tra velocità e qualità
Filosofia delle architetture
Spleeter maschera gli spettrogrammi. Demucs ricostruisce le forme d'onda. Questa differenza centrale determina tutto il resto.
L'approccio di Spleeter nel dominio della frequenza è efficiente perché ogni frame STFT riassume migliaia di campioni, quindi le convoluzioni operano su molti meno passi temporali. Il costo: il modello ignora la fase e riutilizza quella del mix. Inoltre, la risoluzione tempo-frequenza fissa della STFT non rappresenta bene allo stesso tempo transienti netti e toni stabili.
Il metodo temporale di Demucs impara i propri banchi di filtri tramite convoluzioni 1D. Conserva la fase e tratta i transienti con accuratezza a livello di campione. In v4, gli strati Transformer mantengono il contesto su diversi secondi di audio, riducendo gli artefatti di «ping-pong» comuni nei metodi basati su frame.
Hybrid Demucs v3: rami della forma d'onda e dello spettrogramma
Connessioni di salto tra encoder e decoder
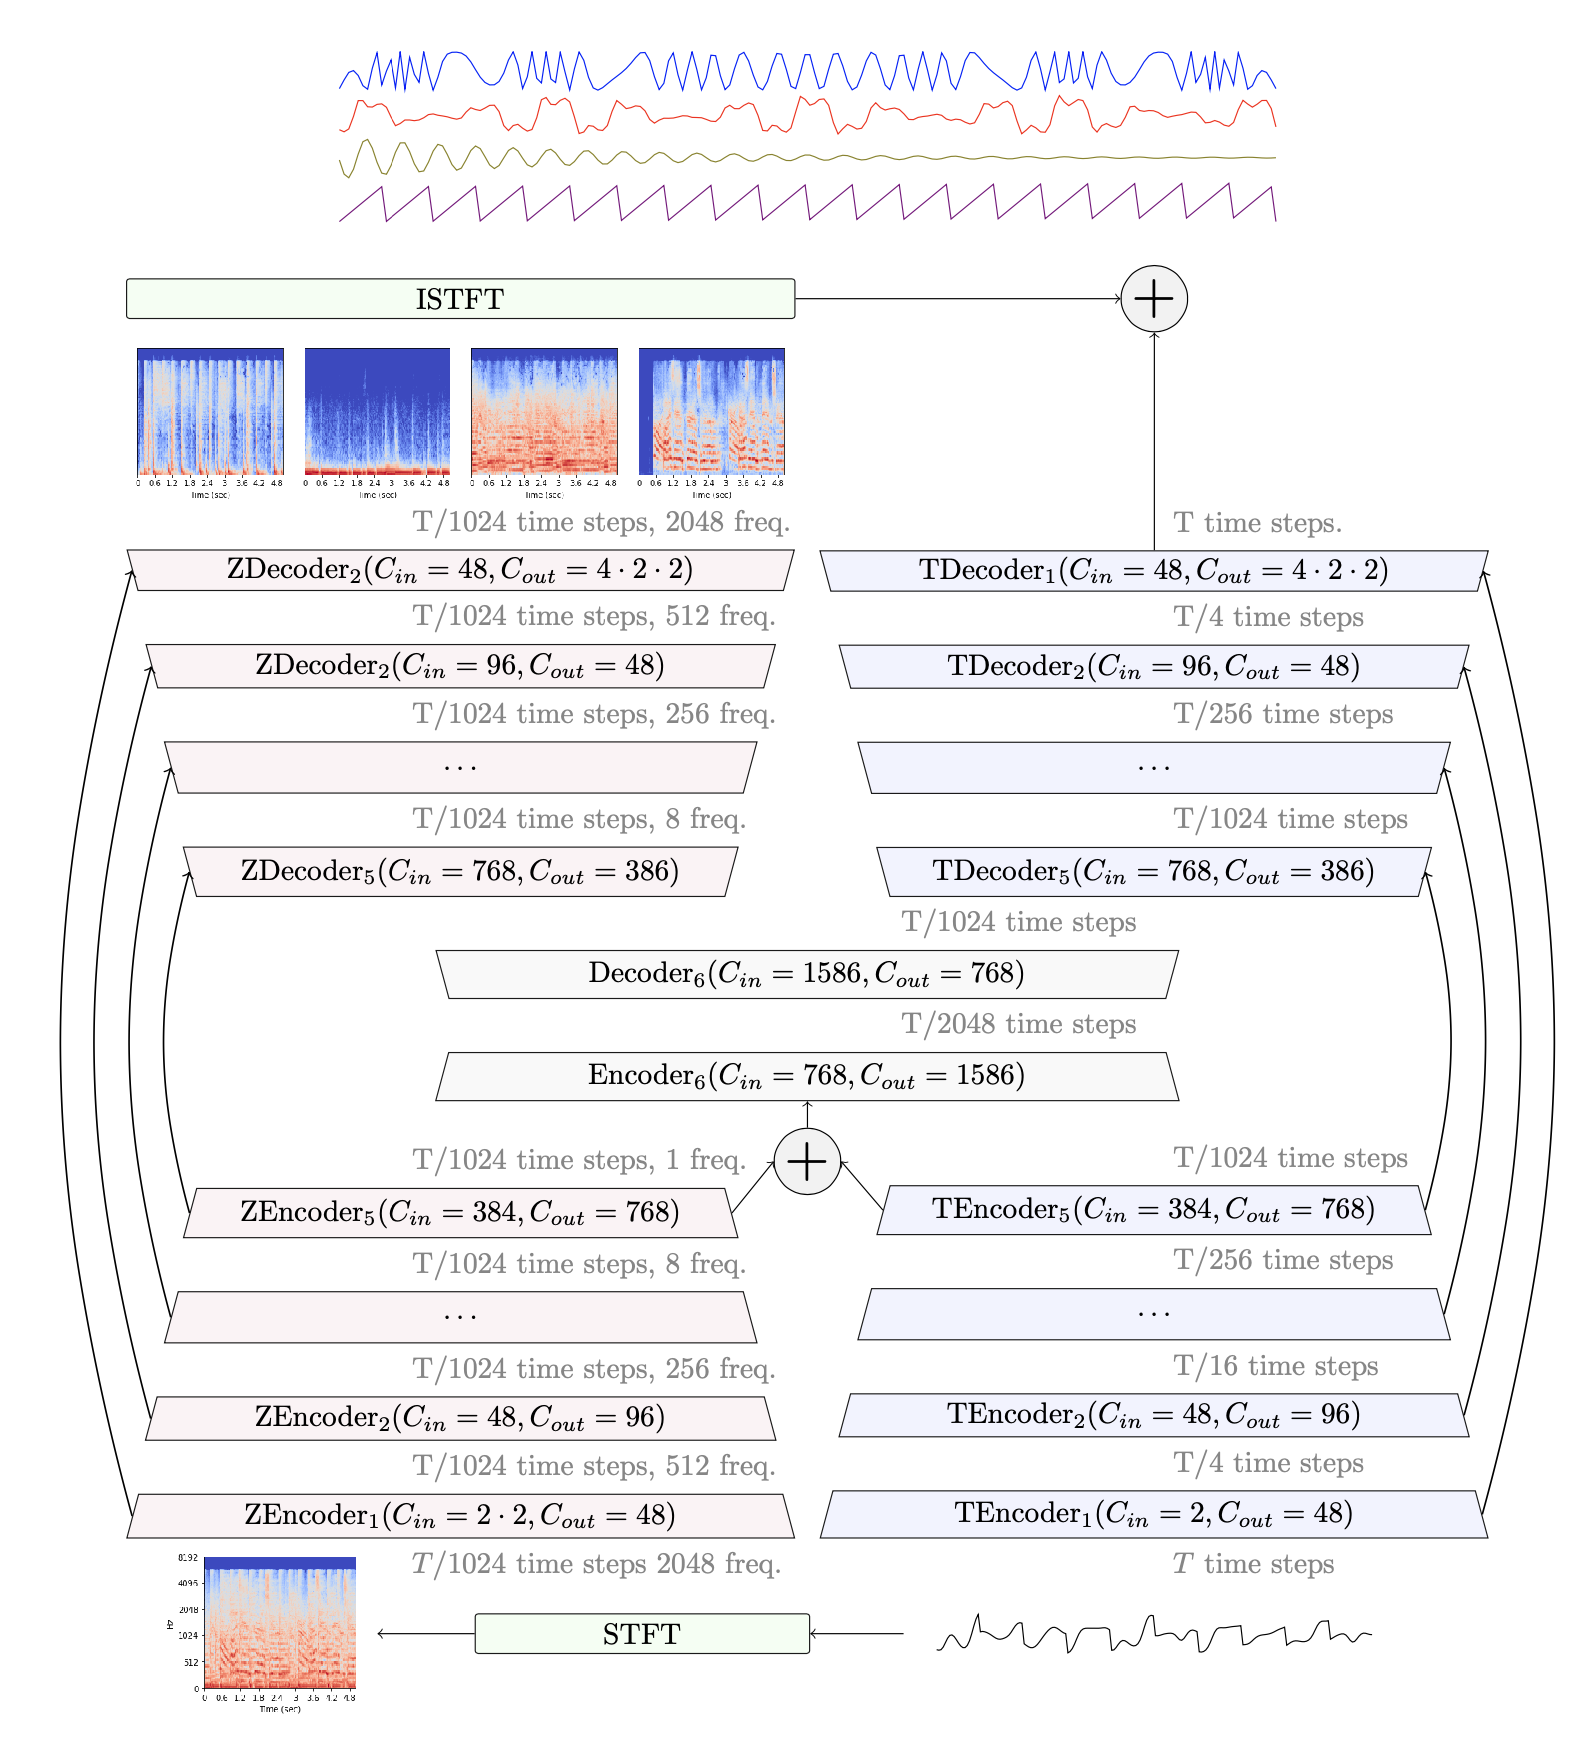
Figura originale: Introduzione alla separazione delle sorgenti, figura 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Risultati comparativi di Spleeter e Demucs
Questi punteggi sul set di test MUSDB18 provengono dal repository GitHub ufficiale di Demucs:
| Modello | Dominio | Dati di addestramento aggiuntivi | SDR complessivo | Qualità MOS |
|---|---|---|---|---|
| Spleeter | Spettrogramma | 25.000 brani | 5,9 dB | n/d |
| Demucs v2 | Forma d'onda | Nessuno (solo MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Ibrido | Nessuno (solo MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs fine-tuned v4 | Ibrido | 800 brani | 9,0 dB | n/d |
Il rapporto segnale-distorsione (SDR) misura quanto pulitamente un modello separa una sorgente dal mix. Più è alto, meglio è, ma l'SDR non sostituisce un test d'ascolto. Per sapere cosa aspettarti dagli stem IA nella pratica, consulta la qualità attuale della separazione di stem con IA. Il divario di circa 3 dB tra Spleeter e Demucs v4 è ampio nei benchmark, e Demucs ottiene risultati migliori su ogni stem, soprattutto batteria e voce.
Puoi sentire la differenza nel video comparativo qui sotto. Gli stem di Demucs suonano più naturali e hanno meno artefatti, mentre Spleeter può produrre risonanze metalliche su materiale complesso.

Conseguenze pratiche
Velocità: Spleeter elabora un brano di 3 minuti in circa 2 secondi su GPU. Demucs v4 impiega tra 20 e 30 secondi circa. Su CPU, Spleeter impiega tra 30 e 60 secondi circa, mentre Demucs può superare i 5 minuti.
Hardware: Spleeter funziona solo su CPU in un portatile con 8 GB di RAM. Demucs v4 richiede una GPU con una VRAM compresa tra 4 e 8 GB per una velocità ragionevole, e i suoi strati Transformer usano molta più memoria per le matrici di attenzione.
Artefatti: poiché Spleeter riutilizza la fase del mix, può produrre voci «spettrali» e transienti sfumati. Demucs v4 suona più naturale, ma può lasciare rumore di basso livello nei passaggi silenziosi.
Robustezza: la sfida SDX'23 ha mostrato che le architetture di tipo Demucs gestiscono meglio i dati di addestramento corrotti. L'architettura più semplice di Spleeter non sfrutta facilmente tecniche come dataset filtrati e troncamento della funzione di perdita.
Spleeter o Demucs: quale dovresti usare?
Molti produttori usano entrambi, a seconda del lavoro.
Quando usare Spleeter
Usa Spleeter quando la velocità conta: a cappella rapidi per DJ set, tracce karaoke per esercitarti o elaborazione in batch di un'intera libreria di campioni. La velocità di 100 volte il tempo reale e i requisiti hardware modesti sono difficili da battere. La qualità basta per remix in cui elaborerai ulteriormente gli stem.
Quando usare Demucs
Scegli Demucs v4 quando gli artefatti sono inaccettabili: stem per remix ufficiali, campioni per pubblicazioni commerciali o analisi ravvicinata di un'esecuzione. Il miglioramento di qualità di 3 dB e la coerenza di fase giustificano l'attesa. Se hai materiale di un genere specifico, affina il modello con dati aggiuntivi, perché l'architettura di Demucs scala meglio con dati puliti.
Combinare Spleeter e Demucs
Esegui Spleeter sull'intero catalogo per trovare brani promettenti, poi elabora i finalisti con Demucs. Per le esibizioni dal vivo, separa in anticipo con Spleeter. Per il lavoro in studio, usa Demucs per gli stem più puliti. Strumenti come Ultimate Vocal Remover riuniscono Demucs e altri modelli di separazione in un'interfaccia grafica semplice.
Serve una GPU?
Spleeter funziona bene su CPU, mentre i processi Demucs di alta qualità beneficiano davvero di una GPU. Per l'elaborazione in batch offline o adatta a un portatile, i modelli di tipo Spleeter restano utili. Per stem più puliti, Demucs e i modelli Transformer ibridi più recenti giustificano solitamente l'elaborazione nel cloud o una macchina locale più potente.
Aggiornamento 2026: modelli che superano Spleeter e Demucs
Spleeter e Demucs restano riferimenti utili, ma non rappresentano più il limite di qualità della separazione di stem.
BS-RoFormer (Band-Split RoPE Transformer) divide lo spettrogramma in bande di frequenza e le modella con strati Transformer. Il suo paper riporta 9,80 dB di SDR medio su MUSDB18-HQ senza dati di addestramento aggiuntivi, più dei 9,0 dB raggiunti da Demucs v4 affinato con 800 brani aggiuntivi. Una versione addestrata con 500 brani aggiuntivi ha vinto il primo posto nella categoria di separazione musicale del Sound Demixing Challenge 2023.
| Modello | Anno | SDR complessivo (MUSDB18) | Dati di addestramento aggiuntivi |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25.000 brani |
| HT Demucs fine-tuned (v4) | 2022 | 9,0 dB | 800 brani |
| BS-RoFormer | 2023 | 9,8 dB | Nessuno |
Mel-Band RoFormer è un parente stretto che raggruppa le frequenze sulla scala mel. I checkpoint della community di entrambi i modelli alimentano oggi la maggior parte dei separatori di voce e basi strumentali di fascia alta. Il nostro confronto dei modelli di separazione vocale li classifica su brani reali, e il confronto dei modelli di separazione strumentale fa lo stesso per altri strumenti.
Il separatore di stem IA di Neural Analog usa modelli BS-RoFormer per i preset a 4 e 6 stem, e SAM Audio quando vuoi estrarre uno strumento non coperto dai preset, come un sassofono o un sintetizzatore solista. Consulta quali modelli usa Neural Analog per separare gli stem per l'elenco completo.
Domande frequenti su Spleeter e Demucs
Demucs è migliore di Spleeter?
Sì, per la qualità. Demucs v4 ottiene un SDR circa 3 dB più alto di Spleeter su MUSDB18 e ha meno artefatti su voce e batteria. Spleeter è migliore solo quando la velocità o una macchina senza GPU contano più della qualità.
Qual è migliore per la voce, Spleeter o Demucs?
Demucs. Le voci di Spleeter suonano spesso sottili o come se fossero «sott'acqua» perché Spleeter riutilizza la fase del mix originale. Per voce e basi strumentali più pulite, un modello BS-RoFormer o Mel-Band RoFormer supera solitamente entrambi.
Spleeter riceve ancora manutenzione?
Spleeter è ancora disponibile su GitHub, ma è un modello del 2019 basato su TensorFlow, e il README avverte di problemi di TensorFlow sui chip Apple M1. La maggior parte degli strumenti più recenti è passata a Demucs o ai modelli RoFormer.
Cosa usa Ultimate Vocal Remover (UVR)?
UVR è un'applicazione desktop gratuita, non un singolo modello. Riunisce diverse famiglie di modelli, tra cui Demucs, MDX-Net e i propri modelli VR Architecture, quindi la qualità dipende dal modello scelto.
Posso usare Demucs senza GPU?
Sì, ma è lento. Aspettati diversi minuti per brano su CPU. Un separatore di stem online esegue invece il modello sulla GPU di un server. La guida di Studio alla separazione degli stem mostra i passaggi.
Guide correlate
- Rimuovere la batteria da una canzone di Suno: un uso pratico della separazione dello stem di batteria.
- Sostituire la batteria IA con il tuo kit: separa la batteria, poi crea un nuovo groove intorno alla voce.
- Restaurare stem MP3 alla qualità WAV: ricostruisci gli acuti persi dalle sorgenti compresse e dalla separazione.
- Convertire un brano stereo in Dolby Atmos: posiziona gli stem separati in un mix Atmos.
- Installare ed eseguire AudioSR da GitHub: un altro modello audio open source da eseguire in locale, con configurazione di Python e PyTorch.