2026년 Spleeter와 Demucs 비교: 벤치마크와 더 나은 모델
Spleeter와 Demucs의 선택은 결국 속도와 음질의 균형입니다. Demucs는 스템을 더 깨끗하게 분리합니다. 미세 조정한 Demucs v4의 SDR은 9.0 dB이며 Spleeter는 5.9 dB입니다. 반면 Spleeter는 훨씬 빠르고 보급형 CPU에서도 원활하게 실행됩니다. 2026년에는 BS-RoFormer 같은 더 새로운 모델이 둘보다 높은 점수를 기록합니다.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| 개발 주체 | Deezer, 2019 | Meta AI Research, 2022 |
| 작동 방식 | 스펙트로그램 마스킹(U-Net) | Transformer를 사용하는 파형 및 스펙트로그램 분기 |
| 품질(MUSDB18의 SDR) | 5.9 dB | 9.0 dB (미세 조정) |
| 속도 | 매우 빠르며 CPU로도 충분 | 더 느리고 GPU 사용이 유리 |
| 스템 | 2, 4 또는 5 | 4, 또는 기타와 피아노를 포함한 6 |
| 적합한 용도 | 빠른 미리 듣기, 노래방, 일괄 처리 | 리믹스와 발매를 위한 깨끗한 스템 |
보컬을 추출하거나 리믹스용 반주를 만들어 본 적이 있다면 둘 중 하나를 기반으로 한 도구를 사용했을 가능성이 높습니다. 두 오픈 소스 모델은 스템 분리의 기준점이 되었으며, 지금도 비교해 보면 속도, 아티팩트, 음질 사이의 절충을 이해할 수 있습니다.
스템이란 무엇이며 분리는 왜 어려울까요?
스템은 믹스된 곡의 개별 구성 요소로, 보통 보컬, 드럼, 베이스와 나머지 소리입니다. 프로듀서는 스튜디오에서 이들을 따로 다룬 뒤 최종 믹스에서 하나로 합칩니다.
믹스 후에 분리하는 것은 구운 케이크를 다시 재료로 되돌리려는 것과 같습니다. 악기들은 같은 주파수 대역을 공유합니다. 보컬의 배음은 기타 주파수와 겹치고, 킥 드럼 트랜지언트는 베이스 음을 가리며, 심벌 크래시는 스테레오 음장 전체에 퍼집니다. 기존 신호 처리 방식은 소리가 흔들리고 아티팩트가 많이 남는 결과를 냈습니다.
딥 러닝은 전통적인 신호 처리가 놓친 패턴을 신경망이 알아보도록 학습하면서 이를 개선했습니다. Spleeter와 Demucs는 두 대표 모델이 되었지만 접근 방식은 매우 다릅니다.
역사: Spleeter, Demucs와 파리의 연결
Spleeter: Deezer의 빠른 스펙트로그램 마스킹
2019년 11월, 프랑스 스트리밍 서비스 Deezer는 Spleeter를 무료 오픈 소스 도구로 공개했습니다. Romain Hennequin이 이끄는 팀은 오디오의 시간과 주파수 표현인 크기 스펙트로그램을 처리하는 U-Net 합성곱 신경망을 중심으로 TensorFlow에서 구축했습니다.
Spleeter는 분리를 이미지 분할처럼 다룹니다. 시간과 주파수의 각 구간에 대해 소프트 마스크를 예측하여 해당 성분 중 보컬, 드럼, 베이스 또는 나머지에 속하는 비율을 추정합니다. 선택적인 위너 필터링 단계에서 마스크를 개선하고 원래 믹스의 위상을 사용해 스템을 재구성합니다.
Spleeter의 강점은 속도입니다. 4분 곡을 몇 초 만에 분리하며 GPU에서는 실시간의 100배 속도에 도달합니다. 보급형 CPU에서도 원활하게 실행됩니다. 2스템(보컬/반주), 4스템, 5스템 구성을 제공하며, 연구의 기준 모델이자 수많은 YouTube 리믹스 채널의 기반이 되었습니다.
Demucs: Meta의 파형 영역 분리
Spleeter가 속도에 집중할 때 Meta AI Research(당시 Facebook AI Research)는 음질에 집중했습니다. 역시 프랑스 출신인 Alexandre Défossez와 연구진은 2019년 완전히 다른 접근의 Demucs를 발표했습니다. 이름은 Deep Extractor for MUlti-Channel Sources의 약자로, 다중 채널 음원의 심층 추출기를 뜻합니다.
Demucs는 스펙트로그램 대신 원시 파형을 직접 처리하며 분리를 시간 영역 재구성 문제로 다룹니다. Wave-U-Net에서 착안한 U-Net형 합성곱 인코더와 디코더에 양방향 LSTM 병목을 결합합니다. 이를 통해 장기적인 음악 구조를 포착하고 위상 일관성을 유지할 수 있습니다.
Demucs는 네 주요 버전을 거쳤습니다.
- v1 (2019): 순수 파형 방식으로 이미 스펙트로그램 방식과 경쟁했습니다
- v2 (2020): 학습을 정교하게 다듬고 효율을 높였습니다
- v3 "Hybrid Demucs" (2021): 스펙트로그램 분기를 추가하여 MUSDB18에서 SDR 7.7 dB로 Music Demixing Challenge에서 우승했습니다
- v4 "Hybrid Transformer Demucs" (2022): 가장 안쪽 레이어를 교차 영역 Transformer로 바꾸어 미세 조정 시 SDR 9.0 dB, 논문의 최상 구성에서 최대 9.2 dB를 기록했습니다
Sound Demixing Challenge와 새로운 시작
Sound Demixing Challenge 2023은 연구의 초점을 바꾸었습니다. Meta, Sony 등이 개최한 이 대회는 강건한 음악 음원 분리를 도입했습니다. 부정확한 레이블과 스템 간 누출이 있는 데이터로 모델을 학습하는 방식입니다. Alexandre Défossez는 핵심 운영진으로 대회 설계와 기준 모델에 기여했습니다.
핵심 결과는 학습 데이터가 많다고 더 좋은 결과가 보장되지는 않는다는 것이었습니다. 데이터 품질과 강건성 전략이 더 중요합니다. 손실 절단과 반복 개선 같은 기법은 노이즈가 있는 데이터에서 SDR을 0.89 dB 높였습니다.
얼마 뒤 Défossez는 Meta를 떠나 프랑스 AI 연구소 Kyutai를 공동 설립했습니다. Demucs 저장소는 여전히 공개되어 있지만 README에는 더 이상 적극적으로 작업하고 있지 않다고 적혀 있으므로 새 기능을 기대하기는 어렵습니다.
성능: 속도와 음질의 절충
구조의 기본 방향
Spleeter는 스펙트로그램을 마스킹하고 Demucs는 파형을 재구성합니다. 이 핵심 차이가 나머지 차이를 만듭니다.
Spleeter의 주파수 영역 방식은 효율적입니다. STFT 프레임 하나가 수천 개 샘플을 요약하므로 합성곱이 처리하는 시간 스텝이 훨씬 적습니다. 대신 모델은 위상을 고려하지 않고 믹스의 위상을 재사용합니다. 또한 STFT의 고정된 시간과 주파수 해상도는 날카로운 트랜지언트와 일정한 음을 모두 잘 표현하기 어렵습니다.
Demucs의 시간 영역 방식은 1D 합성곱으로 자체 필터 뱅크를 학습합니다. 위상을 보존하며 샘플 단위의 정확도로 트랜지언트를 처리합니다. v4의 Transformer 레이어는 몇 초에 걸친 오디오 맥락을 유지하여 프레임 기반 방식에서 흔한 '핑퐁' 아티팩트를 줄입니다.
Hybrid Demucs v3: 파형 및 스펙트로그램 분기
인코더와 디코더의 스킵 연결
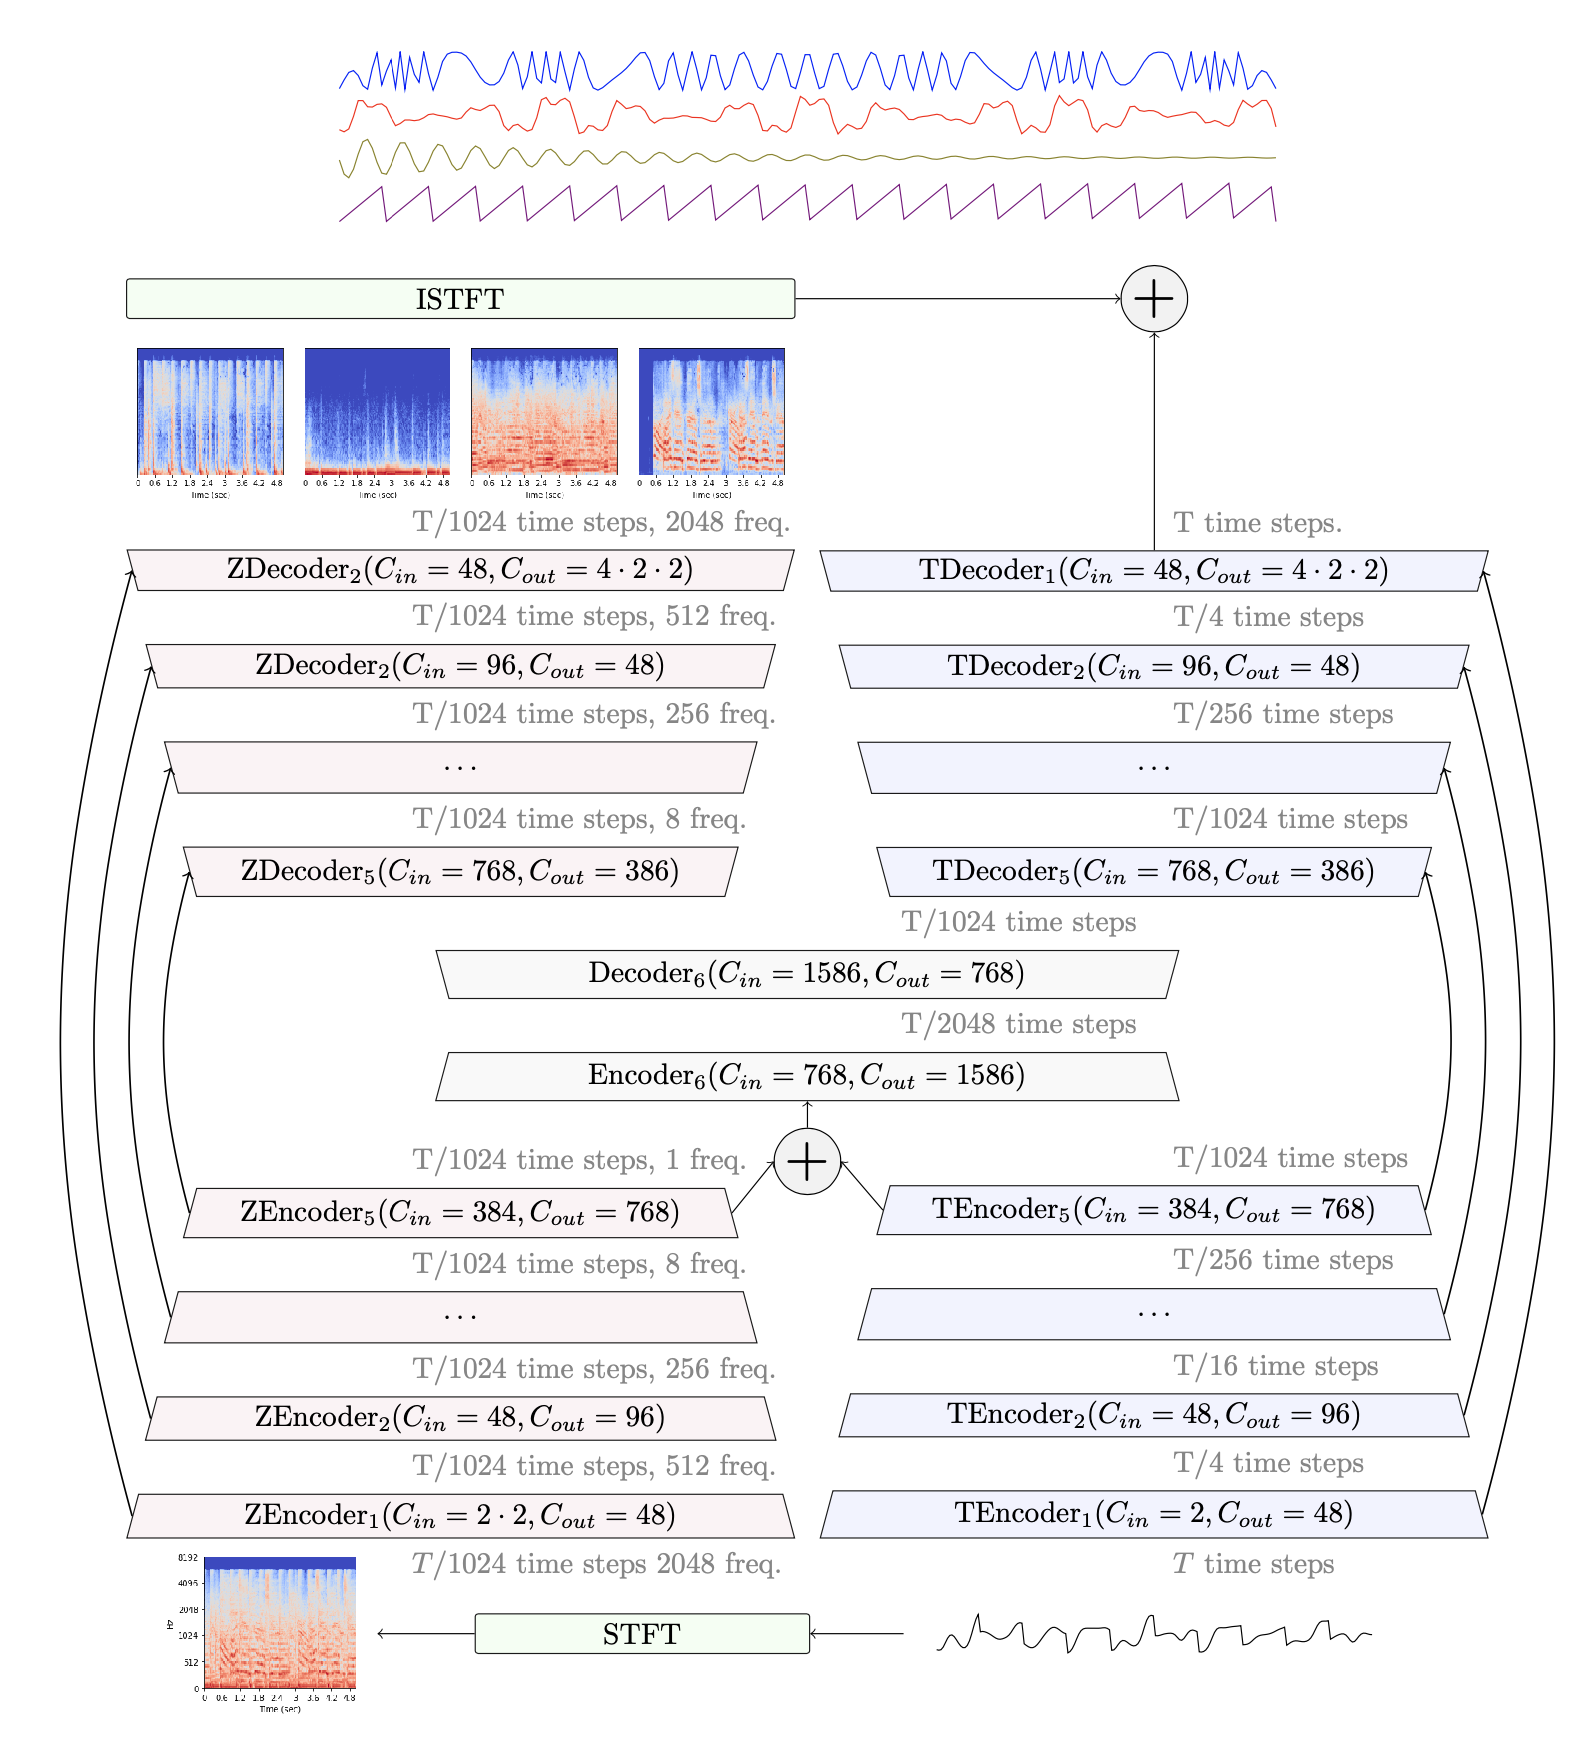
원본 도식: 음원 분리 입문, 그림 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Spleeter와 Demucs 벤치마크 수치
다음 MUSDB18 테스트 세트 점수는 공식 Demucs GitHub 저장소에서 가져왔습니다.
| 모델 | 영역 | 추가 학습 데이터 | 전체 SDR | MOS 품질 |
|---|---|---|---|---|
| Spleeter | 스펙트로그램 | 25,000곡 | 5.9 dB | 자료 없음 |
| Demucs v2 | 파형 | 없음(MUSDB18만 사용) | 6.3 dB | 2.37 |
| Hybrid Demucs v3 | 혼합 | 없음(MUSDB18만 사용) | 7.7 dB | 2.83 |
| 미세 조정한 HT Demucs v4 | 혼합 | 800곡 | 9.0 dB | 자료 없음 |
**신호 대 왜곡비(SDR)**는 모델이 믹스에서 음원을 얼마나 깨끗하게 분리하는지 측정합니다. 높을수록 좋지만 청취 테스트를 대신하지는 않습니다. 실제 AI 스템의 기대 수준은 현재 AI 스템 분리 품질을 참고하세요. Spleeter와 Demucs v4의 약 3 dB 차이는 벤치마크 기준으로 크며, Demucs는 모든 스템에서 더 높은 점수를 기록합니다. 특히 드럼과 보컬에서 차이가 큽니다.
아래 비교 영상에서 차이를 들을 수 있습니다. Demucs 스템은 아티팩트가 적고 더 자연스러운 반면, Spleeter는 복잡한 소스에서 금속성 울림을 만들 수 있습니다.

실제 작업에서의 성능 차이
속도: Spleeter는 GPU에서 3분 곡을 약 2초에 처리합니다. Demucs v4는 약 20~30초가 걸립니다. CPU에서는 Spleeter가 약 30~60초, Demucs는 5분 이상 걸릴 수 있습니다.
하드웨어: Spleeter는 RAM 8GB의 노트북에서 CPU만으로 실행됩니다. Demucs v4가 적절한 속도를 내려면 VRAM 4~8GB의 GPU가 필요하며, Transformer 레이어는 어텐션 행렬 때문에 훨씬 많은 메모리를 사용합니다.
아티팩트: Spleeter는 믹스의 위상을 재사용하므로 '유령처럼' 희미한 보컬과 번진 트랜지언트를 만들 수 있습니다. Demucs v4는 더 자연스럽지만 무음 구간에 작은 잡음이 남을 수 있습니다.
강건성: SDX'23 대회는 Demucs형 구조가 손상된 학습 데이터에 더 잘 대처한다는 점을 보여주었습니다. 더 단순한 Spleeter 구조는 선별된 데이터셋이나 손실 절단 같은 기법의 이점을 쉽게 얻기 어렵습니다.
Spleeter와 Demucs 중 무엇을 사용해야 할까요?
많은 프로듀서는 작업에 따라 둘을 함께 사용합니다.
Spleeter를 선택할 때
속도가 중요할 때 Spleeter를 사용하세요. DJ 공연용 보컬만 빠르게 추출하거나 연습용 노래방 반주를 만들거나 샘플 라이브러리 전체를 일괄 처리할 때입니다. 실시간의 100배 속도와 낮은 하드웨어 요구량은 경쟁력이 크며, 이후 스템을 추가 가공할 리믹스에는 충분한 품질입니다.
Demucs를 선택할 때
공식 리믹스용 스템, 상업적 발매용 샘플, 연주의 정밀 분석처럼 아티팩트를 허용하기 어려울 때 Demucs v4를 선택하세요. 3 dB의 SDR 개선과 위상 일관성은 기다릴 가치가 있습니다. 특정 장르의 소스를 사용한다면 추가 데이터로 미세 조정하세요. Demucs 구조는 깨끗한 데이터를 늘렸을 때 더 잘 발전합니다.
Spleeter와 Demucs를 함께 사용하기
전체 카탈로그를 Spleeter로 처리해 유망한 곡을 찾은 뒤 최종 후보를 Demucs로 처리하세요. 라이브 공연용으로는 Spleeter로 미리 분리하고, 스튜디오 작업에서는 Demucs로 가장 깨끗한 스템을 얻으세요. Ultimate Vocal Remover 같은 도구는 간단한 GUI 안에 Demucs와 다른 분리 모델을 함께 제공합니다.
GPU가 필요한가요?
Spleeter는 CPU로도 잘 실행되지만 고품질 Demucs 작업의 처리 속도를 높이려면 GPU 사용을 권장합니다. 오프라인이나 노트북에 부담이 적은 일괄 처리에는 Spleeter형 모델이 여전히 유용합니다. 더 깨끗한 스템을 원한다면 Demucs와 최신 혼합 Transformer 모델은 대체로 클라우드 처리나 더 강력한 로컬 장비를 사용할 가치가 있습니다.
2026년 업데이트: Spleeter와 Demucs보다 나은 모델
Spleeter와 Demucs는 여전히 유용한 기준점이지만 더 이상 스템 분리 품질의 최고 수준은 아닙니다.
BS-RoFormer(Band-Split RoPE Transformer)는 스펙트로그램을 주파수 대역으로 나누고 Transformer 레이어로 모델링합니다. 논문은 추가 학습 데이터 없이 MUSDB18-HQ에서 평균 SDR 9.80 dB를 보고했습니다. 이는 800곡을 추가해 미세 조정한 Demucs v4의 9.0 dB보다 높습니다. 500곡을 추가해 학습한 버전은 Sound Demixing Challenge 2023의 음악 분리 부문에서 1위를 차지했습니다.
| 모델 | 연도 | 전체 SDR(MUSDB18) | 추가 학습 데이터 |
|---|---|---|---|
| Spleeter | 2019 | 5.9 dB | 25,000곡 |
| 미세 조정한 HT Demucs (v4) | 2022 | 9.0 dB | 800곡 |
| BS-RoFormer | 2023 | 9.8 dB | 없음 |
Mel-Band RoFormer는 밀접한 관련이 있는 모델로, 멜 척도에 따라 주파수를 묶습니다. 두 모델의 커뮤니티 체크포인트는 현재 대부분의 고급 보컬 및 반주 분리 도구에 사용됩니다. 보컬 분리 모델 비교는 실제 곡으로 순위를 매기며, 악기 분리 모델 비교는 다른 악기를 같은 방식으로 평가합니다.
Neural Analog의 AI 스템 분리 도구는 4스템과 6스템 프리셋에 BS-RoFormer 모델을 사용합니다. 색소폰이나 신시사이저 리드처럼 프리셋이 다루지 않는 악기를 추출하려면 SAM Audio를 사용합니다. 전체 목록은 Neural Analog가 스템 분리에 사용하는 모델을 참고하세요.
Spleeter와 Demucs 자주 묻는 질문
Demucs가 Spleeter보다 좋은가요?
음질에서는 그렇습니다. Demucs v4는 MUSDB18 벤치마크에서 Spleeter보다 SDR이 약 3 dB 높고 보컬과 드럼의 아티팩트가 적습니다. 속도나 CPU만 있는 장비가 음질보다 중요할 때만 Spleeter가 더 낫습니다.
보컬에는 Spleeter와 Demucs 중 무엇이 더 좋나요?
Demucs입니다. Spleeter는 원래 믹스의 위상을 재사용하므로 보컬이 얇거나 '물결치는' 듯한 소리로 들리는 경우가 많습니다. 가장 깨끗한 보컬과 반주를 원한다면 BS-RoFormer 또는 Mel-Band RoFormer 모델이 대체로 둘보다 낫습니다.
Spleeter는 아직 유지 관리되나요?
Spleeter는 여전히 GitHub에서 받을 수 있지만 TensorFlow 기반의 2019년 모델이며, README는 Apple M1 칩의 TensorFlow 문제를 경고합니다. 최신 도구는 대부분 Demucs나 RoFormer 모델로 옮겨갔습니다.
Ultimate Vocal Remover(UVR)는 어떤 모델을 사용하나요?
UVR은 단일 모델이 아니라 무료 데스크톱 앱입니다. Demucs, MDX-Net 및 자체 VR Architecture 모델 등 여러 모델 계열을 포함하므로 품질은 선택한 모델에 달려 있습니다.
GPU 없이 Demucs를 사용할 수 있나요?
네, 하지만 느립니다. CPU에서는 곡당 몇 분을 예상해야 합니다. 온라인 스템 분리 도구는 서버 GPU에서 모델을 실행합니다. Studio 스템 분리 가이드에서 절차를 안내합니다.
관련 가이드
- Suno 곡에서 드럼 제거하기: 드럼 스템 분리의 실용적인 활용입니다.
- AI 드럼을 나만의 드럼 키트로 교체하기: 드럼을 분리한 뒤 보컬에 맞춰 새 그루브를 만듭니다.
- MP3 스템을 WAV 품질로 복원하기: 압축된 소스와 분리 과정에서 손실된 고음을 재구성합니다.
- 스테레오 곡을 Dolby Atmos로 변환하기: 분리된 스템을 Atmos 믹스에 배치합니다.
- GitHub에서 AudioSR 설치하고 실행하기: Python과 PyTorch 설정을 포함하며 로컬에서 실행할 수 있는 또 다른 오픈 소스 오디오 모델입니다.