고품질 AI 스템 분리: SAM Audio와 BS-RoFormer로 깨끗한 스템을 추출하는 방법
고품질 AI 스템 분리는 세 가지에 달려 있습니다. 작업에 맞는 모델, 전체 길이의 스테레오 처리, 그리고 압축 손상이 있는 원본의 복원입니다. 보컬, 드럼, 베이스에는 BS-RoFormer 같은 전용 고정 스템 모델을, 다른 악기에는 Meta의 SAM Audio를 사용하세요. Spleeter나 초기 Demucs 같은 오래된 스템 분리 도구보다 깨끗한 스템을 얻을 수 있습니다.
프로듀서, DJ, 콘텐츠 제작자는 비슷한 문제를 겪습니다. 리믹스에 쓸 깨끗한 아카펠라, 연습용 드럼 없는 트랙, 샘플링할 기타 리프만 필요할 때가 있습니다. 오래된 스템 분리 도구는 탁한 보컬과 희미하게 남은 드럼 아티팩트를 만들어 냅니다.
이 가이드는 스템이 무엇인지, 대부분의 분리 도구가 왜 아티팩트를 만드는지, Suno 노래를 포함해 실제 음악 제작에 쓸 수 있는 스템을 어떻게 얻는지 설명합니다.
스템이란? 오디오 분리의 기본 이해하기
스템은 믹스가 끝난 노래에서 추출한 개별 오디오 트랙입니다. 모든 소리가 담긴 스테레오 파일 하나 대신 보컬, 드럼, 베이스, 피아노와 다른 악기를 각각 별도의 파일로 얻습니다. 각 스템에는 해당 요소만 들어 있습니다.
스템에는 드라이 스템(효과 없음)과 웨트 스템(리버브, 압축 등의 효과 적용)이 있습니다. 드라이 스템은 요리 전 재료이고, 웨트 스템은 완성된 요리라고 생각하면 됩니다. 이 글에서 다루는 모델은 웨트 스템만 추출하므로 각 스템에는 믹스에서 적용된 효과가 그대로 남습니다.
현대 음악 제작에서 스템이 중요한 이유
스템은 고정된 스테레오 믹스를 자유롭게 다룰 수 있는 요소들로 바꿉니다. 고품질 스템이 있으면 다음 작업을 할 수 있습니다.
- 보컬을 제거해 노래방 반주 만들기
- 깨끗하게 분리한 아카펠라로 매시업 제작하기
- 원래 보컬을 중심으로 리믹스 만들기. Spotify가 계획 중인 AI 리믹스 기능도 이런 방식입니다
- 개별 악기의 레벨을 조절해 믹스의 균형 다시 잡기
- 특정 파트만 솔로로 들으며 노래 익히기
- 다른 악기의 소리가 섞이지 않도록 요소 샘플링하기
- 분리된 트랙에서 문제가 되는 주파수 수정하기
AI 이전에는 EQ 필터링과 위상 상쇄로 스템을 분리했습니다. 이 방식은 아티팩트를 만들고 파트를 완전히 분리하지 못했습니다. AI 모델은 단순히 주파수를 걸러 내는 대신 음색과 배음 구조를 인식하도록 학습해 이 문제를 개선했습니다.
대부분의 스템 분리 서비스가 가진 문제
AI 스템 분리 도구의 성능은 제각각입니다. 많은 서비스가 ‘고품질’을 약속하면서 기본적인 부분을 소홀히 합니다.
체험용 도구와 제작용 도구
Meta의 SAM Audio 체험 도구는 30초 모노 클립만 처리합니다. 데모에는 충분하지만 전체 노래를 스테레오로 처리해야 할 때는 부족합니다. Neural Analog와 SAM Audio 체험 도구의 차이를 확인하세요.
단일 모델의 한계
많은 서비스는 모델 하나만 사용하므로 타협이 필요합니다. Demucs나 BS-RoFormer 같은 고정 스템 모델은 정해진 분리 작업(보컬, 드럼, 베이스, 기타 요소)에 강하지만 색소폰이나 신시사이저처럼 사용자가 지정한 악기를 추출할 수 없습니다. 다른 모델은 맞춤 추출을 지원하지만 일반적인 스템을 전용 도구만큼 깨끗하게 분리하지 못합니다.
오디오 복원 과정이 없음
MP3나 스트리밍 녹음 같은 압축된 소스를 분리하면 기존 아티팩트가 드러납니다. 낮은 비트레이트의 MP3는 대개 약 16 kHz 이상의 정보를 잘라 내고, 트랜지언트를 흐리게 하는 양자화 잡음을 더합니다. 이를 무시하는 스템 분리 도구는 손상된 오디오를 더 뚜렷하게 분리할 뿐입니다.
SAM Audio가 스템 분리를 발전시키는 방법
Meta의 SAM Audio는 전용 보컬 제거기가 아니라 범용 음원 분리 모델입니다. Meta는 이를 텍스트, 시각 정보, 시간 구간 프롬프트를 받는 단일 모델로 설명합니다. 흐름 매칭 트랜스포머를 기반으로 하며, 음성, 음악, 일반적인 소리를 포함한 대규모 혼합 오디오로 학습했습니다.
차이를 들어 보세요: SAM Audio와 업계의 대표 도구
아래는 실제 사용 사례를 비교한 것입니다. 밀도 높은 클래식 믹스에서 SAM Audio(Neural Analog)와 주요 경쟁 도구로 피아노 스템을 분리했습니다.
예시: 피아노 추출 결과 비교
프롬프트 'piano'로 밀도 높은 스테레오 믹스에서 악기 하나를 분리합니다.
SAM Audio의 기반 기술
SAM Audio는 흐름 매칭 트랜스포머로 혼합된 녹음에서 목표 음원을 예측합니다. Neural Analog Studio에서는 음원을 글로 설명하고 그 소리가 나타나는 시간 구간을 표시할 수 있습니다. 시각 프롬프트는 연구 모델의 기능이며 현재 Studio 오디오 화면의 조작 항목은 아닙니다. 제작자에게 중요한 차이는 제어 범위입니다. 이 모델은 보컬, 드럼, 베이스, 기타 요소라는 고정된 범주 밖의 소리도 대상으로 삼을 수 있습니다.
신경 오디오 인코더: 모델 구조가 품질을 결정하는 이유
모든 AI 스템 분리 도구의 중심에는 신경 오디오 인코더가 있습니다. 원시 파형을 음색, 음높이, 리듬, 스테레오 위치에 대한 압축된 표현으로 바꿉니다. 모델의 ‘귀’라고 생각하면 됩니다. 스네어와 보컬을 얼마나 잘 구별하는지는 이 인코더가 얼마나 잘 학습됐는지에 달려 있습니다.
Spleeter 같은 초기 분리 모델은 스펙트로그램을 2D 이미지로 다루는 CNN 인코더를 사용했습니다. 기본적인 보컬과 드럼 분리는 가능했지만 세밀한 음색과 시간에 따른 일관성을 유지하기 어려웠습니다. Demucs v4(Hybrid Transformer Demucs)는 파형과 스펙트로그램을 함께 처리해 트랜지언트와 위상을 보존하므로 더 자연스럽게 들립니다. BS-RoFormer는 스펙트로그램을 주파수 대역으로 나누고 Transformer 층으로 모델링합니다. 해당 논문은 MUSDB18-HQ 벤치마크에서 평균 SDR 9.8 dB를 보고했으며, Demucs v4보다 높은 수치입니다. Spleeter와 Demucs 비교에서 이전 모델을 자세히 설명합니다.
SAM Audio는 1억 개가 넘는 비디오 클립으로 학습한 **Perception Encoder Audiovisual(PE-AV)**로 한 단계 더 나아갑니다. 비디오에서 학습했기 때문에 소리를 내는 악기와 동작을 소리와 연결합니다. 이는 ‘guitar’ 같은 프롬프트에 도움이 되며, 특히 기타와 다른 악기가 비슷한 주파수 범위를 차지할 때 유용합니다.
SAM Audio 연구 구조
dog barking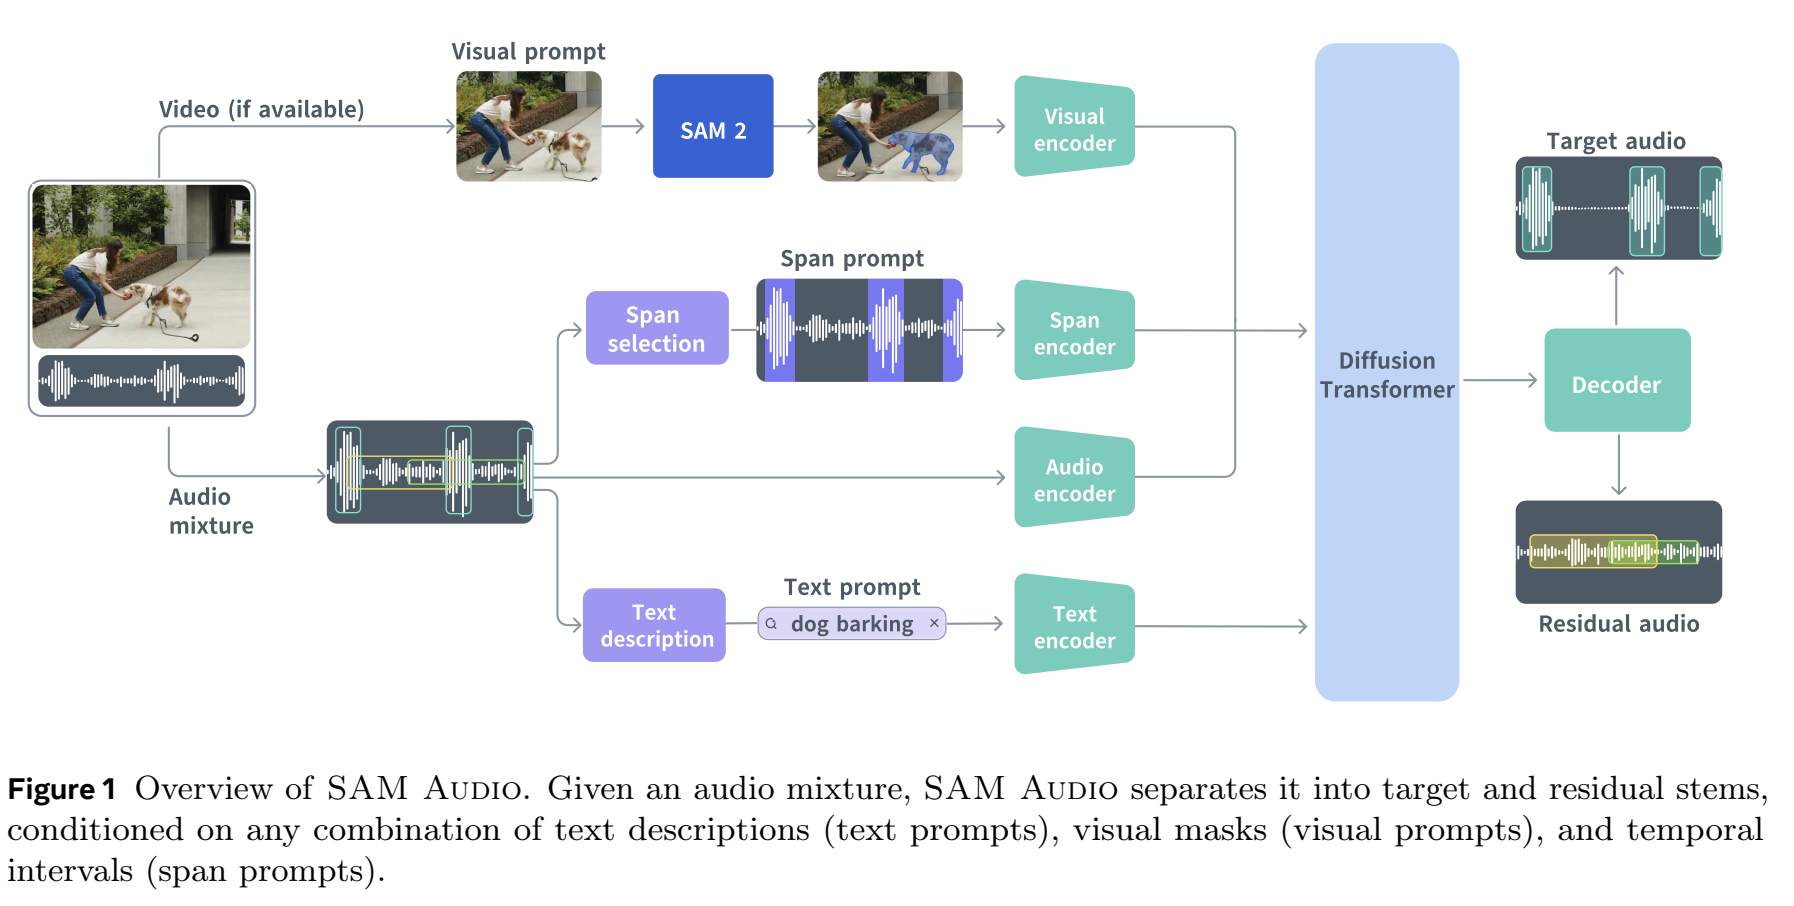
원본 도식: SAM Audio 연구 구조.
인코더의 품질은 세 가지 방식으로 스템 품질에 직접 영향을 줍니다.
- 음색 분해 능력: 더 좋은 인코더는 배음과 잡음을 구분해 악기의 고유한 음색을 유지합니다
- 시간적 일관성: 더 강력한 인코더는 시간에 따라 분리를 일관되게 유지하고, 저렴한 도구에서 흔한 빠른 끊김 아티팩트를 피합니다
- 세부 표현: 더 큰 인코더는 현의 마찰음, 숨소리, 방의 잔향과 분위기를 포착합니다
스템 분리 서비스를 비교할 때는 마케팅 문구보다 어떤 모델을 사용하는지 확인하세요. 후처리만으로는 오래된 인코더의 한계를 완전히 보완할 수 없습니다.
Neural Analog가 SAM Audio와 BS-RoFormer를 사용하는 방법
Neural Analog의 AI 스템 분리 도구는 SAM Audio와 BS-RoFormer를 음악가가 실제로 사용할 수 있는 도구로 제공합니다.
30초 모노 체험 도구와 달리 Neural Analog는 전체 트랙을 완전한 스테레오로 처리하므로 스템에 원래 믹스의 폭과 깊이가 유지됩니다.
SAM Audio와 검증된 고정 스템 프리셋 중에서 선택할 수 있습니다.
- SAM Audio: 색소폰, 신시사이저, 현악기처럼 사용자가 지정한 악기를 추출할 때 사용합니다
- 프리셋: 빠르고 안정적인 분리를 제공합니다. 스템 4개는 보컬, 드럼, 베이스, 기타 요소이며, 스템 6개에는 기타와 피아노가 추가됩니다. Demucs보다 새로운 세대의 고정 스템 분리 도구인 BS-RoFormer 모델을 사용합니다
온라인 SAM Audio에서는 목표 소리가 트랙 일부에만 나타날 때 프롬프트를 쓰고 파형에 구간을 표시할 수 있습니다. 질문이나 공유할 결과가 있나요? Neural Analog Discord에 참여하세요.
통합 오디오 복원 과정
추출한 스템에 오디오 복원을 적용해 주파수 범위를 넓히고 일부 아티팩트를 줄일 수 있습니다. 결과를 들어 보세요. 복원으로 모든 분리 오류를 수정할 수는 없습니다.
더 좋은 Suno 스템: AI 생성 음악에 특별한 처리가 필요한 이유
Suno와 Udio, FlowMusic / Producer.ai 등의 AI 음악 생성기는 압축되거나 대역폭이 제한된 파일을 출력하는 경우가 많습니다. 스템을 분리하기 전부터 품질의 한계가 생기는 것입니다. Suno 노래 링크에서 바로 분리하려면 Suno 스템 분리 도구를 사용하세요. Udio는 더 이상 다운로드나 스템을 제공하지 않으므로 먼저 Udio 노래를 오디오 파일로 저장하세요.
이중 압축 문제
기본 도구로 Suno MP3를 분리하면 이미 손상된 오디오를 분리하게 됩니다. 스템에도 다음 문제가 남습니다.
- 심한 고주파 손실. 흔히 15 kHz 이상의 정보가 없습니다
- 신호에 포함된 양자화 잡음
- 줄어든 스테레오 폭과 깊이
- 디지털 ‘링잉’ 아티팩트
복원이 AI 생성 음악을 개선하는 방법
이 과정은 위 한계를 단계별로 다룹니다.
- 추출: SAM Audio나 프리셋 모델이 스템을 분리합니다
- 아티팩트 제거: 신경 오디오 복원으로 MP3 압축 잡음을 줄일 수 있습니다
- 주파수 재구성: 모델이 최대 20 kHz까지 배음 성분을 예측하고 다시 생성합니다
- 스테레오 처리: 세부 표현을 복원하면서 스테레오 신호를 보존하고, 원본과 비교해 폭과 위상을 들어 봅니다
이렇게 얻은 Suno 스템은 전문적으로 녹음한 멀티트랙에 더 가까운 소리를 냅니다.
단계별 안내: Neural Analog로 고품질 스템 얻기
일관된 결과를 위해 다음 단계를 따르세요. Studio 스템 분리 가이드에서 각 조작 항목을 자세히 설명합니다.
1단계: 오디오 업로드
파일을 끌어 놓거나 Suno, FlowMusic, TopMediaAI, Treblo, Mureka, YouTube 같은 지원 소스의 공개 링크를 붙여 넣으세요. 업로드는 MP3, WAV, FLAC, M4A, OGG 형식을 지원합니다. 최대 길이는 요금제와 선택한 모델에 따라 달라집니다.
2단계: 분리 방식 선택
예측 가능한 결과를 원한다면, 분리를 열고 보컬, 드럼, 베이스, 기타 요소를 위한 스템 4개를 선택하거나 기타와 피아노가 추가된 스템 6개를 선택하세요. 선택된 입력을 확인하세요. 이 프리셋은 전용 고정 스템 모델을 실행해 일관된 분리를 제공합니다.
사용자가 지정한 악기를 추출하려면, 사용자 지정 프롬프트를 선택해 SAM Audio를 사용하세요. 선택된 모델을 확인한 다음 소리를 설명하세요. 구체적으로 써야 합니다. electric guitar solo with distortion은 guitar보다 효과적입니다. SAM Audio는 서로 보완되는 스템 두 개를 반환합니다. 하나는 프롬프트에 맞는 소리이고 다른 하나는 녹음의 나머지 부분입니다.
3단계: 처리 설정
SAM Audio 스테레오 처리: 기본값인 **스테레오 (Mid/Sides)**는 미드(중앙)와 사이드 신호를 따로 처리한 뒤 다시 합칩니다. **스테레오 (L/R)**를 선택하면 왼쪽과 오른쪽 채널을 각각 처리하고, 모노를 선택하면 두 채널의 평균을 하나의 채널로 만듭니다. 이 조작 항목은 SAM Audio에 적용되며, 고정 스템 프리셋은 자체 스테레오 모델을 사용합니다. Mid/Side 처리를 사용할 때를 참고하세요.
4단계: 처리 및 다운로드
분리만 하려면 스템 음질 향상을 끈 상태로 두세요. 잔액에서 차감될 처리 분 사용량의 예상치를 확인한 다음 추출 시작을 클릭하고 기다리세요. 짧은 트랙은 보통 몇 분 안에 끝나지만, 긴 트랙과 더 무거운 모델은 시간이 더 걸립니다. Studio에서 각 스템을 확인한 다음 내보내기를 열고, 각각의 파일이 필요하면 개별 스템을, 현재 믹스가 필요하면 합친 스템을 선택하세요.
5단계: 추출한 스템 복원
스템에 고주파가 없거나 들리는 압축 손상이 있다면 음질 향상에서 해당 스템을 입력으로 선택하세요. 악기에는 MP3 음악 복원, 보컬에는 노랫소리 개선을 선택하고 모델 실행 시작을 클릭하세요. 내보내기 전에 결과를 비교하세요. MP3에서 WAV로 복원하는 가이드는 모델 선택을 설명합니다. 추출 후 해당하는 스템을 자동 처리하려면 스템 음질 향상을 켜고 복원 모델을 선택한 뒤, 추출을 시작하기 전에 추가 처리 분 사용량의 예상치를 확인하세요. 깨끗한 스템은 복원할 필요가 없습니다.
제작 과정에서 살펴볼 기술적 요소
스템 추출을 제작 과정에 추가할 때는 다음 요소를 확인하세요.
원본 파일의 품질
복원은 압축 파일을 재구성할 수 있지만 무손실 원본(WAV, FLAC)을 쓰면 여전히 더 정확하게 분리할 수 있습니다. 인코더가 활용할 원래 정보가 더 많으므로 재구성해야 할 부분이 줄어듭니다.
긴 파일에서 악기가 몇 초 동안만 나타난다면 Studio에서 해당 구간을 표시하거나 업로드 전에 파일을 잘라 내세요. 모델에 더 명확한 목표를 주고 처리 속도도 높일 수 있습니다.
스템의 위상 일관성
같은 노래에서 나온 스템을 더하면 대략 원래 믹스가 되어야 합니다. 위상이 어긋나면 다시 합칠 때 콤 필터링이나 상쇄가 발생합니다. Neural Analog 모델은 위상 관계를 유지하도록 설계됐으며, 이는 스템 마스터링과 리믹스에 중요합니다. DAW에서 스템을 더한 뒤 원본과 비교해 확인하세요.
들리는 아티팩트
다음과 같은 일반적인 분리 아티팩트가 있는지 들어 보세요.
- 소리 유입: 악기 소리가 잘못된 스템에 희미하게 나타남
- 빠른 끊김: 추출 중 소리가 빠르게 켜졌다 꺼짐
- 번짐: 트랜지언트의 선명함이 사라짐
- 고주파 손실: 공기감과 세부 표현이 부족함
복원으로 이 중 많은 문제를 개선할 수 있지만, 깨끗한 원본을 쓰면 추출 단계에서부터 문제가 줄어듭니다. 이후 DAW에서 각 스템의 소리가 적절한 부분만 남기세요.
모델 유형별 사용 시점
고정 스템 프리셋(BS-RoFormer)을 사용할 때
- 일반적인 보컬, 드럼, 베이스 분리가 필요할 때
- 처리 속도가 중요할 때
- 원본 믹스가 비교적 깨끗할 때
- 예측 가능하고 검증된 결과를 원할 때
SAM Audio(맞춤 분리)를 사용할 때
- 표준 프리셋에 없는 악기일 때
- 믹스가 조밀하고 소리가 겹칠 때
- 리드 기타와 리듬 기타처럼 비슷한 소리를 분리해야 할 때
- 원본에 특이한 악기나 합성된 소리가 있을 때
필요에 따라 복원을 사용할 때
- MP3나 스트리밍 소스에 들리는 압축 손상이 있을 때
- 원본 파일이 320 kbps 미만이며 고주파 세부 정보가 없을 때
- AI 생성 음악에 대역폭 제한이나 압축 아티팩트가 있을 때
- 귀로 확인한 뒤 상업적 발매 전에 스템을 복구해야 할 때
가장 적합한 AI 스템 분리 과정 선택하기
잘 아는 테스트 트랙으로 시작하세요. 추출한 스템을 원래 믹스와 비교해 위상 일관성과 아티팩트 정도를 확인하세요. 일반적인 분리에는 프리셋을, 그 외에는 SAM Audio를 쓰고, 압축되거나 AI로 생성된 원본에 복구가 필요할 때 복원을 사용하세요.
현재의 AI 모델과 복원을 사용하면 리믹스, 샘플링, 믹스 분석에 쓸 추출 스템이 원래 멀티트랙 세션에 가까워질 수 있습니다.
고품질 스템 분리 FAQ
스템 분리에 가장 좋은 AI 모델은 무엇인가요?
보컬, 드럼, 베이스, 반주 분리에서는 BS-RoFormer와 Mel-Band RoFormer 모델이 현재 공개 벤치마크에서 가장 높은 점수를 받습니다. 고정 스템에 포함되지 않는 악기에는 SAM Audio 같은 프롬프트 기반 모델이 더 유연합니다. 보컬 분리에 가장 좋은 모델과 악기 분리에 가장 좋은 모델 순위를 확인하세요.
Neural Analog는 스템 분리에 Demucs를 사용하나요?
아니요. 스템 4개와 스템 6개 프리셋은 BS-RoFormer 모델을 사용하고, 사용자가 지정한 악기를 추출할 때는 SAM Audio를 사용합니다.
스템이 왜 얇거나 물속처럼 울렁거리게 들리나요?
대개 원본이 낮은 비트레이트의 MP3이거나 도구가 오래된 모델을 사용하기 때문입니다. 가능한 가장 좋은 원본으로 시작하고, 더 새로운 모델로 분리한 뒤 스템을 복원하세요. MP3 음질 개선으로 먹먹한 스템을 고칠 수 있는지를 읽고 복원으로 고칠 수 있는 것과 없는 것을 확인하세요.
관련 가이드
- 완성된 Suno 노래에서 드럼 제거하기: 드럼 스템 분리를 이용해 드럼 없는 트랙을 얻으세요.
- Suno 드럼을 직접 만든 드럼 소리로 교체하기: AI 드럼을 제거하고 새로운 그루브를 프로그래밍하세요.
- 스테레오 노래를 Dolby Atmos로 변환하기: 분리된 스템을 Atmos 베드와 오브젝트에 배치하세요.