Pemisahan Stem AI Berkualitas: Cara Mengekstrak Stem Bersih dengan SAM Audio dan BS-RoFormer
Pemisahan stem AI berkualitas bergantung pada tiga hal: model yang tepat untuk tugasnya, pemrosesan stereo sepanjang lagu, dan restorasi sumber yang mengalami kerusakan akibat kompresi. Gunakan model khusus dengan kategori stem tetap seperti BS-RoFormer untuk vokal, drum, dan bas, serta SAM Audio dari Meta untuk instrumen lainnya. Anda mendapatkan stem yang lebih bersih daripada hasil alat pemisah lama seperti Spleeter atau versi awal Demucs.
Produser, DJ, dan kreator konten menghadapi masalah yang sama. Anda membutuhkan akapela bersih untuk remix, lagu tanpa drum untuk berlatih, atau riff gitar terpisah untuk dijadikan sampel. Alat pemisah stem lama menyisakan vokal keruh dan artefak drum yang masih terdengar samar.
Panduan ini menjelaskan apa itu stem, mengapa sebagian besar pemisah stem menimbulkan artefak, dan cara mendapatkan stem yang bisa Anda gunakan dalam produksi sesungguhnya, termasuk stem dari lagu Suno.
Apa Itu Stem? Memahami Dasar Pemisahan Audio
Stem adalah trek audio individual yang diekstrak dari sebuah lagu yang sudah di-mix. Alih-alih satu berkas stereo yang berisi semuanya, Anda mendapatkan berkas terpisah untuk vokal, drum, bas, piano, dan instrumen lainnya. Setiap stem hanya berisi elemen tersebut.
Ada stem kering (tanpa efek) dan stem dengan efek (sudah diberi efek seperti reverb dan kompresi). Stem kering ibarat bahan sebelum dimasak; stem dengan efek ibarat hidangan jadi. Model dalam artikel ini hanya mengekstrak stem dengan efek, sehingga setiap stem mempertahankan efek yang sudah ada dalam mix.
Mengapa Stem Penting dalam Produksi Musik Modern
Stem mengubah mix stereo yang statis menjadi bagian-bagian yang fleksibel. Dengan stem berkualitas, Anda dapat:
- Membuat trek karaoke dengan menghapus vokal
- Membuat mashup dengan isolasi akapela yang bersih
- Membuat remix berdasarkan vokal asli, gagasan di balik fitur remix AI yang direncanakan Spotify
- Menyeimbangkan kembali mix dengan mengatur level setiap instrumen
- Mempelajari lagu dengan mendengarkan bagian tertentu secara solo
- Mengambil sampel elemen tanpa bocoran suara instrumen lain
- Memperbaiki frekuensi bermasalah dalam trek yang sudah dipisahkan
Sebelum AI, pemisahan stem mengandalkan penyaringan EQ dan pembatalan fase, yang menimbulkan artefak dan tidak pernah sepenuhnya mengisolasi suatu bagian. Model AI memperbaiki pendekatan ini dengan belajar mengenali warna suara dan struktur harmonik, bukan hanya menyaring frekuensi.
Masalah pada Sebagian Besar Layanan Pemisahan Stem
Pemisah stem AI tidak semuanya setara. Banyak layanan menjanjikan “kualitas tinggi”, tetapi mengorbankan hal-hal mendasar:
Area Demo Dibandingkan dengan Alat Produksi
Area demo SAM Audio dari Meta hanya memproses klip mono berdurasi 30 detik. Itu cukup untuk demo, tetapi tidak ketika Anda membutuhkan lagu utuh dalam stereo. Lihat perbedaan Neural Analog dengan area demo SAM Audio.
Keterbatasan Satu Model
Banyak layanan menggunakan satu model, sehingga harus menerima kompromi. Model dengan kategori stem tetap seperti Demucs atau BS-RoFormer bagus untuk pemisahan berdasarkan preset (vokal, drum, bas, lainnya), tetapi tidak dapat mengekstrak instrumen khusus seperti saksofon atau synthesizer. Model lain menawarkan ekstraksi khusus, tetapi pemisahan stem standarnya kurang bersih dibandingkan dengan alat yang memang dirancang untuk itu.
Tanpa Alur Restorasi Audio
Memisahkan sumber terkompresi seperti MP3 atau rekaman dari layanan streaming akan memperjelas artefak yang sudah ada. MP3 dengan bitrate rendah sering membuang semua frekuensi di atas sekitar 16 kHz dan menambahkan derau kuantisasi yang mengaburkan transien. Pemisah stem yang mengabaikan hal ini hanya mengisolasi audio rusak dengan lebih jelas.
Bagaimana SAM Audio Memajukan Pemisahan Stem
SAM Audio dari Meta merupakan model pemisahan sumber umum, bukan penghapus vokal khusus. Meta menjelaskannya sebagai satu model yang menerima prompt teks, visual, dan rentang waktu, dibangun dengan transformer pencocokan aliran, serta dilatih pada campuran audio berskala besar yang mencakup ucapan, musik, dan suara umum.
Dengarkan Perbedaannya: SAM Audio Dibandingkan dengan Standar Industri
Berikut perbandingan dari penggunaan nyata. Kami mengambil mix musik klasik yang padat, lalu mengisolasi stem piano menggunakan SAM Audio (Neural Analog) dan layanan pesaing terkemuka.
Contoh: Perbandingan Ekstraksi Piano
Mengisolasi satu instrumen dari mix stereo yang padat menggunakan prompt 'piano'.
Teknologi di Balik SAM Audio
SAM Audio menggunakan transformer pencocokan aliran untuk memprediksi sumber target dari rekaman campuran. Di Neural Analog Studio, Anda dapat mendeskripsikan sumber dengan teks dan menandai rentang waktu saat suara tersebut muncul. Prompt visual merupakan bagian dari model penelitian, bukan kontrol dalam antarmuka audio Studio saat ini. Bagi produser, perbedaannya terletak pada kendali: model dapat menargetkan suara di luar kategori tetap vokal, drum, bas, dan lainnya.
Encoder Audio Neural: Mengapa Arsitektur Model Menentukan Kualitas
Setiap pemisah stem AI dibangun dengan encoder audio neural sebagai inti. Encoder mengubah bentuk gelombang mentah menjadi representasi ringkas dari warna suara, tinggi nada, ritme, dan penempatan stereo. Anggap ini sebagai “telinga” model: kemampuan membedakan snare dengan vokal bergantung pada seberapa baik encoder tersebut dilatih.
Model pemisahan awal, seperti Spleeter, menggunakan encoder CNN yang memperlakukan spektrogram seperti gambar 2D. Model ini dapat memisahkan vokal dan drum secara dasar, tetapi kesulitan mempertahankan detail halus warna suara dan konsistensi sepanjang waktu. Demucs v4 (Hybrid Transformer Demucs) memproses bentuk gelombang sekaligus spektrogram, sehingga membantu mempertahankan transien dan fase untuk menghasilkan suara yang lebih alami. BS-RoFormer membagi spektrogram ke dalam pita frekuensi dan memodelkannya menggunakan lapisan Transformer. Makalahnya melaporkan SDR rata-rata 9,8 dB pada tolok ukur MUSDB18-HQ, melampaui Demucs v4. Perbandingan Spleeter dan Demucs kami membahas model-model lama secara terperinci.
SAM Audio melangkah lebih jauh dengan Perception Encoder Audiovisual (PE-AV), yang dilatih pada lebih dari 100 juta klip video. Karena belajar dari video, model ini menghubungkan suara dengan instrumen dan tindakan yang menghasilkannya. Ini membantu saat Anda menggunakan prompt seperti “guitar”, terutama jika gitar berbagi rentang frekuensi dengan instrumen lain.
Arsitektur riset SAM Audio
dog barking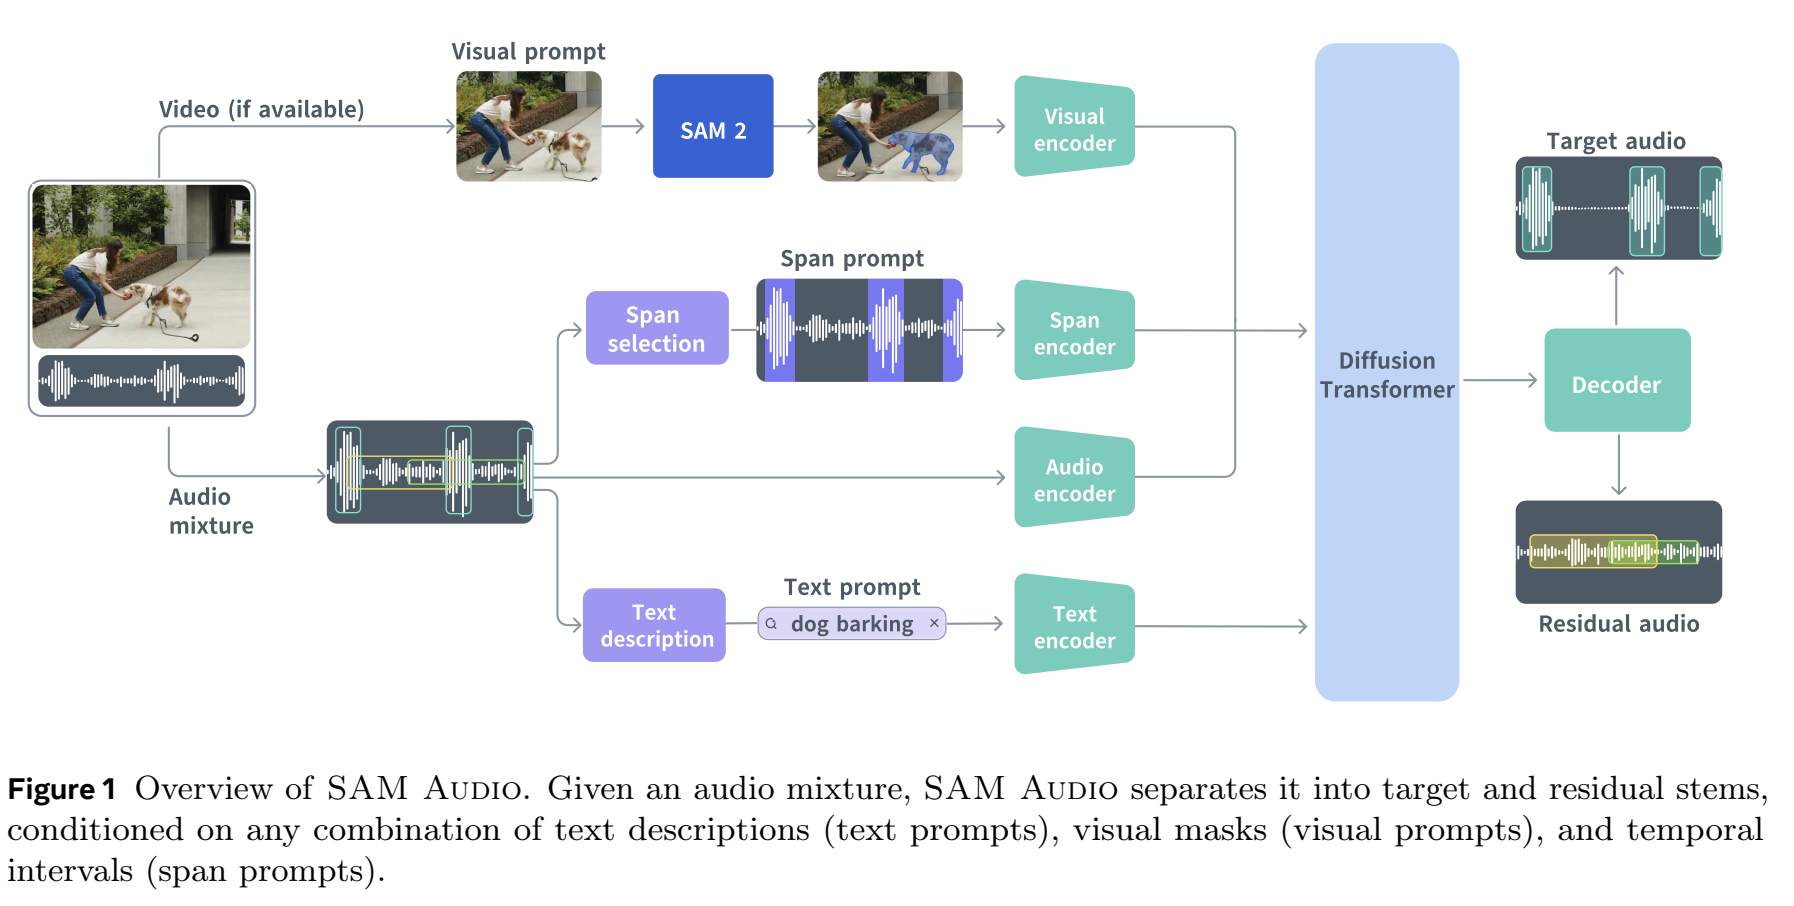
Diagram asli: Arsitektur riset SAM Audio.
Kualitas encoder secara langsung memengaruhi kualitas stem dalam tiga hal:
- Resolusi warna suara: encoder yang lebih baik memisahkan harmonik dari derau, sehingga instrumen mempertahankan karakternya
- Koherensi temporal: encoder yang lebih kuat menjaga konsistensi pemisahan sepanjang waktu, menghindari artefak suara terputus-putus yang umum pada alat berbiaya rendah
- Detail: encoder yang lebih besar menangkap gesekan senar, napas, dan suasana ruangan
Saat membandingkan layanan pemisahan stem, tanyakan model yang digunakan, bukan hanya membaca klaim pemasaran. Pemrosesan setelah pemisahan tidak dapat sepenuhnya menutupi kekurangan encoder lama.
Cara Neural Analog Menggunakan SAM Audio dan BS-RoFormer
Pemisah stem AI Neural Analog menjadikan SAM Audio dan BS-RoFormer alat praktis bagi musisi.
Berbeda dari area demo mono berdurasi 30 detik, Neural Analog memproses lagu utuh dalam stereo penuh, sehingga stem mempertahankan lebar dan kedalaman mix asli.
Anda dapat memilih SAM Audio atau preset stem tetap yang sudah terbukti:
- SAM Audio untuk ekstraksi instrumen khusus (saksofon, synthesizer, alat musik gesek)
- Preset untuk pemisahan yang lebih cepat dan andal: 4 stem (vokal, drum, bas, lainnya) atau 6 stem (menambahkan gitar dan piano), menggunakan model BS-RoFormer, generasi pemisah stem tetap yang lebih baru daripada Demucs
Dengan SAM Audio online, Anda dapat menulis prompt dan menandai rentang pada bentuk gelombang ketika suara target hanya muncul di sebagian lagu. Punya pertanyaan atau hasil yang ingin dibagikan? Bergabunglah dengan Discord Neural Analog.
Alur Restorasi Audio Terintegrasi
Anda dapat menjalankan restorasi audio pada stem hasil ekstraksi untuk memperluas rentang frekuensinya dan membersihkan sebagian artefak. Dengarkan hasilnya: restorasi tidak memperbaiki setiap kesalahan pemisahan.
Stem Suno yang Lebih Baik: Mengapa Musik AI Memerlukan Penanganan Khusus
Suno dan generator musik AI lainnya, termasuk Udio dan FlowMusic / Producer.ai, sering menghasilkan berkas terkompresi atau dengan rentang frekuensi terbatas. Ini membatasi kualitas bahkan sebelum pemisahan stem dimulai. Untuk memisahkan lagu Suno langsung dari tautannya, gunakan pemisah stem Suno. Udio tidak lagi menyediakan unduhan atau stem, jadi terlebih dahulu simpan lagu Udio Anda sebagai berkas audio.
Masalah Kompresi Ganda
Memisahkan MP3 Suno dengan alat dasar berarti memisahkan audio yang kualitasnya sudah menurun. Stem ikut membawa:
- Kehilangan frekuensi tinggi yang parah (sering tidak ada apa pun di atas 15 kHz)
- Derau kuantisasi yang tertanam dalam sinyal
- Lebar dan kedalaman stereo yang berkurang
- Artefak denging digital
Cara Restorasi Memperbaiki Musik Buatan AI
Prosesnya menangani keterbatasan ini secara bertahap:
- Ekstraksi: SAM Audio atau model preset memisahkan stem
- Pengurangan artefak: restorasi neural dapat mengurangi derau kompresi MP3
- Rekonstruksi frekuensi: model memprediksi dan membangun kembali konten harmonik hingga 20 kHz
- Penanganan stereo: pertahankan sinyal stereo saat memulihkan detail, lalu dengarkan dan bandingkan lebar serta fase dengan sumber
Stem Suno yang dihasilkan terdengar lebih mendekati rekaman multitrack profesional.
Langkah demi Langkah: Mendapatkan Stem Berkualitas dengan Neural Analog
Ikuti langkah-langkah ini untuk mendapatkan hasil yang konsisten. Panduan pemisahan stem di Studio membahas setiap kontrol secara lebih terperinci.
Langkah 1: Unggah Audio
Seret dan lepaskan berkas Anda, atau tempelkan tautan publik dari sumber yang didukung, seperti Suno, FlowMusic, TopMediaAI, Treblo, Mureka, atau YouTube. Format unggahan yang didukung mencakup MP3, WAV, FLAC, M4A, dan OGG. Durasi maksimum bergantung pada paket Anda dan model yang dipilih.
Langkah 2: Pilih Strategi Pemisahan
Untuk hasil yang dapat diprediksi, buka Pisahkan dan pilih 4 stem untuk vokal, drum, bas, dan lainnya, atau 6 stem untuk menambahkan gitar dan piano. Periksa Input yang dipilih. Preset ini menjalankan model khusus dengan kategori stem tetap dan memberikan pemisahan yang konsisten.
Untuk instrumen khusus, pilih Prompt Kustom untuk menggunakan SAM Audio. Periksa Model yang dipilih, lalu deskripsikan suaranya. Gunakan deskripsi yang spesifik: electric guitar solo with distortion bekerja lebih baik daripada guitar. SAM Audio menghasilkan dua stem yang saling melengkapi: suara yang sesuai dengan prompt dan sisa rekaman.
Langkah 3: Atur Pemrosesan
Pemrosesan stereo SAM Audio: mode default Stereo (Tengah/Selisih) memproses sinyal tengah (Mid) dan selisih (Side) secara terpisah, lalu menggabungkannya kembali. Pilih Stereo (L/R) untuk memproses kanal kiri dan kanan secara terpisah, atau Mono untuk merata-ratakannya menjadi satu kanal. Kontrol ini berlaku untuk SAM Audio; preset stem tetap menggunakan model stereo sendiri. Lihat kapan menggunakan pemrosesan Mid/Side.
Langkah 4: Proses dan Unduh
Biarkan Tingkatkan stem nonaktif jika Anda hanya ingin memisahkan stem. Tinjau perkiraan menit pemrosesan yang akan dipotong dari saldo Anda, lalu klik Mulai ekstraksi dan tunggu. Lagu pendek sering selesai dalam beberapa menit; lagu lebih panjang dan model yang lebih berat membutuhkan lebih banyak waktu. Tinjau setiap stem di Studio, lalu buka Ekspor dan pilih Stem individual untuk berkas terpisah atau Stem gabungan untuk mix saat ini.
Langkah 5: Restorasi Stem Hasil Ekstraksi
Jika stem kehilangan frekuensi tinggi atau mengalami kerusakan kompresi yang terdengar, pilih stem tersebut sebagai Input di bagian Tingkatkan, pilih Restorasi Musik MP3 untuk instrumen atau Restorasi Nyanyian MP3 untuk vokal, lalu klik Jalankan model. Bandingkan hasilnya sebelum mengekspor. Panduan restorasi MP3 ke WAV menjelaskan pilihan model. Jika Anda ingin memproses stem yang memenuhi syarat secara otomatis setelah ekstraksi, aktifkan Tingkatkan stem, pilih model restorasi, dan tinjau perkiraan tambahan menit pemrosesan sebelum memulai ekstraksi. Stem yang bersih tidak memerlukan restorasi.
Pertimbangan Teknis untuk Alur Produksi
Saat menambahkan ekstraksi stem ke alur produksi Anda, periksa faktor-faktor berikut:
Kualitas Berkas Sumber
Restorasi dapat membangun kembali detail berkas terkompresi, tetapi sumber lossless (WAV, FLAC) tetap memberikan pemisahan yang lebih akurat. Encoder mendapat lebih banyak informasi asli untuk diproses, sehingga lebih sedikit yang perlu direkonstruksi.
Jika instrumen Anda hanya muncul beberapa detik dalam berkas panjang, tandai rentang tersebut di Studio atau potong berkas sebelum mengunggahnya. Model mendapatkan target yang lebih jelas, dan pemrosesan menjadi lebih cepat.
Koherensi Fase Stem
Stem dari lagu yang sama seharusnya jika dijumlahkan menghasilkan kurang lebih mix asli. Jika fasenya bergeser, penggabungannya menimbulkan penyaringan sisir atau pembatalan sinyal. Model Neural Analog dirancang untuk mempertahankan hubungan fase, yang penting untuk mastering stem dan remix. Periksa dengan menjumlahkan stem dalam DAW Anda dan membandingkannya dengan versi asli.
Artefak yang Terdengar
Dengarkan artefak pemisahan yang umum:
- Bocoran suara: instrumen terdengar samar di stem yang salah
- Suara terputus-putus: suara cepat muncul dan menghilang selama ekstraksi
- Pengaburan transien: hilangnya ketajaman transien
- Hilangnya frekuensi tinggi: berkurangnya kesan lapang dan detail
Restorasi memperbaiki banyak artefak ini, tetapi sumber yang bersih menguranginya sejak tahap ekstraksi. Setelah itu, gunakan DAW untuk mempertahankan hanya bagian setiap stem yang terdengar baik.
Kapan Menggunakan Setiap Jenis Model
Gunakan Preset Stem Tetap (BS-RoFormer) Jika:
- Anda membutuhkan isolasi standar untuk vokal, drum, atau bas
- Kecepatan pemrosesan sangat penting
- Mix sumber relatif bersih
- Anda menginginkan hasil yang dapat diprediksi dan sudah teruji
Gunakan SAM Audio (Kustom) Jika:
- Instrumen tidak tercakup dalam preset standar
- Mix padat dan memiliki banyak suara yang tumpang tindih
- Anda perlu memisahkan suara yang mirip (misalnya gitar melodi dengan gitar ritme)
- Sumber berisi instrumen yang tidak umum atau suara sintetis
Gunakan Restorasi Jika Diperlukan:
- Sumber MP3 atau streaming mengalami kerusakan kompresi yang terdengar
- Berkas asli memiliki bitrate di bawah 320 kbps dan kehilangan detail frekuensi tinggi
- Musik buatan AI memiliki batas rentang frekuensi atau artefak kompresi
- Stem perlu diperbaiki sebelum rilis komersial, setelah diperiksa dengan mendengarkannya
Cara Memilih Alur Pemisahan Stem AI Terbaik
Mulailah dengan lagu uji yang Anda kenal baik. Bandingkan stem hasil ekstraksi dengan mix asli untuk memeriksa koherensi fase dan tingkat artefak. Gunakan preset untuk pemisahan standar, SAM Audio untuk kebutuhan lainnya, dan restorasi ketika sumber terkompresi atau buatan AI perlu diperbaiki.
Dengan model AI dan restorasi saat ini, stem hasil ekstraksi dapat mendekati sesi multitrack asli untuk remix, sampel, dan analisis mix.
Tanya Jawab Pemisahan Stem Berkualitas
Apa model AI terbaik untuk pemisahan stem?
Untuk vokal, drum, bas, dan instrumental, model BS-RoFormer dan Mel-Band RoFormer saat ini meraih skor tertinggi pada tolok ukur publik. Untuk instrumen di luar kategori stem tetap tersebut, model berbasis prompt seperti SAM Audio lebih fleksibel. Lihat peringkat model terbaik untuk vokal dan model terbaik untuk instrumen kami.
Apakah Neural Analog menggunakan Demucs untuk stem?
Tidak. Preset 4 stem dan 6 stem menggunakan model BS-RoFormer, sedangkan ekstraksi instrumen khusus menggunakan SAM Audio.
Mengapa stem saya terdengar tipis atau seperti berair?
Biasanya karena sumbernya adalah MP3 dengan bitrate rendah, atau karena alatnya menggunakan model lama. Mulailah dari sumber terbaik yang Anda miliki, gunakan model yang lebih baru, lalu lakukan restorasi stem. Baca apakah peningkatan kualitas MP3 memperbaiki stem yang terdengar teredam untuk memahami apa yang dapat dan tidak dapat diperbaiki restorasi.
Panduan Terkait
- Hapus drum dari lagu Suno yang sudah jadi: pisahkan stem drum untuk mendapatkan lagu tanpa drum.
- Ganti drum Suno dengan kit drum Anda sendiri: hapus drum AI, lalu program pola ritme baru.
- Konversi lagu stereo ke Dolby Atmos: tempatkan stem terpisah dalam bed dan objek Atmos.