Spleeter vs Demucs pada 2026: tolok ukur dan model yang mengungguli keduanya
Perbandingan Spleeter dan Demucs pada dasarnya adalah kecepatan versus kualitas. Demucs memisahkan stem dengan lebih bersih (SDR 9,0 dB untuk Demucs v4 dengan pelatihan lanjutan, dibandingkan 5,9 dB untuk Spleeter), sedangkan Spleeter jauh lebih cepat dan berjalan dengan baik pada CPU sederhana. Pada 2026, model yang lebih baru seperti BS-RoFormer memperoleh skor lebih tinggi daripada keduanya.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Pengembang | Deezer, 2019 | Meta AI Research, 2022 |
| Cara kerja | Menerapkan masker pada spektrogram (U-Net) | Cabang bentuk gelombang dan spektrogram dengan Transformer |
| Kualitas (SDR pada MUSDB18) | 5,9 dB | 9,0 dB (pelatihan lanjutan) |
| Kecepatan | Sangat cepat, berjalan baik pada CPU | Lebih lambat, paling baik dengan GPU |
| Stem | 2, 4, atau 5 | 4, atau 6 dengan gitar dan piano |
| Cocok untuk | Pratinjau cepat, karaoke, pemrosesan sekaligus | Stem bersih untuk remix dan rilisan |
Jika Anda pernah mencoba mengekstrak vokal atau membuat instrumental untuk remix, kemungkinan Anda menggunakan alat yang dibangun di atas salah satunya. Kedua model sumber terbuka ini menjadi acuan pemisahan stem, dan perbandingannya tetap memperlihatkan kompromi antara kecepatan, artefak, dan kualitas.
Apa itu stem dan mengapa sulit dipisahkan?
Stem adalah komponen terpisah dari lagu yang sudah dicampur, biasanya vokal, drum, bas, dan suara lainnya. Produser mengolahnya di studio sebelum semuanya digabungkan dalam campuran akhir.
Memisahkannya setelah pencampuran seperti mencoba mengembalikan kue yang sudah dipanggang ke bahan-bahannya. Instrumen berbagi rentang frekuensi yang sama. Harmonik vokal bertumpang tindih dengan frekuensi gitar. Transien kick drum bertumpang tindih dengan nada bas. Hantaman simbal menyebar ke seluruh bidang stereo. Pemrosesan sinyal tradisional menghasilkan suara bergelombang dengan banyak artefak.
Pembelajaran mendalam memperbaikinya dengan melatih jaringan saraf untuk mengenali pola yang terlewat oleh pemrosesan sinyal klasik. Spleeter dan Demucs menjadi dua model acuan, dengan pendekatan yang sangat berbeda.
Sejarah Spleeter, Demucs, dan kaitannya dengan Paris
Spleeter: pemaskeran spektrogram yang cepat dari Deezer
Pada November 2019, layanan streaming Prancis Deezer merilis Spleeter sebagai alat gratis dan sumber terbuka. Tim yang dipimpin Romain Hennequin membangunnya dengan TensorFlow, menggunakan jaringan saraf konvolusional U-Net yang bekerja pada spektrogram magnitudo, yaitu representasi audio dalam waktu dan frekuensi.
Spleeter memperlakukan pemisahan seperti segmentasi gambar. Model ini memprediksi masker lunak untuk setiap bin waktu-frekuensi, memperkirakan seberapa besar bagian tersebut berasal dari vokal, drum, bas, atau suara lain. Tahap penyaringan Wiener opsional menyempurnakan masker, lalu stem direkonstruksi menggunakan fase campuran asli.
Kekuatan Spleeter adalah kecepatan. Model ini memisahkan lagu berdurasi empat menit dalam hitungan detik, mencapai 100 kali kecepatan waktu nyata pada GPU, dan berjalan dengan baik pada CPU sederhana. Konfigurasinya mencakup 2 stem (vokal/iringan), 4 stem, dan 5 stem. Spleeter menjadi acuan penelitian dan mendukung banyak kanal remix YouTube.
Demucs: pemisahan dalam domain bentuk gelombang dari Meta
Saat Spleeter berfokus pada kecepatan, Meta AI Research, yang saat itu bernama Facebook AI Research, berfokus pada kualitas. Alexandre Défossez, yang juga berasal dari Prancis, dan timnya memperkenalkan Demucs pada 2019, singkatan dari Deep Extractor for MUlti-Channel Sources, dengan pendekatan yang sangat berbeda.
Alih-alih spektrogram, Demucs bekerja langsung pada bentuk gelombang audio mentah dan memperlakukan pemisahan sebagai masalah rekonstruksi dalam domain waktu. Arsitekturnya menggabungkan enkoder-dekoder konvolusional bergaya U-Net, terinspirasi oleh Wave-U-Net, dengan bottleneck LSTM dua arah. Hal ini membantu jaringan menangkap struktur musik jangka panjang dan menjaga koherensi fase.
Demucs berkembang melalui empat versi utama:
- v1 (2019): Pendekatan bentuk gelombang murni yang sudah mampu menyaingi metode spektrogram
- v2 (2020): Penyempurnaan pelatihan dan peningkatan efisiensi
- v3 "Hybrid Demucs" (2021): Menambahkan cabang spektrogram dan memenangi Music Demixing Challenge dengan SDR 7,7 dB pada MUSDB18
- v4 "Hybrid Transformer Demucs" (2022): Mengganti lapisan terdalam dengan Transformer lintas domain, mencapai SDR 9,0 dB dengan pelatihan lanjutan dan hingga 9,2 dB pada konfigurasi terbaik dalam makalah
Sound Demixing Challenge dan awal yang baru
Sound Demixing Challenge 2023 mengubah fokusnya. Kompetisi yang diselenggarakan oleh Meta, Sony, dan pihak lain ini memperkenalkan pemisahan sumber musik yang tangguh: melatih model pada data dengan label yang tidak akurat dan kebocoran antarstem. Alexandre Défossez adalah salah satu penyelenggara utama dan turut menyusun kompetisi serta model acuan.
Temuan utamanya adalah lebih banyak data pelatihan tidak menjamin hasil yang lebih baik. Kualitas data dan strategi ketangguhan lebih penting. Teknik seperti pemangkasan nilai fungsi kerugian dan penyempurnaan berulang meningkatkan SDR sebesar 0,89 dB pada data yang mengandung gangguan.
Tak lama kemudian, Défossez meninggalkan Meta untuk ikut mendirikan Kyutai, laboratorium riset AI Prancis. Repositori Demucs masih tersedia, tetapi README menyebutkan bahwa ia tidak lagi aktif mengerjakannya, jadi jangan mengharapkan fitur baru.
Performa: kompromi kecepatan dan kualitas
Filosofi arsitektur
Spleeter menerapkan masker pada spektrogram. Demucs merekonstruksi bentuk gelombang. Perbedaan mendasar ini menentukan aspek-aspek lainnya.
Pendekatan domain frekuensi Spleeter efisien karena setiap bingkai STFT merangkum ribuan sampel, sehingga konvolusi berjalan pada jauh lebih sedikit langkah waktu. Konsekuensinya, model tidak mempelajari fase, melainkan menggunakan kembali fase campuran, dan resolusi waktu-frekuensi STFT yang tetap tidak dapat merepresentasikan transien tajam sekaligus nada stabil dengan baik.
Metode domain waktu Demucs mempelajari bank filternya sendiri melalui konvolusi 1D. Model ini mempertahankan fase dan menangani transien dengan ketepatan per sampel. Pada v4, lapisan Transformer mempertahankan konteks selama beberapa detik audio, sehingga mengurangi artefak "ping-pong" yang umum pada metode berbasis bingkai.
Hybrid Demucs v3: cabang bentuk gelombang dan spektrogram
Koneksi pintas antara enkoder dan dekoder
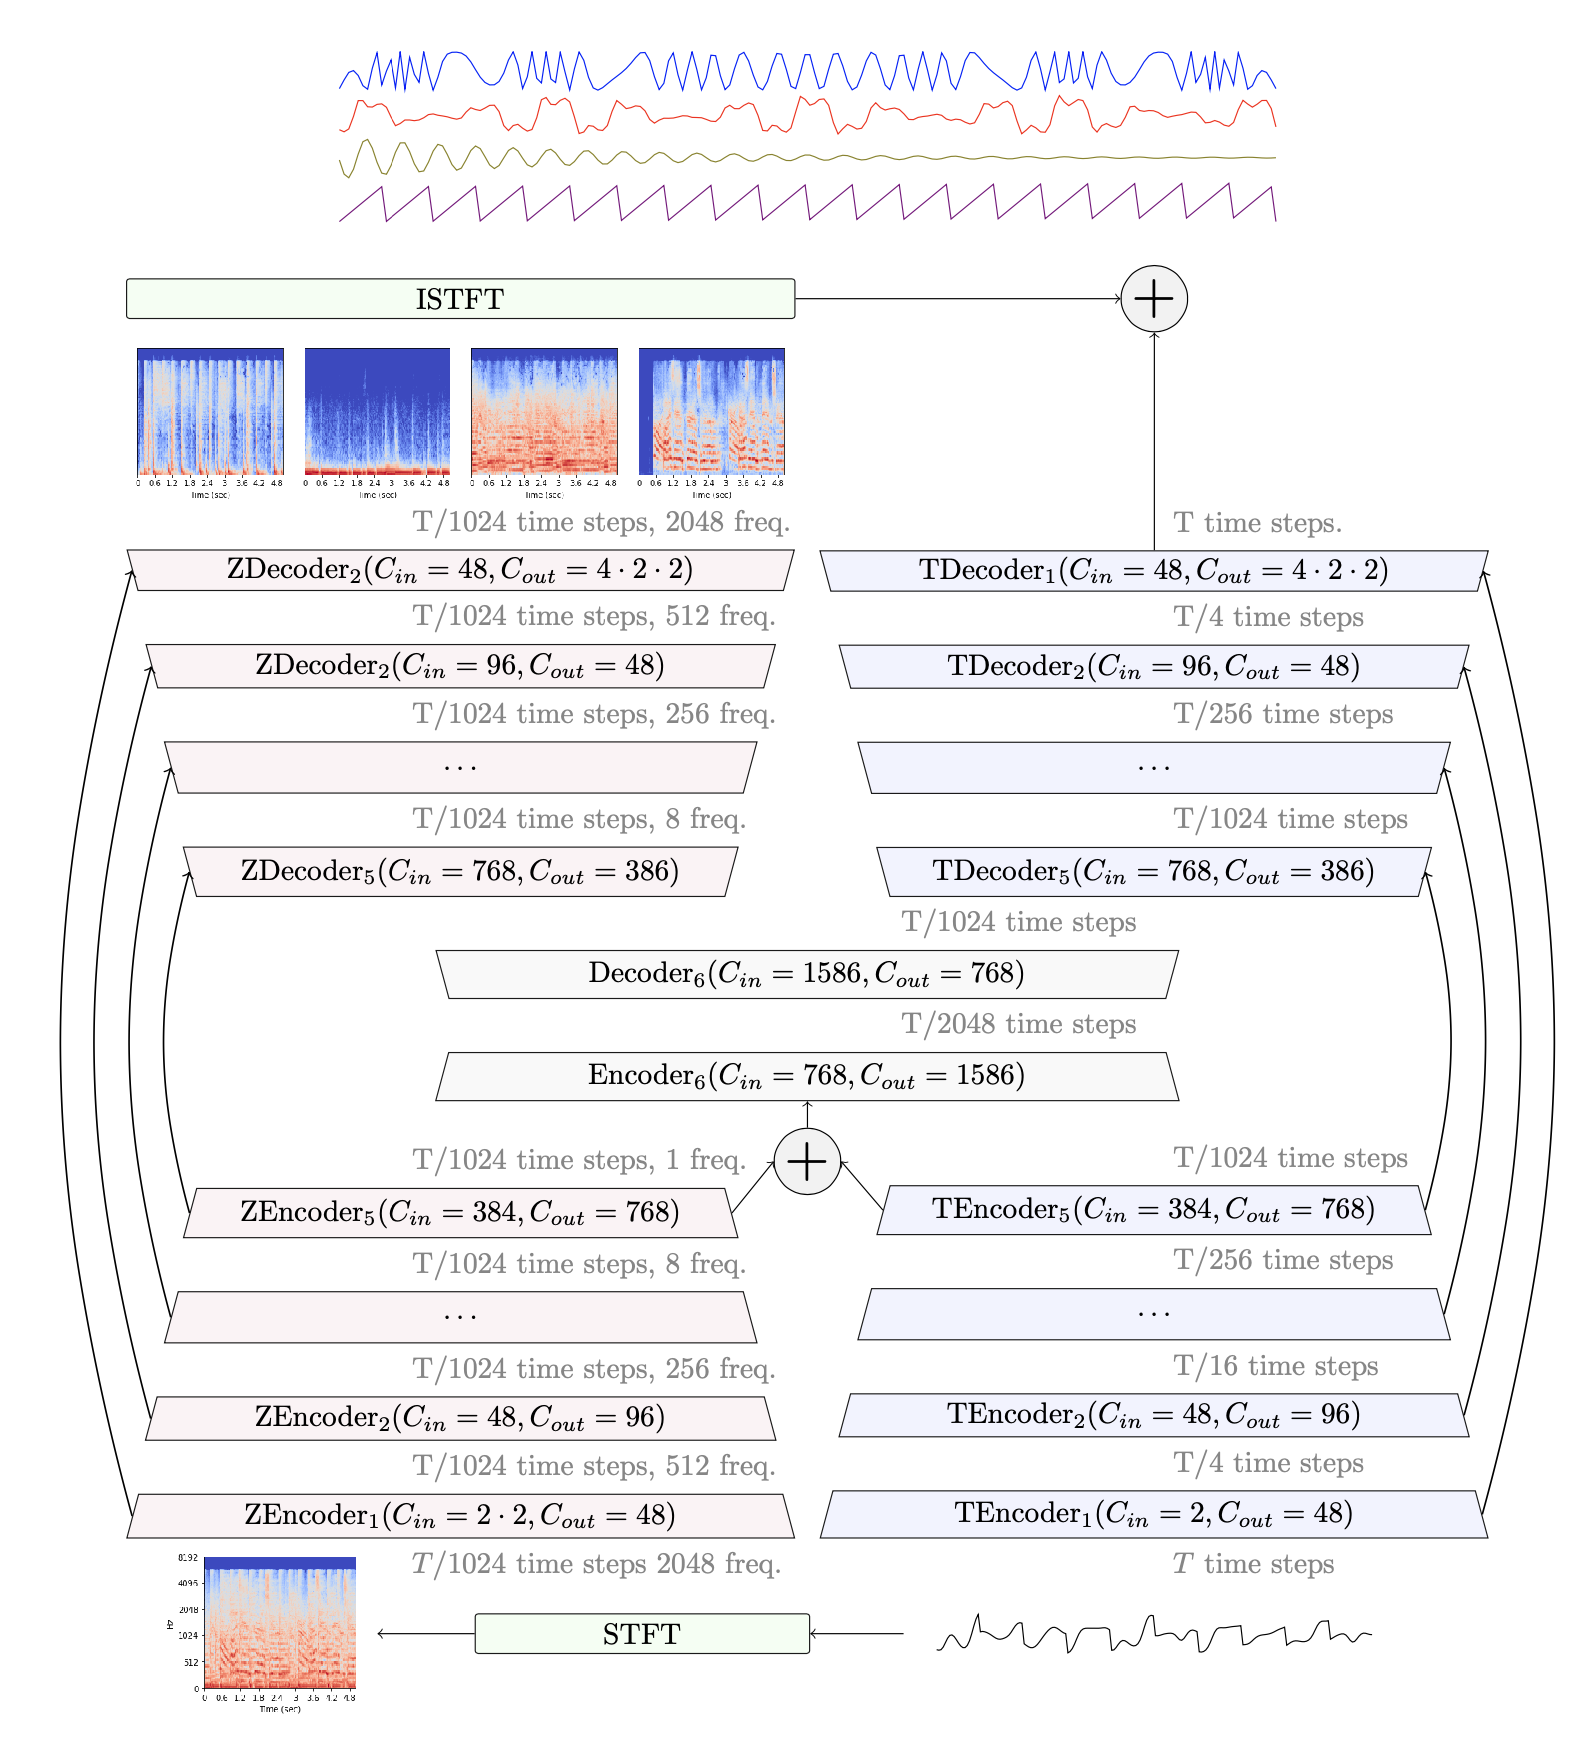
Diagram asli: Pengantar pemisahan sumber, Gambar 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Angka tolok ukur Spleeter versus Demucs
Skor pada set uji MUSDB18 ini berasal dari repositori GitHub resmi Demucs:
| Model | Domain | Data pelatihan tambahan | SDR keseluruhan | Kualitas MOS |
|---|---|---|---|---|
| Spleeter | Spektrogram | 25 ribu lagu | 5,9 dB | Tidak tersedia |
| Demucs v2 | Bentuk gelombang | Tidak ada (hanya MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Hibrida | Tidak ada (hanya MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs v4 dengan pelatihan lanjutan | Hibrida | 800 lagu | 9,0 dB | Tidak tersedia |
Rasio sinyal terhadap distorsi (SDR) mengukur seberapa bersih model memisahkan suatu sumber dari campuran. Lebih tinggi berarti lebih baik, tetapi SDR tidak menggantikan uji dengar. Untuk mengetahui hasil stem AI dalam praktik, lihat seberapa baik pemisahan stem AI saat ini. Selisih sekitar 3 dB antara Spleeter dan Demucs v4 tergolong besar dalam tolok ukur, dan Demucs memperoleh skor lebih tinggi pada setiap stem, terutama drum dan vokal.
Anda dapat mendengar perbedaannya dalam video perbandingan di bawah. Stem Demucs terdengar lebih alami dengan lebih sedikit artefak, sedangkan Spleeter dapat menghasilkan denging metalik pada materi yang kompleks.

Dampak performa dalam penggunaan nyata
Kecepatan: Spleeter memproses lagu berdurasi 3 menit dalam sekitar 2 detik pada GPU. Demucs v4 membutuhkan sekitar 20 hingga 30 detik. Pada CPU, Spleeter membutuhkan sekitar 30 hingga 60 detik, sedangkan Demucs dapat membutuhkan lebih dari 5 menit.
Perangkat keras: Spleeter berjalan hanya dengan CPU pada laptop ber-RAM 8 GB. Demucs v4 membutuhkan GPU dengan VRAM 4 hingga 8 GB untuk kecepatan yang memadai, dan lapisan Transformernya memakai jauh lebih banyak memori karena matriks perhatian.
Artefak: Karena Spleeter menggunakan kembali fase campuran, vokalnya dapat terdengar "seperti bayangan" dan transiennya kabur. Demucs v4 terdengar lebih alami, tetapi dapat menyisakan derau tingkat rendah pada bagian yang hening.
Ketangguhan: Kompetisi SDX'23 menunjukkan bahwa arsitektur bergaya Demucs lebih tahan terhadap data pelatihan yang rusak. Arsitektur Spleeter yang lebih sederhana sulit memanfaatkan teknik seperti dataset tersaring dan pemangkasan nilai fungsi kerugian.
Spleeter atau Demucs: mana yang sebaiknya Anda gunakan?
Banyak produser menggunakan keduanya, bergantung pada pekerjaannya.
Kapan menggunakan Spleeter?
Gunakan Spleeter ketika kecepatan penting: membuat a cappella cepat untuk set DJ, lagu karaoke untuk berlatih, atau memproses seluruh pustaka sampel sekaligus. Kecepatan pemrosesannya yang mencapai 100 kali kecepatan waktu nyata dan kebutuhan perangkat kerasnya yang sederhana sulit ditandingi. Kualitasnya memadai untuk remix yang stem-nya akan Anda proses lebih lanjut.
Kapan menggunakan Demucs?
Pilih Demucs v4 ketika artefak tidak dapat diterima: stem untuk remix resmi, sampel untuk rilisan komersial, atau analisis mendetail suatu penampilan. Peningkatan kualitas 3 dB dan koherensi fase sepadan dengan waktu tunggunya. Jika materi Anda berasal dari genre tertentu, lakukan pelatihan lanjutan dengan data tambahan, karena arsitektur Demucs lebih mampu memanfaatkan data bersih.
Menggabungkan Spleeter dan Demucs
Jalankan Spleeter pada seluruh katalog untuk menemukan lagu yang menjanjikan, lalu proses pilihan akhirnya dengan Demucs. Untuk penampilan langsung, pisahkan stem terlebih dahulu dengan Spleeter. Untuk pekerjaan studio, gunakan Demucs demi stem yang paling bersih. Alat seperti Ultimate Vocal Remover mengemas Demucs bersama model pemisahan lain dalam antarmuka grafis sederhana.
Apakah Anda membutuhkan GPU?
Spleeter berjalan baik pada CPU, sedangkan GPU dianjurkan agar pemrosesan Demucs berkualitas tinggi tidak memakan waktu terlalu lama. Untuk pemrosesan sekaligus tanpa koneksi atau pada laptop, model bergaya Spleeter tetap berguna. Untuk stem yang lebih bersih, Demucs dan model Transformer hibrida yang lebih baru biasanya sepadan dengan pemrosesan awan atau mesin lokal yang lebih kuat.
Pembaruan 2026: model yang mengungguli Spleeter dan Demucs
Spleeter dan Demucs masih menjadi acuan yang berguna, tetapi bukan lagi batas tertinggi kualitas pemisahan stem.
BS-RoFormer (Band-Split RoPE Transformer) membagi spektrogram menjadi pita frekuensi dan memodelkannya dengan lapisan Transformer. Makalahnya melaporkan SDR rata-rata 9,80 dB pada MUSDB18-HQ tanpa data pelatihan tambahan, lebih tinggi daripada 9,0 dB yang dicapai Demucs v4 dengan pelatihan lanjutan menggunakan 800 lagu tambahan. Versi yang dilatih dengan 500 lagu tambahan meraih peringkat pertama pada kategori pemisahan musik di Sound Demixing Challenge 2023.
| Model | Tahun | SDR keseluruhan (MUSDB18) | Data pelatihan tambahan |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25 ribu lagu |
| HT Demucs dengan pelatihan lanjutan (v4) | 2022 | 9,0 dB | 800 lagu |
| BS-RoFormer | 2023 | 9,8 dB | Tidak ada |
Mel-Band RoFormer adalah kerabat dekatnya yang mengelompokkan frekuensi pada skala mel. Checkpoint komunitas dari kedua model kini mendukung sebagian besar pemisah vokal dan instrumental kelas atas. Perbandingan model pemisah vokal kami memeringkatkannya berdasarkan lagu nyata, dan perbandingan model pemisah instrumen melakukan hal yang sama untuk instrumen lain.
Pemisah stem AI Neural Analog menggunakan model BS-RoFormer untuk preset 4 stem dan 6 stem, serta SAM Audio saat Anda ingin mengekstrak instrumen yang tidak tercakup dalam preset, seperti saksofon atau lead synth. Lihat model yang digunakan Neural Analog untuk pemisahan stem untuk daftar lengkapnya.
FAQ Spleeter versus Demucs
Apakah Demucs lebih baik daripada Spleeter?
Ya, dari segi kualitas. Demucs v4 memperoleh SDR sekitar 3 dB lebih tinggi daripada Spleeter pada tolok ukur MUSDB18, dengan lebih sedikit artefak pada vokal dan drum. Spleeter hanya lebih baik ketika kecepatan atau mesin yang hanya memiliki CPU lebih penting daripada kualitas.
Mana yang lebih baik untuk vokal, Spleeter atau Demucs?
Demucs. Vokal Spleeter sering terdengar tipis atau "seperti dari dalam air" karena menggunakan kembali fase campuran asli. Untuk vokal dan instrumental yang paling bersih, model BS-RoFormer atau Mel-Band RoFormer biasanya mengungguli keduanya.
Apakah Spleeter masih dipelihara?
Spleeter masih tersedia di GitHub, tetapi merupakan model tahun 2019 yang dibangun dengan TensorFlow. README-nya memperingatkan masalah TensorFlow pada cip Apple M1. Sebagian besar alat baru telah beralih ke Demucs atau model RoFormer.
Model apa yang digunakan Ultimate Vocal Remover (UVR)?
UVR adalah aplikasi desktop gratis, bukan satu model. Aplikasi ini mengemas beberapa keluarga model, termasuk Demucs, MDX-Net, dan model VR Architecture-nya sendiri. Jadi, kualitasnya bergantung pada model yang Anda pilih.
Bisakah Anda menggunakan Demucs tanpa GPU?
Bisa, tetapi lambat. Perkirakan beberapa menit per lagu pada CPU. Pemisah stem daring menjalankan model pada GPU server sebagai gantinya. Panduan Studio untuk memisahkan stem menjelaskan langkah-langkahnya.
Panduan terkait
- Hapus drum dari lagu Suno: penerapan praktis pemisahan stem drum.
- Ganti drum AI dengan kit Anda sendiri: pisahkan drum, lalu bangun groove baru di sekitar vokal.
- Restorasi stem MP3 ke kualitas WAV: rekonstruksi frekuensi tinggi yang hilang akibat kompresi dan pemisahan.
- Konversi lagu stereo ke Dolby Atmos: tempatkan stem terpisah dalam campuran Atmos.
- Instal dan jalankan AudioSR dari GitHub: model audio sumber terbuka lain untuk dijalankan secara lokal, dengan pengaturan Python dan PyTorch.