Panduan Instal AudioSR dari GitHub: Menjalankan AudioSR Secara Lokal
AudioSR adalah model superresolusi audio sumber terbuka. Model ini menghasilkan detail frekuensi tinggi yang hilang pada ucapan, musik, dan efek suara untuk menghasilkan audio dengan laju pengambilan sampel 48 kHz. Anda dapat menginstalnya dari repositori GitHub resmi atau menjalankan AudioSR online dengan Neural Analog.
Untuk instalasi lokal, klon repositorinya, buat lingkungan Python 3.10 dengan uv, instal versi PyTorch yang kompatibel dan AudioSR, lalu jalankan python -m audiosr pada WAV pendek. Langkah berikut menjelaskan setiap perintahnya.
Bagaimana AudioSR Bekerja? Penjelasan Arsitektur
Cara AudioSR Merekonstruksi Frekuensi Tinggi yang Hilang
Spektrogram mel masukan mengondisikan difusi laten untuk memperkirakan spektrogram mel dengan rentang frekuensi yang lebih lebar. Pita mel rendah dari masukan menggantikan pita yang dihasilkan sebelum vocoder; pita STFT rendahnya menggantikan pita yang dihasilkan setelah vocoder. Model menghasilkan detail hilang yang masuk akal, bukan memulihkan salinan persis rekaman yang telah hilang.
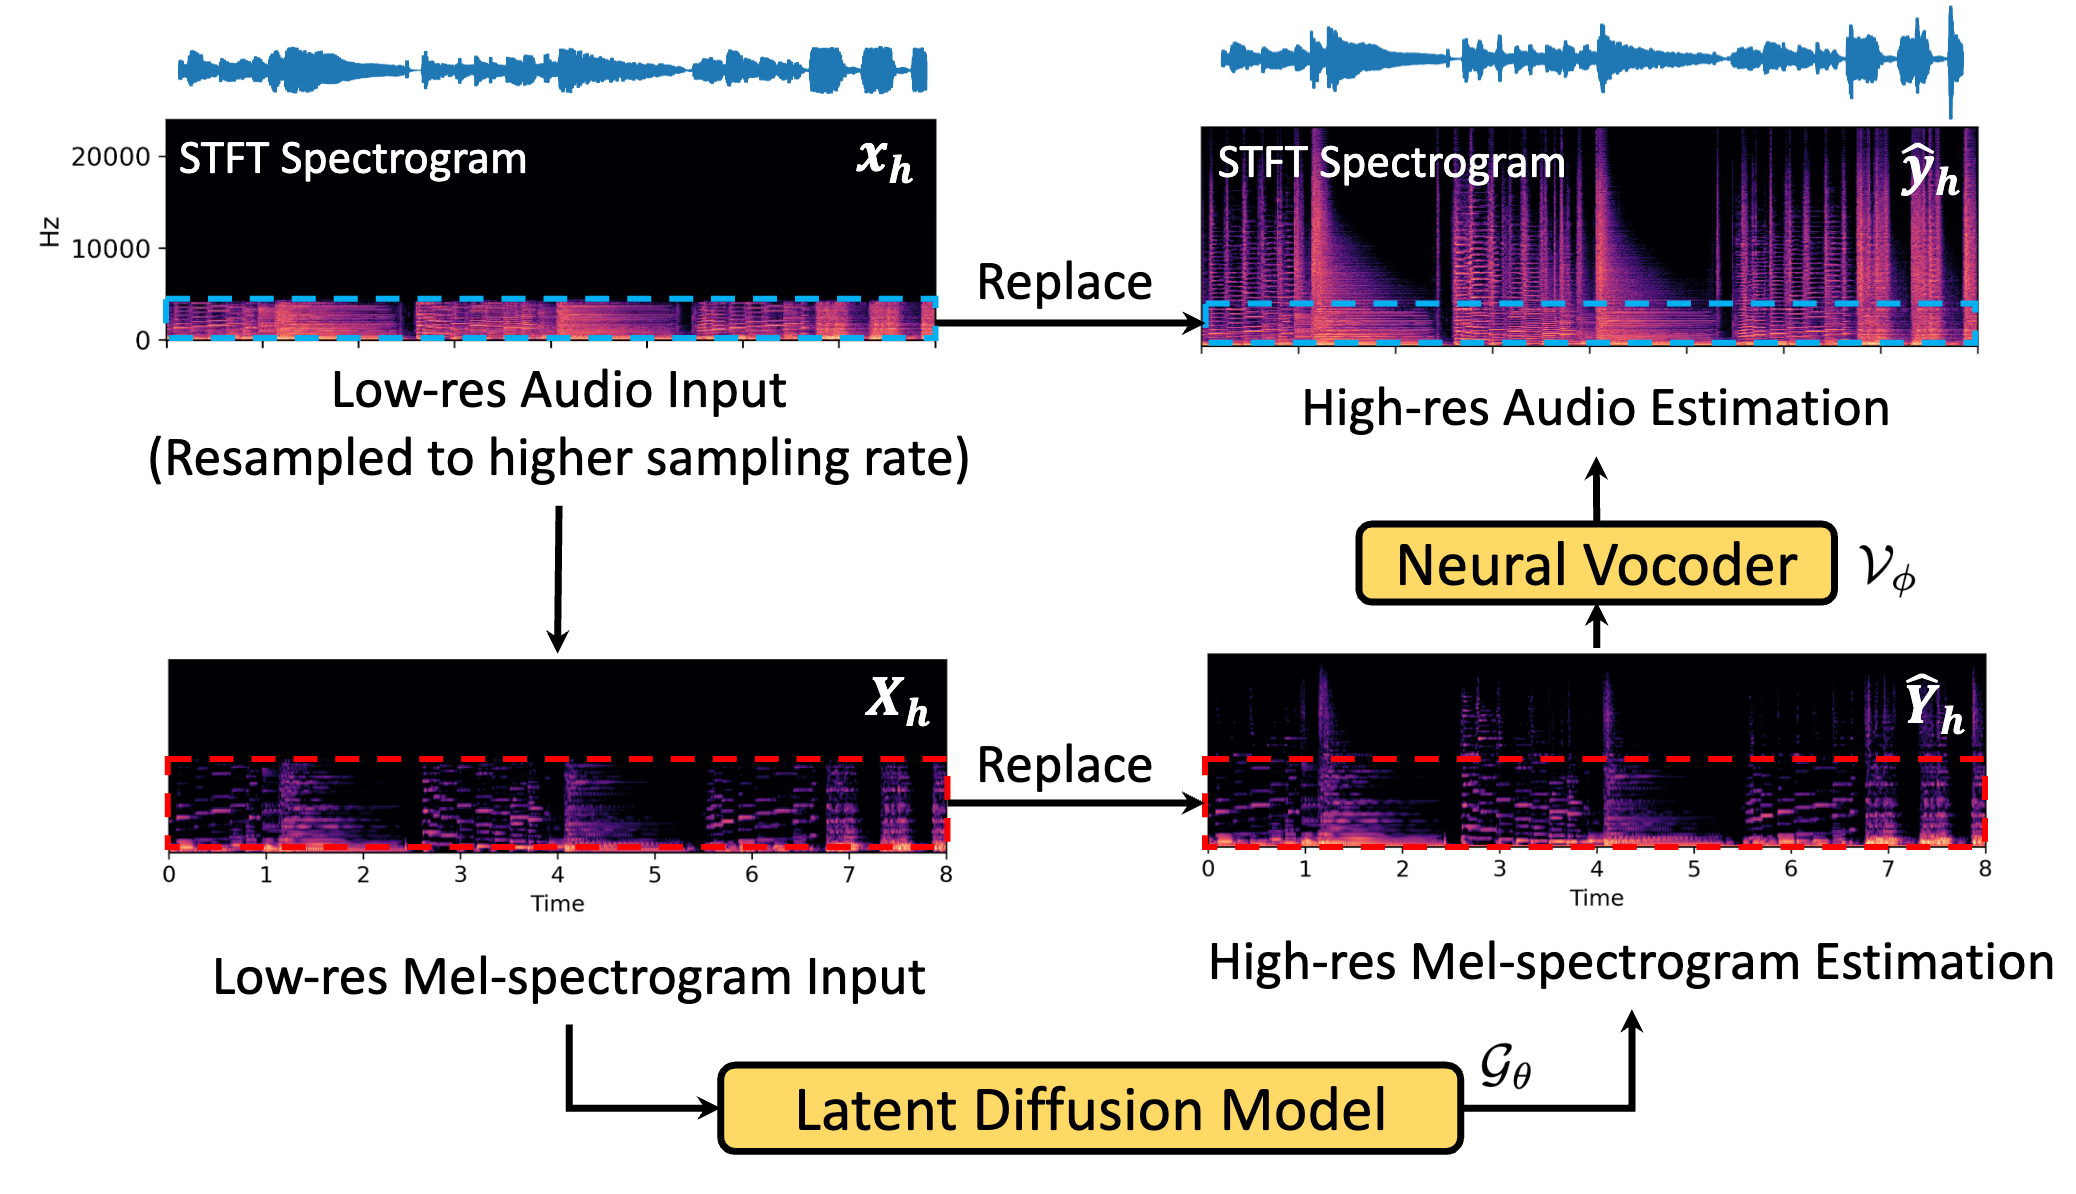
Diagram asli: AudioSR.
AudioSR mengubah rekaman menjadi spektrogram mel, menggunakan model difusi laten untuk memperkirakan detail frekuensi tinggi yang hilang, lalu mengubah hasilnya kembali menjadi bentuk gelombang dengan vocoder. Pascapemrosesan kemudian mengembalikan frekuensi rendah asli dari sumber untuk menggantikan frekuensi yang dihasilkan. Hasilnya merupakan rekonstruksi yang masuk akal, bukan pemulihan persis audio yang hilang, dan bukan sekadar penambahan derau.
Di Mana Anda Bisa Menjalankan AudioSR?
| Opsi | Paling sesuai untuk | Penyiapan dan konsekuensinya |
|---|---|---|
| Neural Analog AudioSR Online (disarankan) | Restorasi stereo dengan pemrosesan sinyal tengah dan selisih dan frekuensi batas yang dapat disesuaikan | Unggah, dengarkan pratinjau, dan ekspor secara online. Tidak perlu instalasi Python atau GPU lokal. |
| Repositori GitHub resmi | Eksperimen lokal dan skrip Python | Instal dependensi, unduh bobot, dan sediakan sumber daya komputasi. |
| Notebook AudioSR Colab | Eksperimen dengan GPU cloud Google | Buka notebook komunitas dan ikuti petunjuknya di browser. |
| Hugging Face Space | Demo singkat di browser | Dikelola komunitas; ketersediaan dan kuota GPU dapat berubah. |
| AudioSR di Replicate | Prediksi yang dihosting dan integrasi API | Tagihan berdasarkan penggunaan; tanpa instalasi model lokal. |
Neural Analog memproses sinyal tengah dan selisih pada audio stereo secara terpisah. Anda juga dapat mengatur frekuensi batas (cutoff) tempat AudioSR mulai menghasilkan ulang detail. Batas yang lebih rendah mengubah lebih banyak bagian suara, sedangkan batas yang lebih tinggi hanya mengisi bagian frekuensi teratas.
Persyaratan AudioSR: Python, Memori GPU, dan Ruang Penyimpanan
AudioSR merupakan model berat, terutama untuk lagu penuh. Checkpoint dasar resmi berukuran sekitar 6,2 GB di penyimpanan, dan inferensi membutuhkan lebih banyak memori daripada bobot yang tersimpan. GPU NVIDIA besar membantu, tetapi ukuran checkpoint bukan angka minimum VRAM: panjang klip dan implementasi juga memengaruhi penggunaan memori. README resmi tidak mencantumkan persyaratan GPU minimum.
Input panjang dapat menghabiskan memori GPU. Mulailah dengan klip pendek, lalu proses rekaman yang lebih panjang dalam potongan kecil.
Siapkan dependensi berikut sebelum memulai:
- Python dalam lingkungan terisolasi. Contoh dari proyek asli menggunakan Python 3.9. Panduan ini menggunakan Python 3.10, yang kompatibel dengan versi NumPy lama yang dibutuhkan AudioSR. Lingkungan virtual memisahkan paket ini dari Python sistem.
- Git dan uv. Instal Git dan uv untuk mengunduh kode sumber dan mengelola lingkungan Python.
- PyTorch dan driver GPU yang sesuai. Pengguna NVIDIA membutuhkan build PyTorch yang kompatibel dengan CUDA. Cocokkan versi PyTorch, TorchAudio, dan TorchVision melalui matriks instalasi resmi.
- FFmpeg, termasuk ffprobe. Kode penyimpanan file dari proyek asli menggunakan perintah ini. Instal melalui opsi unduhan FFmpeg dan pastikan perintahnya tersedia di terminal.
- Ruang penyimpanan kosong dan koneksi internet. Sediakan ruang untuk lingkungan, bobot model yang diunduh, file input, dan output. Pemuatan model pertama akan mengunduh checkpoint.
Kode pemilihan perangkat dari proyek asli mengenali CUDA, Apple MPS, dan CPU. Pemrosesan CPU bisa sangat lambat. Dukungan MPS dalam pemeriksaan perangkat tidak menjamin setiap dependensi dan operasi bekerja pada setiap Mac.
Cara Menginstal AudioSR dari GitHub
1. Unduh Repositori Resmi dan Buat Lingkungan Python
Jalankan perintah berikut di terminal:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Aktifkan lingkungan di Linux atau macOS:
source .venv/bin/activateDi Windows PowerShell, gunakan perintah aktivasi berikut:
.venv\Scripts\Activate.ps12. Instal Dependensi yang Kompatibel dan AudioSR
AudioSR memiliki batasan dependensi lama, termasuk NumPy 1.23.5 atau lebih lama dan Transformers 4.30.2. Memasang versi Python dan PyTorch terbaru dapat menyebabkan masalah kompatibilitas. Persyaratan paket dan lingkungan referensi proyek dapat menjadi titik awal yang berguna.
Sebagai contoh, lingkungan referensi memasangkan PyTorch 2.0.1, TorchAudio 2.0.2, dan TorchVision 0.15.2. Di Linux atau Windows dengan driver NVIDIA yang sesuai, instal kombinasi CUDA 11.7 tersebut, lalu kode sumber AudioSR yang sudah Anda klon:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
Perintah CUDA ditujukan untuk sistem NVIDIA. Untuk perangkat lain, gunakan petunjuk macOS atau CPU yang sesuai dalam matriks PyTorch. Ini merupakan versi dependensi lama, jadi pisahkan lingkungan ini dari proyek Python lainnya.
Jika Anda hanya memerlukan paket yang telah diterbitkan, README resmi juga menjelaskan audiosr==0.0.7. Rilis itu dan branch main GitHub saat ini mungkin memiliki fitur berbeda, jadi periksa python -m audiosr --help untuk versi yang Anda instal.
3. Pastikan Python Mengenali GPU Anda
Jalankan pemeriksaan ini dalam lingkungan yang sudah diaktifkan pada mesin NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Jika CUDA tidak tersedia, perbaiki driver atau instalasi PyTorch sebelum memulai pekerjaan panjang. Menambahkan -d cuda ke AudioSR tidak bisa membuat GPU yang tidak tersedia menjadi berfungsi.
Penggunaan AudioSR di Terminal: Mulai dengan WAV Pendek
Gunakan WAV mono pendek untuk percobaan pertama. Pemuat audio proyek asli menyarankan input 5,12 detik dan memperingatkan soal kualitas di atas 10,24 detik. Lagu penuh membuat masalah penyiapan dan memori lebih sulit didiagnosis.
Tempatkan input.wav di direktori repositori, lalu jalankan:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42Implementasi baris perintah menyimpan WAV 48 kHz dalam folder bertanda waktu di bawah output. Gunakan basic untuk audio umum atau speech untuk rekaman ucapan. Nilai awal generator acak (seed) mengatur variasi hasil; membandingkan beberapa nilai awal dapat membantu Anda memilih hasil yang lebih baik.
Jika generasi selesai tetapi penyimpanan memunculkan numpy.ndarray has no attribute cpu, gunakan contoh Python di bawah untuk menulis output langsung. Dalam kode GitHub yang diperiksa untuk panduan ini, inferensi mengembalikan array NumPy tetapi fungsi penyimpanan file mengharapkan tensor. Ini merupakan ketidakcocokan tipe output dalam proyek asli, bukan kesalahan memori GPU.
Kode GitHub saat ini juga menyediakan pemrosesan per potongan untuk file yang lebih panjang:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Pemrosesan per potongan menangani bagian lebih kecil dan mencampur bagian yang saling tumpang tindih. Cara ini mengurangi penggunaan memori, tetapi menambahkan sambungan yang perlu Anda periksa dengan mendengarkan. Flag ini bergantung pada versi, dan jalur pemrosesan per potongan proyek asli mencampur input stereo menjadi mono, jadi simpan file stereo aslinya.
Cara Menggunakan AudioSR dari Python
Gunakan API Python untuk memanggil AudioSR dari skrip Anda sendiri. Contoh berikut menjalankan file mono pendek, memangkas padding agar sesuai dengan durasi input, dan menulis WAV 48 kHz. Simpan sebagai run_audiosr.py dalam direktori repositori.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPipeline Python memuat model sekali, sehingga skrip pemrosesan batch dapat memakainya kembali. Di Neural Analog, pemrosesan batch menjalankan satu restorasi pada banyak file tanpa skrip. Tetapkan jumlah langkah sampling secara eksplisit, karena API Python dan CLI mungkin memiliki nilai bawaan berbeda.
Cara Menjalankan AudioSR di Google Colab
Google Colab memungkinkan Anda menjalankan AudioSR pada perangkat cloud Google. Buka notebook komunitas AudioSR Colab dan ikuti petunjuk untuk memuat audio, menjalankan model, dan menyimpan hasil. Notebook berjalan di browser, jadi komputer Anda tidak memerlukan instalasi Python atau GPU.
Notebook tersebut merupakan adaptasi AudioSR dari komunitas. Kode sumbernya tersedia di GitHub.
Di Mana Anda Bisa Mengunduh Bobot Model AudioSR?
Unduh bobot model AudioSR di Hugging Face.
Detail Model AudioSR: Arsitektur, Pelatihan, dan Sejarah
Siapa yang Membuat AudioSR?
AudioSR adalah model superresolusi audio generatif karya Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang, dan Mark D. Plumbley. Model ini memperkirakan frekuensi tinggi yang hilang pada ucapan, musik, dan efek suara serta menghasilkan audio dengan laju pengambilan sampel 48 kHz. Halaman riset AudioSR memuat makalah dan contoh untuk didengarkan. Karya tersebut pertama kali muncul sebagai prapublikasi September 2023 dan diterbitkan di ICASSP 2024.
AudioSR menghasilkan detail yang masuk akal. Model ini tidak bisa memulihkan salinan persis master studio yang hilang. Mengonversi MP3 menjadi WAV 48 kHz sama sekali tidak melakukan rekonstruksi itu. Untuk memahami perbedaannya, lihat panduan meningkatkan resolusi MP3 menjadi WAV.
Peningkatan Resolusi Audio, Pengambilan Sampel Ulang, dan Lebar Pita Berbeda
Pengambilan sampel ulang (resampling) mengubah jumlah sampel yang mewakili tiap detik audio. Peningkatan resolusi audio, atau superresolusi, mencoba memperkirakan kandungan frekuensi yang tidak lagi ada dalam rekaman. Misalnya, mengambil sampel ulang rekaman 8 kHz menjadi 48 kHz menambah jumlah sampel, tetapi tidak dengan sendirinya memulihkan suara di atas batas frekuensi asli 4 kHz.
AudioSR menargetkan lebar pita input 2 hingga 16 kHz dan menghasilkan output dengan lebar pita 24 kHz pada laju pengambilan sampel 48 kHz, menurut deskripsi proyek resmi. Lebar pita menggambarkan rentang frekuensi; laju pengambilan sampel menggambarkan jumlah sampel per detik. File berlabel 48 kHz masih bisa memiliki lebar pita sempit akibat kompresi atau penyaringan sebelumnya. Banyak lagu buatan AI seperti ini, sehingga lagu Suno sering terdengar teredam.
Apakah AudioSR Model Peningkatan Resolusi Audio Pertama?
AudioSR bukan peningkat resolusi audio neural pertama. Kuleshov, Enam, dan Ermon menerbitkan Superresolusi Audio Menggunakan Jaringan Neural pada 2017, dan peningkatan resolusi ucapan berbasis difusi juga sudah ada sebelum AudioSR.
Kontribusinya lebih khusus. Makalah AudioSR memperkenalkannya sebagai sistem pertama yang mencakup ranah umum audio yang dapat didengar: musik, ucapan, dan efek suara. Model ini menggabungkan cakupan tersebut dengan lebar pita input yang fleksibel, bukan memperkenalkan superresolusi audio itu sendiri.
Dari Rekaman Input ke Bentuk Gelombang 48 kHz
AudioSR menggabungkan autoencoder variasional (VAE), model difusi laten bersyarat, dan vocoder neural. Setiap komponen menangani satu tahap rekonstruksi:
| Tahap | Yang terjadi | Mengapa penting |
|---|---|---|
| Representasi audio | Input menjadi spektrogram mel: peta energi suara sepanjang waktu dan frekuensi. | Model bekerja dengan pola kandungan frekuensi. |
| Pengodean VAE | Encoder memampatkan spektrogram menjadi representasi lebih kecil yang disebut laten. | Difusi bekerja pada lebih sedikit nilai daripada spektrogram penuh. |
| Difusi bersyarat | Transformer U-Net memperbaiki laten berderau secara berulang, dengan panduan laten input beresolusi rendah. | Rekaman memandu detail yang dihasilkan; tidak diperlukan prompt teks. |
| Decoding dan vocoder | VAE mendekode spektrogram mel beresolusi lebih tinggi. Vocoder berbasis HiFi-GAN mengubahnya menjadi bentuk gelombang. | Spektrogram harus diubah kembali menjadi sampel yang bisa didengar. |
| Penggantian frekuensi | Informasi frekuensi rendah dari input menggantikan pita hasil generasi yang sesuai. | Informasi yang sudah ada membantu membatasi perubahan pada rekaman. |
Konfigurasi model yang diterbitkan menetapkan representasi mel dengan 256 pita, VAE, dan U-Net dengan transformer spasial. Konfigurasi ini menggabungkan fitur input yang telah difilter lolos rendah dan dikodekan dengan laten difusi. Generasi dikondisikan oleh audio, meskipun beberapa deskripsi CLI yang diwarisi menyebut teks.
Apa yang Dikontrol Langkah Sampling dan Kekuatan Panduan?
Langkah sampling mengatur jumlah iterasi yang digunakan model untuk memperbaiki representasi hasil generasi. AudioSR menggunakan sampler DDIM. Kekuatan panduan mengatur seberapa kuat kondisi input mengarahkan generasi. Nilainya bukan besaran EQ, dan angka lebih tinggi tidak menjamin kualitas lebih tinggi. Implementasi inferensi menjalankan sampling, decoding, penggantian frekuensi, dan normalisasi bentuk gelombang secara berurutan.
Lebih banyak langkah sampling dan rekaman lebih panjang memerlukan waktu pemrosesan lebih lama. AudioSR ditujukan untuk pemrosesan di luar waktu nyata, dan kecepatan sebenarnya bergantung pada GPU serta pengaturan. Mengurangi ddim_steps mempercepat generasi, tetapi tidak secara andal mengatasi kesalahan memori GPU.
Bagaimana AudioSR Dilatih?
Bagian pelatihan dalam makalah menjelaskan sekitar 7.000 jam dari MUSDB18-HQ, MoisesDB, MedleyDB, Freesound, dan data ucapan OpenSLR. Filter lolos rendah dengan frekuensi batas bervariasi menghasilkan input terdegradasi yang dipasangkan dengan target yang memiliki lebar pita lebih luas. Model difusi menggunakan jadwal derau kosinus, prediksi kecepatan, dan panduan tanpa pengklasifikasi. Vocoder berbasis HiFi-GAN dengan diskriminator multiresolusi.
Rekaman nyata dapat berbeda dari contoh pelatihan ini. Penulis menjelaskan bahwa batas frekuensi yang tidak teratur, derau berat, dan reverb dapat mengurangi kualitas. Kompresi MP3 dapat meninggalkan celah di dekat frekuensi batas. Penyaringan lolos rendah sebelum inferensi dapat membantu, tetapi batas yang terlalu rendah menghilangkan detail berguna. Untuk rekaman dengan reverb, menghapus reverb sebelum peningkatan resolusi dapat memberi model input yang lebih bersih.
Anda tidak perlu melatih komponen ini untuk menjalankan AudioSR. Alur instalasi memuat bobot yang sudah dilatih.
Mengapa AudioSR Menggunakan Pascapemrosesan?
Audio yang dihasilkan perlu mempertahankan informasi berguna yang sudah ada dalam sumber. AudioSR mengganti pita rendah dua kali: pada spektrogram mel perkiraan sebelum vocoder, dan pada representasi transformasi Fourier waktu singkat (STFT) dari bentuk gelombang hasilnya. Kode penggantian memperkirakan frekuensi batas dan menyesuaikan output rekonstruksi.
Rekaman stereo dan lagu penuh memerlukan pipeline yang menangani kanal, potongan, dan rekonstruksi. Alur bawaan repositori menghasilkan audio mono: pemuat standar mengambil kanal input pertama, sedangkan pipeline per potongan mencampur stereo menjadi mono. Mempertahankan stereo membutuhkan penanganan kanal tambahan, misalnya pemrosesan kanal kiri dan kanan secara terpisah dalam notebook komunitas.
Rekonstruksi perlu diperiksa dengan mendengarkan. Catatan pipeline komunitas memperingatkan bahwa overlap berlebihan dapat menyebabkan pembatalan fase. Bandingkan hasil pada tingkat kelantangan yang serupa dan periksa frekuensi tinggi yang dihasilkan ulang, sambungan potongan, durasi, dan citra stereo. Penggantian frekuensi membantu mempertahankan sumber, tetapi tidak menjamin pita rendah tidak berubah atau sambungan bersih.
Pertanyaan Umum tentang Masalah AudioSR
Apakah AudioSR Tersedia di PyPI?
Ya. README resmi menjelaskan instalasi audiosr==0.0.7 dengan pip, atau kode terbaru langsung dari GitHub. Branch main GitHub memiliki fitur seperti pemrosesan per potongan yang mungkin belum ada dalam rilis PyPI.
Berapa Memori GPU yang Dibutuhkan AudioSR?
README tidak menyebutkan batas minimum. Checkpoint dasar saja berukuran sekitar 6,2 GB di penyimpanan, dan penggunaan memori bertambah seiring panjang klip. Mulailah dengan klip sekitar 5 detik, lalu gunakan pemrosesan per potongan untuk file lebih panjang.
Mengapa AudioSR Gagal dengan numpy.ndarray has no attribute cpu?
Inferensi sudah selesai, tetapi tahap penyimpanan mengharapkan tensor PyTorch dan menerima array NumPy. Gunakan skrip Python di atas, yang menulis output dengan soundfile.
Mengapa Output AudioSR Saya Mono?
Pemuat bawaan hanya membaca kanal pertama, dan jalur per potongan mencampur stereo menjadi mono. Proses kanal kiri dan kanan secara terpisah, atau gunakan AudioSR Online, yang memproses sinyal tengah dan selisih untuk Anda.
Apakah Kode Pelatihan AudioSR Tersedia?
Ya. Changelog README tanggal 31 Desember 2024 menautkan kode pelatihan, yang dijelaskan penulis sebagai referensi saja dan belum ditata dengan teliti.
Jalankan AudioSR dengan Neural Analog Tanpa Mengelola Instalasi
Untuk melewati penyiapan lokal, buka AudioSR Online, unggah file atau impor tautan musik yang didukung, lalu sesuaikan pengaturan restorasi. Untuk Udio, simpan atau rekam audionya terlebih dahulu, kemudian unggah file. Anda dapat memilih frekuensi batas, mendengarkan pratinjau hasil yang diproses, dan mengekspor audio dari antarmuka yang sama.
Neural Analog menangani pemrosesan model secara online, sehingga Anda dapat menggunakan komputer tanpa GPU besar dan melewati instalasi Python, unduhan checkpoint, serta pemeliharaan notebook. Anda tetap perlu mendengarkan dengan kritis, karena alur yang dihosting tidak menghilangkan keterbatasan kualitas model. Setelah restorasi, ikuti panduan peningkatan audio untuk langkah berikutnya. Untuk musik buatan AI, memperbaiki kualitas audio lagu AI membahas perbaikan stem dan mastering setelah peningkatan resolusi.
Anda juga dapat membandingkan AudioSR dengan model peningkatan resolusi audio lebih baru di Neural Analog, termasuk UniverSR dan FlashSR. Kartu modelnya menjelaskan cara kerja tiap model, dan FAQ merangkum perbedaan UniverSR dengan AudioSR. Untuk contoh lengkap, lihat seluruh 203 efek suara RPG Maker 2000 yang direstorasi ke 48 kHz dengan UniverSR. Jalankan model pada rekaman yang sama dan bandingkan pratinjau untuk memilih hasil terbaik.