Instalar AudioSR desde GitHub: cómo ejecutarlo en tu equipo
AudioSR es un modelo de superresolución de audio de código abierto. Genera los detalles de alta frecuencia que faltan en voz, música y efectos de sonido para producir audio a 48 kHz. Puedes instalarlo desde el repositorio oficial de GitHub o usar AudioSR en línea con Neural Analog.
Para instalarlo en tu equipo, clona el repositorio, crea un entorno Python 3.10 con uv, instala una versión compatible de PyTorch y AudioSR y ejecuta python -m audiosr sobre un archivo WAV corto. Los pasos siguientes explican cada comando.
¿Cómo funciona AudioSR? Su arquitectura explicada
Cómo AudioSR reconstruye las frecuencias altas que faltan
El espectrograma mel de entrada condiciona la difusión latente para estimar un espectrograma mel con un ancho de banda mayor. Las bandas mel bajas de la entrada sustituyen a las generadas antes del vocoder; sus bandas STFT bajas sustituyen a las generadas después del vocoder. El modelo genera detalles ausentes plausibles, sin recuperar una copia exacta de una grabación perdida.
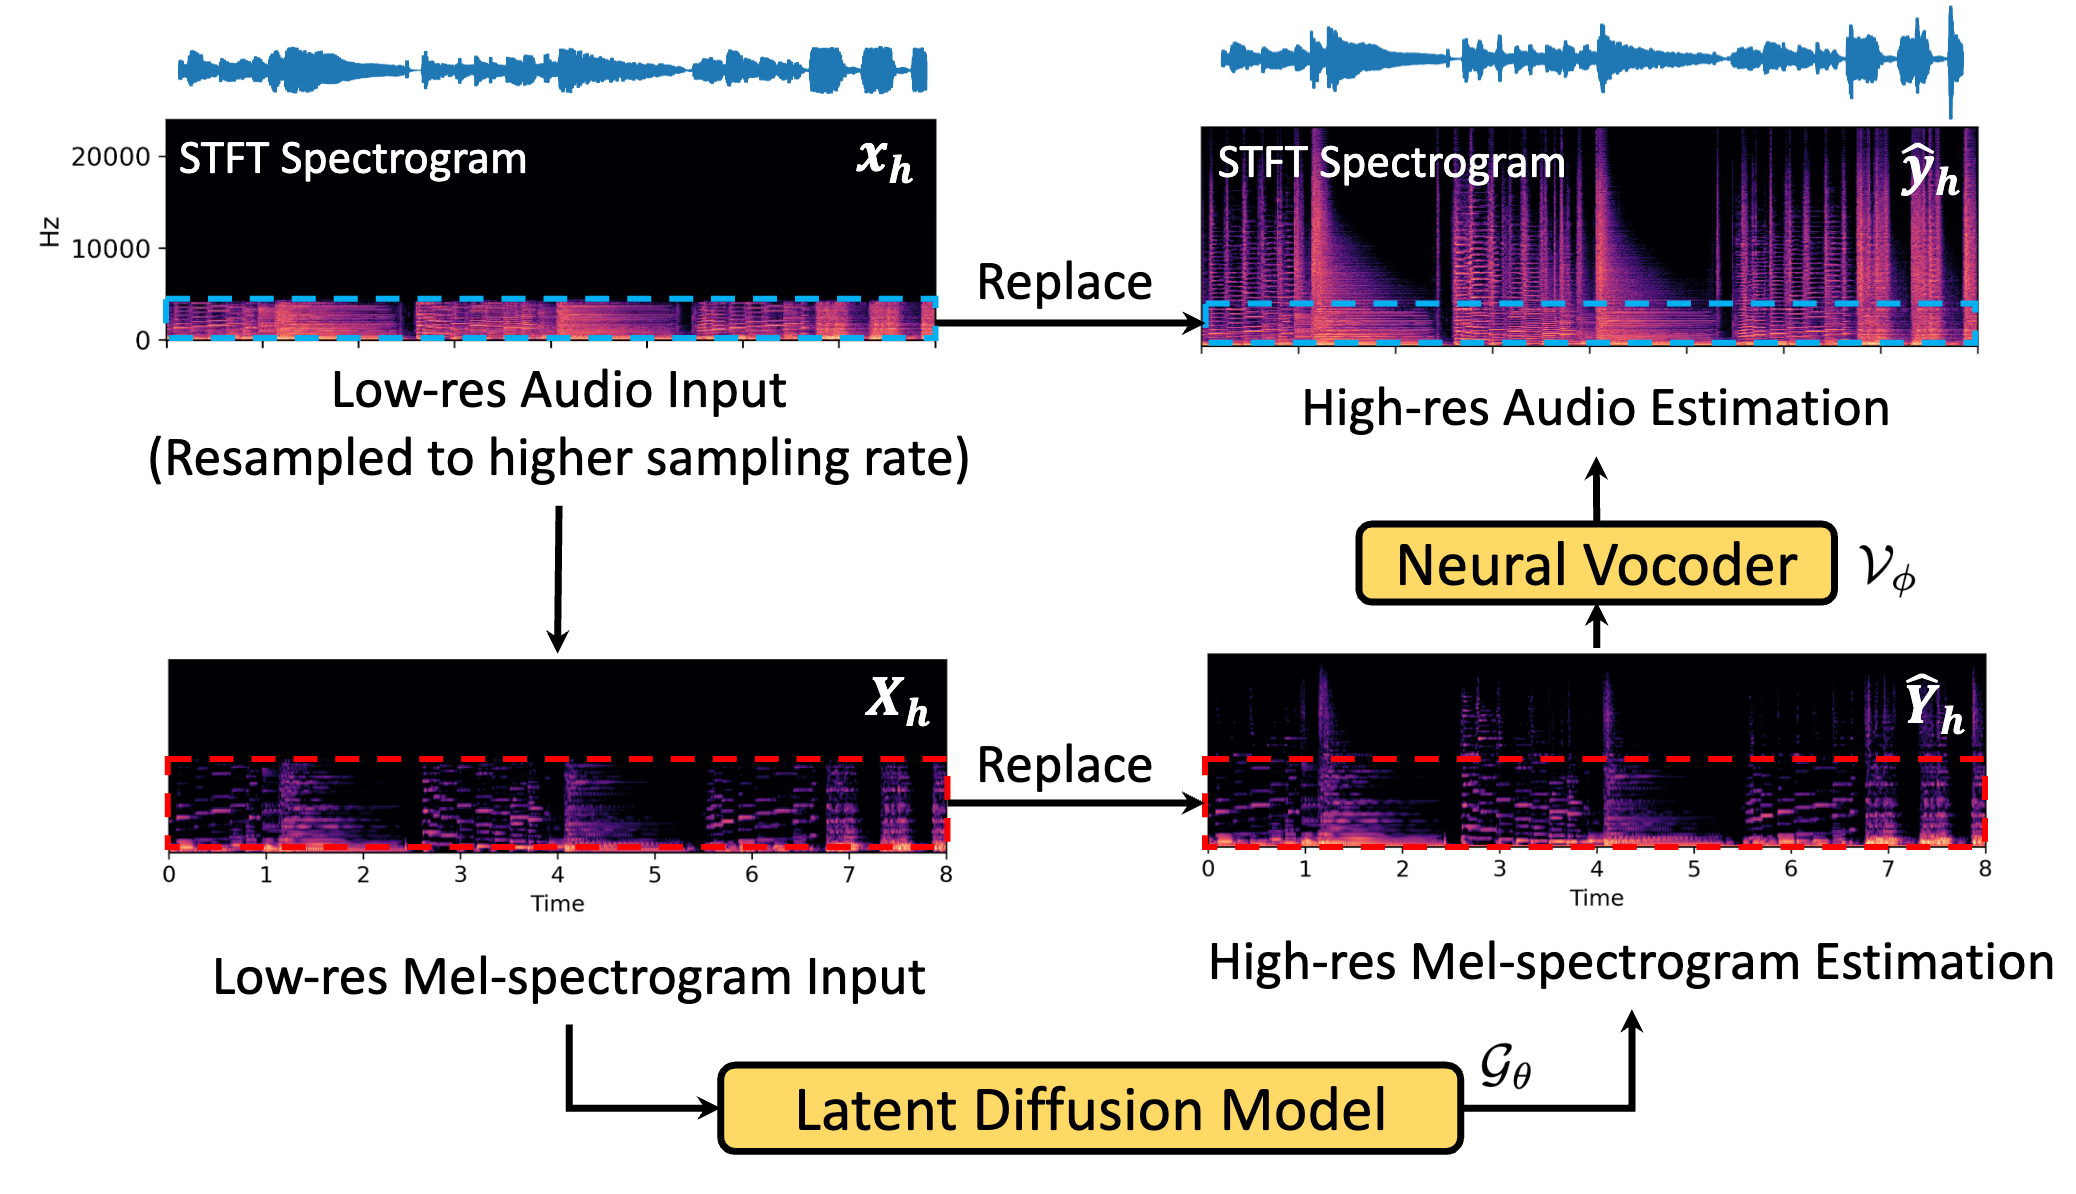
Figura original: AudioSR.
AudioSR convierte la grabación en un espectrograma mel, usa un modelo de difusión latente para estimar los detalles de alta frecuencia ausentes y transforma el resultado en una forma de onda con un vocoder. Después, el posprocesamiento vuelve a colocar las frecuencias bajas originales de la fuente en lugar de las generadas. El resultado es una reconstrucción plausible, no una recuperación exacta del audio perdido, y no consiste simplemente en añadir ruido.
¿Dónde puedes ejecutar AudioSR?
| Opción | Uso más adecuado | Instalación y compromisos |
|---|---|---|
| Neural Analog AudioSR en línea (recomendado) | Restauración estéreo con procesamiento centro/diferencia y frecuencia de corte ajustable | Sube, escucha una vista previa y exporta en línea. No necesitas instalar Python ni tener una GPU local. |
| Repositorio oficial de GitHub | Experimentos locales y scripts Python | Instala dependencias, descarga los pesos y aporta los recursos de cómputo. |
| Cuaderno AudioSR Colab | Experimentos con las GPU de Google en la nube | Abre el cuaderno de la comunidad y sigue sus instrucciones en el navegador. |
| Space de Hugging Face | Una demostración rápida en el navegador | Despliegue de la comunidad; la disponibilidad y las cuotas de GPU pueden cambiar. |
| AudioSR en Replicate | Predicciones alojadas e integración mediante API | Facturación por uso; sin instalación local del modelo. |
Neural Analog procesa por separado las señales de centro y diferencia del audio estéreo. También puedes fijar la frecuencia de corte a partir de la cual AudioSR regenera los detalles. Un corte más bajo modifica más el sonido, mientras que uno más alto solo completa el extremo agudo.
Requisitos de AudioSR: Python, memoria GPU y espacio en disco
AudioSR es un modelo pesado, sobre todo para canciones completas. El checkpoint básico oficial ocupa unos 6,2 GB en disco, y la inferencia necesita más memoria que los pesos almacenados. Una GPU NVIDIA con mucha memoria ayuda, pero el tamaño del checkpoint no equivale a una cantidad mínima de VRAM: la duración del fragmento y la implementación también afectan al consumo de memoria. El README oficial no publica un requisito mínimo de GPU.
Las entradas largas pueden agotar la memoria GPU. Empieza con un fragmento corto y después procesa las grabaciones más largas en segmentos pequeños.
Prepara estas dependencias antes de empezar:
- Python en un entorno aislado. El ejemplo del proyecto original usa Python 3.9. Esta guía usa Python 3.10, que funciona con las versiones antiguas de NumPy que AudioSR necesita. Un entorno virtual mantiene estos paquetes fuera del Python del sistema.
- Git y uv. Instala Git y uv para descargar el código y gestionar el entorno Python.
- PyTorch y un controlador GPU adecuado. Los usuarios de NVIDIA necesitan una versión de PyTorch compatible con CUDA. Haz coincidir las versiones de PyTorch, TorchAudio y TorchVision mediante la tabla oficial de instalación.
- FFmpeg, incluido ffprobe. El código original para guardar archivos usa estos comandos. Instálalos mediante las opciones de descarga de FFmpeg y asegúrate de que estén disponibles en el terminal.
- Espacio libre en disco y conexión a internet. Reserva espacio para el entorno, los pesos descargados, los archivos de entrada y las salidas. La primera carga del modelo descarga su checkpoint.
El código original de selección del dispositivo reconoce CUDA, Apple MPS y CPU. El procesamiento por CPU puede ser muy lento. Reconocer MPS al comprobar el dispositivo no garantiza que todas las dependencias y operaciones funcionen en todos los Mac.
Cómo instalar AudioSR desde GitHub
1. Descarga el repositorio oficial y crea un entorno Python
Ejecuta estos comandos en un terminal:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Activa el entorno en Linux o macOS:
source .venv/bin/activateEn Windows PowerShell, usa este comando de activación en su lugar:
.venv\Scripts\Activate.ps12. Instala dependencias compatibles y AudioSR
AudioSR tiene restricciones de dependencias antiguas, entre ellas NumPy 1.23.5 o anterior y Transformers 4.30.2. Instalar las versiones más recientes de Python y PyTorch puede causar errores de compatibilidad. Los requisitos del paquete y el entorno de referencia del proyecto son buenos puntos de partida.
Por ejemplo, el entorno de referencia combina PyTorch 2.0.1, TorchAudio 2.0.2 y TorchVision 0.15.2. En Linux o Windows con un controlador NVIDIA adecuado, instala esa combinación para CUDA 11.7 y después el código de AudioSR que has descargado:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
El comando CUDA es para sistemas NVIDIA. Para macOS o CPU, usa las instrucciones correspondientes de la tabla de PyTorch. Son versiones antiguas de las dependencias, así que mantén este entorno separado de otros proyectos Python.
Si solo necesitas el paquete publicado, el README oficial también documenta audiosr==0.0.7. Esa versión y la rama main actual de GitHub pueden tener funciones distintas, así que comprueba python -m audiosr --help para la versión que has instalado.
3. Comprueba que Python detecta tu GPU
Ejecuta esta comprobación dentro del entorno activado en un equipo NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Si CUDA no está disponible, corrige la instalación del controlador o de PyTorch antes de empezar un procesamiento largo. Añadir -d cuda a AudioSR no puede hacer funcionar una GPU no disponible.
AudioSR en la línea de comandos: empieza con un WAV corto
Usa un WAV mono corto en la primera ejecución. El cargador de audio original recomienda entradas de 5,12 segundos y advierte sobre la calidad más allá de 10,24 segundos. Una canción completa dificulta diagnosticar los problemas de instalación y memoria.
Coloca input.wav en el directorio del repositorio y ejecuta:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42La implementación de la línea de comandos guarda un WAV a 48 kHz en una carpeta con marca de tiempo dentro de output. Usa basic para audio general o speech para grabaciones habladas. La semilla controla las variaciones generadas; comparar varias semillas puede ayudarte a elegir un resultado mejor.
Si la generación termina pero al guardar aparece numpy.ndarray has no attribute cpu, usa el ejemplo Python siguiente para escribir directamente la salida. En el código de GitHub revisado para esta guía, la inferencia devuelve un array NumPy, pero la función de guardado espera un tensor. Es una incompatibilidad del tipo de salida en el proyecto original, no un error de memoria GPU.
El código actual de GitHub también ofrece procesamiento por segmentos para archivos más largos:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Este proceso trata secciones pequeñas y mezcla sus solapamientos. Reduce el uso de memoria, pero añade uniones que debes comprobar al oído. Estas opciones dependen de la versión, y la ruta original por segmentos mezcla la entrada estéreo hasta convertirla en mono, así que conserva el archivo estéreo original.
Cómo usar AudioSR desde Python
Usa la API Python para llamar a AudioSR desde tu propio script. El ejemplo siguiente procesa un archivo mono corto, recorta el relleno hasta la duración de la entrada y escribe un WAV a 48 kHz. Guárdalo como run_audiosr.py en el directorio del repositorio.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyEl pipeline Python carga el modelo una sola vez, por lo que un script de procesamiento por lotes puede reutilizarlo. En Neural Analog, el procesamiento por lotes aplica una restauración a muchos archivos sin un script. Define explícitamente el número de pasos de muestreo, porque la API Python y la CLI pueden usar valores predeterminados distintos.
Cómo ejecutar AudioSR en Google Colab
Google Colab permite ejecutar AudioSR en el hardware de Google en la nube. Abre el cuaderno AudioSR Colab de la comunidad y sigue sus instrucciones para cargar el audio, ejecutar el modelo y guardar el resultado. El cuaderno se ejecuta en el navegador, así que no necesitas instalar Python ni tener una GPU en tu ordenador.
El cuaderno es una adaptación comunitaria de AudioSR. Su código está disponible en GitHub.
¿Dónde puedes descargar los pesos del modelo AudioSR?
Descarga los pesos del modelo AudioSR en Hugging Face.
Detalles del modelo AudioSR: arquitectura, entrenamiento e historia
¿Quién creó AudioSR?
AudioSR es un modelo generativo de superresolución de audio de Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang y Mark D. Plumbley. Predice las altas frecuencias que faltan en voz, música y efectos de sonido y produce audio a 48 kHz. La página de investigación de AudioSR incluye el artículo y ejemplos de escucha. El trabajo apareció primero como prepublicación en septiembre de 2023 y se publicó en ICASSP 2024.
AudioSR genera detalles plausibles. No puede recuperar una copia exacta de un máster de estudio perdido. Convertir un MP3 a WAV de 48 kHz no realiza esta reconstrucción en absoluto. Para entender la diferencia, consulta la guía de restauración de archivos MP3 a WAV.
Restauración, remuestreo y ancho de banda son distintos
El remuestreo cambia cuántas muestras representan cada segundo de audio. La restauración de audio, o superresolución, intenta estimar el contenido frecuencial que la grabación ya no contiene. Por ejemplo, remuestrear una grabación de 8 kHz a 48 kHz le da más muestras, pero no restaura por sí solo los sonidos por encima de su límite de frecuencia original de 4 kHz.
AudioSR trabaja con anchos de banda de entrada de 2 a 16 kHz y genera una salida con 24 kHz de ancho de banda a una frecuencia de muestreo de 48 kHz, según la descripción oficial del proyecto. El ancho de banda describe el rango de frecuencias; la frecuencia de muestreo describe las muestras por segundo. Un archivo etiquetado como 48 kHz puede seguir teniendo un ancho de banda estrecho debido a compresión o filtrado anteriores. Muchas canciones generadas por IA son así, y por eso las canciones Suno suelen sonar apagadas.
¿Fue AudioSR el primer modelo de restauración de audio?
AudioSR no fue el primer modelo neuronal de superresolución de audio. Kuleshov, Enam y Ermon publicaron Superresolución de audio mediante redes neuronales en 2017, y la superresolución de voz mediante difusión también existía antes de AudioSR.
Su aportación es más concreta. El artículo de AudioSR lo presenta como el primer sistema que cubre todo el dominio audible: música, voz y efectos de sonido. Combina esa amplitud con un ancho de banda de entrada flexible, sin haber introducido la superresolución de audio en sí.
De la grabación de entrada a una forma de onda de 48 kHz
AudioSR combina un autoencoder variacional (VAE), un modelo de difusión latente condicional y un vocoder neuronal. Cada componente se ocupa de una etapa de la reconstrucción:
| Etapa | Qué ocurre | Por qué importa |
|---|---|---|
| Representación del audio | La entrada se convierte en un espectrograma mel: un mapa de la energía sonora en el tiempo y la frecuencia. | El modelo trabaja con patrones del contenido frecuencial. |
| Codificación VAE | Un encoder comprime el espectrograma en una representación más pequeña llamada latente. | La difusión opera sobre menos valores que en un espectrograma completo. |
| Difusión condicional | Un Transformer U-Net refina iterativamente un latente con ruido, guiado por el latente de entrada de baja resolución. | La grabación guía los detalles generados; no hace falta un prompt de texto. |
| Decodificación y vocoder | El VAE decodifica un espectrograma mel de mayor resolución. Un vocoder basado en HiFi-GAN lo convierte en una forma de onda. | Un espectrograma debe convertirse de nuevo en muestras audibles. |
| Sustitución de frecuencias | La información de baja frecuencia de la entrada sustituye a las bandas generadas correspondientes. | La información existente ayuda a limitar los cambios en la grabación. |
La configuración publicada del modelo especifica una representación mel de 256 bandas, un VAE y un U-Net con transformers espaciales. Concatena las características pasa-bajos codificadas de la entrada con el latente de difusión. Es generación condicionada por audio, aunque algunas descripciones heredadas de la CLI mencionen texto.
¿Qué controlan los pasos de muestreo y el guiado?
Los pasos de muestreo controlan cuántas iteraciones dedica el modelo a refinar su representación generada. AudioSR usa un muestreador DDIM. El guiado controla con qué fuerza el condicionamiento de entrada dirige la generación. No es una cantidad de EQ, y un valor más alto no garantiza una calidad mayor. La implementación de la inferencia aplica en secuencia muestreo, decodificación, sustitución de frecuencias y normalización de la forma de onda.
Más pasos de muestreo y grabaciones más largas requieren más tiempo de procesamiento. AudioSR está pensado para procesamiento fuera de tiempo real, y la velocidad depende de tu GPU y de los ajustes. Reducir ddim_steps acelera la generación, pero no soluciona de forma fiable los errores de memoria GPU.
¿Cómo se entrenó AudioSR?
La sección de entrenamiento del artículo describe unas 7.000 horas de MUSDB18-HQ, MoisesDB, MedleyDB, Freesound y datos de voz de OpenSLR. Filtros pasa-bajos con cortes variados crean entradas degradadas emparejadas con objetivos de ancho de banda mayor. El modelo de difusión usa una programación de ruido cosenoidal, predicción de velocidad y guiado sin clasificador. El vocoder se basa en HiFi-GAN con un discriminador multirresolución.
Las grabaciones reales pueden diferir de estos ejemplos de entrenamiento. Los autores explican que los cortes de frecuencia irregulares, el ruido intenso y la reverberación pueden reducir la calidad. La compresión MP3 puede dejar huecos cerca del corte. El filtrado pasa-bajos antes de la inferencia puede ayudar, pero un corte demasiado bajo elimina detalles útiles. Para grabaciones reverberantes, eliminar la reverberación antes de la restauración puede proporcionar una entrada más limpia al modelo.
No necesitas entrenar estos componentes para ejecutar AudioSR. El proceso de instalación carga pesos preentrenados.
¿Por qué AudioSR usa posprocesamiento?
El audio generado debe conservar la información útil que ya existe en la fuente. AudioSR sustituye las bandas bajas dos veces: en el espectrograma mel estimado antes del vocoder y en la representación mediante transformada de Fourier de tiempo corto (STFT) de la forma de onda resultante. El código de sustitución estima un corte y ajusta la salida reconstruida.
Las grabaciones estéreo y las canciones completas necesitan un pipeline que gestione canales, segmentos y reconstrucción. El proceso predeterminado del repositorio produce audio mono: el cargador estándar toma el primer canal de entrada, mientras que el pipeline por segmentos mezcla el estéreo hasta convertirlo en mono. Conservar el estéreo requiere un tratamiento adicional de canales, como el procesamiento separado de izquierda y derecha del cuaderno comunitario.
La reconstrucción debe comprobarse al oído. Las notas del pipeline comunitario advierten de que un solapamiento excesivo puede causar cancelaciones de fase. Compara el resultado a un volumen similar y revisa los agudos regenerados, las uniones de los segmentos, la duración y la imagen estéreo. La sustitución de frecuencias ayuda a conservar la fuente, pero no garantiza una banda baja sin cambios ni uniones limpias.
Preguntas frecuentes sobre errores de AudioSR
¿Está AudioSR en PyPI?
Sí. El README oficial instala audiosr==0.0.7 con pip o el código más reciente directamente desde GitHub. La rama main de GitHub tiene funciones, como el procesamiento por segmentos, que la versión de PyPI puede no incluir.
¿Cuánta memoria GPU necesita AudioSR?
El README no da un mínimo. Solo el checkpoint básico ocupa unos 6,2 GB en disco, y el uso de memoria crece con la duración del fragmento. Empieza con un fragmento de unos 5 segundos y usa segmentos para archivos más largos.
¿Por qué falla AudioSR con numpy.ndarray has no attribute cpu?
La inferencia ha terminado, pero el paso de guardado espera un tensor PyTorch y recibe un array NumPy. Usa el script Python anterior, que escribe la salida con soundfile.
¿Por qué mi salida de AudioSR es mono?
El cargador predeterminado solo lee el primer canal, y la ruta por segmentos mezcla el estéreo hasta convertirlo en mono. Procesa los canales izquierdo y derecho por separado o usa AudioSR en línea, que procesa las señales de centro y diferencia por ti.
¿Está disponible el código de entrenamiento de AudioSR?
Sí. El registro de cambios del README del 31 de diciembre de 2024 enlaza el código de entrenamiento, que el autor describe como material solo de referencia y no organizado cuidadosamente.
Usa AudioSR con Neural Analog sin gestionar la instalación
Para evitar la instalación local, abre AudioSR en línea, sube un archivo o importa un enlace musical compatible y ajusta la restauración. Para Udio, guarda o graba primero el audio y después sube el archivo. Puedes elegir una frecuencia de corte, escuchar una vista previa del resultado procesado y exportar audio desde la misma interfaz.
Neural Analog gestiona el procesamiento del modelo en línea, así que puedes usar un ordenador sin una GPU grande y evitar instalar Python, descargar checkpoints y mantener cuadernos. Aun así, debes escuchar con atención crítica, porque un proceso alojado no elimina las limitaciones de calidad del modelo. Después de restaurar, sigue la guía de mejora de audio para los pasos siguientes. Para música generada por IA, corregir la calidad de audio de canciones IA trata la reparación de pistas y la masterización después de la restauración.
También puedes comparar AudioSR con modelos de restauración de audio más recientes disponibles en Neural Analog, como UniverSR y FlashSR. Sus fichas explican cómo funciona cada uno, y la FAQ resume en qué se diferencia UniverSR de AudioSR. Como ejemplo completo, consulta los 203 efectos de sonido de RPG Maker 2000 restaurados a 48 kHz con UniverSR. Aplícalos a la misma grabación y compara las vistas previas para elegir el mejor resultado.