AudioSR GitHub 설치 가이드: AudioSR을 로컬에서 실행하는 방법
AudioSR은 오픈 소스 오디오 초해상도 모델입니다. 음성, 음악, 효과음에서 손실된 고주파 세부 정보를 생성해 48 kHz 오디오를 만듭니다. 공식 GitHub 저장소에서 설치하거나 Neural Analog에서 AudioSR을 온라인으로 실행할 수 있습니다.
로컬에 설치하려면 저장소를 복제하고 uv로 Python 3.10 환경을 만든 뒤 호환되는 PyTorch 빌드와 AudioSR을 설치하세요. 그런 다음 짧은 WAV 파일에 python -m audiosr을 실행합니다. 아래에서 각 명령을 설명합니다.
AudioSR은 어떻게 작동하나요? 구조 설명
AudioSR의 손실된 고주파 재구성 과정
입력 멜 스펙트로그램을 조건으로 잠재 확산을 수행해 더 넓은 대역폭의 멜 스펙트로그램을 추정합니다. 보코더 전에는 생성된 저역 멜 대역을 입력의 대역으로 교체하고, 보코더 후에는 생성된 저역 STFT 대역을 입력의 대역으로 교체합니다. 모델은 그럴듯한 손실 세부 정보를 생성하며, 잃어버린 녹음을 정확하게 복구하는 것은 아닙니다.
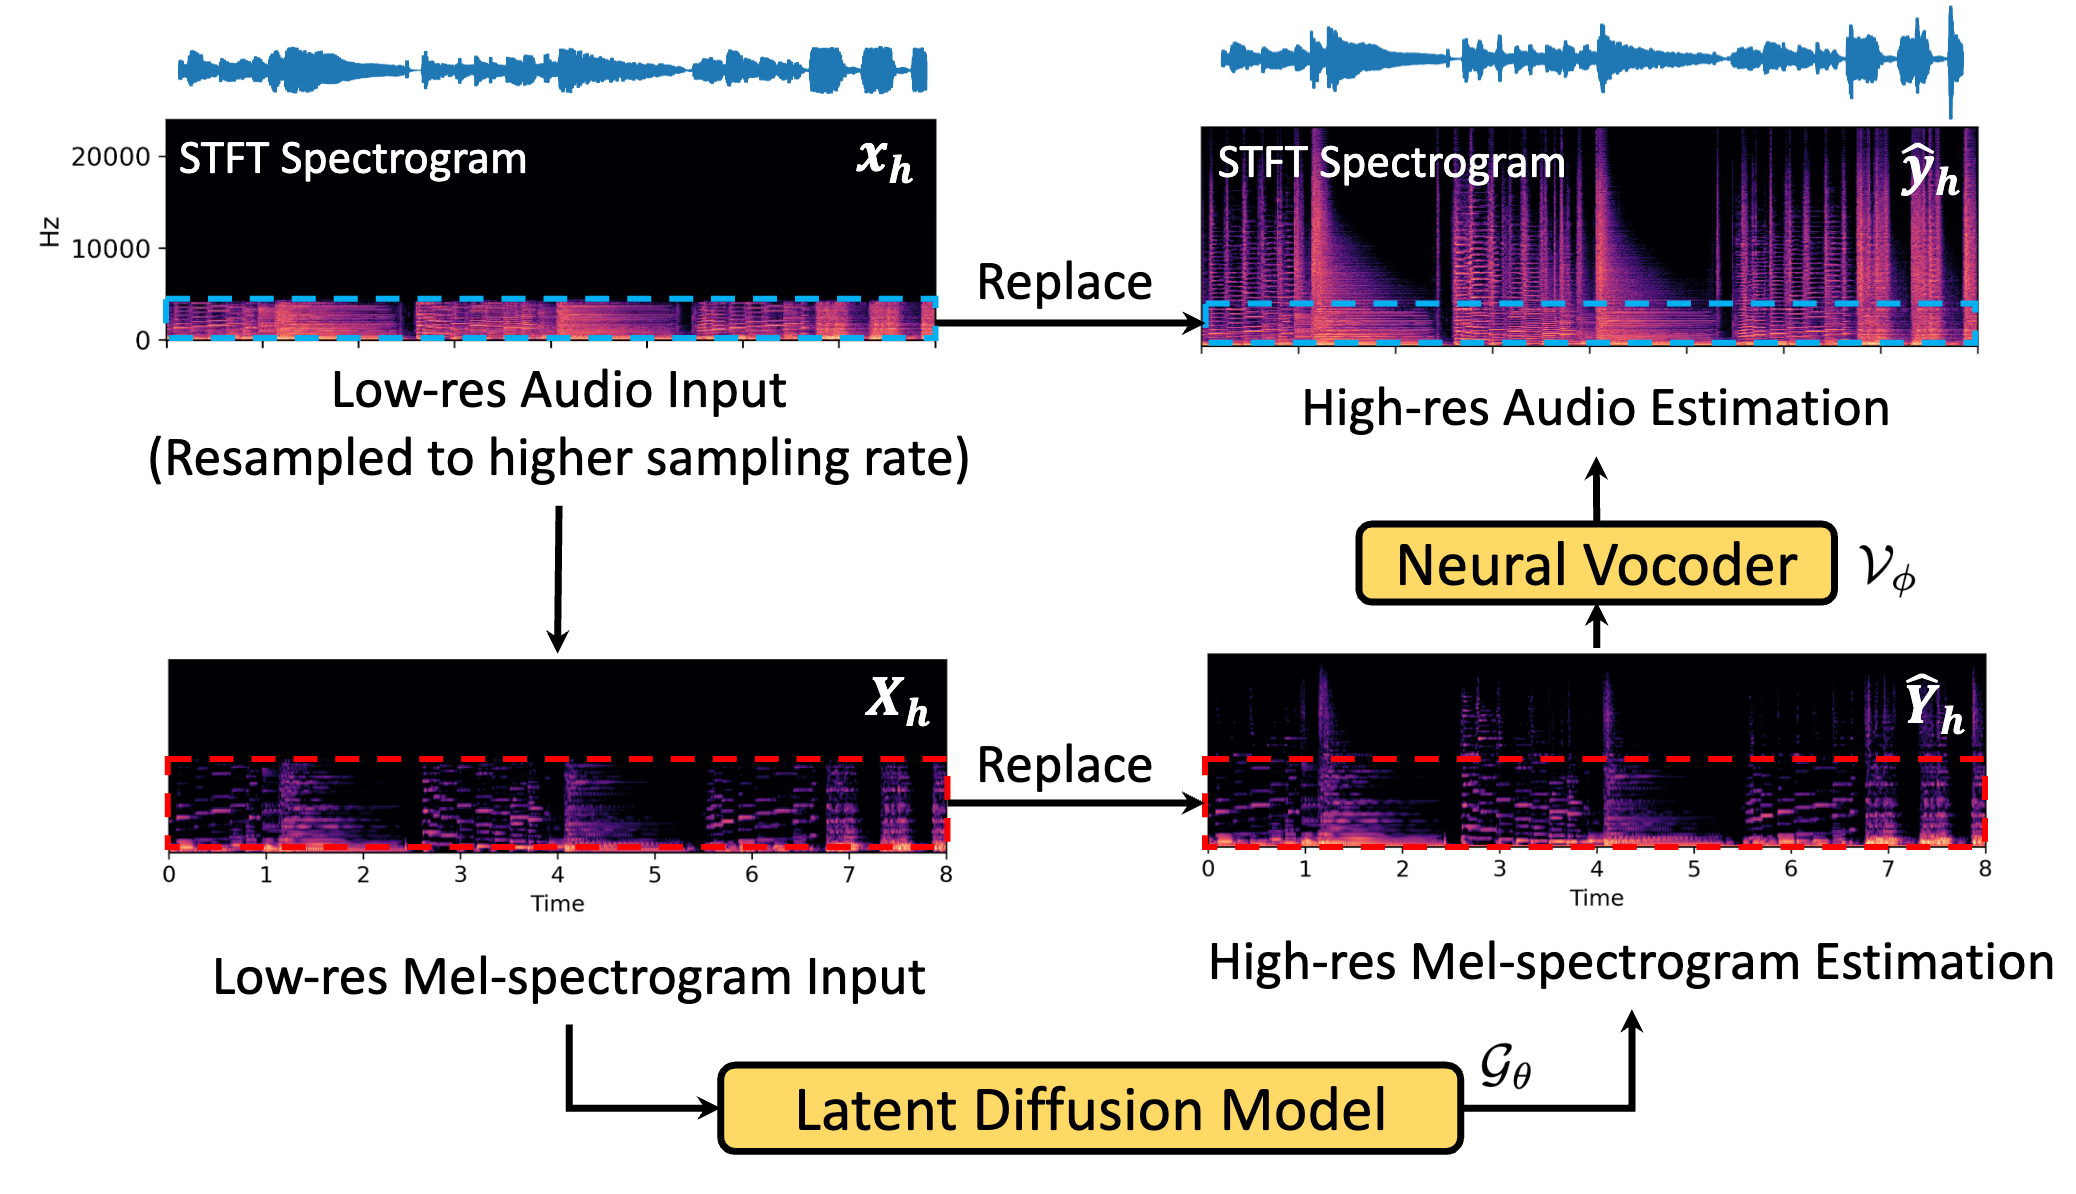
원본 도식: AudioSR.
AudioSR은 녹음을 멜 스펙트로그램으로 변환하고 잠재 확산 모델로 손실된 고주파 세부 정보를 추정한 뒤 보코더로 결과를 파형으로 되돌립니다. 후처리에서는 생성된 저주파 대신 원본의 기존 저주파를 넣습니다. 결과는 그럴듯한 재구성이며 손실된 오디오의 정확한 복구가 아닙니다. 또한 단순히 잡음을 더하는 것도 아닙니다.
AudioSR은 어디에서 실행할 수 있나요?
| 옵션 | 적합한 용도 | 설정과 고려 사항 |
|---|---|---|
| Neural Analog 온라인 AudioSR(권장) | 미드/사이드 처리와 조절 가능한 컷오프 주파수를 사용하는 스테레오 복원 | 온라인에서 업로드, 미리 듣기, 내보내기를 할 수 있습니다. Python 설치나 로컬 GPU가 필요 없습니다. |
| 공식 GitHub 저장소 | 로컬 실험과 Python 스크립트 | 의존성을 설치하고 가중치를 다운로드하며 연산 자원을 준비해야 합니다. |
| AudioSR Colab 노트북 | Google의 클라우드 GPU로 하는 실험 | 커뮤니티 노트북을 열고 브라우저에서 안내를 따릅니다. |
| Hugging Face Space | 브라우저에서 빠르게 해 보는 데모 | 커뮤니티 배포입니다. 가용성과 GPU 사용 한도가 바뀔 수 있습니다. |
| Replicate의 AudioSR | 호스팅된 추론과 API 연동 | 사용량에 따라 과금되며 로컬에 모델을 설치하지 않습니다. |
Neural Analog는 스테레오 오디오의 중앙 정보와 사이드 정보를 각각 처리합니다. AudioSR이 세부 정보를 다시 생성하기 시작하는 컷오프 주파수도 설정할 수 있습니다. 낮은 컷오프는 소리의 더 넓은 부분을 바꾸고, 높은 컷오프는 최상단의 고역만 채웁니다.
AudioSR 요구 사항: Python, GPU 메모리, 디스크 공간
AudioSR은 특히 전체 노래를 처리할 때 무거운 모델입니다. 공식 기본 체크포인트는 디스크에서 약 6.2 GB를 차지하며, 추론에는 저장된 가중치보다 더 많은 메모리가 필요합니다. 메모리가 큰 NVIDIA GPU가 도움이 되지만 체크포인트 크기가 최소 VRAM 요구량은 아닙니다. 클립 길이와 구현도 메모리 사용량에 영향을 줍니다. 공식 README에는 최소 GPU 요구 사항이 나와 있지 않습니다.
긴 입력은 GPU 메모리를 소진할 수 있습니다. 짧은 클립으로 시작하고 긴 녹음은 작은 청크로 나누어 처리하세요.
시작 전에 다음 의존성을 준비하세요.
- 격리된 환경의 Python. 원본 프로젝트 예시는 Python 3.9를 사용합니다. 이 가이드는 AudioSR이 요구하는 이전 NumPy 버전과 호환되는 Python 3.10을 사용합니다. 가상 환경을 쓰면 이 패키지들이 시스템 Python에 설치되지 않습니다.
- Git과 uv. 소스를 다운로드하고 Python 환경을 관리하려면 Git과 uv를 설치하세요.
- PyTorch와 적절한 GPU 드라이버. NVIDIA 사용자는 CUDA와 호환되는 PyTorch 빌드가 필요합니다. 공식 설치 버전 표에 따라 PyTorch, TorchAudio, TorchVision 버전을 맞추세요.
- ffprobe를 포함한 FFmpeg. 원본 프로젝트의 파일 저장 코드는 이 명령을 사용합니다. FFmpeg 다운로드 옵션을 통해 설치하고 터미널에서 사용할 수 있도록 설정하세요.
- 여유 디스크 공간과 인터넷 연결. 환경, 다운로드할 모델 가중치, 입력 파일, 출력에 필요한 공간을 확보하세요. 모델을 처음 불러올 때 체크포인트를 다운로드합니다.
원본 프로젝트의 장치 선택 코드는 CUDA, Apple MPS, CPU를 인식합니다. CPU 처리는 매우 느릴 수 있습니다. 장치 확인에서 MPS를 지원한다고 해서 모든 의존성과 연산이 모든 Mac에서 작동한다는 뜻은 아닙니다.
GitHub에서 AudioSR 설치하기
1. 공식 저장소 다운로드와 Python 환경 만들기
터미널에서 다음 명령을 실행하세요.
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Linux나 macOS에서 환경을 활성화하세요.
source .venv/bin/activateWindows PowerShell에서는 대신 다음 활성화 명령을 사용하세요.
.venv\Scripts\Activate.ps12. 호환되는 의존성과 AudioSR 설치하기
AudioSR은 NumPy 1.23.5 이하와 Transformers 4.30.2를 비롯해 이전 의존성에 대한 버전 제약이 있습니다. 최신 Python과 PyTorch를 설치하면 호환성 오류가 발생할 수 있습니다. 프로젝트의 패키지 요구 사항과 참조 환경을 출발점으로 삼으세요.
예를 들어 참조 환경은 PyTorch 2.0.1, TorchAudio 2.0.2, TorchVision 0.15.2를 함께 사용합니다. 적절한 NVIDIA 드라이버가 있는 Linux나 Windows에서 이 CUDA 11.7 조합을 설치한 다음 체크아웃한 AudioSR 소스를 설치하세요.
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
CUDA 명령은 NVIDIA 시스템용입니다. 다른 장치에서는 PyTorch 버전 표의 해당 macOS 또는 CPU 안내를 사용하세요. 이전 의존성 버전이므로 이 환경을 다른 Python 프로젝트와 분리해 두세요.
배포된 패키지만 필요하다면 공식 README에 audiosr==0.0.7도 안내되어 있습니다. 이 릴리스와 GitHub의 현재 main 브랜치는 기능이 다를 수 있으므로 설치한 버전에서 python -m audiosr --help를 확인하세요.
3. Python이 GPU를 인식하는지 확인하기
NVIDIA 컴퓨터의 활성화된 환경 안에서 다음을 확인하세요.
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
CUDA를 사용할 수 없다면 긴 작업을 시작하기 전에 드라이버나 PyTorch 설치를 수정하세요. AudioSR에 -d cuda를 추가해도 사용할 수 없는 GPU가 작동하지는 않습니다.
AudioSR 명령줄 사용법: 짧은 WAV로 시작하기
첫 실행에는 짧은 모노 WAV를 사용하세요. 원본 프로젝트의 오디오 로더는 5.12초 입력을 권장하며 10.24초를 넘으면 품질에 문제가 생길 수 있다고 경고합니다. 전체 노래를 쓰면 설정과 메모리 문제의 원인을 찾기 어렵습니다.
input.wav를 저장소 디렉터리에 넣고 실행하세요.
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42명령줄 구현은 output 아래 시간 표시가 있는 폴더에 48 kHz WAV 출력을 저장합니다. 일반 오디오에는 basic, 말소리 녹음에는 speech를 사용하세요. 시드는 생성 결과의 변화를 제어합니다. 몇 가지 시드를 비교하면 더 좋은 결과를 고르는 데 도움이 됩니다.
생성이 끝났는데 저장 중 numpy.ndarray has no attribute cpu 오류가 난다면 아래 Python 예제로 출력을 직접 기록하세요. 이 가이드에서 확인한 GitHub 소스는 추론에서 NumPy 배열을 반환하지만 파일 저장 함수는 텐서를 기대합니다. 원본 프로젝트의 출력 유형 불일치이며 GPU 메모리 오류가 아닙니다.
현재 GitHub 코드는 긴 파일의 청크 처리도 제공합니다.
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1청크 처리는 작은 구간을 처리하고 겹치는 부분을 섞습니다. 메모리 사용량을 줄이지만 연결 지점이 생기므로 귀로 확인해야 합니다. 이 플래그는 버전에 따라 다르며 원본 프로젝트의 청크 경로는 스테레오 입력을 모노로 다운믹스하므로 원래 스테레오 파일을 보관하세요.
Python에서 AudioSR 사용하기
Python API로 자신의 스크립트에서 AudioSR을 호출하세요. 아래 예제는 짧은 모노 파일을 처리하고 패딩을 입력 길이로 잘라낸 뒤 48 kHz WAV를 기록합니다. 저장소 디렉터리에 run_audiosr.py로 저장하세요.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPython 파이프라인은 모델을 한 번만 불러오므로 일괄 처리 스크립트에서 재사용할 수 있습니다. Neural Analog의 일괄 처리는 스크립트 없이 여러 파일에 같은 복원을 적용합니다. Python API와 CLI의 기본값이 다를 수 있으므로 샘플링 스텝 수를 명시적으로 설정하세요.
Google Colab에서 AudioSR 실행하기
Google Colab을 쓰면 Google의 클라우드 하드웨어에서 AudioSR을 실행할 수 있습니다. 커뮤니티 AudioSR Colab 노트북을 열고 안내에 따라 오디오를 불러오고 모델을 실행한 뒤 결과를 저장하세요. 브라우저에서 실행되는 노트북이므로 자신의 컴퓨터에 Python이나 GPU가 필요 없습니다.
이 노트북은 커뮤니티가 AudioSR을 변형한 버전입니다. 소스는 GitHub에서 볼 수 있습니다.
AudioSR 모델 가중치는 어디에서 다운로드하나요?
Hugging Face의 AudioSR 모델 가중치를 다운로드하세요.
AudioSR 모델 세부 사항: 구조, 학습, 역사
AudioSR은 누가 만들었나요?
AudioSR은 Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang, Mark D. Plumbley가 만든 생성형 오디오 초해상도 모델입니다. 음성, 음악, 효과음에서 손실된 고주파를 예측하고 48 kHz 오디오를 만듭니다. AudioSR 연구 페이지에 논문과 청취 예제가 있습니다. 이 연구는 2023년 9월 프리프린트로 처음 공개됐고 ICASSP 2024에서 발표됐습니다.
AudioSR은 그럴듯한 세부 정보를 생성합니다. 잃어버린 스튜디오 마스터를 정확히 복구할 수는 없습니다. MP3를 48 kHz WAV로 변환하는 것만으로는 이런 재구성이 전혀 일어나지 않습니다. 이 차이는 MP3를 WAV로 복원하는 가이드를 참고하세요.
오디오 복원, 리샘플링, 대역폭의 차이
리샘플링은 오디오 1초를 표현하는 샘플 수를 바꿉니다. 오디오 음질 개선 또는 초해상도는 녹음에서 사라진 주파수 성분을 추정하려 합니다. 예를 들어 8 kHz 녹음을 48 kHz로 리샘플링하면 샘플 수는 늘지만, 원래의 4 kHz 주파수 한계 위에 있는 소리가 저절로 복원되지는 않습니다.
공식 프로젝트 설명에 따르면 AudioSR은 입력 대역폭 2에서 16 kHz를 대상으로 하며, 48 kHz 샘플레이트에서 24 kHz 대역폭의 출력을 생성합니다. 대역폭은 주파수 범위이고 샘플레이트는 초당 샘플 수입니다. 48 kHz로 표시된 파일도 이전 압축이나 필터링 때문에 대역폭이 좁을 수 있습니다. AI 생성 노래 중에도 이런 경우가 많으며, Suno 노래가 자주 먹먹하게 들리는 이유이기도 합니다.
AudioSR이 최초의 오디오 초해상도 모델인가요?
AudioSR은 최초의 신경 오디오 초해상도 모델이 아닙니다. Kuleshov, Enam, Ermon은 2017년에 신경망을 이용한 오디오 초해상도를 발표했으며 확산 기반 음성 초해상도도 AudioSR보다 먼저 나왔습니다.
기여 범위는 더 구체적입니다. AudioSR 논문은 이를 음악, 음성, 효과음을 포함한 일반적인 가청 영역을 포괄하는 최초의 시스템으로 소개합니다. 오디오 초해상도 자체를 처음 제안한 것이 아니라 넓은 적용 범위와 유연한 입력 대역폭을 결합한 것입니다.
입력 녹음에서 48 kHz 파형까지
AudioSR은 변분 오토인코더(VAE), 조건부 잠재 확산 모델, 신경 보코더를 결합합니다. 각 구성 요소는 재구성의 한 단계를 담당합니다.
| 단계 | 일어나는 일 | 중요한 이유 |
|---|---|---|
| 오디오 표현 | 입력은 시간과 주파수에 따른 소리 에너지 지도인 멜 스펙트로그램이 됩니다. | 모델은 주파수 성분의 패턴을 다룹니다. |
| VAE 인코딩 | 인코더가 스펙트로그램을 잠재 표현이라고 하는 더 작은 표현으로 압축합니다. | 확산은 전체 스펙트로그램보다 적은 값을 처리합니다. |
| 조건부 확산 | Transformer U-Net이 저해상도 입력 잠재 표현의 유도를 받아 잡음이 있는 잠재 표현을 반복적으로 다듬습니다. | 녹음이 생성 세부 정보를 유도하며 텍스트 프롬프트가 필요 없습니다. |
| 디코딩과 보코더 | VAE가 고해상도 멜 스펙트로그램을 디코딩합니다. HiFi-GAN 기반 보코더가 이를 파형으로 바꿉니다. | 스펙트로그램을 다시 들을 수 있는 샘플로 변환해야 합니다. |
| 주파수 교체 | 입력의 저주파 정보로 해당하는 생성 대역을 교체합니다. | 기존 정보가 녹음의 변화를 제한하는 데 도움이 됩니다. |
공개된 모델 설정은 256개 멜 대역 표현, VAE, 공간 트랜스포머가 있는 U-Net을 지정합니다. 입력의 인코딩된 저역 통과 특성을 확산 잠재 표현과 이어 붙입니다. 일부 상속된 CLI 설명에 텍스트가 언급되더라도 생성은 오디오를 조건으로 합니다.
샘플링 스텝과 유도는 무엇을 제어하나요?
샘플링 스텝은 모델이 생성 표현을 다듬는 반복 횟수를 제어합니다. AudioSR은 DDIM 샘플러를 사용합니다. 유도는 입력 조건이 생성에 얼마나 강하게 영향을 주는지 제어합니다. EQ 적용량이 아니며 높은 값이 더 높은 품질을 보장하지도 않습니다. 추론 구현은 샘플링, 디코딩, 주파수 교체, 파형 정규화를 순서대로 적용합니다.
샘플링 스텝이 많고 녹음이 길수록 처리 시간이 늘어납니다. AudioSR은 비실시간 처리용이며 실제 속도는 GPU와 설정에 따라 달라집니다. ddim_steps를 줄이면 생성 속도가 빨라지지만 GPU 메모리 오류가 확실하게 해결되지는 않습니다.
AudioSR은 어떻게 학습됐나요?
논문의 학습 부분은 MUSDB18-HQ, MoisesDB, MedleyDB, Freesound, OpenSLR 음성 데이터에서 얻은 약 7,000시간을 설명합니다. 다양한 컷오프의 저역 통과 필터로 열화된 입력을 만들어 더 넓은 대역폭의 목표와 짝지었습니다. 확산 모델은 코사인 잡음 스케줄, 속도 예측, 분류기 없는 유도를 사용합니다. 보코더는 다중 해상도 판별기를 사용하는 HiFi-GAN 기반입니다.
실제 녹음은 이 학습 예제와 다를 수 있습니다. 저자는 불규칙한 주파수 컷오프, 심한 잡음, 리버브가 품질을 낮출 수 있다고 설명합니다. MP3 압축은 컷오프 근처에 빈 부분을 남길 수 있습니다. 추론 전에 저역 통과 필터링을 하면 도움이 될 수 있지만 컷오프를 너무 낮추면 유용한 세부 정보가 사라집니다. 리버브가 있는 녹음은 초해상도 처리 전에 리버브를 제거하면 더 깨끗한 입력을 줄 수 있습니다.
AudioSR을 실행하기 위해 이 구성 요소들을 학습할 필요는 없습니다. 설치 과정은 사전 학습된 가중치를 불러옵니다.
AudioSR은 왜 후처리를 사용하나요?
생성된 오디오는 원본에 이미 존재하는 유용한 정보를 유지해야 합니다. AudioSR은 저역 대역을 두 번 교체합니다. 보코더 전의 추정 멜 스펙트로그램에서 한 번, 결과 파형의 단시간 푸리에 변환(STFT) 표현에서 한 번입니다. 교체 코드는 컷오프를 추정하고 재구성된 출력을 조절합니다.
스테레오 녹음과 전체 노래에는 채널, 청크, 재구성을 처리하는 파이프라인이 필요합니다. 저장소의 기본 과정은 모노 오디오를 만듭니다. 표준 로더는 입력의 첫 채널을 가져오고, 청크 파이프라인은 스테레오를 모노로 다운믹스합니다. 스테레오를 유지하려면 커뮤니티 노트북의 좌우 채널 개별 처리처럼 추가 채널 처리가 필요합니다.
재구성 결과는 청취 확인이 필요합니다. 커뮤니티 파이프라인 안내는 과도한 겹침이 위상 상쇄를 일으킬 수 있다고 경고합니다. 비슷한 음량으로 결과를 비교하고 재생성된 고역, 청크 연결부, 길이, 스테레오 이미지를 확인하세요. 주파수 교체는 원본을 유지하는 데 도움이 되지만 저역 대역이 그대로 남거나 연결부가 깨끗하다는 보장은 없습니다.
AudioSR 문제 해결 FAQ
AudioSR은 PyPI에 있나요?
네. 공식 README는 pip로 audiosr==0.0.7을 설치하거나 GitHub에서 최신 코드를 바로 설치하는 방법을 설명합니다. GitHub main 브랜치에는 청크 처리처럼 PyPI 릴리스에 없는 기능이 있을 수 있습니다.
AudioSR에 필요한 GPU 메모리는 얼마인가요?
README에는 최소 요구량이 없습니다. 기본 체크포인트만 디스크에서 약 6.2 GB를 차지하며, 메모리 사용량은 클립 길이에 따라 늘어납니다. 약 5초 클립으로 시작하고 긴 파일은 청크로 처리하세요.
AudioSR에서 numpy.ndarray has no attribute cpu 오류가 나는 이유는 무엇인가요?
추론은 끝났지만 저장 단계가 PyTorch 텐서를 기대하는데 NumPy 배열을 받았습니다. 위 Python 스크립트로 soundfile을 사용해 출력을 기록하세요.
AudioSR 출력이 모노인 이유는 무엇인가요?
기본 로더는 첫 채널만 읽고 청크 경로는 스테레오를 모노로 다운믹스합니다. 좌우 채널을 각각 처리하거나 미드와 사이드 채널을 처리해 주는 온라인 AudioSR을 사용하세요.
AudioSR 학습 코드가 공개되어 있나요?
네. README의 2024년 12월 31일 변경 기록에 학습 코드 링크가 있습니다. 저자는 참고용일 뿐이며 세심하게 정리된 코드는 아니라고 설명합니다.
설치 관리 대신 Neural Analog에서 AudioSR 실행하기
로컬 설정을 건너뛰려면 온라인 AudioSR을 열고 파일을 업로드하거나 지원되는 음악 링크를 가져온 뒤 복원 설정을 조절하세요. Udio에서는 먼저 오디오를 저장하거나 녹음하고 파일을 업로드하세요. 같은 화면에서 컷오프 주파수를 선택하고 처리 결과를 미리 듣고 오디오를 내보낼 수 있습니다.
Neural Analog는 온라인으로 모델을 처리하므로 큰 GPU가 없는 컴퓨터를 쓰고 Python 설치, 체크포인트 다운로드, 노트북 관리를 생략할 수 있습니다. 호스팅된 과정도 모델의 품질 한계를 없애지는 않으므로 주의 깊게 들어야 합니다. 복원 후에는 오디오 개선 가이드의 다음 단계를 따르세요. AI 생성 음악은 AI 노래 음질 수정에서 초해상도 처리 후의 스템 복구와 마스터링을 설명합니다.
Neural Analog의 더 새로운 오디오 초해상도 모델인 UniverSR와 FlashSR를 AudioSR과 비교할 수도 있습니다. 모델 카드는 각각의 작동 방식을 설명하고 FAQ는 UniverSR과 AudioSR의 차이를 정리합니다. 실제 예제는 UniverSR로 RPG Maker 2000 효과음 203개 모두를 48 kHz로 복원한 사례를 참고하세요. 같은 녹음에 실행하고 미리 듣기를 비교해 가장 좋은 결과를 고르세요.