Hướng dẫn cài AudioSR từ GitHub: cách chạy AudioSR trên máy
AudioSR là mô hình siêu phân giải âm thanh mã nguồn mở. Nó tạo chi tiết tần số cao bị mất trong lời nói, âm nhạc và hiệu ứng âm thanh để cho ra âm thanh 48 kHz. Bạn có thể cài từ repo GitHub chính thức hoặc chạy AudioSR trực tuyến bằng Neural Analog.
Để cài trên máy, sao chép repo, tạo môi trường Python 3.10 bằng uv, cài bản PyTorch tương thích và AudioSR, rồi chạy python -m audiosr trên một tệp WAV ngắn. Các bước dưới đây trình bày từng lệnh.
AudioSR hoạt động thế nào? Giải thích kiến trúc
Cách AudioSR tái dựng tần số cao bị mất
Spectrogram mel đầu vào làm điều kiện cho khuếch tán tiềm ẩn để ước tính spectrogram mel có băng thông đầy đủ hơn. Trước vocoder, các dải mel thấp của đầu vào thay cho dải được tạo; sau vocoder, các dải STFT thấp của đầu vào thay cho dải được tạo. Mô hình tạo chi tiết bị mất một cách hợp lý, chứ không khôi phục chính xác bản ghi đã mất.
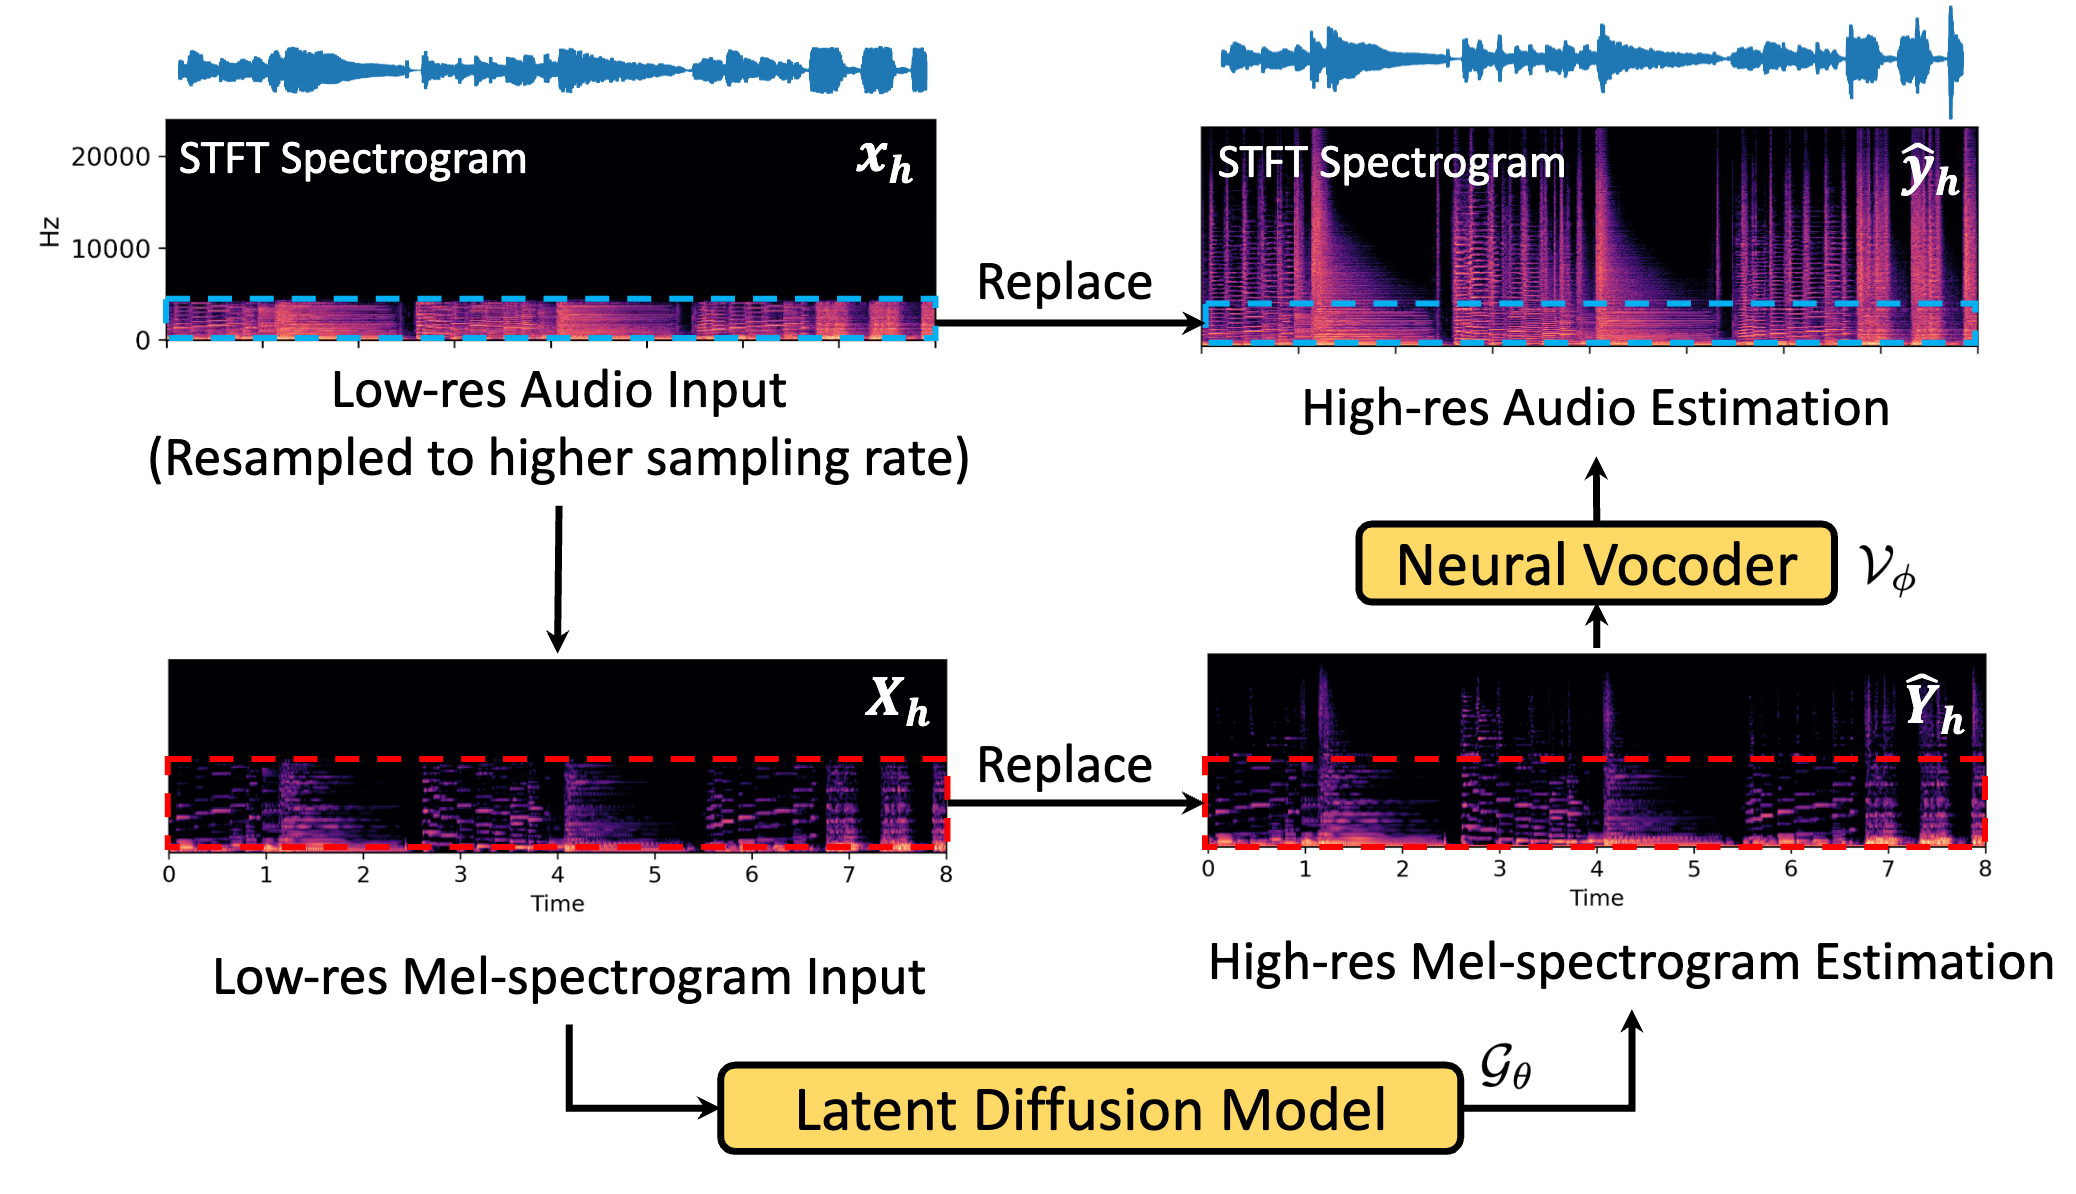
Sơ đồ gốc: AudioSR.
AudioSR chuyển bản ghi thành spectrogram mel, dùng mô hình khuếch tán tiềm ẩn để ước tính chi tiết tần số cao bị mất, rồi dùng vocoder chuyển kết quả trở lại dạng sóng. Hậu xử lý đưa các tần số thấp gốc của nguồn vào thay cho phần được tạo. Kết quả là tái dựng hợp lý, không phải khôi phục chính xác âm thanh đã mất, và không chỉ là thêm nhiễu.
Bạn có thể chạy AudioSR ở đâu?
| Lựa chọn | Phù hợp nhất | Thiết lập và đánh đổi |
|---|---|---|
| AudioSR trực tuyến của Neural Analog (khuyên dùng) | Phục hồi stereo với xử lý mid/side và tần số cắt tùy chỉnh | Tải lên, nghe thử và xuất trực tuyến. Không cần cài Python hay GPU trên máy. |
| Repo GitHub chính thức | Thử nghiệm trên máy và script Python | Cài các gói phụ thuộc, tải trọng số và tự cung cấp tài nguyên tính toán. |
| Notebook AudioSR Colab | Thử nghiệm bằng GPU đám mây của Google | Mở notebook cộng đồng và làm theo hướng dẫn trong trình duyệt. |
| Hugging Face Space | Demo nhanh trong trình duyệt | Bản triển khai cộng đồng; tình trạng hoạt động và hạn mức GPU có thể thay đổi. |
| AudioSR trên Replicate | Suy luận do dịch vụ vận hành và tích hợp API | Tính phí theo mức sử dụng; không cài mô hình trên máy. |
Neural Analog xử lý riêng thông tin giữa và side của âm thanh stereo. Bạn cũng có thể đặt tần số cắt nơi AudioSR bắt đầu tái tạo chi tiết. Tần số cắt thấp thay đổi nhiều phần âm thanh hơn, còn tần số cắt cao chỉ bổ sung phần tần số cao nhất.
Yêu cầu của AudioSR: Python, bộ nhớ GPU và dung lượng đĩa
AudioSR là mô hình nặng, đặc biệt với cả bài hát. Checkpoint cơ bản chính thức chiếm khoảng 6,2 GB trên đĩa, và suy luận cần nhiều bộ nhớ hơn dung lượng trọng số lưu trữ. GPU NVIDIA có bộ nhớ lớn sẽ hữu ích, nhưng kích thước checkpoint không phải yêu cầu VRAM tối thiểu: độ dài đoạn âm thanh và cách triển khai cũng ảnh hưởng đến bộ nhớ. README chính thức không công bố yêu cầu GPU tối thiểu.
Đầu vào dài có thể làm hết bộ nhớ GPU. Bắt đầu bằng đoạn ngắn, rồi xử lý bản ghi dài hơn theo các đoạn nhỏ.
Chuẩn bị các gói phụ thuộc sau trước khi bắt đầu:
- Python trong môi trường tách biệt. Ví dụ của dự án gốc dùng Python 3.9. Hướng dẫn này dùng Python 3.10, tương thích với các bản NumPy cũ mà AudioSR yêu cầu. Môi trường ảo giữ các gói này tách khỏi Python hệ thống.
- Git và uv. Cài Git và uv để tải mã nguồn và quản lý môi trường Python.
- PyTorch và driver GPU phù hợp. Người dùng NVIDIA cần bản PyTorch tương thích CUDA. Ghép đúng phiên bản PyTorch, TorchAudio và TorchVision theo bảng cài đặt chính thức.
- FFmpeg, gồm cả ffprobe. Mã lưu tệp của dự án gốc dùng các lệnh này. Cài qua các lựa chọn tải FFmpeg và bảo đảm chạy được trong terminal.
- Dung lượng đĩa trống và kết nối Internet. Dành chỗ cho môi trường, trọng số mô hình tải về, tệp đầu vào và đầu ra. Lần đầu tải mô hình sẽ tải checkpoint xuống.
Mã chọn thiết bị của dự án gốc nhận diện CUDA, Apple MPS và CPU. Xử lý bằng CPU có thể rất chậm. Việc kiểm tra thiết bị hỗ trợ MPS không bảo đảm mọi gói phụ thuộc và phép toán hoạt động trên mọi máy Mac.
Cách cài AudioSR từ GitHub
1. Tải repo chính thức và tạo môi trường Python
Chạy các lệnh sau trong terminal:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Kích hoạt môi trường trên Linux hoặc macOS:
source .venv/bin/activateTrên Windows PowerShell, dùng lệnh kích hoạt này thay thế:
.venv\Scripts\Activate.ps12. Cài các gói phụ thuộc tương thích và AudioSR
AudioSR có ràng buộc với các gói cũ, gồm NumPy 1.23.5 hoặc cũ hơn và Transformers 4.30.2. Cài Python và PyTorch mới nhất có thể gây lỗi tương thích. Yêu cầu gói và môi trường tham chiếu của dự án là điểm bắt đầu hữu ích.
Ví dụ, môi trường tham chiếu ghép PyTorch 2.0.1, TorchAudio 2.0.2 và TorchVision 0.15.2. Trên Linux hoặc Windows có driver NVIDIA phù hợp, cài bộ phiên bản CUDA 11.7 đó, rồi cài mã nguồn AudioSR đã lấy từ repo:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
Lệnh CUDA dành cho hệ thống NVIDIA. Với thiết bị khác, dùng hướng dẫn macOS hoặc CPU tương ứng trong bảng PyTorch. Đây là các bản phụ thuộc cũ, nên giữ môi trường này riêng với các dự án Python khác.
Nếu chỉ cần gói đã phát hành, README chính thức cũng trình bày audiosr==0.0.7. Bản đó và nhánh main hiện tại trên GitHub có thể có tính năng khác nhau, nên kiểm tra python -m audiosr --help của phiên bản đã cài.
3. Kiểm tra Python có nhận GPU hay không
Chạy kiểm tra này trong môi trường đã kích hoạt trên máy NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Nếu CUDA không khả dụng, sửa driver hoặc bản cài PyTorch trước khi chạy tác vụ dài. Thêm -d cuda vào AudioSR không thể khiến GPU không khả dụng hoạt động.
Dùng AudioSR qua dòng lệnh: bắt đầu với WAV ngắn
Dùng WAV mono ngắn cho lần chạy đầu. Bộ tải âm thanh của dự án gốc khuyên dùng đầu vào 5,12 giây và cảnh báo về chất lượng khi vượt 10,24 giây. Cả bài hát khiến lỗi thiết lập và bộ nhớ khó chẩn đoán hơn.
Đặt input.wav vào thư mục repo, rồi chạy:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42Mã dòng lệnh lưu đầu ra WAV 48 kHz trong thư mục có dấu thời gian bên trong output. Dùng basic cho âm thanh tổng quát hoặc speech cho bản ghi lời nói. Seed kiểm soát biến thể được tạo; so sánh vài seed có thể giúp chọn kết quả tốt hơn.
Nếu tạo xong nhưng khi lưu báo numpy.ndarray has no attribute cpu, dùng ví dụ Python dưới đây để ghi đầu ra trực tiếp. Trong mã GitHub được kiểm tra cho hướng dẫn này, suy luận trả về mảng NumPy nhưng hàm lưu tệp cần tensor. Đây là sự không khớp kiểu đầu ra của dự án gốc, không phải lỗi bộ nhớ GPU.
Mã GitHub hiện tại cũng hỗ trợ chia đoạn cho tệp dài:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Chia đoạn xử lý các phần nhỏ hơn và trộn những vùng chồng lấn. Nó giảm bộ nhớ nhưng tạo điểm nối cần kiểm tra bằng tai. Các cờ này phụ thuộc phiên bản, và nhánh xử lý chia đoạn của dự án gốc trộn đầu vào stereo xuống mono, nên giữ tệp stereo gốc.
Cách dùng AudioSR từ Python
Dùng API Python để gọi AudioSR từ script của bạn. Ví dụ dưới đây chạy tệp mono ngắn, cắt phần đệm theo thời lượng đầu vào và ghi WAV 48 kHz. Lưu thành run_audiosr.py trong thư mục repo.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyQuy trình Python tải mô hình một lần, nên script xử lý hàng loạt có thể dùng lại. Trong Neural Analog, xử lý hàng loạt áp dụng cùng phép phục hồi cho nhiều tệp mà không cần script. Đặt rõ số bước lấy mẫu vì API Python và CLI có thể dùng giá trị mặc định khác nhau.
Cách chạy AudioSR trong Google Colab
Google Colab cho phép chạy AudioSR trên phần cứng đám mây của Google. Mở notebook AudioSR Colab của cộng đồng và làm theo hướng dẫn để tải âm thanh, chạy mô hình và lưu kết quả. Notebook chạy trong trình duyệt nên máy của bạn không cần cài Python hay có GPU.
Notebook là bản điều chỉnh AudioSR của cộng đồng. Mã nguồn có trên GitHub.
Có thể tải trọng số mô hình AudioSR ở đâu?
Tải trọng số mô hình AudioSR trên Hugging Face.
Chi tiết mô hình AudioSR: kiến trúc, huấn luyện và lịch sử
Ai tạo ra AudioSR?
AudioSR là mô hình siêu phân giải âm thanh sinh tạo của Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang và Mark D. Plumbley. Nó dự đoán tần số cao bị mất trong lời nói, âm nhạc và hiệu ứng âm thanh, rồi tạo âm thanh 48 kHz. Trang nghiên cứu AudioSR có bài báo và ví dụ nghe thử. Công trình xuất hiện đầu tiên dưới dạng bản tiền xuất bản tháng 9 năm 2023, rồi được công bố tại ICASSP 2024.
AudioSR tạo chi tiết hợp lý. Nó không thể khôi phục bản sao chính xác của master phòng thu đã mất. Chuyển MP3 sang WAV 48 kHz hoàn toàn không thực hiện việc tái dựng này. Để hiểu khác biệt, xem hướng dẫn nâng cấp MP3 sang WAV.
Nâng cấp âm thanh, lấy mẫu lại và băng thông là những khái niệm khác nhau
Lấy mẫu lại thay đổi số mẫu biểu diễn mỗi giây âm thanh. Nâng cấp âm thanh, hay siêu phân giải, cố gắng ước tính nội dung tần số mà bản ghi không còn chứa. Ví dụ, lấy mẫu lại bản ghi 8 kHz thành 48 kHz sẽ tăng số mẫu, nhưng tự nó không phục hồi âm thanh trên giới hạn tần số gốc 4 kHz.
Theo mô tả chính thức của dự án, AudioSR nhắm tới đầu vào có băng thông từ 2 đến 16 kHz và tạo đầu ra có băng thông 24 kHz ở tần số lấy mẫu 48 kHz. Băng thông mô tả dải tần, còn tần số lấy mẫu mô tả số mẫu mỗi giây. Tệp ghi nhãn 48 kHz vẫn có thể hẹp băng thông do nén hoặc lọc trước đó. Nhiều bài AI cũng như vậy, và đó là lý do bài Suno thường nghe đục.
AudioSR có phải mô hình nâng cấp âm thanh đầu tiên không?
AudioSR không phải mô hình nâng cấp âm thanh neural đầu tiên. Kuleshov, Enam và Ermon công bố siêu phân giải âm thanh bằng mạng neural năm 2017, và nâng cấp lời nói dựa trên khuếch tán cũng có trước AudioSR.
Đóng góp của nó cụ thể hơn. Bài báo AudioSR giới thiệu đây là hệ thống đầu tiên bao quát miền âm thanh nghe được nói chung: âm nhạc, lời nói và hiệu ứng âm thanh. Nó kết hợp phạm vi rộng đó với băng thông đầu vào linh hoạt, thay vì khai sinh siêu phân giải âm thanh.
Từ bản ghi đầu vào đến dạng sóng 48 kHz
AudioSR kết hợp bộ tự mã hóa biến phân (VAE), mô hình khuếch tán tiềm ẩn có điều kiện và vocoder neural. Mỗi thành phần xử lý một giai đoạn tái dựng:
| Giai đoạn | Quá trình | Vì sao quan trọng |
|---|---|---|
| Biểu diễn âm thanh | Đầu vào trở thành spectrogram mel: bản đồ năng lượng âm thanh theo thời gian và tần số. | Mô hình xử lý các mẫu hình của nội dung tần số. |
| Mã hóa VAE | Bộ mã hóa nén spectrogram thành biểu diễn nhỏ hơn gọi là biểu diễn tiềm ẩn. | Khuếch tán hoạt động trên ít giá trị hơn spectrogram đầy đủ. |
| Khuếch tán có điều kiện | Transformer U-Net lặp lại việc tinh chỉnh biểu diễn tiềm ẩn có nhiễu, dưới định hướng của biểu diễn tiềm ẩn đầu vào độ phân giải thấp. | Bản ghi định hướng chi tiết được tạo; không cần yêu cầu văn bản. |
| Giải mã và vocoder | VAE giải mã ra spectrogram mel độ phân giải cao hơn. Vocoder dựa trên HiFi-GAN chuyển nó thành dạng sóng. | Spectrogram phải được chuyển lại thành các mẫu âm thanh nghe được. |
| Thay thế tần số | Thông tin tần số thấp từ đầu vào thay cho các dải được tạo tương ứng. | Thông tin có sẵn giúp giới hạn thay đổi đối với bản ghi. |
Cấu hình mô hình công bố chỉ định biểu diễn mel 256 dải, VAE và U-Net có các transformer không gian. Nó nối đặc trưng thông thấp đã mã hóa của đầu vào với biểu diễn tiềm ẩn khuếch tán. Đây là sinh tạo với điều kiện âm thanh, dù một số mô tả CLI được kế thừa có nhắc đến văn bản.
Số bước lấy mẫu và định hướng điều khiển điều gì?
Số bước lấy mẫu quyết định số lần mô hình lặp để tinh chỉnh biểu diễn được tạo. AudioSR dùng bộ lấy mẫu DDIM. Định hướng quyết định điều kiện đầu vào dẫn dắt việc sinh tạo mạnh tới mức nào. Nó không phải mức EQ, và giá trị cao hơn không bảo đảm chất lượng cao hơn. Mã suy luận lần lượt áp dụng lấy mẫu, giải mã, thay thế tần số và chuẩn hóa dạng sóng.
Nhiều bước lấy mẫu hơn và bản ghi dài hơn cần nhiều thời gian xử lý hơn. AudioSR dành cho xử lý ngoài thời gian thực, và tốc độ thực tế phụ thuộc GPU cùng cài đặt. Giảm ddim_steps làm sinh tạo nhanh hơn, nhưng không chắc giải quyết được lỗi bộ nhớ GPU.
AudioSR được huấn luyện thế nào?
Phần huấn luyện của bài báo mô tả khoảng 7.000 giờ từ MUSDB18-HQ, MoisesDB, MedleyDB, Freesound và dữ liệu lời nói OpenSLR. Bộ lọc thông thấp với nhiều tần số cắt tạo đầu vào suy giảm chất lượng, ghép với mục tiêu có băng thông đầy đủ hơn. Mô hình khuếch tán dùng lịch nhiễu cosin, dự đoán vận tốc và định hướng không dùng bộ phân loại. Vocoder dựa trên HiFi-GAN với bộ phân biệt đa độ phân giải.
Bản ghi thực tế có thể khác các ví dụ huấn luyện này. Tác giả giải thích rằng tần số cắt không đều, nhiễu nặng và reverb có thể giảm chất lượng. Nén MP3 có thể để lại khoảng trống gần tần số cắt. Lọc thông thấp trước suy luận có thể hữu ích, nhưng đặt tần số cắt quá thấp làm mất chi tiết có ích. Với bản ghi có reverb, loại bỏ reverb trước khi nâng cấp có thể cho mô hình đầu vào sạch hơn.
Bạn không cần huấn luyện các thành phần này để chạy AudioSR. Quy trình cài đặt tải trọng số đã huấn luyện sẵn.
Vì sao AudioSR dùng hậu xử lý?
Âm thanh được tạo nên giữ thông tin có ích vốn có trong nguồn. AudioSR thay các dải thấp hai lần: trong spectrogram mel ước tính trước vocoder, và trong biểu diễn biến đổi Fourier thời gian ngắn (STFT) của dạng sóng đầu ra. Mã thay thế ước tính tần số cắt và điều chỉnh đầu ra tái dựng.
Bản ghi stereo và cả bài hát cần quy trình xử lý kênh, chia đoạn và tái dựng. Quy trình mặc định của repo tạo âm thanh mono: bộ tải tiêu chuẩn lấy kênh đầu vào đầu tiên, còn quy trình chia đoạn trộn stereo xuống mono. Giữ stereo cần xử lý kênh bổ sung, chẳng hạn xử lý riêng kênh trái và phải như notebook cộng đồng.
Tái dựng cần kiểm tra bằng cách nghe. Ghi chú quy trình cộng đồng cảnh báo chồng lấn quá nhiều có thể gây triệt tiêu pha. So sánh kết quả ở độ lớn tương tự và kiểm tra tần số cao được tái tạo, điểm nối đoạn, thời lượng và hình ảnh stereo. Thay thế tần số giúp giữ nguồn, nhưng không bảo đảm dải thấp không đổi hoặc điểm nối sạch.
Câu hỏi thường gặp khi xử lý lỗi AudioSR
AudioSR có trên PyPI không?
Có. README chính thức cài audiosr==0.0.7 bằng pip, hoặc mã mới nhất trực tiếp từ GitHub. Nhánh main GitHub có những tính năng như chia đoạn mà bản PyPI có thể chưa có.
AudioSR cần bao nhiêu bộ nhớ GPU?
README không đưa mức tối thiểu. Riêng checkpoint cơ bản đã chiếm khoảng 6,2 GB trên đĩa, và bộ nhớ tăng theo độ dài đoạn. Bắt đầu với đoạn khoảng 5 giây, rồi dùng chia đoạn cho tệp dài hơn.
Vì sao AudioSR lỗi numpy.ndarray has no attribute cpu?
Suy luận đã xong, nhưng bước lưu cần tensor PyTorch lại nhận mảng NumPy. Dùng script Python ở trên, ghi đầu ra bằng soundfile.
Vì sao đầu ra AudioSR là mono?
Bộ tải mặc định chỉ đọc kênh đầu tiên, còn nhánh chia đoạn trộn stereo xuống mono. Xử lý riêng kênh trái và phải, hoặc dùng AudioSR trực tuyến, nơi xử lý kênh mid và side cho bạn.
Mã huấn luyện AudioSR có sẵn không?
Có. Nhật ký thay đổi ngày 31 tháng 12 năm 2024 trong README liên kết tới mã huấn luyện, được tác giả mô tả là chỉ để tham khảo và chưa được tổ chức cẩn thận.
Chạy AudioSR bằng Neural Analog thay vì tự quản lý cài đặt
Để bỏ thiết lập trên máy, mở AudioSR trực tuyến, tải tệp lên hoặc nhập liên kết nhạc được hỗ trợ và điều chỉnh cài đặt phục hồi. Với Udio, lưu hoặc ghi âm trước rồi tải tệp lên. Bạn có thể chọn tần số cắt, nghe thử kết quả xử lý và xuất âm thanh trong cùng giao diện.
Neural Analog xử lý mô hình trực tuyến, nên bạn có thể dùng máy không có GPU lớn và bỏ qua cài Python, tải checkpoint, bảo trì notebook. Bạn vẫn cần nghe kỹ, vì quy trình chạy trên dịch vụ không xóa giới hạn chất lượng của mô hình. Sau phục hồi, làm theo hướng dẫn cải thiện âm thanh cho bước tiếp theo. Với nhạc AI, sửa chất lượng âm thanh bài AI trình bày việc sửa stem và mastering sau nâng cấp.
Bạn cũng có thể so sánh AudioSR với các mô hình nâng cấp âm thanh mới hơn trên Neural Analog, gồm UniverSR và FlashSR. Thẻ mô hình giải thích cách từng mô hình hoạt động, còn câu hỏi thường gặp tóm tắt UniverSR khác AudioSR thế nào. Để xem ví dụ hoàn chỉnh, đọc toàn bộ 203 hiệu ứng âm thanh RPG Maker 2000 được phục hồi lên 48 kHz bằng UniverSR. Chạy trên cùng bản ghi và so sánh bản nghe thử để chọn kết quả tốt nhất.