Installer AudioSR depuis GitHub : exécuter AudioSR en local
AudioSR est un modèle open source de super-résolution audio. Il génère les détails manquants dans les hautes fréquences de la parole, de la musique et des effets sonores pour produire un audio à 48 kHz. Vous pouvez l'installer depuis le dépôt GitHub officiel ou utiliser AudioSR en ligne avec Neural Analog.
Pour l'installer en local, clonez le dépôt, créez un environnement Python 3.10 avec uv, installez une version compatible de PyTorch et AudioSR, puis lancez python -m audiosr sur un court fichier WAV. Les étapes ci-dessous présentent chaque commande.
Comment fonctionne AudioSR ? Son architecture expliquée
Comment AudioSR reconstruit les hautes fréquences manquantes
Le spectrogramme mel d'entrée conditionne la diffusion latente pour estimer un spectrogramme mel au contenu fréquentiel plus étendu. Les bandes mel basses de l'entrée remplacent celles générées avant le vocodeur ; ses bandes STFT basses remplacent celles générées après le vocodeur. Le modèle génère des détails manquants plausibles, sans retrouver à l'identique un enregistrement perdu.
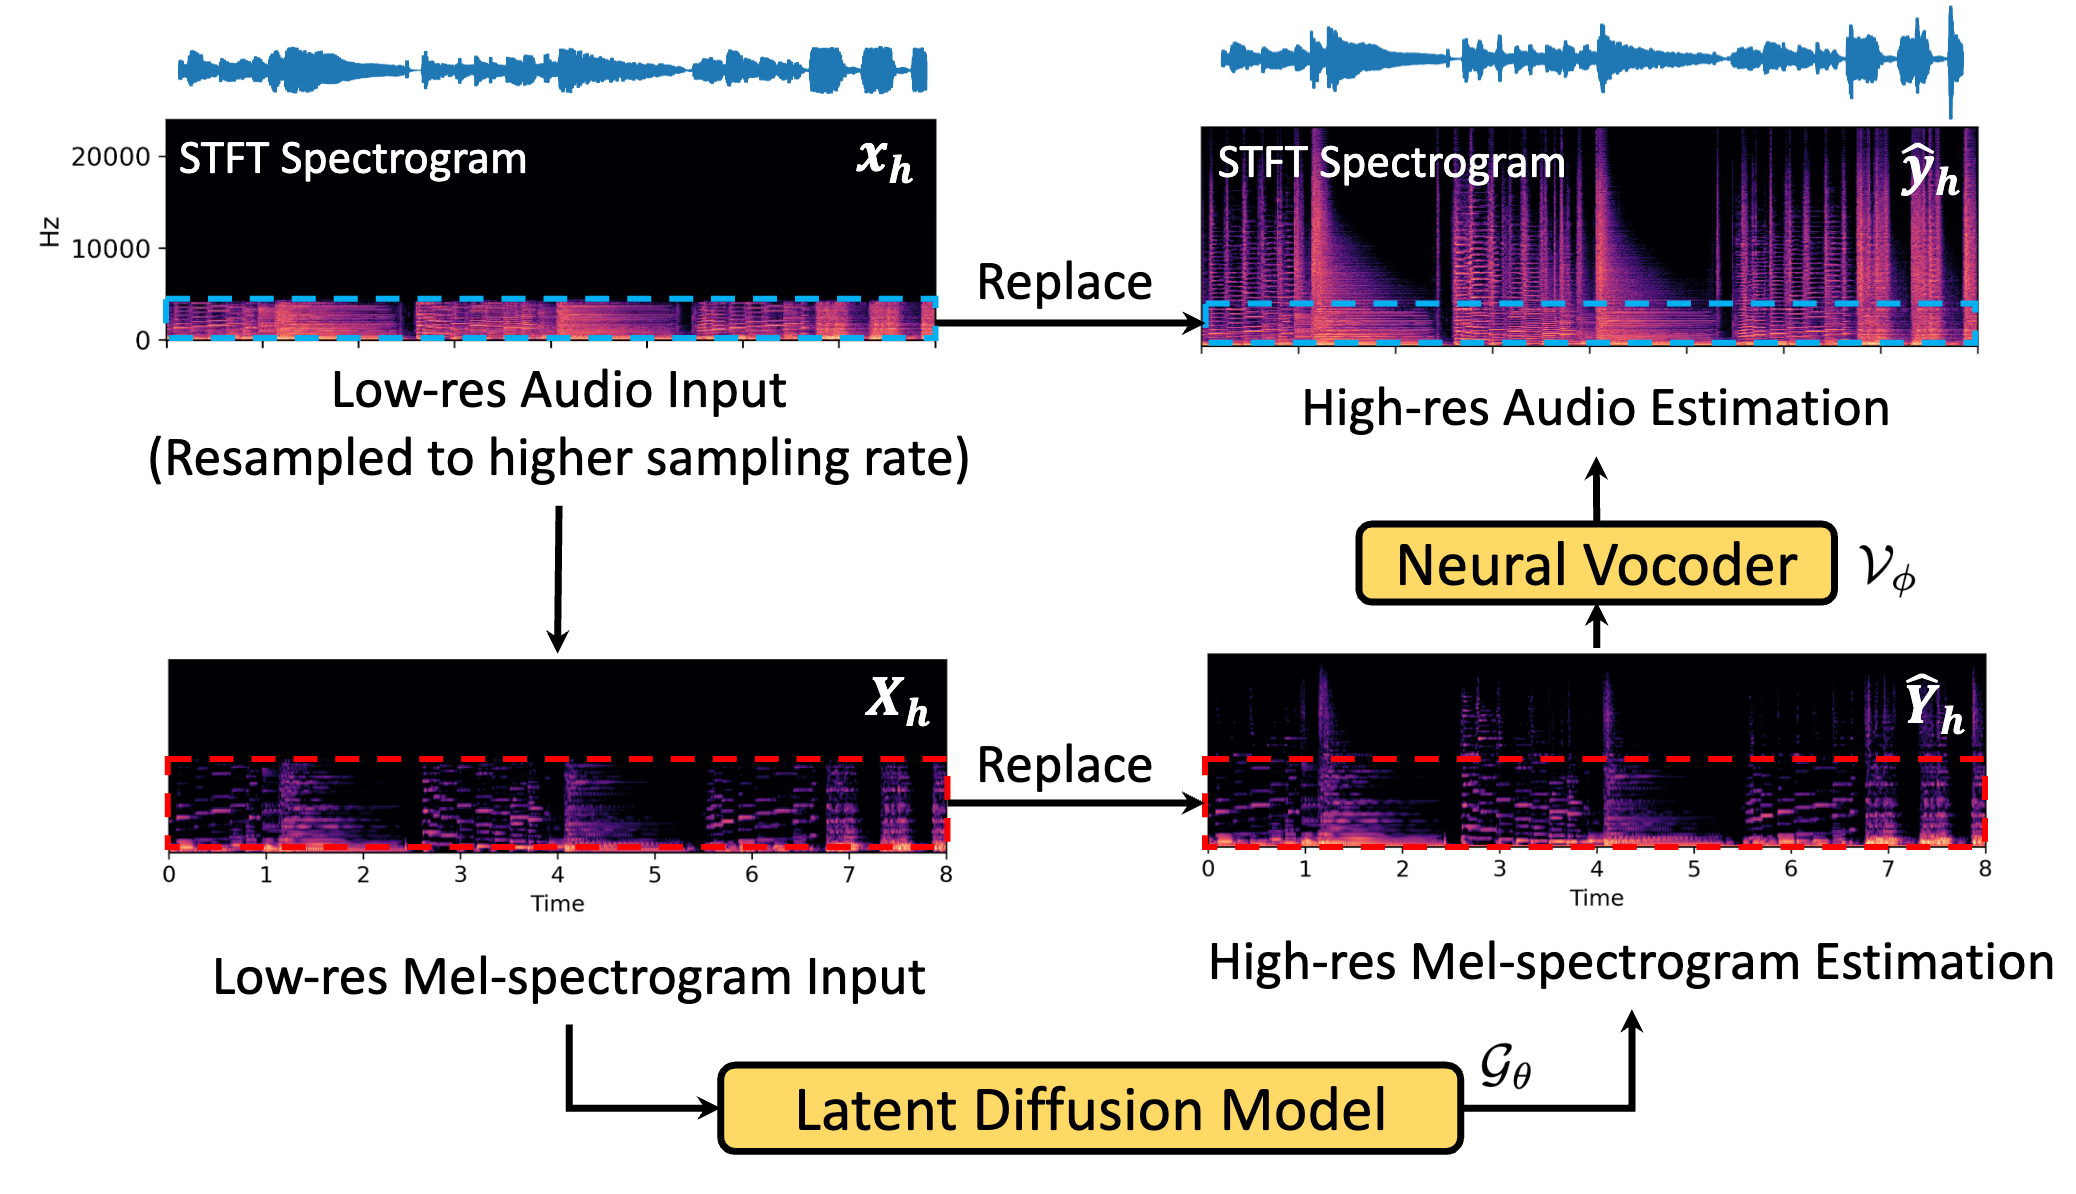
Figure originale: AudioSR.
AudioSR convertit l'enregistrement en spectrogramme mel, utilise un modèle de diffusion latente pour estimer les détails manquants dans les hautes fréquences, puis transforme le résultat en forme d'onde avec un vocodeur. Le post-traitement remet ensuite les basses fréquences originales de la source à la place de celles générées. Le résultat est une reconstruction plausible, pas une récupération exacte de l'audio perdu, et il ne s'agit pas simplement de bruit ajouté.
Où peut-on exécuter AudioSR ?
| Option | Usage adapté | Installation et compromis |
|---|---|---|
| Neural Analog AudioSR en ligne (recommandé) | Restauration stéréo avec traitement centre/différence et fréquence de coupure personnalisable | Importez, préécoutez et exportez en ligne. Aucune installation de Python ni carte graphique locale nécessaire. |
| Dépôt GitHub officiel | Expérimentations locales et scripts Python | Installez les dépendances, téléchargez les poids et fournissez les ressources de calcul. |
| Notebook AudioSR Colab | Expérimentations sur les GPU de Google dans le cloud | Ouvrez le notebook communautaire et suivez ses instructions dans votre navigateur. |
| Space Hugging Face | Démonstration rapide dans le navigateur | Déploiement communautaire ; la disponibilité et les quotas GPU peuvent changer. |
| AudioSR sur Replicate | Prédictions hébergées et intégration par API | Facturation à l'usage ; aucune installation locale du modèle. |
Neural Analog traite séparément le signal central et le signal de différence de l'audio stéréo. Vous pouvez aussi définir la fréquence de coupure à partir de laquelle AudioSR régénère les détails. Une coupure plus basse modifie davantage le son, tandis qu'une coupure plus haute ne complète que l'extrême aigu.
Prérequis AudioSR : Python, mémoire GPU et espace disque
AudioSR est un modèle lourd, surtout pour des morceaux complets. Le checkpoint de base officiel occupe environ 6,2 Go sur disque, et l'inférence demande plus de mémoire que les poids stockés. Un GPU NVIDIA doté de beaucoup de mémoire est utile, mais la taille du checkpoint ne constitue pas un minimum de VRAM : la durée de l'extrait et l'implémentation influencent aussi la consommation de mémoire. Le README officiel ne publie pas de configuration GPU minimale.
Des entrées longues peuvent épuiser la mémoire GPU. Commencez par un court extrait, puis traitez les enregistrements plus longs par petits segments.
Préparez ces dépendances avant de commencer :
- Python dans un environnement isolé. L'exemple du projet d'origine utilise Python 3.9. Ce guide utilise Python 3.10, compatible avec les anciennes versions de NumPy requises par AudioSR. Un environnement virtuel sépare ces paquets du Python de votre système.
- Git et uv. Installez Git et uv pour télécharger les sources et gérer l'environnement Python.
- PyTorch et un pilote GPU adapté. Les utilisateurs de NVIDIA ont besoin d'une version de PyTorch compatible avec CUDA. Faites correspondre les versions de PyTorch, TorchAudio et TorchVision à l'aide du tableau d'installation officiel.
- FFmpeg, y compris ffprobe. Le code de sauvegarde du projet d'origine utilise ces commandes. Installez-les avec les options de téléchargement de FFmpeg et rendez-les accessibles dans votre terminal.
- De l'espace disque libre et une connexion internet. Prévoyez de la place pour l'environnement, les poids téléchargés, les fichiers d'entrée et les résultats. Le premier chargement du modèle télécharge son checkpoint.
Le code de sélection du périphérique du projet d'origine reconnaît CUDA, Apple MPS et le CPU. Le traitement sur CPU peut être très lent. La prise en compte de MPS lors de la vérification du périphérique ne garantit pas que toutes les dépendances et opérations fonctionnent sur tous les Mac.
Installer AudioSR depuis GitHub
1. Télécharger le dépôt officiel et créer un environnement Python
Exécutez ces commandes dans un terminal :
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Activez l'environnement sous Linux ou macOS :
source .venv/bin/activateSous Windows PowerShell, utilisez plutôt cette commande d'activation :
.venv\Scripts\Activate.ps12. Installer des dépendances compatibles et AudioSR
AudioSR impose des contraintes de dépendances anciennes, notamment NumPy 1.23.5 ou une version antérieure et Transformers 4.30.2. Installer les versions les plus récentes de Python et PyTorch peut provoquer des erreurs de compatibilité. Les dépendances du paquet et l'environnement de référence du projet constituent des points de départ utiles.
Par exemple, l'environnement de référence associe PyTorch 2.0.1, TorchAudio 2.0.2 et TorchVision 0.15.2. Sous Linux ou Windows avec un pilote NVIDIA adapté, installez cette combinaison pour CUDA 11.7, puis les sources AudioSR que vous avez récupérées :
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
La commande CUDA concerne les systèmes NVIDIA. Pour macOS ou le CPU, utilisez les instructions correspondantes du tableau PyTorch. Ces versions de dépendances sont anciennes : gardez donc cet environnement séparé de vos autres projets Python.
Si vous avez seulement besoin du paquet publié, le README officiel décrit aussi audiosr==0.0.7. Cette version et la branche main actuelle de GitHub peuvent proposer des fonctionnalités différentes ; vérifiez donc python -m audiosr --help pour la version installée.
3. Vérifier que Python détecte votre GPU
Lancez cette vérification dans l'environnement activé sur une machine NVIDIA :
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Si CUDA est indisponible, corrigez l'installation du pilote ou de PyTorch avant de lancer un long traitement. Ajouter -d cuda à AudioSR ne rend pas utilisable un GPU indisponible.
Utiliser AudioSR en ligne de commande : commencer par un court WAV
Utilisez un court WAV mono pour le premier essai. Le chargeur audio du projet d'origine recommande des entrées de 5,12 secondes et avertit d'une baisse de qualité au-delà de 10,24 secondes. Un morceau complet rend les problèmes d'installation et de mémoire plus difficiles à diagnostiquer.
Placez input.wav dans le répertoire du dépôt, puis lancez :
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42L'implémentation de la ligne de commande enregistre un WAV à 48 kHz dans un dossier horodaté sous output. Utilisez basic pour l'audio général ou speech pour les enregistrements parlés. La graine contrôle les variations générées ; comparer plusieurs graines peut vous aider à choisir un meilleur résultat.
Si la génération se termine mais que l'enregistrement provoque l'erreur numpy.ndarray has no attribute cpu, utilisez l'exemple Python ci-dessous pour écrire directement le résultat. Dans les sources GitHub vérifiées pour ce guide, l'inférence renvoie un tableau NumPy, mais la fonction d'enregistrement attend un tenseur. Il s'agit d'une incompatibilité du type de sortie dans le projet d'origine, pas d'une erreur de mémoire GPU.
Le code GitHub actuel propose aussi un découpage en segments pour les fichiers plus longs :
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Ce découpage traite de petites sections et mélange leurs chevauchements. Il réduit la consommation de mémoire, mais ajoute des raccords à vérifier à l'écoute. Ces options dépendent de la version, et le traitement par segments du projet d'origine réduit l'entrée stéréo en mono ; conservez donc le fichier stéréo original.
Utiliser AudioSR depuis Python
Utilisez l'API Python pour appeler AudioSR depuis votre propre script. L'exemple ci-dessous traite un court fichier mono, retire le remplissage ajouté pour retrouver la durée d'entrée et écrit un WAV à 48 kHz. Enregistrez-le sous run_audiosr.py dans le répertoire du dépôt.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyLe pipeline Python charge le modèle une seule fois, ce qui permet à un script de traitement par lot de le réutiliser. Dans Neural Analog, le traitement par lot applique une restauration à de nombreux fichiers sans script. Définissez explicitement le nombre d'étapes d'échantillonnage, car l'API Python et la ligne de commande peuvent utiliser des valeurs par défaut différentes.
Exécuter AudioSR dans Google Colab
Google Colab permet d'exécuter AudioSR sur le matériel de Google dans le cloud. Ouvrez le notebook AudioSR Colab communautaire et suivez ses instructions pour charger votre audio, lancer le modèle et enregistrer le résultat. Le notebook s'exécute dans votre navigateur : vous n'avez besoin ni d'installer Python ni d'un GPU sur votre ordinateur.
Le notebook est une adaptation communautaire d'AudioSR. Ses sources sont disponibles sur GitHub.
Où télécharger les poids du modèle AudioSR ?
Téléchargez les poids du modèle AudioSR sur Hugging Face.
Le modèle AudioSR en détail : architecture, entraînement et histoire
Qui a créé AudioSR ?
AudioSR est un modèle génératif de super-résolution audio créé par Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang et Mark D. Plumbley. Il prédit les hautes fréquences manquantes de la parole, de la musique et des effets sonores et produit un audio à 48 kHz. La page de recherche AudioSR comprend l'article et des exemples d'écoute. Les travaux ont d'abord été présentés dans une prépublication de septembre 2023, puis publiés à ICASSP 2024.
AudioSR génère des détails plausibles. Il ne peut pas retrouver une copie exacte d'un master de studio perdu. Convertir un MP3 en WAV à 48 kHz n'effectue aucune de ces reconstructions. Pour comprendre cette distinction, consultez le guide de restauration de fichiers MP3 en WAV.
Restauration audio, rééchantillonnage et bande passante sont différents
Le rééchantillonnage change le nombre d'échantillons qui représentent chaque seconde d'audio. La restauration audio, ou super-résolution, tente d'estimer le contenu fréquentiel que l'enregistrement ne contient plus. Par exemple, rééchantillonner un enregistrement de 8 kHz à 48 kHz lui donne plus d'échantillons, mais ne restaure pas à lui seul les sons au-dessus de sa limite fréquentielle originale de 4 kHz.
AudioSR vise des bandes passantes d'entrée de 2 à 16 kHz et génère une sortie avec une bande passante de 24 kHz à une fréquence d'échantillonnage de 48 kHz, selon la description officielle du projet. La bande passante décrit l'étendue des fréquences ; la fréquence d'échantillonnage décrit le nombre d'échantillons par seconde. Un fichier étiqueté 48 kHz peut encore avoir une bande passante étroite à cause d'une compression ou d'un filtrage antérieurs. C'est le cas de nombreux morceaux générés par IA, ce qui explique pourquoi les morceaux Suno sonnent souvent étouffés.
AudioSR était-il le premier modèle de restauration audio ?
AudioSR n'était pas le premier modèle neuronal de super-résolution audio. Kuleshov, Enam et Ermon ont publié Super-résolution audio à l'aide de réseaux neuronaux en 2017, et la super-résolution de la parole par diffusion existait aussi avant AudioSR.
Sa contribution est plus précise. L'article AudioSR le présente comme le premier système couvrant tout le domaine audible : musique, parole et effets sonores. Il associe cette étendue à une bande passante d'entrée flexible, sans avoir inventé la super-résolution audio elle-même.
De l'enregistrement d'entrée à une forme d'onde à 48 kHz
AudioSR combine un autoencodeur variationnel (VAE), un modèle de diffusion latente conditionnelle et un vocodeur neuronal. Chaque composant prend en charge une étape de la reconstruction :
| Étape | Ce qui se passe | Pourquoi c'est utile |
|---|---|---|
| Représentation audio | L'entrée devient un spectrogramme mel : une carte de l'énergie sonore selon le temps et la fréquence. | Le modèle travaille sur les motifs du contenu fréquentiel. |
| Encodage VAE | Un encodeur compresse le spectrogramme en une représentation plus petite appelée latent. | La diffusion travaille sur moins de valeurs qu'avec un spectrogramme complet. |
| Diffusion conditionnelle | Un Transformer U-Net affine progressivement un latent bruité, guidé par le latent d'entrée de faible résolution. | L'enregistrement guide les détails générés ; aucun prompt textuel n'est nécessaire. |
| Décodage et vocodeur | Le VAE décode un spectrogramme mel de plus haute résolution. Un vocodeur fondé sur HiFi-GAN le transforme en forme d'onde. | Un spectrogramme doit être reconverti en échantillons audibles. |
| Remplacement fréquentiel | Les informations basses fréquences de l'entrée remplacent les bandes générées correspondantes. | Les informations existantes aident à limiter les changements apportés à l'enregistrement. |
La configuration publiée du modèle décrit une représentation mel à 256 bandes, un VAE et un U-Net avec des transformers spatiaux. Elle concatène les caractéristiques passe-bas encodées de l'entrée avec le latent de diffusion. Il s'agit d'une génération conditionnée par l'audio, même si certaines descriptions héritées de la ligne de commande mentionnent du texte.
Que contrôlent les étapes d'échantillonnage et le guidage ?
Les étapes d'échantillonnage déterminent combien d'itérations le modèle consacre à affiner sa représentation générée. AudioSR utilise un échantillonneur DDIM. Le guidage contrôle la force avec laquelle le conditionnement par l'entrée oriente la génération. Ce n'est pas une quantité d'EQ, et une valeur plus élevée ne garantit pas une meilleure qualité. L'implémentation de l'inférence applique successivement l'échantillonnage, le décodage, le remplacement fréquentiel et la normalisation de la forme d'onde.
Davantage d'étapes d'échantillonnage et des enregistrements plus longs prennent plus de temps de traitement. AudioSR est conçu pour un traitement hors temps réel, et sa vitesse dépend de votre GPU et des réglages. Réduire ddim_steps accélère la génération, mais ne résout pas de façon fiable les erreurs de mémoire GPU.
Comment AudioSR a-t-il été entraîné ?
La section de l'article consacrée à l'entraînement décrit environ 7 000 heures provenant de MUSDB18-HQ, MoisesDB, MedleyDB, Freesound et des données de parole OpenSLR. Des filtres passe-bas aux fréquences de coupure variées créent des entrées dégradées associées à des cibles de bande passante plus étendue. Le modèle de diffusion utilise une loi d'évolution du bruit en cosinus, la prédiction de vitesse et un guidage sans classifieur. Le vocodeur est fondé sur HiFi-GAN avec un discriminateur multi-résolution.
Les enregistrements réels peuvent différer de ces exemples d'entraînement. Les auteurs expliquent que des coupures fréquentielles irrégulières, un bruit important et la réverbération peuvent réduire la qualité. La compression MP3 peut laisser des trous près de la coupure. Un filtrage passe-bas avant l'inférence peut aider, mais une coupure trop basse supprime des détails utiles. Pour les enregistrements réverbérants, retirer la réverbération avant la restauration peut fournir une entrée plus propre au modèle.
Vous n'avez pas besoin d'entraîner ces composants pour exécuter AudioSR. L'installation charge des poids préentraînés.
Pourquoi AudioSR utilise-t-il un post-traitement ?
L'audio généré doit conserver les informations utiles déjà présentes dans la source. AudioSR remplace les bandes basses à deux reprises : dans le spectrogramme mel estimé avant le vocodeur et dans la représentation par transformée de Fourier à court terme (STFT) de la forme d'onde obtenue. Le code de remplacement estime une coupure et ajuste la sortie reconstruite.
Les enregistrements stéréo et les morceaux complets nécessitent un pipeline qui gère les canaux, les segments et la reconstruction. Le traitement par défaut du dépôt produit un audio mono : le chargeur standard prend le premier canal d'entrée, tandis que le pipeline par segments réduit la stéréo en mono par mixage. Préserver la stéréo exige une gestion supplémentaire des canaux, comme le traitement séparé des canaux gauche et droit dans le notebook communautaire.
La reconstruction doit être vérifiée à l'écoute. Les notes du pipeline communautaire avertissent qu'un chevauchement excessif peut provoquer des annulations de phase. Comparez le résultat à un niveau sonore similaire et vérifiez les aigus régénérés, les raccords entre segments, la durée et l'image stéréo. Le remplacement fréquentiel aide à préserver la source, mais ne garantit ni des bandes basses inchangées ni des raccords propres.
FAQ de dépannage AudioSR
AudioSR est-il disponible sur PyPI ?
Oui. Le README officiel installe audiosr==0.0.7 avec pip, ou le code le plus récent directement depuis GitHub. La branche main de GitHub propose des fonctionnalités, comme le découpage en segments, qui peuvent manquer dans la version PyPI.
De combien de mémoire GPU AudioSR a-t-il besoin ?
Le README ne donne pas de minimum. Le checkpoint de base occupe à lui seul environ 6,2 Go sur disque, et la consommation de mémoire augmente avec la durée de l'extrait. Commencez par un extrait d'environ 5 secondes, puis utilisez le découpage en segments pour les fichiers plus longs.
Pourquoi AudioSR échoue-t-il avec l'erreur numpy.ndarray has no attribute cpu ?
L'inférence est terminée, mais l'étape d'enregistrement attend un tenseur PyTorch et reçoit un tableau NumPy. Utilisez le script Python ci-dessus, qui écrit la sortie avec soundfile.
Pourquoi ma sortie AudioSR est-elle mono ?
Le chargeur par défaut ne lit que le premier canal, et le traitement par segments réduit la stéréo en mono. Traitez les canaux gauche et droit séparément ou utilisez AudioSR en ligne, qui traite les canaux central et de différence pour vous.
Le code d'entraînement d'AudioSR est-il disponible ?
Oui. Le journal des modifications du README daté du 31 décembre 2024 contient un lien vers le code d'entraînement, que l'auteur décrit comme fourni uniquement à titre de référence et non organisé avec soin.
Utiliser AudioSR avec Neural Analog plutôt que gérer l'installation
Pour éviter l'installation locale, ouvrez AudioSR en ligne, importez un fichier ou une URL musicale prise en charge et ajustez les réglages de restauration. Pour Udio, enregistrez ou capturez d'abord l'audio, puis importez le fichier. Vous pouvez choisir une fréquence de coupure, préécouter le résultat traité et exporter l'audio depuis la même interface.
Neural Analog gère le traitement du modèle en ligne. Vous pouvez donc utiliser un ordinateur sans gros GPU et éviter l'installation de Python, le téléchargement des checkpoints et la maintenance des notebooks. Vous devez toujours écouter de manière critique, car une solution hébergée ne supprime pas les limites de qualité du modèle. Après la restauration, consultez le guide d'amélioration audio pour la suite. Pour la musique générée par IA, corriger la qualité audio des morceaux IA traite de la réparation des pistes et du mastering après la restauration.
Vous pouvez aussi comparer AudioSR aux modèles de restauration audio plus récents disponibles sur Neural Analog, notamment UniverSR et FlashSR. Leurs fiches décrivent le fonctionnement de chaque modèle, et la FAQ résume les différences entre UniverSR et AudioSR. Pour un exemple complet, consultez les 203 effets sonores de RPG Maker 2000 restaurés à 48 kHz avec UniverSR. Appliquez-les au même enregistrement et comparez les préécoutes pour choisir le meilleur résultat.