Установка AudioSR с GitHub: как запустить AudioSR локально
AudioSR — модель сверхразрешения аудио с открытым исходным кодом. Она генерирует отсутствующие высокочастотные детали речи, музыки и звуковых эффектов, создавая аудио с частотой дискретизации 48 kHz. Её можно установить из официального репозитория GitHub или запустить AudioSR онлайн в Neural Analog.
Для локальной установки клонируйте репозиторий, создайте окружение Python 3.10 с uv, установите совместимую сборку PyTorch и AudioSR, затем запустите python -m audiosr на коротком WAV-файле. Ниже разобрана каждая команда.
Как работает AudioSR? Объяснение архитектуры
Как AudioSR восстанавливает отсутствующие высокие частоты
Входная мел-спектрограмма задаёт условия латентной диффузии для оценки мел-спектрограммы с более широкой полосой частот. Перед вокодером нижние мел-полосы источника заменяют сгенерированные; после вокодера его нижние STFT-полосы заменяют сгенерированные. Модель создаёт правдоподобные отсутствующие детали, а не восстанавливает точную копию утраченной записи.
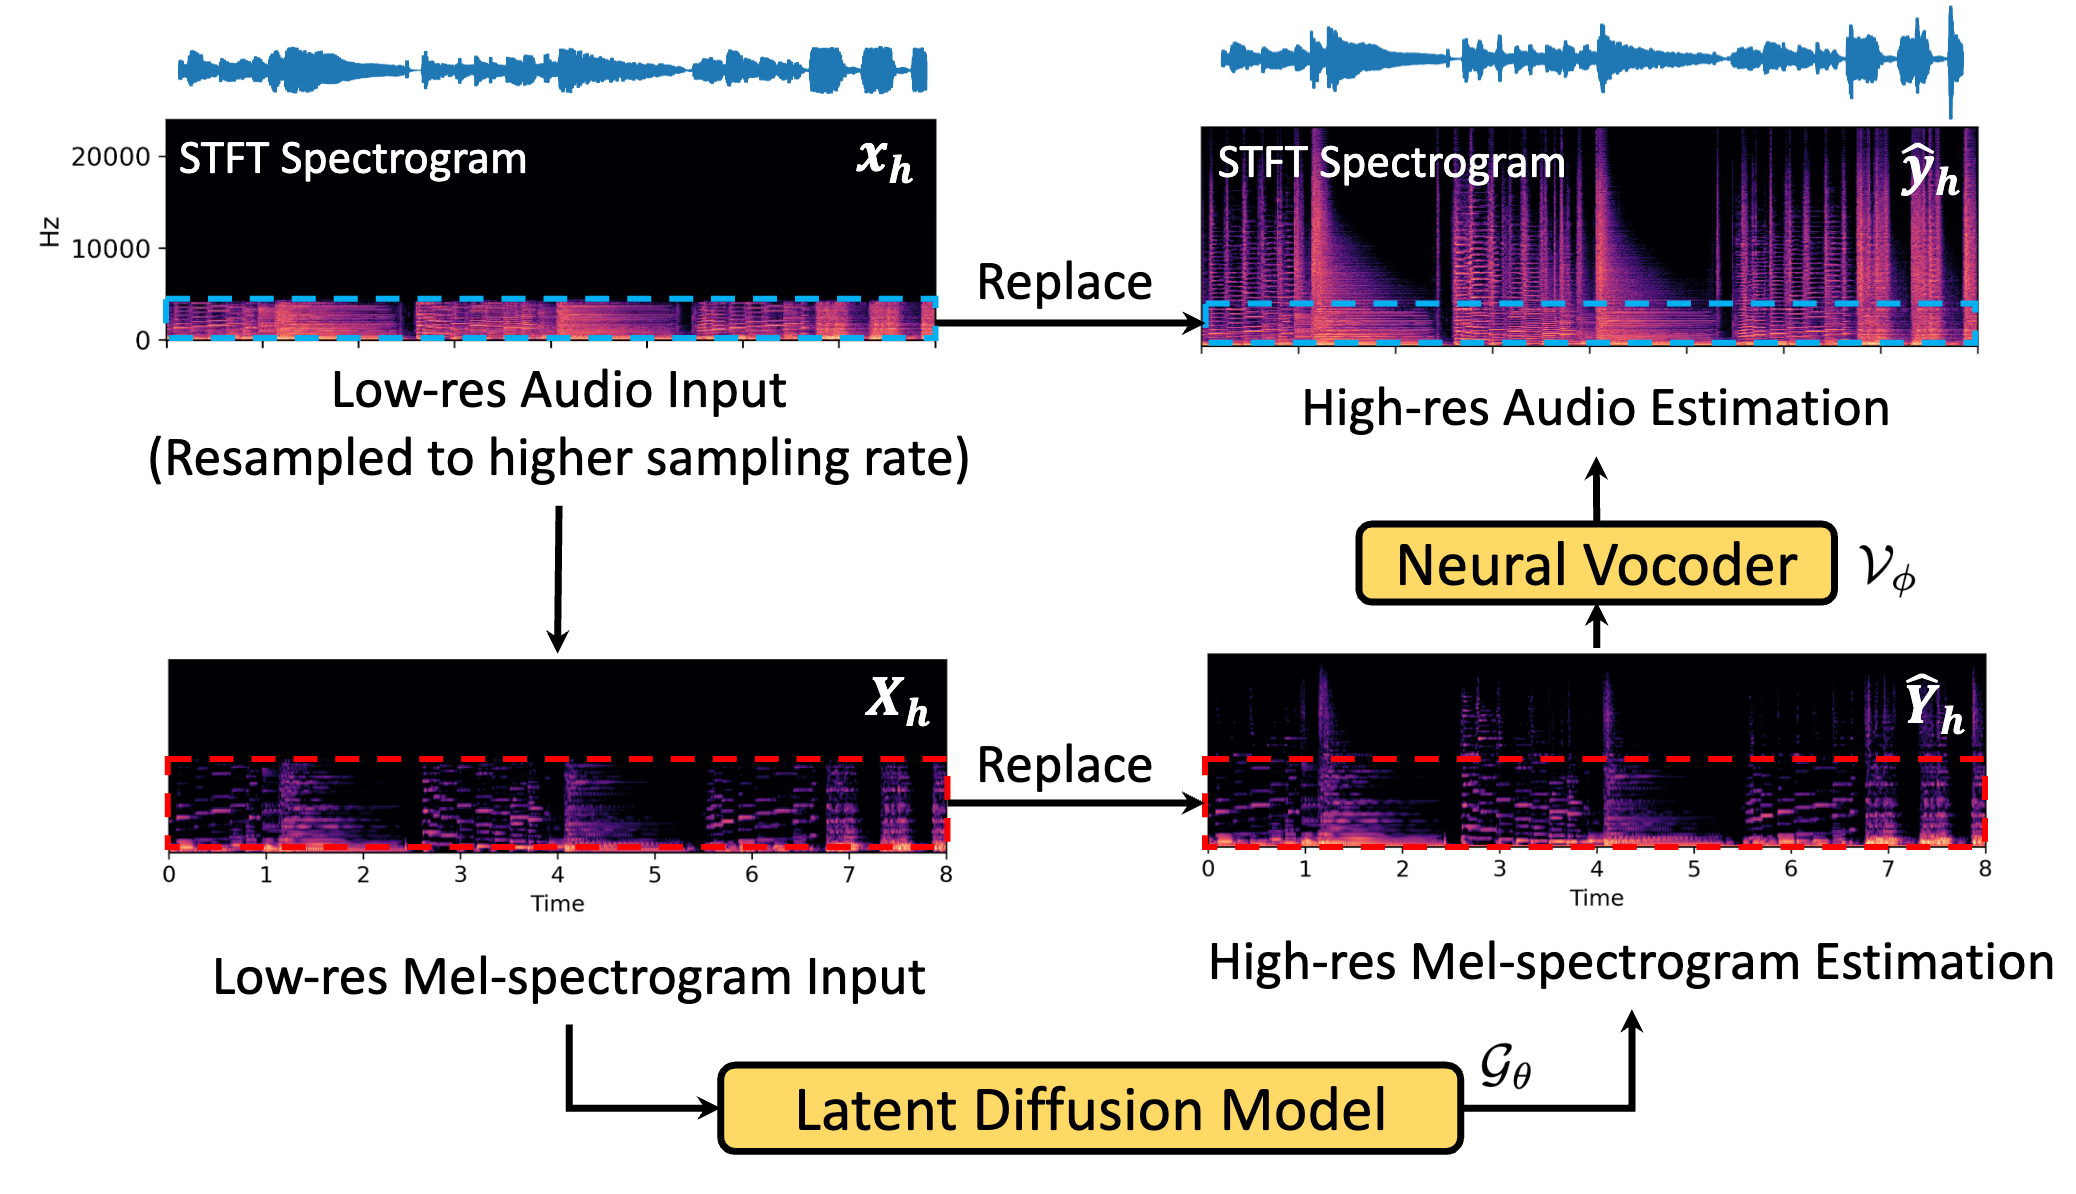
Оригинальная иллюстрация: AudioSR.
AudioSR превращает запись в мел-спектрограмму, оценивает отсутствующие высокочастотные детали с помощью модели латентной диффузии и преобразует результат обратно в волновую форму через вокодер. Затем постобработка возвращает исходные низкие частоты на место сгенерированных. Результат — правдоподобная реконструкция, а не точное восстановление утраченного аудио; модель не просто добавляет шум.
Где можно запустить AudioSR?
| Вариант | Для чего подходит | Установка и компромиссы |
|---|---|---|
| Neural Analog AudioSR Online (рекомендуется) | Восстановление стерео с обработкой центра и разностного сигнала и настраиваемой частотой среза | Загрузка, прослушивание и экспорт онлайн. Python и локальный GPU не нужны. |
| Официальный репозиторий GitHub | Локальные эксперименты и Python-скрипты | Установите зависимости, скачайте веса и обеспечьте вычислительные ресурсы. |
| Блокнот AudioSR Colab | Эксперименты на облачных GPU Google | Откройте блокнот сообщества и следуйте инструкциям в браузере. |
| Hugging Face Space | Быстрая демонстрация в браузере | Развёртывание сообщества; доступность и квоты GPU могут меняться. |
| AudioSR на Replicate | Запуск модели на хостинге и интеграция через API | Оплата по использованию; локальная установка модели не нужна. |
Neural Analog отдельно обрабатывает центральную и разностную составляющие стерео. Можно также задать частоту среза, с которой AudioSR начинает заново генерировать детали. Более низкий срез меняет большую часть звука, а более высокий дополняет лишь верхние частоты.
Требования AudioSR: Python, память GPU и место на диске
AudioSR — тяжёлая модель, особенно для полных песен. Официальный базовый чекпойнт занимает около 6,2 GB на диске, а для выполнения модели требуется больше памяти, чем занимают сохранённые веса. Мощный NVIDIA GPU помогает, но размер чекпойнта не означает минимальный объём VRAM: расход памяти зависит также от длины фрагмента и реализации. Официальный README не указывает минимальные требования к GPU.
Длинные записи могут исчерпать память GPU. Начните с короткого фрагмента, затем обрабатывайте длинные записи небольшими частями.
Перед началом подготовьте зависимости:
- Python в изолированном окружении. Пример разработчиков использует Python 3.9. В этом руководстве используется Python 3.10, совместимый со старыми версиями NumPy, которые нужны AudioSR. Виртуальное окружение отделяет эти пакеты от системного Python.
- Git и uv. Установите Git и uv, чтобы скачать исходный код и управлять окружением Python.
- PyTorch и подходящий драйвер GPU. Для NVIDIA нужна сборка PyTorch с поддержкой CUDA. Согласуйте версии PyTorch, TorchAudio и TorchVision по официальной таблице установки.
- FFmpeg, включая ffprobe. Код сохранения файлов разработчиков использует эти команды. Установите их одним из способов загрузки FFmpeg и обеспечьте доступ к ним из терминала.
- Свободное место на диске и подключение к интернету. Предусмотрите место для окружения, скачанных весов модели, входных файлов и результатов. При первой загрузке модели скачивается её чекпойнт.
Код выбора устройства разработчиков распознаёт CUDA, Apple MPS и CPU. Обработка на CPU может быть очень медленной. Наличие MPS в проверке устройства не гарантирует работу каждой зависимости и операции на любом Mac.
Как установить AudioSR с GitHub
1. Скачайте официальный репозиторий и создайте окружение Python
Выполните команды в терминале:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Активируйте окружение в Linux или macOS:
source .venv/bin/activateВ Windows PowerShell вместо этого используйте такую команду активации:
.venv\Scripts\Activate.ps12. Установите совместимые зависимости и AudioSR
У AudioSR устаревшие ограничения зависимостей, в том числе NumPy 1.23.5 или более ранняя версия и Transformers 4.30.2. Установка новейших Python и PyTorch может вызвать ошибки совместимости. Требования пакета и эталонное окружение проекта помогут выбрать начальную конфигурацию.
Например, эталонное окружение сочетает PyTorch 2.0.1, TorchAudio 2.0.2 и TorchVision 0.15.2. В Linux или Windows с подходящим драйвером NVIDIA установите эту комбинацию для CUDA 11.7, а затем AudioSR из скачанного исходного кода:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
Команда CUDA предназначена для систем NVIDIA. Для macOS или CPU используйте соответствующие инструкции в таблице PyTorch. Это устаревшие версии зависимостей, поэтому держите окружение отдельно от других Python-проектов.
Если нужен лишь опубликованный пакет, официальный README также описывает audiosr==0.0.7. Этот релиз и текущая ветка main на GitHub могут иметь разные функции, поэтому проверьте python -m audiosr --help для установленной версии.
3. Проверьте, видит ли Python ваш GPU
Выполните проверку в активированном окружении на компьютере с NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Если CUDA недоступна, исправьте драйвер или установку PyTorch до запуска долгой обработки. Флаг -d cuda в AudioSR не заставит недоступный GPU работать.
AudioSR в командной строке: начните с короткого WAV
Для первого запуска возьмите короткий монофонический WAV. Загрузчик аудио разработчиков рекомендует входные записи длиной 5,12 секунды и предупреждает о качестве при длительности свыше 10,24 секунды. С полной песней сложнее диагностировать проблемы установки и памяти.
Поместите input.wav в каталог репозитория и выполните:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42Реализация командной строки сохраняет WAV с частотой дискретизации 48 kHz в папку с отметкой времени внутри output. Используйте basic для общего аудио или speech для речевых записей. Начальное значение случайного генератора (seed) управляет вариацией генерации; сравнение нескольких значений поможет выбрать более удачный результат.
Если генерация завершилась, но при сохранении возникает numpy.ndarray has no attribute cpu, используйте приведённый ниже Python-пример для прямой записи результата. В исходном коде GitHub, проверенном для руководства, выполнение модели возвращает массив NumPy, а функция сохранения файла ожидает тензор. Это несовпадение типов выходных данных в исходном проекте, а не ошибка памяти GPU.
Текущий код GitHub также предлагает разбиение длинных файлов на части:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1При разбиении обрабатываются небольшие части, а их перекрытия смешиваются. Это снижает расход памяти, но добавляет стыки, которые нужно проверить на слух. Флаги зависят от версии, а обработка частей в исходном проекте сводит входное стерео в моно, поэтому сохраните исходный стереофайл.
Как использовать AudioSR из Python
Используйте Python API, чтобы вызывать AudioSR из собственного скрипта. Пример ниже обрабатывает короткий монофайл, обрезает дополнение до исходной длительности и записывает WAV с частотой дискретизации 48 kHz. Сохраните его как run_audiosr.py в каталоге репозитория.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPython-цепочка обработки загружает модель один раз, поэтому скрипт пакетной обработки может использовать её повторно. В Neural Analog пакетная обработка применяет одно восстановление ко многим файлам без скрипта. Явно задайте число шагов семплирования: Python API и CLI могут иметь разные значения по умолчанию.
Как запустить AudioSR в Google Colab
Google Colab позволяет запускать AudioSR на облачном оборудовании Google. Откройте блокнот AudioSR Colab от сообщества и следуйте инструкциям, чтобы загрузить аудио, запустить модель и сохранить результат. Блокнот работает в браузере, поэтому установка Python и GPU на вашем компьютере не нужны.
Блокнот — адаптация AudioSR от сообщества. Его исходный код доступен на GitHub.
Где скачать веса модели AudioSR?
Скачайте веса модели AudioSR на Hugging Face.
Подробности модели AudioSR: архитектура, обучение и история
Кто создал AudioSR?
AudioSR — генеративная модель сверхразрешения аудио, созданная Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang и Mark D. Plumbley. Она предсказывает отсутствующие высокие частоты речи, музыки и звуковых эффектов и создаёт аудио с частотой дискретизации 48 kHz. Исследовательская страница AudioSR содержит статью и примеры для прослушивания. Работа впервые появилась как препринт в сентябре 2023 года, а затем была опубликована на ICASSP 2024.
AudioSR генерирует правдоподобные детали. Модель не может восстановить точную копию утраченного студийного мастера. Простая конвертация MP3 в WAV с частотой дискретизации 48 kHz вообще не выполняет такую реконструкцию. Это различие объясняет руководство по восстановлению MP3 в WAV.
Восстановление аудио, передискретизация и полоса частот — разные вещи
Передискретизация меняет число отсчётов, которыми представлена каждая секунда аудио. Восстановление аудио, или сверхразрешение, пытается оценить частотное содержимое, которого в записи больше нет. Например, передискретизация записи с 8 kHz до 48 kHz добавляет отсчёты, но сама по себе не восстанавливает звуки выше исходного частотного предела 4 kHz.
По официальному описанию проекта, AudioSR рассчитан на входную полосу от 2 до 16 kHz и создаёт результат с полосой 24 kHz при частоте дискретизации 48 kHz. Полоса описывает диапазон частот, а частота дискретизации — число отсчётов в секунду. Файл с пометкой 48 kHz всё ещё может иметь узкую полосу из-за предыдущего сжатия или фильтрации. Это характерно для многих ИИ-песен и объясняет, почему песни Suno часто звучат глухо.
Был ли AudioSR первой моделью восстановления аудио?
AudioSR не был первым нейросетевым инструментом восстановления аудио. Kuleshov, Enam и Ermon опубликовали «Сверхразрешение аудио с помощью нейронных сетей» в 2017 году; диффузионное восстановление речи тоже появилось до AudioSR.
Его вклад более узкий. Статья AudioSR представляет модель как первую систему, охватывающую всю область слышимого аудио: музыку, речь и звуковые эффекты. Она сочетает этот охват с гибкой входной полосой, а не впервые вводит само сверхразрешение аудио.
От исходной записи к волновой форме с частотой дискретизации 48 kHz
AudioSR сочетает вариационный автоэнкодер (VAE), условную модель латентной диффузии и нейросетевой вокодер. Каждый компонент отвечает за этап реконструкции:
| Этап | Что происходит | Почему это важно |
|---|---|---|
| Представление аудио | Вход превращается в мел-спектрограмму: карту энергии звука во времени и по частотам. | Модель работает с закономерностями частотного содержимого. |
| Кодирование VAE | Энкодер сжимает спектрограмму в меньшую репрезентацию, называемую латентной. | Диффузия работает с меньшим числом значений, чем в полной спектрограмме. |
| Условная диффузия | Transformer U-Net итеративно уточняет зашумлённую латентную репрезентацию, направляемую входной репрезентацией низкого разрешения. | Запись направляет генерацию деталей; текстовый промпт не нужен. |
| Декодирование и вокодер | VAE декодирует мел-спектрограмму более высокого разрешения. Вокодер на основе HiFi-GAN превращает её в волновую форму. | Спектрограмму нужно преобразовать обратно в слышимые отсчёты. |
| Замена частот | Низкочастотная информация входа заменяет соответствующие сгенерированные полосы. | Имеющаяся информация помогает ограничить изменения записи. |
Опубликованная конфигурация модели задаёт мел-представление из 256 полос, VAE и U-Net с пространственными трансформерами. Она объединяет закодированные низкочастотные признаки входа с латентной репрезентацией диффузии. Генерация обусловлена аудио, хотя некоторые унаследованные описания CLI упоминают текст.
Чем управляют шаги семплирования и сила следования входному условию?
Шаги семплирования задают число итераций, за которые модель уточняет сгенерированную репрезентацию. AudioSR использует семплер DDIM. Сила следования входному условию задаёт степень влияния исходной записи на генерацию. Это не величина EQ, и более высокое значение не гарантирует лучшее качество. Реализация выполнения модели последовательно применяет семплирование, декодирование, замену частот и нормализацию волновой формы.
Больше шагов семплирования и более длинные записи требуют больше времени обработки. AudioSR предназначен для обработки вне реального времени, а фактическая скорость зависит от GPU и настроек. Снижение ddim_steps ускоряет генерацию, но не является надёжным решением ошибок памяти GPU.
Как обучали AudioSR?
Раздел статьи об обучении описывает около 7 000 часов из MUSDB18-HQ, MoisesDB, MedleyDB, Freesound и речевых данных OpenSLR. Фильтры низких частот с разными частотами среза создают ухудшенные входы, сопоставленные с целевыми записями более широкой полосы. Диффузионная модель использует косинусное расписание шума, предсказание скорости и условное управление без классификатора. Вокодер основан на HiFi-GAN с дискриминатором нескольких разрешений.
Реальные записи могут отличаться от этих обучающих примеров. Авторы поясняют, что неравномерные частотные срезы, сильный шум и реверберация могут снизить качество. Сжатие MP3 может оставлять пробелы вблизи среза. Низкочастотная фильтрация перед обработкой может помочь, но слишком низкий срез удаляет полезные детали. Для записей с реверберацией её удаление до восстановления может дать модели более чистый вход.
Чтобы запустить AudioSR, не нужно обучать эти компоненты. Установка загружает готовые обученные веса.
Зачем AudioSR нужна постобработка?
Сгенерированное аудио должно сохранять полезную информацию, уже имеющуюся в источнике. AudioSR дважды заменяет нижние полосы: в оценённой мел-спектрограмме перед вокодером и в представлении коротковременного преобразования Фурье (STFT) полученной волновой формы. Код замены оценивает срез и корректирует восстановленный результат.
Для стереозаписей и полных песен нужна цепочка обработки, учитывающая каналы, части и реконструкцию. Стандартный процесс репозитория создаёт моноаудио: обычный загрузчик берёт первый входной канал, а цепочка обработки по частям сводит стерео в моно. Для сохранения стерео нужна дополнительная обработка каналов, например раздельная обработка левого и правого каналов в блокноте сообщества.
Реконструкцию нужно проверить на слух. Примечания к цепочке обработки сообщества предупреждают, что чрезмерное перекрытие может вызывать фазовое подавление. Сравните результат при примерно одинаковой громкости и проверьте восстановленные высокие частоты, стыки частей, длительность и стереокартину. Замена частот помогает сохранить источник, но не гарантирует неизменную нижнюю полосу или чистые стыки.
Вопросы об ошибках AudioSR
Есть ли AudioSR на PyPI?
Да. Официальный README описывает установку audiosr==0.0.7 через pip или новейшего кода прямо с GitHub. Ветка main на GitHub имеет функции, например разбиение на части, которых может не быть в релизе PyPI.
Сколько памяти GPU нужно AudioSR?
README не указывает минимум. Только базовый чекпойнт занимает около 6,2 GB на диске, а расход памяти растёт с длительностью фрагмента. Начните с фрагмента примерно на 5 секунд, затем используйте разбиение для длинных файлов.
Почему AudioSR завершается с ошибкой numpy.ndarray has no attribute cpu?
Выполнение модели завершилось, но этап сохранения ожидает тензор PyTorch и получает массив NumPy. Используйте Python-скрипт выше: он записывает результат через soundfile.
Почему результат AudioSR монофонический?
Стандартный загрузчик читает только первый канал, а обработка по частям сводит стерео в моно. Обрабатывайте левый и правый каналы отдельно или используйте AudioSR Online, который обрабатывает центральный и разностный каналы за вас.
Доступен ли код обучения AudioSR?
Да. Журнал изменений README от 31 декабря 2024 года содержит ссылку на код обучения. Автор описывает его как справочный и недостаточно тщательно организованный.
Запустите AudioSR в Neural Analog вместо настройки окружения
Чтобы пропустить локальную установку, откройте AudioSR Online, загрузите файл или импортируйте поддерживаемую музыкальную ссылку и настройте восстановление. Для Udio сначала сохраните или запишите аудио, затем загрузите файл. Можно выбрать частоту среза, прослушать обработанный результат и экспортировать аудио из того же интерфейса.
Neural Analog выполняет обработку модели онлайн, поэтому можно использовать компьютер без мощного GPU и обойтись без установки Python, скачивания чекпойнтов и поддержки блокнотов. Критическое прослушивание по-прежнему нужно: размещённый онлайн процесс не отменяет ограничений качества модели. После восстановления следуйте руководству по улучшению аудио. Для ИИ-музыки исправление качества ИИ-песен описывает восстановление стемов и мастеринг после реконструкции.
Можно также сравнить AudioSR с более новыми моделями восстановления аудио в Neural Analog, включая UniverSR и FlashSR. Карточки моделей объясняют их работу, а FAQ кратко описывает, чем UniverSR отличается от AudioSR. Практический пример: все 203 звуковых эффекта RPG Maker 2000, восстановленные до частоты дискретизации 48 kHz с UniverSR. Запустите модели на одной записи и сравните предварительные результаты, чтобы выбрать лучший.