Instalacja AudioSR z GitHub: jak uruchomić AudioSR lokalnie
AudioSR to model superrozdzielczości audio o otwartym kodzie źródłowym. Generuje brakujące szczegóły wysokich częstotliwości w mowie, muzyce i efektach dźwiękowych, tworząc audio o częstotliwości próbkowania 48 kHz. Możesz zainstalować go z oficjalnego repozytorium GitHub albo uruchomić AudioSR online w Neural Analog.
Aby zainstalować go lokalnie, sklonuj repozytorium, utwórz środowisko Python 3.10 za pomocą uv, zainstaluj zgodną wersję PyTorch i AudioSR, a potem uruchom python -m audiosr na krótkim pliku WAV. Poniższe kroki omawiają każdą komendę.
Jak działa AudioSR? Wyjaśnienie architektury
Jak AudioSR odbudowuje brakujące wysokie częstotliwości
Wejściowy spektrogram melowy warunkuje dyfuzję latentną, aby oszacować spektrogram o szerszym paśmie. Przed wokoderem dolne pasma melowe źródła zastępują wygenerowane; po wokoderze jego dolne pasma STFT zastępują wygenerowane. Model tworzy wiarygodne brakujące szczegóły, a nie dokładną kopię utraconego nagrania.
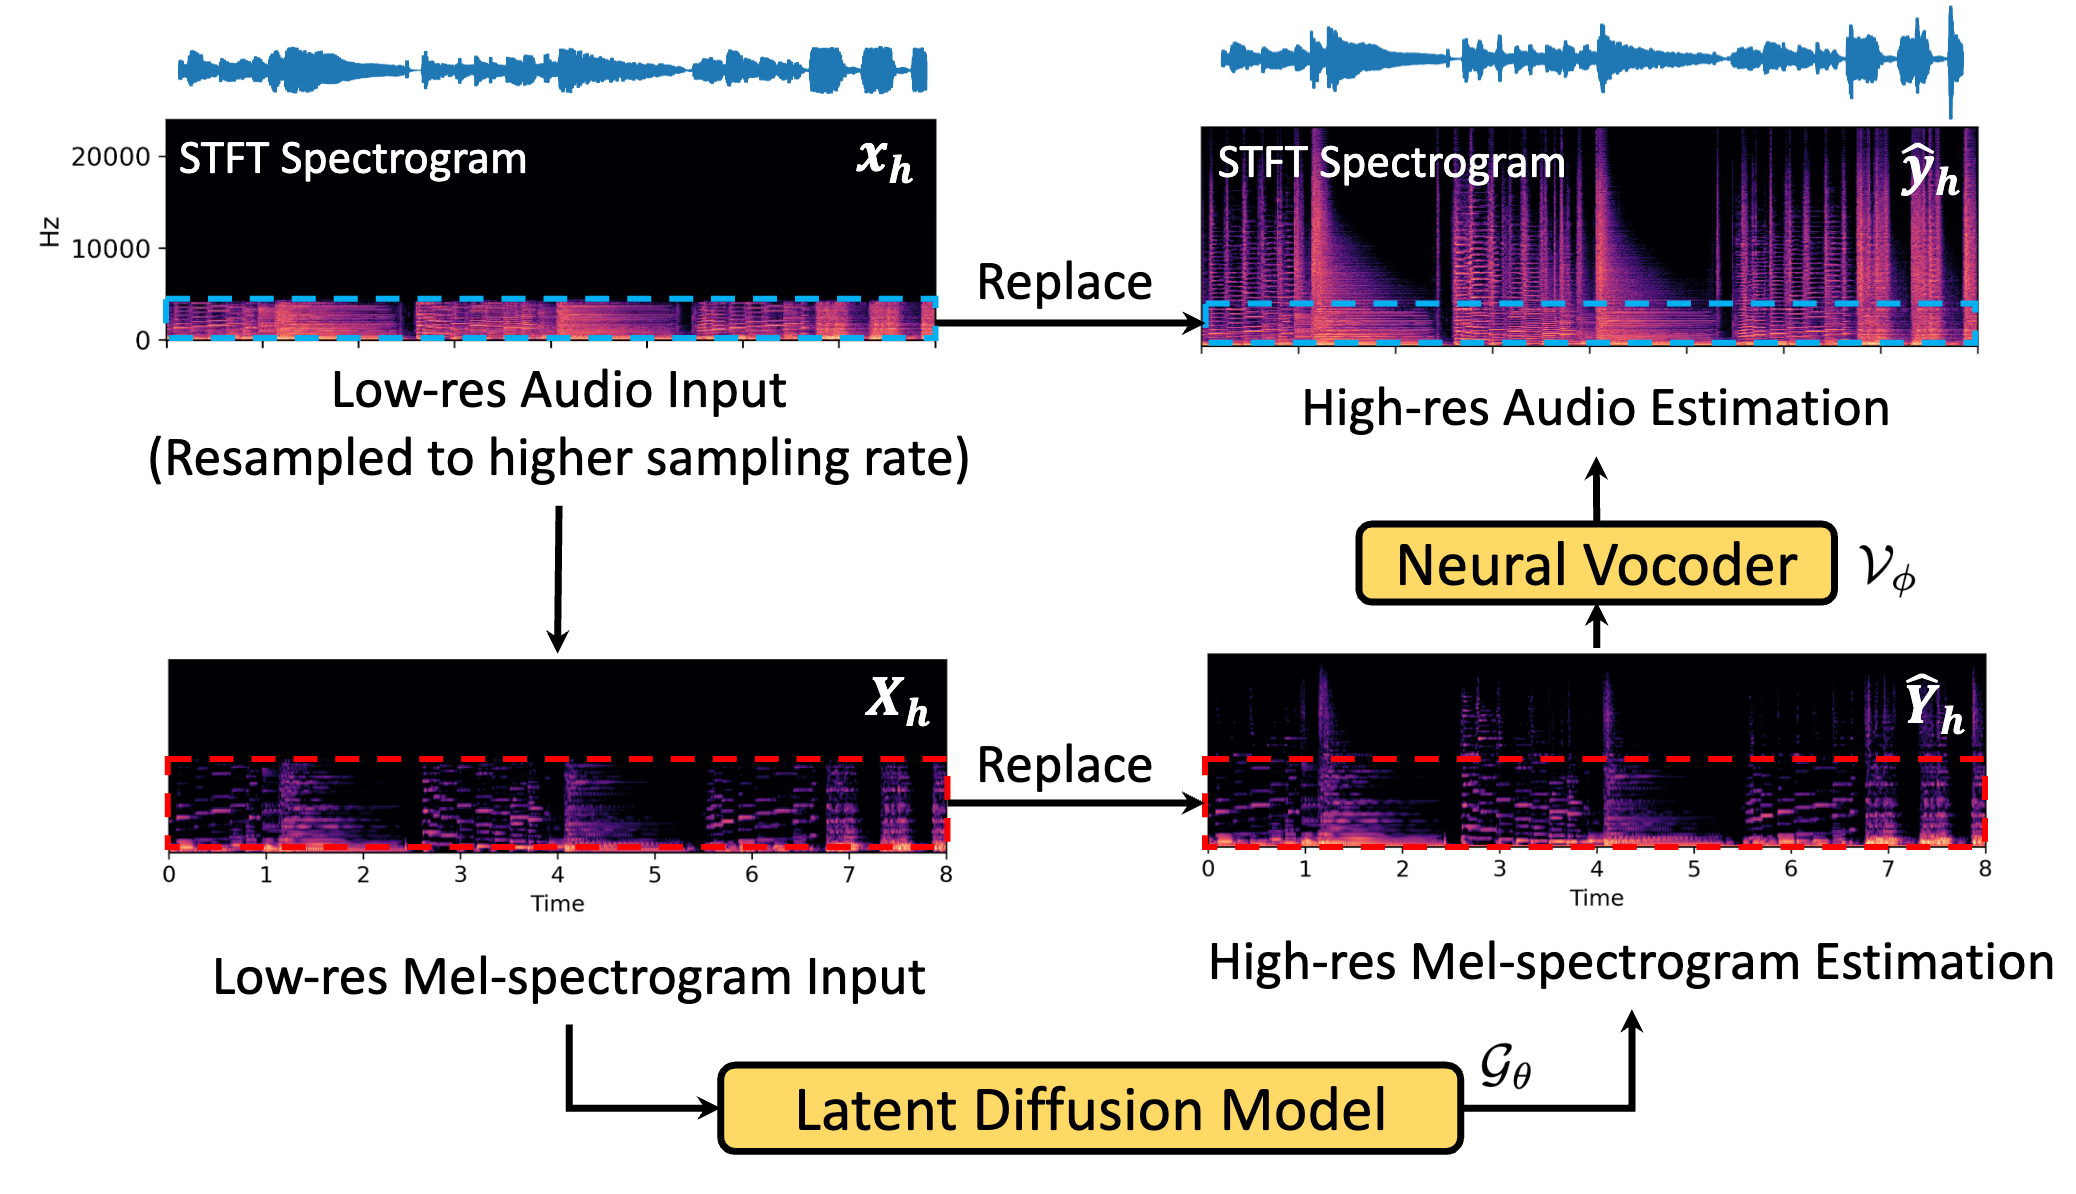
Oryginalny diagram: AudioSR.
AudioSR zamienia nagranie w spektrogram melowy, używa modelu dyfuzji latentnej do oszacowania brakujących szczegółów wysokich częstotliwości i przekształca wynik w przebieg falowy za pomocą wokodera. Obróbka końcowa przywraca potem oryginalne niskie częstotliwości źródła w miejsce wygenerowanych. Wynik to wiarygodna rekonstrukcja, a nie dokładne odzyskanie utraconego audio; model nie dodaje jedynie szumu.
Gdzie można uruchomić AudioSR?
| Opcja | Najlepsze zastosowanie | Konfiguracja i kompromisy |
|---|---|---|
| Neural Analog AudioSR Online (zalecane) | Restauracja stereo z przetwarzaniem sygnału środkowego i różnicowego oraz regulowaną częstotliwością odcięcia | Przesyłanie, odsłuch i eksport online. Bez instalacji Python i lokalnego GPU. |
| Oficjalne repozytorium GitHub | Lokalne eksperymenty i skrypty Python | Zainstaluj zależności, pobierz wagi i zapewnij moc obliczeniową. |
| Notatnik AudioSR Colab | Eksperymenty z GPU Google w chmurze | Otwórz notatnik społeczności i wykonaj instrukcje w przeglądarce. |
| Hugging Face Space | Szybka demonstracja w przeglądarce | Wdrożenie społeczności; dostępność i limity GPU mogą się zmieniać. |
| AudioSR w Replicate | Uruchamianie modelu na hostingu i integracja z API | Opłata według użycia; bez lokalnej instalacji modelu. |
Neural Analog przetwarza osobno sygnał środkowy i różnicowy audio stereo. Możesz też ustawić częstotliwość odcięcia, od której AudioSR zaczyna odbudowywać szczegóły. Niższe odcięcie zmienia większą część dźwięku, a wyższe uzupełnia jedynie górę pasma.
Wymagania AudioSR: Python, pamięć GPU i miejsce na dysku
AudioSR to wymagający model, zwłaszcza dla całych piosenek. Oficjalny podstawowy punkt kontrolny zajmuje około 6,2 GB na dysku, a wykonanie modelu wymaga więcej pamięci niż zapisane wagi. Duży GPU NVIDIA pomaga, ale rozmiar punktu kontrolnego nie określa minimalnej VRAM: długość fragmentu i implementacja też wpływają na zużycie pamięci. Oficjalny README nie podaje minimalnych wymagań GPU.
Długie wejścia mogą wyczerpać pamięć GPU. Zacznij od krótkiego fragmentu, a dłuższe nagrania przetwarzaj potem w mniejszych częściach.
Przed rozpoczęciem przygotuj te zależności:
- Python w izolowanym środowisku. Przykład autorów używa Python 3.9. Ten poradnik używa Python 3.10, który działa ze starszymi wersjami NumPy wymaganymi przez AudioSR. Środowisko wirtualne oddziela te pakiety od systemowego Python.
- Git i uv. Zainstaluj Git i uv, aby pobrać źródła i zarządzać środowiskiem Python.
- PyTorch i odpowiedni sterownik GPU. Użytkownicy NVIDIA potrzebują wersji PyTorch zgodnej z CUDA. Dopasuj wersje PyTorch, TorchAudio i TorchVision według oficjalnej tabeli instalacji.
- FFmpeg, w tym ffprobe. Oryginalny kod zapisu plików używa tych komend. Zainstaluj je zgodnie z opcjami pobierania FFmpeg i udostępnij w terminalu.
- Wolne miejsce na dysku i połączenie z internetem. Zapewnij miejsce na środowisko, pobrane wagi modelu, pliki wejściowe i wyniki. Przy pierwszym załadowaniu model pobiera punkt kontrolny.
Oryginalny kod wyboru urządzenia rozpoznaje CUDA, Apple MPS i CPU. Przetwarzanie na CPU może być bardzo powolne. Obsługa MPS w sprawdzaniu urządzenia nie gwarantuje działania każdej zależności i operacji na każdym Macu.
Jak zainstalować AudioSR z GitHub
1. Pobierz oficjalne repozytorium i utwórz środowisko Python
Uruchom w terminalu te komendy:
git clone https://github.com/haoheliu/versatile_audio_super_resolution.git
cd versatile_audio_super_resolution
uv venv --python 3.10
Aktywuj środowisko w Linux lub macOS:
source .venv/bin/activateW Windows PowerShell użyj zamiast tego tej komendy aktywacji:
.venv\Scripts\Activate.ps12. Zainstaluj zgodne zależności i AudioSR
AudioSR ma starsze ograniczenia zależności, w tym NumPy 1.23.5 lub wcześniejsze i Transformers 4.30.2. Instalowanie najnowszych wersji Python i PyTorch może powodować błędy zgodności. Wymagania pakietu i środowisko referencyjne projektu są użytecznym punktem wyjścia.
Na przykład środowisko referencyjne łączy PyTorch 2.0.1, TorchAudio 2.0.2 i TorchVision 0.15.2. W Linux lub Windows z odpowiednim sterownikiem NVIDIA zainstaluj tę kombinację CUDA 11.7, a potem pobrane źródła AudioSR:
uv pip install torch==2.0.1 torchaudio==2.0.2 torchvision==0.15.2 --index-url https://download.pytorch.org/whl/cu117
uv pip install .
python -m audiosr --help
Komenda CUDA jest przeznaczona dla systemów NVIDIA. Dla macOS lub CPU użyj odpowiednich instrukcji w tabeli PyTorch. To starsze wersje zależności, więc zachowaj to środowisko oddzielnie od innych projektów Python.
Jeśli potrzebujesz tylko opublikowanego pakietu, oficjalny README opisuje też audiosr==0.0.7. Ta wersja i obecna gałąź main na GitHub mogą mieć różne funkcje, więc sprawdź python -m audiosr --help dla zainstalowanej wersji.
3. Sprawdź, czy Python widzi GPU
Uruchom tę kontrolę wewnątrz aktywowanego środowiska na komputerze z NVIDIA:
python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
ffmpeg -version
ffprobe -version
Jeśli CUDA jest niedostępna, napraw sterownik lub instalację PyTorch przed rozpoczęciem długiego zadania. Dodanie -d cuda do AudioSR nie sprawi, że niedostępny GPU zacznie działać.
AudioSR w wierszu poleceń: zacznij od krótkiego WAV
Do pierwszego uruchomienia użyj krótkiego WAV mono. Oryginalny moduł ładowania audio zaleca wejścia trwające 5,12 sekundy i ostrzega o jakości powyżej 10,24 sekundy. Cała piosenka utrudnia diagnozowanie problemów z konfiguracją i pamięcią.
Umieść input.wav w katalogu repozytorium i uruchom:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --seed 42Implementacja wiersza poleceń zapisuje WAV o częstotliwości próbkowania 48 kHz w folderze ze znacznikiem czasu pod output. Użyj basic dla ogólnego audio lub speech dla nagrań mowy. Ziarno generatora losowego steruje wariantem generacji; porównanie kilku ziaren może pomóc wybrać lepszy wynik.
Jeśli generowanie się kończy, ale zapis zgłasza numpy.ndarray has no attribute cpu, użyj poniższego przykładu Python do bezpośredniego zapisu wyniku. W źródłach GitHub sprawdzonych do poradnika wykonanie modelu zwraca tablicę NumPy, ale funkcja zapisu pliku oczekuje tensora. To niezgodność typu wyniku w oryginalnym projekcie, a nie błąd pamięci GPU.
Obecny kod GitHub udostępnia też dzielenie dłuższych plików na fragmenty:
python -m audiosr -i input.wav -s output --model_name basic -d cuda --ddim_steps 50 --chunking --chunk_duration 5 --overlap_duration 1Przetwarzanie fragmentami obrabia mniejsze części i miesza ich nakładające się odcinki. Obniża zużycie pamięci, ale dodaje łączenia, które trzeba sprawdzić na słuch. Te flagi zależą od wersji, a oryginalna ścieżka przetwarzania fragmentami miksuje wejście stereo do mono, więc zachowaj oryginalny plik stereo.
Jak używać AudioSR z Python
Użyj API Python, aby wywołać AudioSR we własnym skrypcie. Poniższy przykład przetwarza krótki plik mono, przycina dopełnienie do czasu wejścia i zapisuje WAV o częstotliwości próbkowania 48 kHz. Zapisz go jako run_audiosr.py w katalogu repozytorium.
import numpy as np
import soundfile as sf
import torch
from audiosr import build_model, super_resolution

model = build_model(model_name="basic", device="cuda")
waveform = super_resolution(
  model,
  "input.wav",
  seed=42,
  ddim_steps=50,
  guidance_scale=3.5,
)
if isinstance(waveform, torch.Tensor):
  waveform = waveform.detach().cpu().numpy()
audio = np.asarray(waveform)[0, 0]
input_info = sf.info("input.wav")
output_samples = round(input_info.frames * 48000 / input_info.samplerate)
sf.write("output.wav", audio[:output_samples], 48000, subtype="PCM_24")
python run_audiosr.pyPipeline Python ładuje model raz, więc skrypt przetwarzania wsadowego może go ponownie wykorzystać. W Neural Analog przetwarzanie wsadowe uruchamia jedną restaurację na wielu plikach bez skryptu. Ustaw liczbę kroków próbkowania jawnie, ponieważ API Python i CLI mogą mieć różne wartości domyślne.
Jak uruchomić AudioSR w Google Colab
Google Colab pozwala uruchamiać AudioSR na sprzęcie Google w chmurze. Otwórz notatnik AudioSR Colab społeczności i wykonaj instrukcje, aby załadować audio, uruchomić model i zapisać wynik. Notatnik działa w przeglądarce, więc nie potrzebujesz instalacji Python ani GPU na komputerze.
Notatnik jest adaptacją AudioSR opracowaną przez społeczność. Jego źródła są dostępne na GitHub.
Gdzie można pobrać wagi modelu AudioSR?
Pobierz wagi modelu AudioSR na Hugging Face.
Szczegóły modelu AudioSR: architektura, trening i historia
Kto stworzył AudioSR?
AudioSR to generatywny model superrozdzielczości audio autorstwa Haohe Liu, Ke Chen, Qiao Tian, Wenwu Wang i Mark D. Plumbley. Przewiduje brakujące wysokie częstotliwości w mowie, muzyce i efektach dźwiękowych oraz tworzy audio o częstotliwości próbkowania 48 kHz. Strona badawcza AudioSR zawiera publikację i przykłady do odsłuchu. Praca ukazała się najpierw jako preprint we wrześniu 2023 roku, a następnie została opublikowana na ICASSP 2024.
AudioSR generuje wiarygodne szczegóły. Nie odzyska dokładnej kopii utraconego mastera studyjnego. Konwersja MP3 do WAV 48 kHz w ogóle nie wykonuje takiej rekonstrukcji. Tę różnicę wyjaśnia poradnik poprawy jakości plików MP3 do WAV.
Poprawa rozdzielczości, zmiana próbkowania i pasmo to różne rzeczy
Zmiana częstotliwości próbkowania zmienia liczbę próbek reprezentujących każdą sekundę audio. Poprawa rozdzielczości audio, czyli superrozdzielczość, próbuje oszacować zawartość częstotliwościową, której nagranie już nie zawiera. Na przykład zmiana próbkowania nagrania z 8 kHz na 48 kHz daje więcej próbek, ale sama nie przywraca dźwięków ponad pierwotny limit częstotliwości 4 kHz.
Według oficjalnego opisu projektu AudioSR obsługuje wejściowe pasma od 2 do 16 kHz i generuje wynik z pasmem 24 kHz przy próbkowaniu 48 kHz. Pasmo opisuje zakres częstotliwości; częstotliwość próbkowania opisuje próbki na sekundę. Plik oznaczony 48 kHz może nadal mieć wąskie pasmo wskutek wcześniejszej kompresji lub filtrowania. Dotyczy to wielu piosenek AI i wyjaśnia, dlaczego piosenki Suno często brzmią stłumione.
Czy AudioSR był pierwszym modelem poprawy rozdzielczości audio?
AudioSR nie był pierwszym neuronowym narzędziem poprawy rozdzielczości audio. Kuleshov, Enam i Ermon opublikowali „Superrozdzielczość audio przy użyciu sieci neuronowych” w 2017 roku, a poprawa rozdzielczości mowy przez dyfuzję też powstała przed AudioSR.
Jego wkład jest węższy. Publikacja AudioSR przedstawia go jako pierwszy system obejmujący ogólną dziedzinę słyszalnego audio: muzykę, mowę i efekty dźwiękowe. Łączy tę wszechstronność z elastycznym pasmem wejściowym, zamiast wprowadzać samą ideę superrozdzielczości audio.
Od nagrania wejściowego do przebiegu falowego 48 kHz
AudioSR łączy wariacyjny autoenkoder (VAE), warunkowy model dyfuzji latentnej i wokoder neuronowy. Każdy komponent odpowiada za etap rekonstrukcji:
| Etap | Co się dzieje | Dlaczego to ważne |
|---|---|---|
| Reprezentacja audio | Wejście staje się spektrogramem melowym: mapą energii dźwięku w czasie i częstotliwości. | Model pracuje z wzorcami zawartości częstotliwościowej. |
| Kodowanie VAE | Enkoder kompresuje spektrogram do mniejszej reprezentacji latentnej. | Dyfuzja operuje na mniejszej liczbie wartości niż pełny spektrogram. |
| Dyfuzja warunkowa | Transformer U-Net iteracyjnie dopracowuje zaszumioną reprezentację latentną, kierowany wejściową reprezentacją niskiej rozdzielczości. | Nagranie kieruje generowanymi szczegółami; prompt tekstowy nie jest potrzebny. |
| Dekodowanie i wokoder | VAE dekoduje spektrogram melowy wyższej rozdzielczości. Wokoder oparty na HiFi-GAN zamienia go w przebieg falowy. | Spektrogram trzeba przekształcić z powrotem w słyszalne próbki. |
| Zastępowanie częstotliwości | Informacja o niższych częstotliwościach z wejścia zastępuje odpowiednie wygenerowane pasma. | Istniejąca informacja pomaga ograniczyć zmiany nagrania. |
Opublikowana konfiguracja modelu określa reprezentację melową o 256 pasmach, VAE i U-Net z transformerami przestrzennymi. Łączy zakodowane cechy wejścia po filtracji dolnoprzepustowej z reprezentacją latentną dyfuzji. To generacja warunkowana audio, choć niektóre odziedziczone opisy CLI wspominają o tekście.
Co kontrolują kroki próbkowania i siła warunkowania?
Kroki próbkowania określają liczbę iteracji, które model poświęca na dopracowanie wygenerowanej reprezentacji. AudioSR używa samplera DDIM. Siła warunkowania określa, jak mocno warunki wejściowe kierują generacją. Nie jest to intensywność EQ, a wyższa wartość nie gwarantuje wyższej jakości. Implementacja inferencji stosuje kolejno próbkowanie, dekodowanie, zastępowanie częstotliwości i normalizację przebiegu falowego.
Więcej kroków próbkowania i dłuższe nagrania wymagają więcej czasu przetwarzania. AudioSR jest przeznaczony do przetwarzania poza czasem rzeczywistym, a faktyczna szybkość zależy od GPU i ustawień. Zmniejszenie ddim_steps przyspiesza generację, ale nie rozwiązuje niezawodnie błędów pamięci GPU.
Jak trenowano AudioSR?
Sekcja publikacji o treningu opisuje około 7 000 godzin z MUSDB18-HQ, MoisesDB, MedleyDB, Freesound i danych mowy OpenSLR. Filtry dolnoprzepustowe o różnych częstotliwościach odcięcia tworzą pogorszone wejścia sparowane z celami o pełniejszym paśmie. Model dyfuzji używa kosinusowego harmonogramu szumu, przewidywania prędkości i sterowania bez klasyfikatora. Wokoder opiera się na HiFi-GAN z dyskryminatorem wielorozdzielczym.
Rzeczywiste nagrania mogą różnić się od tych przykładów treningowych. Autorzy wyjaśniają, że nieregularne odcięcia częstotliwości, silny szum i pogłos mogą obniżać jakość. Kompresja MP3 może zostawiać luki przy odcięciu. Filtracja dolnoprzepustowa przed inferencją może pomóc, ale zbyt niskie odcięcie usuwa przydatne szczegóły. Dla nagrań z pogłosem jego usunięcie przed poprawą rozdzielczości może dać modelowi czystsze wejście.
Nie musisz trenować tych komponentów, aby uruchomić AudioSR. Instalacja ładuje wcześniej wytrenowane wagi.
Dlaczego AudioSR używa obróbki końcowej?
Wygenerowane audio powinno zachować przydatne informacje już obecne w źródle. AudioSR zastępuje dolne pasma dwa razy: w oszacowanym spektrogramie melowym przed wokoderem i w reprezentacji krótkoczasowej transformaty Fouriera (STFT) wynikowego przebiegu falowego. Kod zastępowania szacuje odcięcie i koryguje odbudowany wynik.
Nagrania stereo i całe piosenki wymagają procesu obsługującego kanały, fragmenty i rekonstrukcję. Domyślny proces repozytorium tworzy audio mono: standardowy moduł ładowania bierze pierwszy kanał wejścia, a pipeline fragmentów miksuje stereo do mono. Zachowanie stereo wymaga dodatkowej obsługi kanałów, takiej jak osobne przetwarzanie lewego i prawego kanału w notatniku społeczności.
Rekonstrukcja wymaga sprawdzenia odsłuchem. Uwagi do pipeline'u społeczności ostrzegają, że nadmierne nakładanie fragmentów może powodować znoszenie fazy. Porównaj wynik przy podobnej głośności i sprawdź odbudowaną górę, łączenia fragmentów, długość i obraz stereo. Zastępowanie częstotliwości pomaga zachować źródło, ale nie gwarantuje niezmienionego dolnego pasma ani czystych połączeń.
Rozwiązywanie problemów AudioSR: pytania i odpowiedzi
Czy AudioSR jest dostępny na PyPI?
Tak. Oficjalny README opisuje instalację audiosr==0.0.7 przez pip lub najnowszego kodu prosto z GitHub. Gałąź main GitHub zawiera funkcje, takie jak przetwarzanie fragmentami, których może brakować w wydaniu PyPI.
Ile pamięci GPU potrzebuje AudioSR?
README nie podaje minimum. Sam podstawowy punkt kontrolny ma około 6,2 GB na dysku, a zużycie pamięci rośnie z długością fragmentu. Zacznij od około 5 sekund, potem używaj dzielenia dłuższych plików na fragmenty.
Dlaczego AudioSR zgłasza numpy.ndarray has no attribute cpu?
Inferencja się zakończyła, ale etap zapisu oczekuje tensora PyTorch i otrzymuje tablicę NumPy. Użyj powyższego skryptu Python, który zapisuje wynik przez soundfile.
Dlaczego wynik AudioSR jest mono?
Domyślny moduł ładowania odczytuje tylko pierwszy kanał, a ścieżka fragmentów miksuje stereo do mono. Przetwarzaj osobno kanały lewy i prawy albo użyj AudioSR Online, który przetwarza za ciebie sygnał środkowy i różnicowy.
Czy kod treningu AudioSR jest dostępny?
Tak. Dziennik zmian README z 31 grudnia 2024 roku zawiera link do kodu treningu, który autor opisuje jako przeznaczony tylko do odniesienia i niezbyt starannie uporządkowany.
Uruchom AudioSR w Neural Analog zamiast zarządzać konfiguracją
Aby pominąć lokalną konfigurację, otwórz AudioSR Online, prześlij plik lub zaimportuj obsługiwany link muzyczny i dopasuj ustawienia restauracji. W przypadku Udio najpierw zapisz lub nagraj audio, a potem prześlij plik. Możesz wybrać częstotliwość odcięcia, odsłuchać przetworzony wynik i wyeksportować audio w tym samym interfejsie.
Neural Analog obsługuje model online, więc możesz użyć komputera bez dużego GPU i pominąć instalację Python, pobieranie punktów kontrolnych i utrzymywanie notatników. Nadal musisz uważnie słuchać, ponieważ hosting nie usuwa ograniczeń jakości modelu. Po restauracji wykonaj kolejne kroki z poradnika poprawy audio. Dla muzyki AI poprawa jakości piosenek AI opisuje naprawę ścieżek i mastering po poprawie rozdzielczości.
Możesz też porównać AudioSR z nowszymi modelami poprawy rozdzielczości audio w Neural Analog, w tym UniverSR i FlashSR. Karty modeli wyjaśniają działanie każdego z nich, a FAQ podsumowuje, czym UniverSR różni się od AudioSR. Przykład praktyczny: wszystkie 203 efekty dźwiękowe RPG Maker 2000 odbudowane do 48 kHz z UniverSR. Uruchom je na tym samym nagraniu i porównaj odsłuchy, aby wybrać najlepszy wynik.