Spleeter czy Demucs w 2026? Wyniki testów i co przewyższa oba modele
Wybór Spleeter czy Demucs sprowadza się do szybkości i jakości. Demucs rozdziela ścieżki czyściej: dostrojony Demucs v4 osiąga 9,0 dB SDR wobec 5,9 dB dla Spleeter. Spleeter jest za to znacznie szybszy i dobrze działa na skromnym CPU. W 2026 roku nowsze modele, takie jak BS-RoFormer, uzyskują lepsze wyniki niż oba.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Twórca | Deezer, 2019 | Meta AI Research, 2022 |
| Sposób działania | Maskowanie spektrogramu (U-Net) | Gałęzie przebiegu czasowego i spektrogramu z modelem Transformer |
| Jakość (SDR na MUSDB18) | 5,9 dB | 9,0 dB (po dostrojeniu) |
| Szybkość | Bardzo szybki, dobrze działa na CPU | Wolniejszy, najlepiej z GPU |
| Ścieżki | 2, 4 lub 5 | 4 lub 6 z gitarą i fortepianem |
| Najlepszy do | Szybkich podglądów, karaoke, przetwarzania wsadowego | Czystych ścieżek do remiksów i wydań |
Jeśli próbowałeś wyodrębnić wokal lub stworzyć wersję instrumentalną do remiksu, zapewne używałeś narzędzia opartego na jednym z nich. Oba modele o otwartym kodzie stały się punktami odniesienia dla separacji ścieżek, a ich porównanie nadal pokazuje kompromisy między szybkością, artefaktami i jakością.
Czym są ścieżki składowe i dlaczego tak trudno je rozdzielić?
Ścieżki składowe to poszczególne elementy zmiksowanego utworu, zwykle wokal, perkusja, bas i reszta. Producenci pracują z nimi w studiu, zanim końcowy miks połączy wszystko.
Rozdzielanie ich po zmiksowaniu przypomina próbę rozłożenia upieczonego ciasta na składniki. Instrumenty zajmują te same zakresy częstotliwości. Harmoniczne wokalu nakładają się na częstotliwości gitary. Transjenty stopy wchodzą na nuty basu. Uderzenia talerzy rozchodzą się po całym polu stereo. Tradycyjne przetwarzanie sygnału dawało chwiejne brzmienie pełne artefaktów.
Głębokie uczenie poprawiło sytuację, ucząc sieci neuronowe rozpoznawania wzorców pomijanych przez klasyczne przetwarzanie sygnału. Spleeter i Demucs stały się dwoma modelami referencyjnymi i stosują bardzo różne podejścia.
Historia Spleeter i Demucs oraz związek z Paryżem
Spleeter: szybkie maskowanie spektrogramu od Deezer
W listopadzie 2019 roku francuski serwis streamingowy Deezer udostępnił Spleeter jako darmowe narzędzie o otwartym kodzie. Zespół kierowany przez Romain Hennequin zbudował go na TensorFlow wokół konwolucyjnej sieci neuronowej U-Net, która pracuje na spektrogramach amplitudowych, czyli reprezentacjach audio w czasie i częstotliwości.
Spleeter traktuje separację jak segmentację obrazu. Przewiduje miękką maskę dla każdej komórki czasowo-częstotliwościowej, szacując, jaka jej część należy do wokalu, perkusji, basu lub reszty. Opcjonalny etap filtracji Wienera dopracowuje maski, a ścieżki są odtwarzane z fazą oryginalnego miksu.
Siłą Spleeter jest szybkość. Rozdziela 4-minutowy utwór w kilka sekund, przetwarzając dźwięk na GPU 100 razy szybciej, niż trwa jego odtwarzanie, i dobrze działa na skromnych CPU. Oferuje konfiguracje na 2 ścieżki (wokal/akompaniament), 4 i 5 ścieżek. Stał się bazą porównawczą w badaniach i napędzał niezliczone kanały remiksowe na YouTube.
Demucs: separacja w dziedzinie czasu od Meta
Gdy Spleeter skupiał się na szybkości, Meta AI Research, wówczas Facebook AI Research, postawiło na jakość. Alexandre Défossez, również Francuz, i jego zespół przedstawili Demucs w 2019 roku. Nazwa pochodzi od Deep Extractor for MUlti-Channel Sources; podejście było zupełnie inne.
Zamiast spektrogramów Demucs pracuje bezpośrednio na surowych przebiegach czasowych i traktuje separację jako problem rekonstrukcji w dziedzinie czasu. Architektura łączy konwolucyjny enkoder-dekoder w stylu U-Net, inspirowany Wave-U-Net, z dwukierunkowym LSTM w najwęższej części sieci. Pozwala to uchwycić długotrwałą strukturę muzyczną i zachować spójność fazy.
Demucs rozwinął się przez cztery główne wersje:
- v1 (2019): wyłącznie przebieg czasowy, już konkurujący z metodami spektrogramowymi
- v2 (2020): dopracowany trening i lepsza wydajność
- v3 "Hybrid Demucs" (2021): dodanie gałęzi spektrogramu, zwycięstwo w Music Demixing Challenge z 7,7 dB SDR na MUSDB18
- v4 "Hybrid Transformer Demucs" (2022): zastąpienie najgłębszych warstw międzydziedzinowym modelem Transformer, osiągnięcie 9,0 dB SDR po dostrojeniu i do 9,2 dB w najlepszej konfiguracji z publikacji
Sound Demixing Challenge i nowy początek
Sound Demixing Challenge 2023 zmienił punkt ciężkości. Wydarzenie zorganizowane przez Meta, Sony i innych wprowadziło odporną separację źródeł muzycznych: trening na danych z zaszumionymi etykietami i przesłuchem między ścieżkami. Alexandre Défossez był jednym z kluczowych organizatorów i współtworzył zasady konkursu oraz modele bazowe.
Główny wniosek: więcej danych treningowych nie gwarantuje lepszych wyników. Ważniejsze są jakość danych i strategie odporności. Techniki takie jak obcinanie wartości funkcji straty i iteracyjne udoskonalanie poprawiły SDR o 0,89 dB na zaszumionych danych.
Wkrótce później Défossez opuścił Meta, by współzałożyć Kyutai, francuskie laboratorium badań nad AI. Repozytorium Demucs nadal jest dostępne, ale README informuje, że nie pracuje już aktywnie nad projektem, więc nie oczekuj nowych funkcji.
Wydajność: kompromisy między szybkością i jakością
Filozofia architektury
Spleeter maskuje spektrogramy. Demucs rekonstruuje przebiegi czasowe. Ta podstawowa różnica wpływa na wszystko inne.
Podejście częstotliwościowe Spleeter jest wydajne, ponieważ każda ramka STFT podsumowuje tysiące próbek, więc konwolucje wykonują się na znacznie mniejszej liczbie kroków czasowych. Koszt: model ignoruje fazę, ponownie używając fazy miksu, a stała rozdzielczość czasowo-częstotliwościowa STFT nie potrafi dobrze przedstawić jednocześnie ostrych transjentów i stabilnych tonów.
Metoda czasowa Demucs uczy własne banki filtrów przez konwolucje 1D. Zachowuje fazę i obsługuje transjenty z dokładnością do próbki. W v4 warstwy Transformer utrzymują kontekst wielu sekund audio, ograniczając artefakty „ping-pong” częste w metodach opartych na ramkach.
Hybrid Demucs v3: gałęzie przebiegu i spektrogramu
Połączenia skrótowe enkodera i dekodera
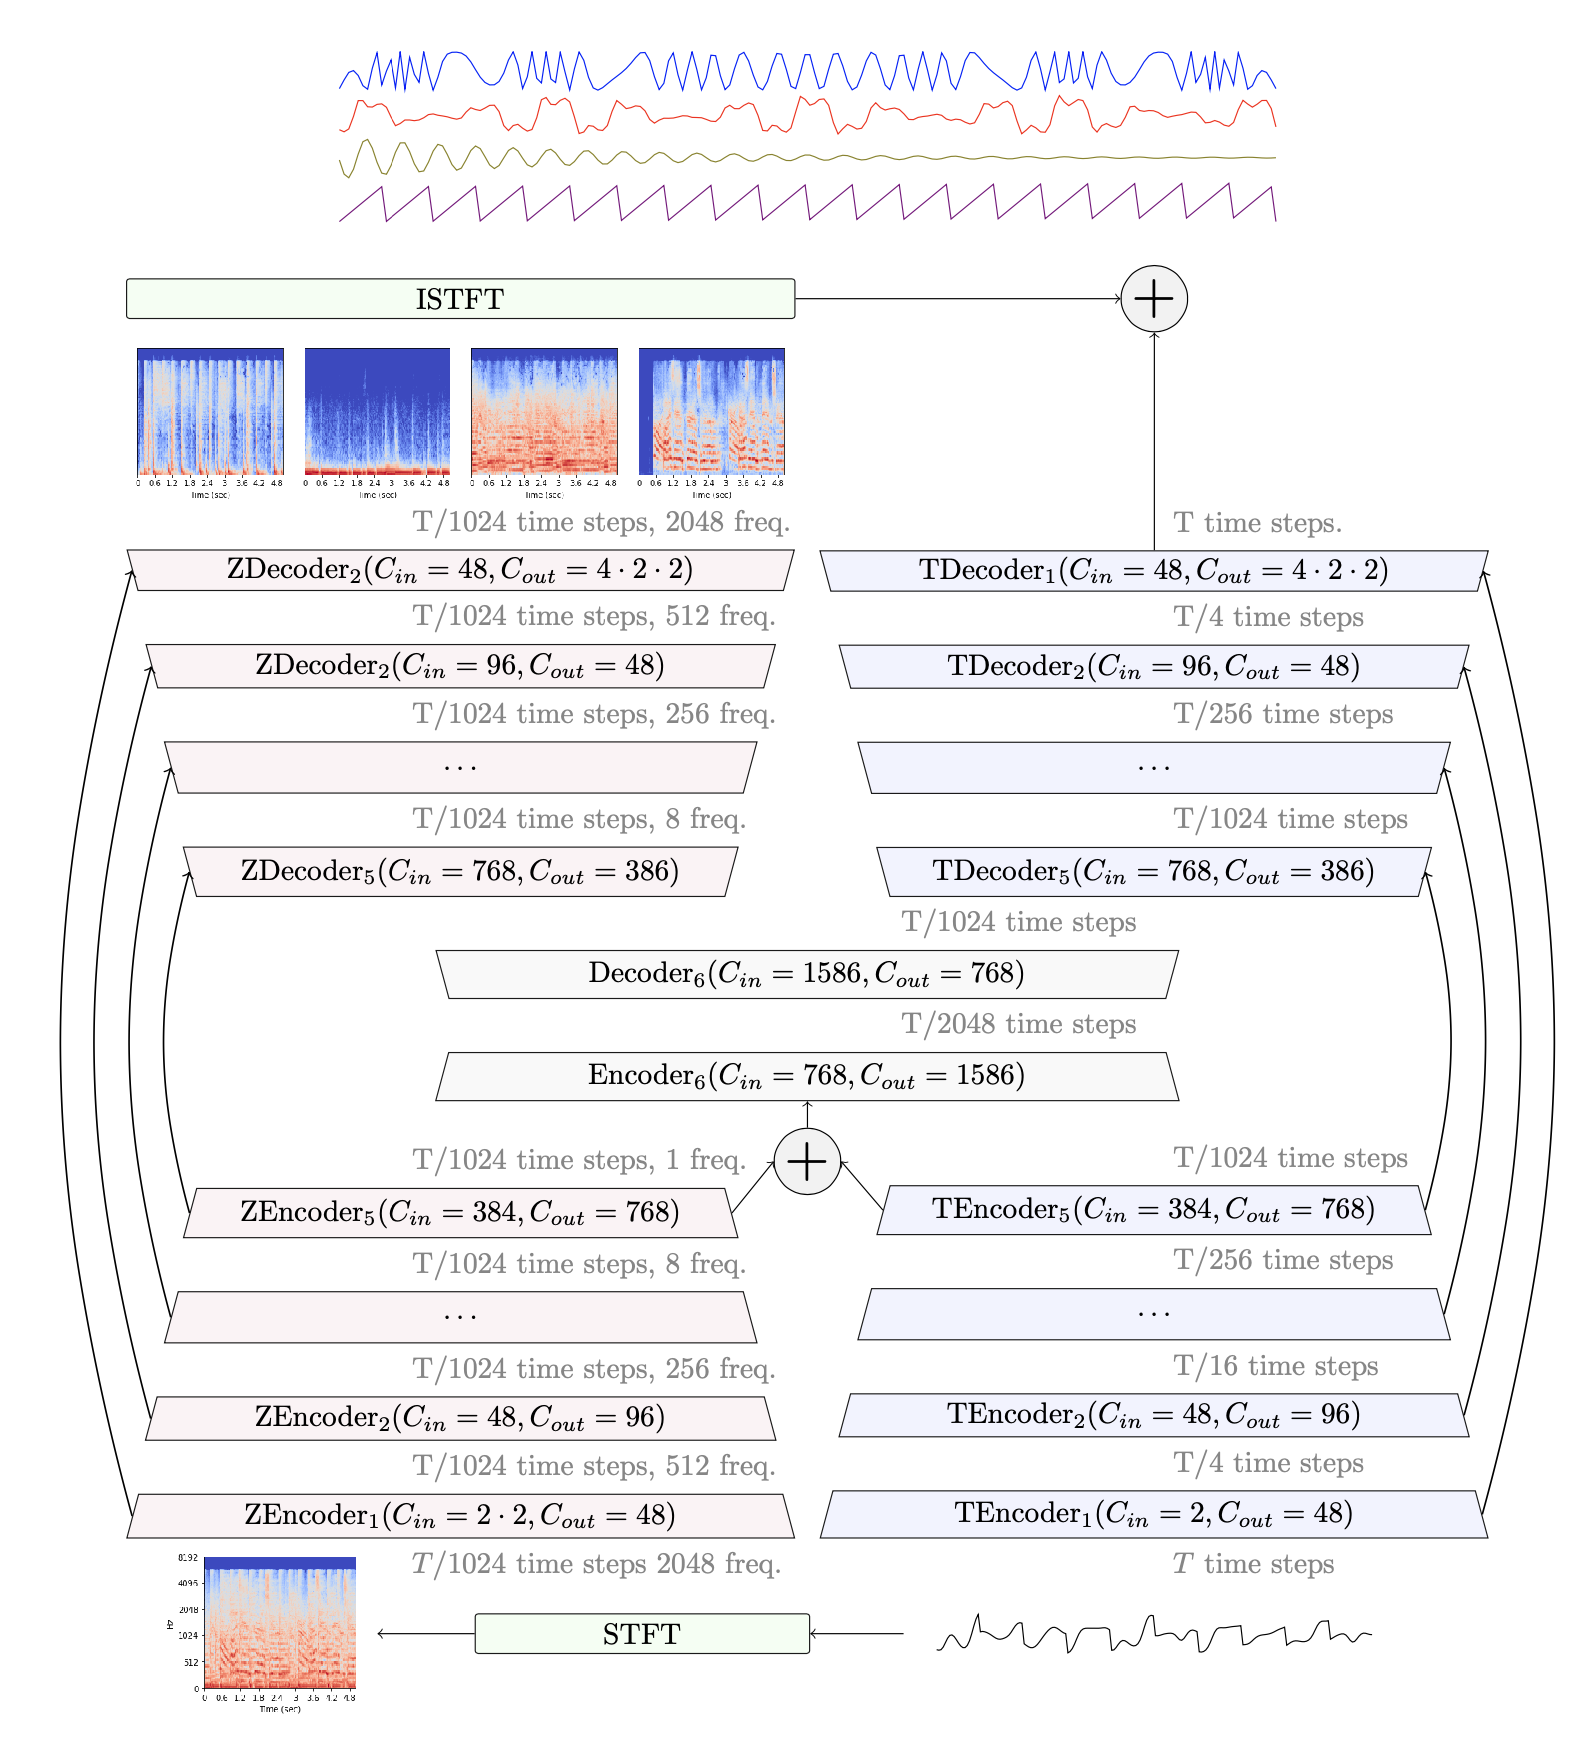
Oryginalny diagram: Wprowadzenie do separacji źródeł, rysunek 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Wyniki testów Spleeter i Demucs
Te wyniki na zbiorze testowym MUSDB18 pochodzą z oficjalnego repozytorium Demucs na GitHub:
| Model | Dziedzina | Dodatkowe dane treningowe | Ogólny SDR | Jakość MOS |
|---|---|---|---|---|
| Spleeter | Spektrogram | 25 000 utworów | 5,9 dB | brak danych |
| Demucs v2 | Przebieg czasowy | Brak (tylko MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Hybrydowa | Brak (tylko MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs v4 po dostrojeniu | Hybrydowa | 800 utworów | 9,0 dB | brak danych |
Stosunek sygnału do zniekształceń (SDR) mierzy, jak czysto model wyodrębnia źródło z miksu. Wyżej znaczy lepiej, ale SDR nie zastępuje odsłuchu. Praktyczne oczekiwania wobec ścieżek AI opisuje odpowiedź, jak dobra jest dziś separacja ścieżek AI. Różnica około 3 dB między Spleeter a Demucs v4 jest duża w kategoriach testowych, a Demucs uzyskuje wyższe wyniki dla każdej ścieżki, zwłaszcza perkusji i wokalu.
Różnicę usłyszysz w filmie porównawczym poniżej. Ścieżki Demucs brzmią naturalniej, z mniejszą liczbą artefaktów, a Spleeter może wytwarzać metaliczne dzwonienie na złożonym materiale.

Praktyczne znaczenie wydajności
Szybkość: Spleeter przetwarza 3-minutowy utwór w około 2 sekundy na GPU. Demucs v4 potrzebuje około 20 do 30 sekund. Na CPU Spleeter zajmuje mniej więcej 30 do 60 sekund, a Demucs może potrzebować ponad 5 minut.
Sprzęt: Spleeter działa wyłącznie na CPU na laptopie z 8 GB RAM. Demucs v4 potrzebuje GPU z 4 do 8 GB VRAM dla rozsądnej szybkości, a jego warstwy Transformer zużywają znacznie więcej pamięci z powodu macierzy uwagi.
Artefakty: ponieważ Spleeter ponownie używa fazy miksu, może tworzyć „widmowy” wokal i rozmazane transjenty. Demucs v4 brzmi naturalniej, ale może pozostawić cichy szum we fragmentach ciszy.
Odporność: konkurs SDX'23 pokazał, że architektury w stylu Demucs lepiej radzą sobie z uszkodzonymi danymi treningowymi. Prostsza architektura Spleeter nie może łatwo skorzystać z technik takich jak filtrowane zbiory danych i obcinanie wartości funkcji straty.
Spleeter czy Demucs: co wybrać?
Wielu producentów używa obu modeli, zależnie od zadania.
Kiedy używać Spleeter
Używaj Spleeter, gdy liczy się szybkość: szybkie partie a cappella do setów DJ-skich, podkłady karaoke do ćwiczeń lub przetwarzanie wsadowe całej biblioteki sampli. Przetwarzanie 100 razy szybsze od odtwarzania w czasie rzeczywistym i skromne wymagania sprzętowe są trudne do pobicia, a jakość wystarcza do remiksów, w których dalej przetworzysz ścieżki.
Kiedy używać Demucs
Wybierz Demucs v4, gdy artefakty są nie do zaakceptowania: ścieżki do oficjalnych remiksów, sample do komercyjnych wydań lub dokładna analiza wykonania. Poprawa jakości o 3 dB i spójność fazy uzasadniają czekanie. Dla materiału z określonego gatunku dostrajaj model na dodatkowych danych, ponieważ architektura Demucs lepiej skaluje się z czystymi danymi.
Łączenie Spleeter i Demucs
Przetwórz cały katalog w Spleeter, by znaleźć obiecujące utwory, a potem wybrane wersje w Demucs. Do występów na żywo rozdziel materiał wcześniej przez Spleeter. Do pracy studyjnej użyj Demucs dla najczystszych ścieżek. Narzędzia takie jak Ultimate Vocal Remover łączą Demucs z innymi modelami separacji w prostym interfejsie graficznym.
Czy potrzebujesz GPU?
Spleeter dobrze działa na CPU, a do wysokiej jakości separacji z Demucs zaleca się GPU, aby skrócić czas przetwarzania. Do przetwarzania offline lub wsadowego na laptopie modele w stylu Spleeter nadal się przydają. Dla czystszych ścieżek Demucs i nowsze hybrydowe modele z Transformer zwykle uzasadniają przetwarzanie w chmurze lub mocniejszy komputer lokalny.
Aktualizacja 2026: co przewyższa Spleeter i Demucs
Spleeter i Demucs nadal są użytecznymi punktami odniesienia, ale nie wyznaczają już najwyższej jakości separacji ścieżek.
BS-RoFormer (Band-Split RoPE Transformer) dzieli spektrogram na pasma częstotliwości i modeluje je warstwami Transformer. Jego publikacja podaje średni SDR 9,80 dB na MUSDB18-HQ bez dodatkowych danych treningowych, wyższy od 9,0 dB, które dostrojony Demucs v4 osiągnął z 800 dodatkowymi utworami. Wersja trenowana z 500 dodatkowymi utworami zajęła pierwsze miejsce w kategorii separacji muzyki Sound Demixing Challenge 2023.
| Model | Rok | Ogólny SDR (MUSDB18) | Dodatkowe dane treningowe |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25 000 utworów |
| HT Demucs po dostrojeniu (v4) | 2022 | 9,0 dB | 800 utworów |
| BS-RoFormer | 2023 | 9,8 dB | Brak |
Mel-Band RoFormer jest blisko spokrewnionym modelem grupującym częstotliwości według skali mel. Wagi obu modeli udostępniane przez społeczność napędzają dziś większość zaawansowanych separatorów wokalu i warstwy instrumentalnej. Nasze porównanie modeli separacji wokalu ocenia je na rzeczywistych utworach, a porównanie modeli separacji instrumentów robi to samo dla pozostałych instrumentów.
Separator ścieżek AI w Neural Analog korzysta z modeli BS-RoFormer dla presetów na 4 i 6 ścieżek oraz z SAM Audio, gdy chcesz wyodrębnić instrument nieuwzględniony przez presety, na przykład saksofon lub solową partię syntezatora. Pełną listę znajdziesz w odpowiedzi, jakich modeli Neural Analog używa do podziału na ścieżki.
FAQ: Spleeter i Demucs
Czy Demucs jest lepszy od Spleeter?
Tak, pod względem jakości. Demucs v4 uzyskuje SDR około 3 dB wyższy niż Spleeter na teście MUSDB18 i mniej artefaktów na wokalu oraz perkusji. Spleeter jest lepszy tylko wtedy, gdy szybkość lub komputer wyłącznie z CPU są ważniejsze niż jakość.
Co jest lepsze do wokalu: Spleeter czy Demucs?
Demucs. Wokal Spleeter często brzmi cienko lub „wodniście”, ponieważ Spleeter ponownie używa fazy oryginalnego miksu. Dla najczystszego wokalu i warstwy instrumentalnej model BS-RoFormer lub Mel-Band RoFormer zwykle przewyższa oba.
Czy Spleeter nadal jest rozwijany?
Spleeter nadal jest dostępny na GitHub, ale to model z 2019 roku oparty na TensorFlow, a jego README ostrzega o problemach TensorFlow na układach Apple M1. Większość nowszych narzędzi przeszła na Demucs lub modele RoFormer.
Z czego korzysta Ultimate Vocal Remover (UVR)?
UVR to darmowa aplikacja desktopowa, nie pojedynczy model. Łączy kilka rodzin modeli, między innymi Demucs, MDX-Net i własne modele VR Architecture, więc jakość zależy od wybranego modelu.
Czy mogę używać Demucs bez GPU?
Tak, ale działa wolno. Spodziewaj się kilku minut na utwór na CPU. Internetowy separator ścieżek uruchamia model na serwerowym GPU. Poradnik podziału na ścieżki w Studio pokazuje kroki.
Powiązane poradniki
- Usuń perkusję z utworu Suno: praktyczne zastosowanie separacji ścieżki perkusji.
- Zastąp perkusję AI własnym zestawem: wyodrębnij perkusję, potem zbuduj nowy groove wokół wokalu.
- Odnów ścieżki MP3 do jakości WAV: zrekonstruuj wysokie częstotliwości utracone przez skompresowane źródła i separację.
- Zamień utwór stereo na Dolby Atmos: umieść rozdzielone ścieżki w miksie Atmos.
- Zainstaluj i uruchom AudioSR z GitHub: kolejny model audio o otwartym kodzie do uruchomienia lokalnie, z konfiguracją Python i PyTorch.