Spleeter vs Demucs en 2026: resultados y modelos que superan a ambos
Elegir entre Spleeter y Demucs es elegir entre velocidad y calidad. Demucs separa las pistas con más limpieza (9,0 dB SDR para Demucs v4 con ajuste fino frente a 5,9 dB de Spleeter), mientras que Spleeter es mucho más rápido y funciona bien en una CPU modesta. En 2026, modelos más recientes como BS-RoFormer obtienen mejores puntuaciones que ambos.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Desarrollado por | Deezer, 2019 | Meta AI Research, 2022 |
| Cómo funciona | Aplica máscaras a un espectrograma (U-Net) | Ramas de forma de onda y espectrograma con un Transformer |
| Calidad (SDR en MUSDB18) | 5,9 dB | 9,0 dB (con ajuste fino) |
| Velocidad | Muy rápido, funciona bien en CPU | Más lento, mejor con GPU |
| Pistas | 2, 4 o 5 | 4, o 6 con guitarra y piano |
| Ideal para | Preescuchas rápidas, karaoke, procesos por lotes | Pistas limpias para remixes y lanzamientos |
Si has intentado extraer voces o crear un instrumental para un remix, seguramente has usado una herramienta basada en uno de ellos. Ambos modelos de código abierto se convirtieron en referentes de la separación de pistas. Compararlos sigue mostrando los compromisos entre velocidad, artefactos y calidad.
¿Qué son las pistas separadas y por qué es tan difícil aislarlas?
Las pistas separadas, o stems, son los componentes individuales de una canción mezclada, normalmente voces, batería, bajo y todo lo demás. Los productores trabajan con ellas en el estudio antes de combinarlas en la mezcla final.
Separarlas después de mezclar es como intentar deshacer un pastel ya horneado. Los instrumentos comparten rangos de frecuencias. Los armónicos de una voz se solapan con las frecuencias de la guitarra. Los transitorios del bombo se superponen a las notas de bajo. Los golpes de platos se extienden por todo el campo estéreo. El procesamiento tradicional de señales daba resultados oscilantes y llenos de artefactos.
El aprendizaje profundo mejoró esto entrenando redes neuronales para reconocer patrones que el procesamiento clásico de señales no detectaba. Spleeter y Demucs se convirtieron en los dos modelos de referencia, con enfoques muy diferentes.
Historia: Spleeter, Demucs y la conexión con París
Spleeter: enmascaramiento rápido de espectrogramas de Deezer
En noviembre de 2019, el servicio francés de streaming Deezer publicó Spleeter como herramienta gratuita de código abierto. El equipo, dirigido por Romain Hennequin, lo construyó en TensorFlow alrededor de una red neuronal convolucional U-Net que trabaja con espectrogramas de magnitud, representaciones tiempo-frecuencia del audio.
Spleeter trata la separación como segmentación de imágenes. Predice una máscara suave para cada celda tiempo-frecuencia y estima cuánto pertenece a voces, batería, bajo u otros sonidos. Un paso opcional de filtrado de Wiener refina las máscaras, y las pistas se reconstruyen con la fase de la mezcla original.
La fuerza de Spleeter es la velocidad. Separa una canción de cuatro minutos en segundos, llega a 100 veces la velocidad de tiempo real en GPU y funciona bien en CPU modestas. Ofrece configuraciones de 2 pistas (voces/acompañamiento), 4 pistas y 5 pistas. Se convirtió en una referencia de investigación y dio soporte a innumerables canales de remix de YouTube.
Demucs: separación en el dominio de la forma de onda de Meta
Mientras Spleeter se centraba en la velocidad, Meta AI Research, entonces Facebook AI Research, se centraba en la calidad. Alexandre Défossez, también francés, y su equipo presentaron Demucs en 2019, abreviatura de Deep Extractor for MUlti-Channel Sources, con un enfoque muy distinto.
En lugar de espectrogramas, Demucs trabaja directamente con formas de onda sin procesar y trata la separación como un problema de reconstrucción en el dominio temporal. Su arquitectura combina un encoder-decoder convolucional de estilo U-Net, inspirado en Wave-U-Net, con un cuello de botella LSTM bidireccional. Esto permite capturar la estructura musical a largo plazo y mantener la coherencia de fase.
Demucs evolucionó en cuatro versiones principales:
- v1 (2019): enfoque solo de forma de onda, que ya competía con los métodos de espectrograma
- v2 (2020): entrenamiento refinado y mejoras de eficiencia
- v3 «Hybrid Demucs» (2021): añadió una rama de espectrograma y ganó el Music Demixing Challenge con 7,7 dB SDR en MUSDB18
- v4 «Hybrid Transformer Demucs» (2022): sustituyó las capas más internas por un Transformer entre dominios, alcanzando 9,0 dB SDR con ajuste fino y hasta 9,2 dB en la mejor configuración del artículo de investigación
El Sound Demixing Challenge y un nuevo comienzo
El Sound Demixing Challenge 2023 cambió el enfoque. Organizado por Meta, Sony y otros, introdujo la separación robusta de fuentes musicales: entrenar modelos con datos de etiquetas ruidosas y filtraciones entre pistas. Alexandre Défossez fue uno de los organizadores principales y contribuyó al diseño del reto y a los modelos de referencia.
El hallazgo principal fue que más datos de entrenamiento no garantizan mejores resultados. La calidad de los datos y las estrategias de robustez importan más. Técnicas como truncar la función de pérdida y el refinamiento iterativo mejoraron el SDR en 0,89 dB con datos ruidosos.
Poco después, Défossez dejó Meta para cofundar Kyutai, un laboratorio francés de investigación en IA. El repositorio Demucs sigue en línea, pero su README indica que ya no trabaja activamente en él, así que no esperes funciones nuevas.
Rendimiento: compromisos entre velocidad y calidad
Filosofía de las arquitecturas
Spleeter enmascara espectrogramas. Demucs reconstruye formas de onda. Esta diferencia central determina todo lo demás.
El enfoque de Spleeter en el dominio frecuencial es eficiente porque cada trama STFT resume miles de muestras, así que las convoluciones abarcan muchos menos pasos temporales. El coste: el modelo ignora la fase y reutiliza la de la mezcla. Además, la resolución tiempo-frecuencia fija de la STFT no representa bien a la vez los transitorios nítidos y los tonos estables.
El método temporal de Demucs aprende sus propios bancos de filtros mediante convoluciones 1D. Conserva la fase y trata los transitorios con exactitud a nivel de muestra. En v4, las capas Transformer mantienen el contexto durante varios segundos de audio, reduciendo los artefactos de «ping-pong» habituales en los métodos basados en tramas.
Hybrid Demucs v3: ramas de forma de onda y espectrograma
Conexiones de salto entre encoder y decoder
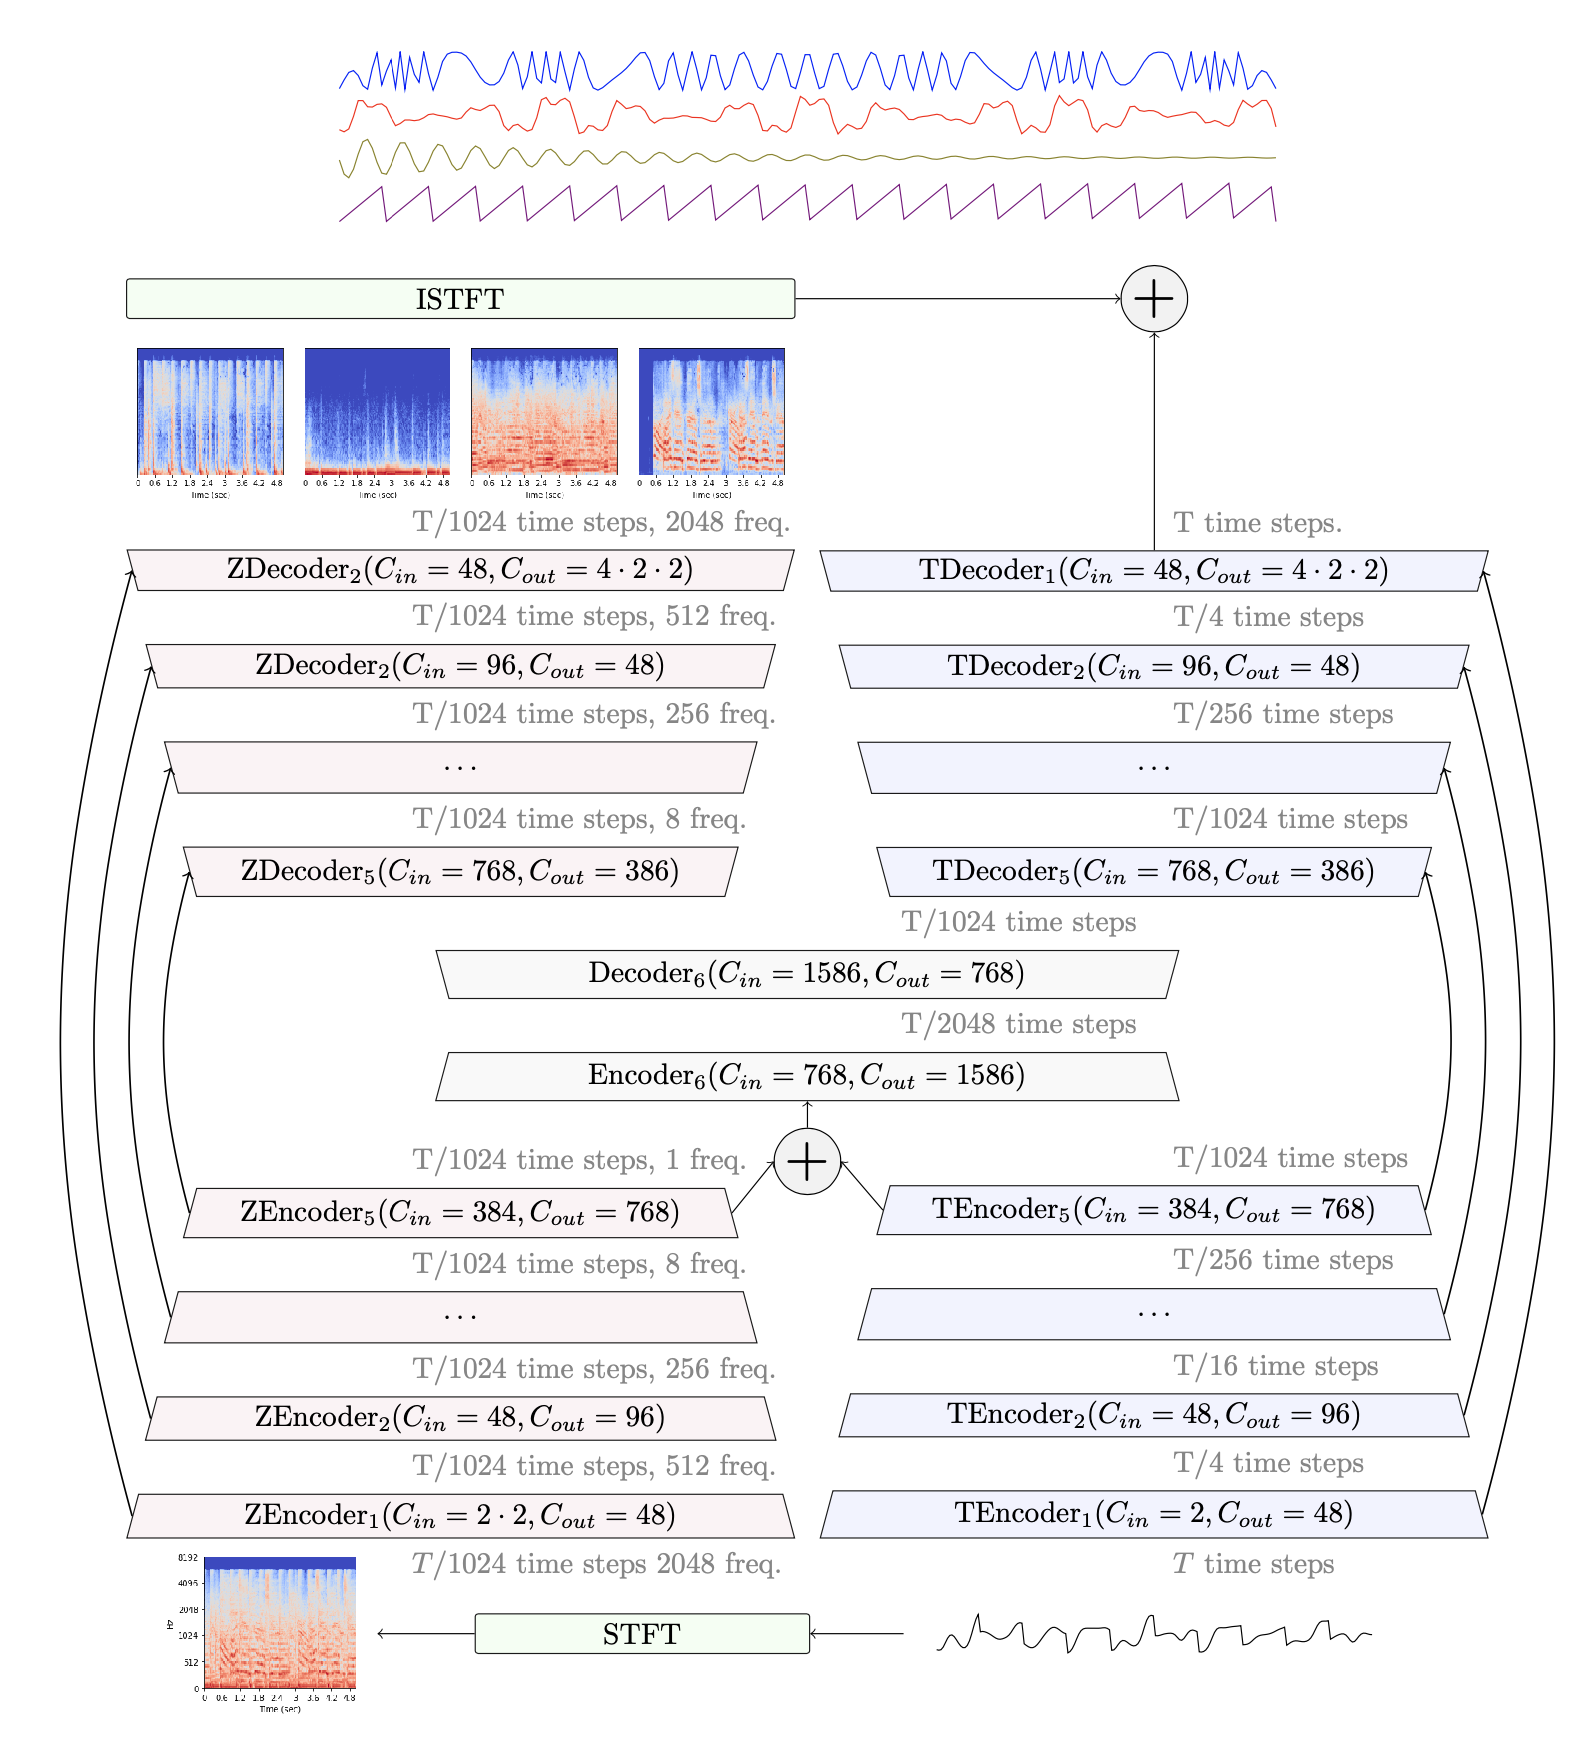
Figura original: Introducción a la separación de fuentes, figura 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Resultados comparativos de Spleeter y Demucs
Estas puntuaciones del conjunto de prueba MUSDB18 proceden del repositorio oficial de Demucs en GitHub:
| Modelo | Dominio | Datos adicionales de entrenamiento | SDR global | Calidad MOS |
|---|---|---|---|---|
| Spleeter | Espectrograma | 25.000 canciones | 5,9 dB | n/d |
| Demucs v2 | Forma de onda | Ninguno (solo MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Híbrido | Ninguno (solo MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs fine-tuned v4 | Híbrido | 800 canciones | 9,0 dB | n/d |
La relación señal-distorsión (SDR) mide con qué limpieza un modelo separa una fuente de la mezcla. Cuanto mayor, mejor, pero el SDR no sustituye una prueba de escucha. Para saber qué esperar en la práctica de las pistas IA, consulta la calidad actual de la separación de pistas con IA. La diferencia de unos 3 dB entre Spleeter y Demucs v4 es grande en términos de resultados comparativos, y Demucs puntúa mejor en todas las pistas, sobre todo batería y voces.
Puedes oír la diferencia en el vídeo comparativo de abajo. Las pistas de Demucs suenan más naturales y tienen menos artefactos, mientras que Spleeter puede producir resonancias metálicas en material complejo.

Consecuencias en la práctica
Velocidad: Spleeter procesa una canción de 3 minutos en unos 2 segundos en GPU. Demucs v4 tarda unos 20 a 30 segundos. En CPU, Spleeter tarda aproximadamente 30 a 60 segundos, y Demucs puede superar los 5 minutos.
Hardware: Spleeter funciona solo con CPU en un portátil con 8 GB de RAM. Demucs v4 necesita una GPU con 4 a 8 GB de VRAM para una velocidad razonable, y sus capas Transformer usan mucha más memoria por las matrices de atención.
Artefactos: como Spleeter reutiliza la fase de la mezcla, puede producir voces «fantasmales» y transitorios difuminados. Demucs v4 suena más natural, pero puede dejar ruido de bajo nivel en los pasajes silenciosos.
Robustez: el reto SDX'23 mostró que las arquitecturas de estilo Demucs manejan mejor los datos de entrenamiento corruptos. La arquitectura más simple de Spleeter no puede aprovechar fácilmente técnicas como conjuntos de datos filtrados y truncamiento de la función de pérdida.
Spleeter o Demucs: ¿cuál deberías usar?
Muchos productores usan ambos, según el trabajo.
Cuándo usar Spleeter
Usa Spleeter cuando importe la velocidad: a cappellas rápidas para sesiones DJ, pistas de karaoke para practicar o procesamiento por lotes de una biblioteca entera de muestras. Su velocidad de 100 veces el tiempo real y sus modestos requisitos de hardware son difíciles de superar. La calidad basta para remixes en los que seguirás procesando las pistas.
Cuándo usar Demucs
Elige Demucs v4 cuando los artefactos sean inaceptables: pistas para remixes oficiales, muestras para lanzamientos comerciales o análisis minucioso de una interpretación. La mejora de calidad de 3 dB y la coherencia de fase justifican la espera. Si tienes material de un género específico, haz ajuste fino con datos adicionales, porque la arquitectura de Demucs escala mejor con datos limpios.
Combinar Spleeter y Demucs
Ejecuta Spleeter en todo tu catálogo para encontrar canciones prometedoras y después procesa las finalistas con Demucs. Para actuaciones en directo, separa antes con Spleeter. En el estudio, usa Demucs para las pistas más limpias. Herramientas como Ultimate Vocal Remover reúnen Demucs y otros modelos de separación en una interfaz gráfica sencilla.
¿Necesitas una GPU?
Spleeter funciona bien en CPU, mientras que los flujos de Demucs de alta calidad realmente se benefician de una GPU. Para procesamiento por lotes sin conexión o cómodo en un portátil, los modelos de estilo Spleeter siguen siendo útiles. Para pistas más limpias, Demucs y los modelos Transformer híbridos más recientes suelen justificar el procesamiento en la nube o un equipo local más potente.
Actualización de 2026: modelos que superan a Spleeter y Demucs
Spleeter y Demucs siguen siendo referentes útiles, pero ya no marcan el límite de calidad de la separación de pistas.
BS-RoFormer (Band-Split RoPE Transformer) divide el espectrograma en bandas de frecuencias y las modela con capas Transformer. Su artículo de investigación indica 9,80 dB de SDR medio en MUSDB18-HQ sin datos adicionales de entrenamiento, más que los 9,0 dB que alcanzó Demucs v4 con ajuste fino y 800 canciones adicionales. Una versión entrenada con 500 canciones adicionales ganó el primer puesto en la categoría de separación musical del Sound Demixing Challenge 2023.
| Modelo | Año | SDR global (MUSDB18) | Datos adicionales de entrenamiento |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25.000 canciones |
| HT Demucs fine-tuned (v4) | 2022 | 9,0 dB | 800 canciones |
| BS-RoFormer | 2023 | 9,8 dB | Ninguno |
Mel-Band RoFormer es un pariente cercano que agrupa frecuencias en la escala mel. Los checkpoints comunitarios de ambos modelos alimentan hoy la mayoría de los separadores de voces e instrumentales de gama alta. Nuestra comparativa de modelos de separación vocal los clasifica con canciones reales, y la comparativa de modelos de separación instrumental hace lo mismo con otros instrumentos.
El separador de pistas IA de Neural Analog usa modelos BS-RoFormer para sus preajustes de 4 y 6 pistas, y SAM Audio cuando quieres extraer un instrumento no cubierto por los preajustes, como un saxofón o un sintetizador solista. Consulta qué modelos usa Neural Analog para separar pistas para ver la lista completa.
Preguntas frecuentes sobre Spleeter y Demucs
¿Demucs es mejor que Spleeter?
Sí, en calidad. Demucs v4 logra un SDR unos 3 dB mayor que Spleeter en MUSDB18 y tiene menos artefactos en voces y batería. Spleeter solo es mejor cuando la velocidad o un equipo sin GPU importan más que la calidad.
¿Qué es mejor para voces, Spleeter o Demucs?
Demucs. Las voces de Spleeter suelen sonar finas o como «bajo el agua» porque reutiliza la fase de la mezcla original. Para voces e instrumentales más limpios, un modelo BS-RoFormer o Mel-Band RoFormer suele superar a ambos.
¿Sigue manteniéndose Spleeter?
Spleeter sigue disponible en GitHub, pero es un modelo de 2019 basado en TensorFlow, y su README advierte de problemas de TensorFlow en chips Apple M1. La mayoría de las herramientas más recientes han pasado a Demucs o a modelos RoFormer.
¿Qué usa Ultimate Vocal Remover (UVR)?
UVR es una aplicación de escritorio gratuita, no un solo modelo. Incluye varias familias de modelos, entre ellas Demucs, MDX-Net y sus propios modelos VR Architecture, así que su calidad depende del modelo que elijas.
¿Puedo usar Demucs sin GPU?
Sí, pero es lento. Espera varios minutos por canción en CPU. Un separador de pistas en línea ejecuta el modelo en la GPU de un servidor. La guía de Studio para separar pistas muestra los pasos.
Guías relacionadas
- Quitar la batería de una canción de Suno: un uso práctico de la separación de pistas de batería.
- Sustituir la batería IA por tu propio kit: separa la batería y crea un groove nuevo alrededor de la voz.
- Restaurar pistas MP3 a calidad WAV: reconstruye los agudos que pierden las fuentes comprimidas y la separación.
- Convertir una canción estéreo a Dolby Atmos: sitúa las pistas separadas en una mezcla Atmos.
- Instalar y ejecutar AudioSR desde GitHub: otro modelo de audio de código abierto para ejecutar localmente, con configuración de Python y PyTorch.