Spleeter vs Demucs em 2026: resultados e modelos que superam os dois
A escolha entre Spleeter e Demucs se resume a velocidade versus qualidade. O Demucs separa stems com mais limpeza (9,0 dB SDR para o Demucs v4 com ajuste fino contra 5,9 dB do Spleeter), enquanto o Spleeter é muito mais rápido e roda bem em uma CPU modesta. Em 2026, modelos mais novos, como BS-RoFormer, alcançam resultados melhores que os dois.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Desenvolvido por | Deezer, 2019 | Meta AI Research, 2022 |
| Como funciona | Aplica máscaras a um espectrograma (U-Net) | Ramos de forma de onda e espectrograma com um Transformer |
| Qualidade (SDR no MUSDB18) | 5,9 dB | 9,0 dB (com ajuste fino) |
| Velocidade | Muito rápido, funciona bem em CPU | Mais lento, melhor com GPU |
| Stems | 2, 4 ou 5 | 4, ou 6 com guitarra e piano |
| Ideal para | Prévias rápidas, karaokê, processamento em lote | Stems limpos para remixes e lançamentos |
Se você já tentou extrair vocais ou fazer um instrumental para um remix, provavelmente usou uma ferramenta baseada em um deles. Os dois modelos de código aberto se tornaram referências para separação de stems, e compará-los ainda mostra os compromissos entre velocidade, artefatos e qualidade.
O que são stems e por que é tão difícil separá-los?
Stems são os componentes individuais de uma música mixada, normalmente vocais, bateria, baixo e todo o resto. Produtores trabalham com eles no estúdio antes de juntar tudo na mixagem final.
Separá-los depois da mixagem é como tentar desfazer um bolo já assado. Instrumentos compartilham as mesmas faixas de frequência. Os harmônicos da voz se sobrepõem às frequências da guitarra. Os transientes do bumbo se sobrepõem às notas de baixo. Os ataques dos pratos se espalham por todo o campo estéreo. O processamento tradicional de sinais deixava resultados oscilantes e cheios de artefatos.
O aprendizado profundo melhorou isso treinando redes neurais para reconhecer padrões que o processamento clássico de sinais não detectava. Spleeter e Demucs se tornaram os dois modelos de referência, com abordagens muito diferentes.
História: Spleeter, Demucs e a conexão com Paris
Spleeter: mascaramento rápido de espectrogramas da Deezer
Em novembro de 2019, o serviço francês de streaming Deezer lançou o Spleeter como uma ferramenta gratuita de código aberto. A equipe liderada por Romain Hennequin o construiu no TensorFlow em torno de uma rede neural convolucional U-Net que trabalha com espectrogramas de magnitude, representações do áudio em tempo e frequência.
O Spleeter trata a separação como segmentação de imagem. Ele prevê uma máscara suave para cada célula de tempo e frequência, estimando quanto pertence a vocais, bateria, baixo ou outros sons. Uma etapa opcional de filtragem de Wiener refina as máscaras, e os stems são reconstruídos usando a fase da mixagem original.
A força do Spleeter é a velocidade. Ele separa uma música de quatro minutos em segundos, alcançando 100 vezes a velocidade de tempo real em GPU, e roda bem em CPUs modestas. Oferece configurações de 2 stems (vocais/acompanhamento), 4 stems e 5 stems. Tornou-se uma referência de pesquisa e alimentou inúmeros canais de remix no YouTube.
Demucs: separação no domínio da forma de onda da Meta
Enquanto o Spleeter focava em velocidade, a Meta AI Research, na época Facebook AI Research, focava em qualidade. Alexandre Défossez, também francês, e sua equipe apresentaram o Demucs em 2019, abreviação de Deep Extractor for MUlti-Channel Sources, com uma abordagem bem diferente.
Em vez de espectrogramas, o Demucs trabalha diretamente com formas de onda brutas e trata a separação como um problema de reconstrução no domínio do tempo. Sua arquitetura combina um encoder-decoder convolucional no estilo U-Net, inspirado no Wave-U-Net, com um gargalo LSTM bidirecional. Isso permite capturar a estrutura musical de longo prazo e manter a coerência de fase.
O Demucs evoluiu por quatro versões principais:
- v1 (2019): abordagem exclusivamente de forma de onda, já competindo com métodos de espectrograma
- v2 (2020): treinamento refinado e melhorias de eficiência
- v3 “Hybrid Demucs” (2021): adicionou um ramo de espectrograma e venceu o Music Demixing Challenge com 7,7 dB SDR no MUSDB18
- v4 “Hybrid Transformer Demucs” (2022): substituiu as camadas mais internas por um Transformer entre domínios, chegando a 9,0 dB SDR com ajuste fino e até 9,2 dB na melhor configuração do artigo de pesquisa
O Sound Demixing Challenge e um novo começo
O Sound Demixing Challenge 2023 mudou o foco. Organizado por Meta, Sony e outros, ele introduziu a separação robusta de fontes musicais: treinar modelos com dados de rótulos ruidosos e vazamento entre stems. Alexandre Défossez foi um dos principais organizadores e contribuiu para o desenho do desafio e os modelos de referência.
O principal resultado foi que mais dados de treinamento não garantem resultados melhores. A qualidade dos dados e as estratégias de robustez importam mais. Técnicas como truncamento da função de perda e refinamento iterativo melhoraram o SDR em 0,89 dB com dados ruidosos.
Pouco depois, Défossez saiu da Meta para cofundar a Kyutai, um laboratório francês de pesquisa em IA. O repositório Demucs continua online, mas seu README informa que ele não trabalha mais ativamente no projeto, então não espere novos recursos.
Desempenho: compromissos entre velocidade e qualidade
Filosofia das arquiteturas
O Spleeter mascara espectrogramas. O Demucs reconstrói formas de onda. Essa diferença central determina todo o resto.
A abordagem do Spleeter no domínio da frequência é eficiente porque cada quadro STFT resume milhares de amostras, então as convoluções percorrem muito menos passos de tempo. O custo: o modelo ignora a fase e reutiliza a da mixagem. A resolução fixa de tempo e frequência da STFT não representa bem ao mesmo tempo transientes nítidos e tons estáveis.
O método temporal do Demucs aprende seus próprios bancos de filtros por meio de convoluções 1D. Ele preserva a fase e trata transientes com exatidão em nível de amostra. Na v4, as camadas Transformer mantêm o contexto por vários segundos de áudio, reduzindo os artefatos de “pingue-pongue” comuns em métodos baseados em quadros.
Hybrid Demucs v3: ramos de forma de onda e espectrograma
Conexões de salto entre encoder e decoder
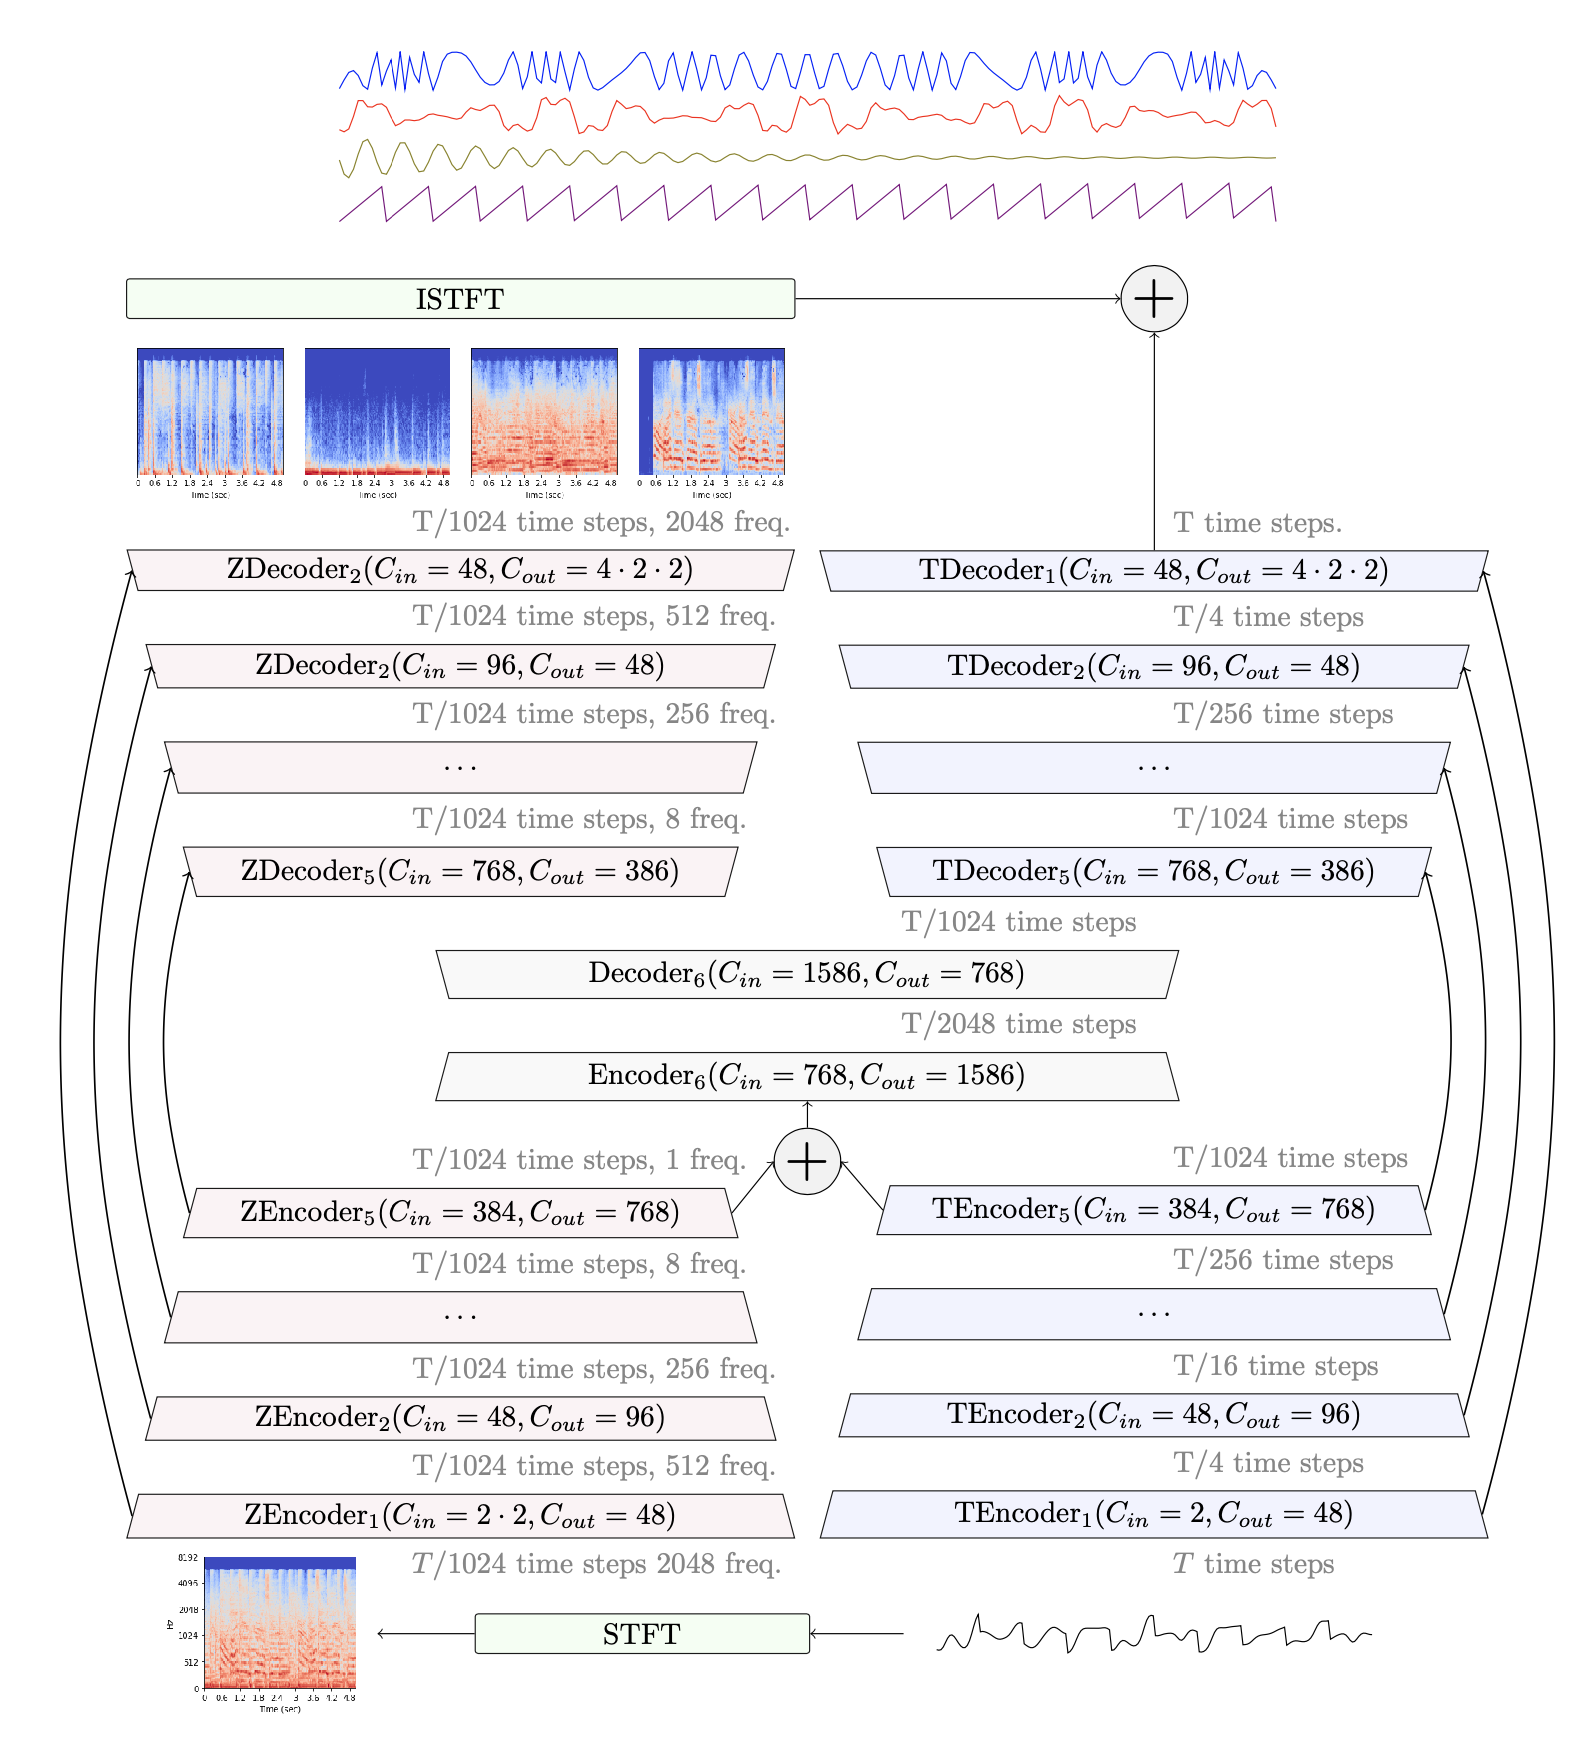
Figura original: Introdução à separação de fontes, figura 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Resultados comparativos de Spleeter e Demucs
Estes resultados no conjunto de teste MUSDB18 vêm do repositório oficial do Demucs no GitHub:
| Modelo | Domínio | Dados extras de treinamento | SDR geral | Qualidade MOS |
|---|---|---|---|---|
| Spleeter | Espectrograma | 25.000 músicas | 5,9 dB | n/d |
| Demucs v2 | Forma de onda | Nenhum (apenas MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Híbrido | Nenhum (apenas MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs fine-tuned v4 | Híbrido | 800 músicas | 9,0 dB | n/d |
A relação sinal-distorção (SDR) mede com que limpeza um modelo separa uma fonte da mixagem. Quanto maior, melhor, mas o SDR não substitui um teste de audição. Para saber o que esperar dos stems de IA na prática, veja a qualidade atual da separação de stems com IA. A diferença de aproximadamente 3 dB entre Spleeter e Demucs v4 é grande nos testes comparativos, e o Demucs pontua melhor em todos os stems, principalmente bateria e vocais.
Você pode ouvir a diferença no vídeo comparativo abaixo. Os stems do Demucs soam mais naturais e têm menos artefatos, enquanto o Spleeter pode produzir ressonâncias metálicas em material complexo.

Consequências na prática
Velocidade: o Spleeter processa uma música de 3 minutos em cerca de 2 segundos em GPU. O Demucs v4 leva cerca de 20 a 30 segundos. Em CPU, o Spleeter leva aproximadamente 30 a 60 segundos, e o Demucs pode levar mais de 5 minutos.
Hardware: o Spleeter funciona só com CPU em um notebook com 8 GB de RAM. O Demucs v4 precisa de uma GPU com 4 a 8 GB de VRAM para uma velocidade razoável, e suas camadas Transformer usam muito mais memória por causa das matrizes de atenção.
Artefatos: como o Spleeter reutiliza a fase da mixagem, pode produzir vocais “fantasmagóricos” e transientes borrados. O Demucs v4 soa mais natural, mas pode deixar ruído de baixo nível em trechos silenciosos.
Robustez: o desafio SDX'23 mostrou que arquiteturas no estilo Demucs lidam melhor com dados de treinamento corrompidos. A arquitetura mais simples do Spleeter não consegue aproveitar facilmente técnicas como conjuntos de dados filtrados e truncamento da função de perda.
Spleeter ou Demucs: qual você deve usar?
Muitos produtores usam os dois, dependendo do trabalho.
Quando usar o Spleeter
Use o Spleeter quando a velocidade importa: a cappellas rápidas para sets de DJ, faixas de karaokê para praticar ou processamento em lote de uma biblioteca inteira de samples. Sua velocidade de 100 vezes o tempo real e seus requisitos modestos de hardware são difíceis de superar. A qualidade basta para remixes nos quais você ainda vai processar os stems.
Quando usar o Demucs
Escolha o Demucs v4 quando os artefatos são inaceitáveis: stems para remixes oficiais, samples para lançamentos comerciais ou análise detalhada de uma execução. O ganho de qualidade de 3 dB e a coerência de fase justificam a espera. Se você tem material de um gênero específico, faça ajuste fino com dados extras, pois a arquitetura do Demucs escala melhor com dados limpos.
Combinar Spleeter e Demucs
Execute o Spleeter no catálogo inteiro para encontrar músicas promissoras e depois processe as finalistas com Demucs. Para apresentações ao vivo, separe antes com o Spleeter. No estúdio, use o Demucs para os stems mais limpos. Ferramentas como Ultimate Vocal Remover reúnem Demucs e outros modelos de separação em uma interface gráfica simples.
Você precisa de uma GPU?
O Spleeter funciona bem em CPU, enquanto fluxos de Demucs de alta qualidade realmente se beneficiam de uma GPU. Para processamento em lote offline ou adequado a notebooks, os modelos no estilo Spleeter ainda são úteis. Para stems mais limpos, Demucs e os modelos Transformer híbridos mais novos geralmente justificam processamento na nuvem ou uma máquina local mais potente.
Atualização de 2026: modelos que superam Spleeter e Demucs
Spleeter e Demucs ainda são referências úteis, mas deixaram de representar o limite de qualidade da separação de stems.
BS-RoFormer (Band-Split RoPE Transformer) divide o espectrograma em bandas de frequência e as modela com camadas Transformer. Seu artigo de pesquisa informa 9,80 dB de SDR médio no MUSDB18-HQ sem dados extras de treinamento, acima dos 9,0 dB que o Demucs v4 com ajuste fino alcançou com 800 músicas extras. Uma versão treinada com 500 músicas extras ganhou o primeiro lugar na categoria de separação musical do Sound Demixing Challenge 2023.
| Modelo | Ano | SDR geral (MUSDB18) | Dados extras de treinamento |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25.000 músicas |
| HT Demucs fine-tuned (v4) | 2022 | 9,0 dB | 800 músicas |
| BS-RoFormer | 2023 | 9,8 dB | Nenhum |
Mel-Band RoFormer é um parente próximo que agrupa frequências na escala mel. Checkpoints da comunidade de ambos os modelos agora alimentam a maioria dos separadores de vocais e instrumentais de alto nível. Nossa comparação de modelos de separação vocal classifica os modelos com músicas reais, e a comparação de modelos de separação instrumental faz o mesmo para outros instrumentos.
O separador de stems com IA do Neural Analog usa modelos BS-RoFormer nos presets de 4 e 6 stems, e SAM Audio quando você quer extrair um instrumento que os presets não cobrem, como um saxofone ou um sintetizador solo. Veja quais modelos o Neural Analog usa para separar stems para conferir a lista completa.
Perguntas frequentes sobre Spleeter e Demucs
O Demucs é melhor que o Spleeter?
Sim, em qualidade. O Demucs v4 alcança um SDR cerca de 3 dB maior que o Spleeter no MUSDB18 e tem menos artefatos em vocais e bateria. O Spleeter só é melhor quando velocidade ou uma máquina sem GPU importam mais que qualidade.
Qual é melhor para vocais, Spleeter ou Demucs?
Demucs. Os vocais do Spleeter costumam soar finos ou como se estivessem “debaixo d’água” porque ele reutiliza a fase da mixagem original. Para vocais e instrumentais mais limpos, um modelo BS-RoFormer ou Mel-Band RoFormer costuma superar os dois.
O Spleeter ainda recebe manutenção?
O Spleeter continua disponível no GitHub, mas é um modelo de 2019 baseado em TensorFlow, e seu README alerta sobre problemas de TensorFlow em chips Apple M1. A maioria das ferramentas mais novas passou para Demucs ou modelos RoFormer.
O que o Ultimate Vocal Remover (UVR) usa?
O UVR é um aplicativo de desktop gratuito, não um único modelo. Ele reúne várias famílias de modelos, incluindo Demucs, MDX-Net e seus próprios modelos VR Architecture, então a qualidade depende do modelo que você escolhe.
Posso usar o Demucs sem GPU?
Sim, mas é lento. Espere vários minutos por música em CPU. Um separador de stems online executa o modelo na GPU de um servidor. O guia do Studio para separar stems mostra os passos.
Guias relacionados
- Remover a bateria de uma música do Suno: um uso prático da separação de stems de bateria.
- Substituir a bateria de IA pelo seu próprio kit: separe a bateria e crie um groove novo em torno do vocal.
- Restaurar stems MP3 para qualidade WAV: reconstrua os agudos perdidos pelas fontes comprimidas e pela separação.
- Converter uma música estéreo para Dolby Atmos: coloque os stems separados em uma mixagem Atmos.
- Instalar e executar AudioSR pelo GitHub: outro modelo de áudio de código aberto para executar localmente, com configuração de Python e PyTorch.