Separação de stems de qualidade com IA: extraia stems limpos com SAM Audio e BS-RoFormer
A separação de stems de qualidade com IA depende de três fatores: o modelo certo para a tarefa, processamento estéreo da faixa inteira e restauração da fonte quando ela apresenta danos de compressão. Use um modelo especializado de stems fixos, como o BS-RoFormer, para voz, bateria e baixo, e o SAM Audio da Meta para outros instrumentos. Você obtém stems mais limpos do que com ferramentas antigas, como Spleeter ou as primeiras versões do Demucs.
Produtores, DJs e criadores de conteúdo enfrentam o mesmo problema. Você precisa de uma voz a cappella limpa para um remix, uma faixa sem bateria para praticar ou um riff de guitarra isolado para criar um sample. Ferramentas antigas de separação deixam as vozes emboladas e resíduos fantasmagóricos da bateria.
Este guia explica o que são stems, por que a maioria das ferramentas de separação introduz artefatos e como obter stems utilizáveis em produções reais, inclusive a partir de músicas Suno.
O que são stems? Fundamentos da separação de áudio
Stems são faixas de áudio individuais extraídas de uma música mixada. Em vez de um único arquivo estéreo com tudo, você recebe arquivos separados de voz, bateria, baixo, piano e outros instrumentos. Cada stem contém apenas aquele elemento.
Existem stems secos, sem efeitos, e stems com efeitos, como reverberação e compressão. Os stems secos são os ingredientes antes de cozinhar; os stems com efeitos são o prato pronto. Os modelos deste artigo extraem apenas stems com efeitos, então cada stem mantém os efeitos que tinha na mixagem.
Por que os stems importam na produção musical atual
Os stems transformam uma mixagem estéreo estática em partes flexíveis. Com stems de qualidade, você pode:
- Criar faixas de karaokê removendo a voz
- Produzir mashups com vozes a cappella bem isoladas
- Criar remixes a partir da voz original, a ideia por trás do recurso de remix com IA planejado pelo Spotify
- Reequilibrar mixagens ajustando o nível de cada instrumento
- Aprender músicas ouvindo partes específicas em solo
- Criar samples sem vazamento de outros instrumentos
- Corrigir frequências problemáticas em faixas isoladas
Antes da IA, a separação de stems dependia de filtragem por EQ e cancelamento de fase, que criavam artefatos e nunca isolavam uma parte completamente. Os modelos de IA melhoraram esse processo ao aprender a reconhecer timbre e estrutura harmônica em vez de apenas filtrar frequências.
O problema da maioria dos serviços de separação de stems
As ferramentas de separação com IA não são iguais. Muitos serviços prometem "alta qualidade", mas descuidam dos fundamentos:
Demonstrações versus ferramentas de produção
O ambiente de demonstração do SAM Audio da Meta processa apenas trechos de 30 segundos em mono. Isso serve para uma demonstração, mas não para uma música completa em estéreo. Veja como o Neural Analog se diferencia do ambiente de demonstração do SAM Audio.
Limitações de um único modelo
Muitos serviços usam um só modelo, o que exige concessões. Modelos de stems fixos, como Demucs ou BS-RoFormer, funcionam bem em separações predefinidas de voz, bateria, baixo e outros, mas não conseguem extrair instrumentos personalizados, como saxofone ou sintetizador. Outros modelos oferecem extração personalizada, mas separam os stems padrão com menos limpeza do que ferramentas especializadas.
Sem um pipeline de restauração de áudio
Separar fontes comprimidas, como MP3 ou gravações de streaming, expõe seus artefatos existentes. MP3 de bitrate baixo costumam cortar tudo acima de aproximadamente 16 kHz e adicionar ruído de quantização que borra os transientes. Uma ferramenta de separação que ignora isso apenas isola com mais clareza um áudio danificado.
Como o SAM Audio aprimora a separação de stems
O SAM Audio da Meta é um modelo geral de separação de fontes, em vez de uma ferramenta especializada em remover voz. A Meta o descreve como um único modelo que aceita prompts de texto, visuais e de intervalos temporais, baseado em um transformer de correspondência de fluxos e treinado com misturas de áudio em larga escala que incluem fala, música e sons gerais.
Ouça a diferença: SAM Audio versus referências do setor
Abaixo está uma comparação real. Pegamos uma mixagem de música clássica densa e isolamos o stem de piano com SAM Audio no Neural Analog e com um concorrente de destaque.
Exemplo: comparação da extração de piano
Isolamento de um único instrumento em uma mixagem estéreo densa com o prompt 'piano'.
A tecnologia por trás do SAM Audio
O SAM Audio usa um transformer de correspondência de fluxos para prever a fonte alvo a partir de uma gravação mixada. No Neural Analog Studio, você pode descrever a fonte em texto e marcar o intervalo em que ela aparece. Os prompts visuais fazem parte do modelo de pesquisa, em vez de serem um controle da interface de áudio atual do Studio. Para produtores, a diferença está no controle: o modelo pode buscar sons fora das categorias fixas de voz, bateria, baixo e outros.
O codificador de áudio neural: por que a arquitetura determina a qualidade
Toda ferramenta de separação com IA se baseia em um codificador de áudio neural. Ele transforma a forma de onda original em uma representação compacta de timbre, altura, ritmo e posição estéreo. Pense nele como os "ouvidos" do modelo: distinguir uma caixa de uma voz depende de como esse codificador foi treinado.
Modelos de separação antigos, como Spleeter, usavam codificadores CNN que tratavam espectrogramas como imagens 2D. Eles conseguiam separar voz e bateria de forma básica, mas tinham dificuldade com detalhes finos do timbre e consistência ao longo do tempo. O Demucs v4 (Hybrid Transformer Demucs) processa tanto a forma de onda quanto o espectrograma, o que ajuda a preservar transientes e fase para um som mais natural. O BS-RoFormer divide o espectrograma em bandas de frequência e as modela com camadas Transformer. Seu artigo relata SDR médio de 9,8 dB no benchmark MUSDB18-HQ, acima do Demucs v4. Nossa comparação entre Spleeter e Demucs aborda os modelos antigos em detalhe.
O SAM Audio vai além com seu Perception Encoder Audiovisual (PE-AV), treinado com mais de 100 milhões de clipes de vídeo. Como aprendeu com vídeo, ele relaciona os sons aos instrumentos e às ações que os produzem. Isso ajuda quando você usa um prompt como "guitar", principalmente quando a guitarra compartilha uma faixa de frequências com outros instrumentos.
Arquitetura de pesquisa do SAM Audio
dog barking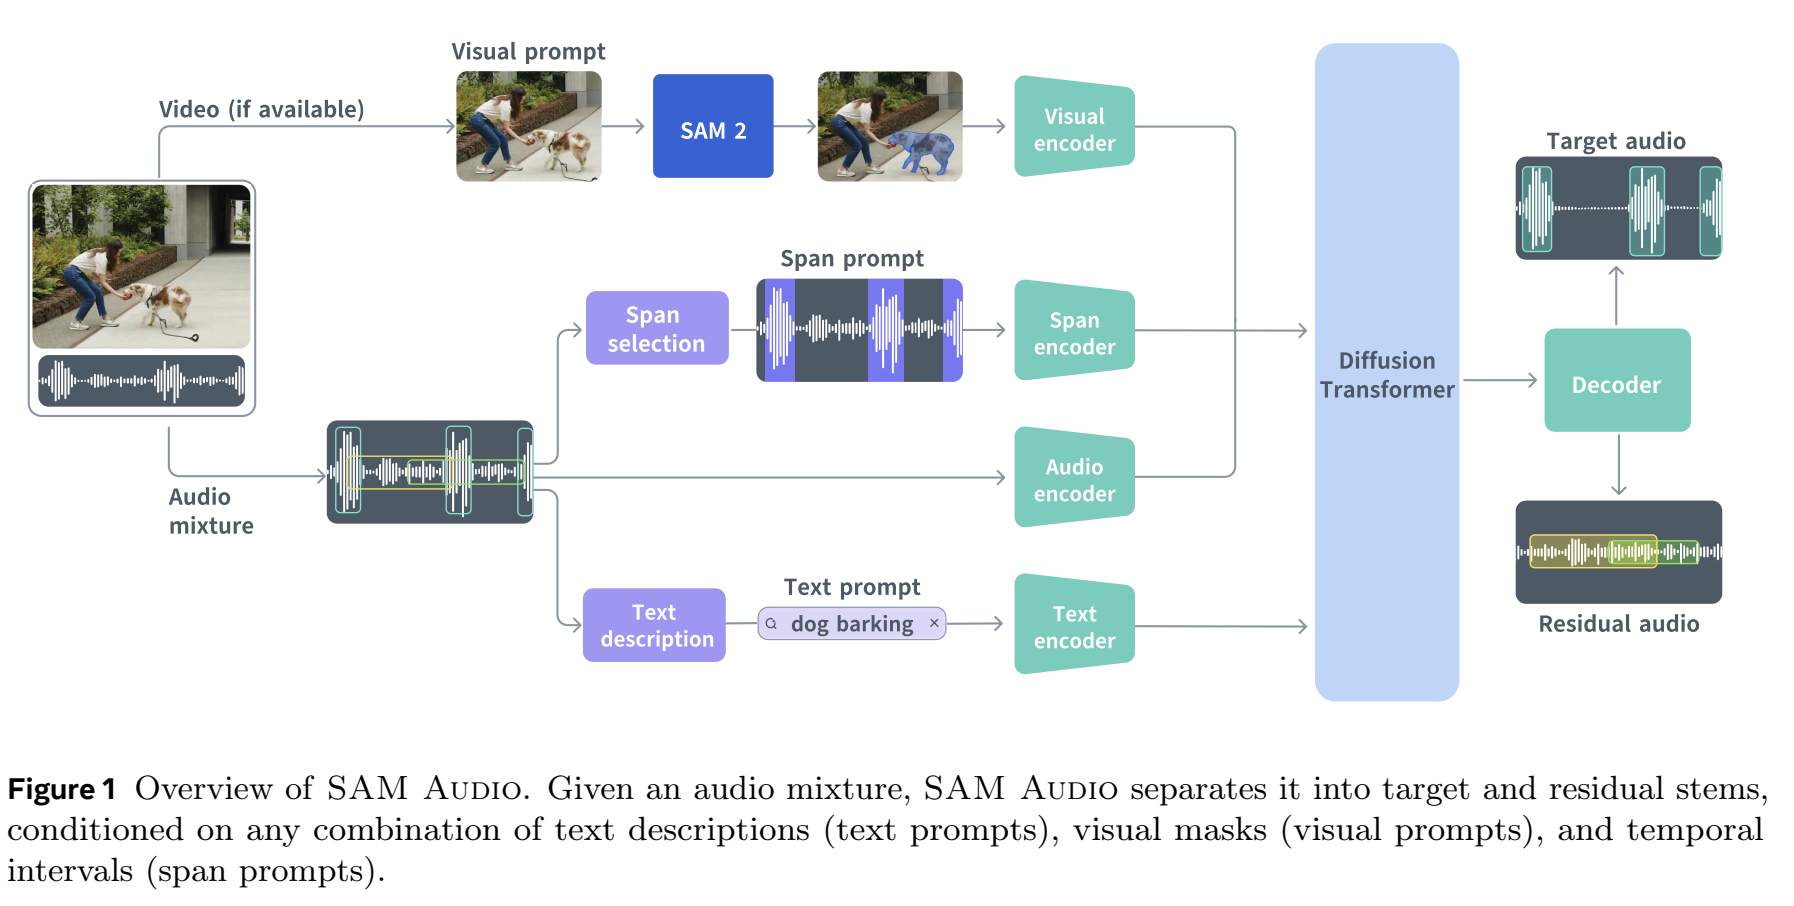
Figura original: Arquitetura de pesquisa do SAM Audio.
A qualidade do codificador afeta diretamente a qualidade dos stems de três formas:
- Resolução de timbre: codificadores melhores separam harmônicos do ruído, preservando o caráter dos instrumentos
- Coerência temporal: codificadores mais capazes mantêm a separação consistente ao longo do tempo, evitando os cortes rápidos comuns em ferramentas mais baratas
- Detalhe: codificadores maiores capturam ruídos das cordas, respirações e a ambiência da sala
Ao comparar serviços de separação, pergunte qual modelo eles usam, em vez de se basear no marketing. O pós-processamento não compensa por completo um codificador antigo.
Como o Neural Analog usa SAM Audio e BS-RoFormer
O separador de stems com IA do Neural Analog transforma SAM Audio e BS-RoFormer em uma ferramenta prática para músicos.
Diferente da demonstração de 30 segundos em mono, o Neural Analog processa faixas completas em estéreo, então os stems mantêm a largura e a profundidade da mixagem original.
Você pode escolher entre SAM Audio e presets testados de stems fixos:
- SAM Audio para extração de instrumentos personalizados, como saxofone, sintetizador e cordas
- Presets para separações rápidas e confiáveis: 4 stems, voz, bateria, baixo e outros, ou 6 stems, acrescentando guitarra e piano, com modelos BS-RoFormer, uma geração de separadores de stems fixos mais recente que o Demucs
Com o SAM Audio online, você pode escrever um prompt e marcar intervalos na forma de onda quando o som alvo aparece apenas em parte da faixa. Tem perguntas ou resultados para compartilhar? Entre no Discord do Neural Analog.
Pipeline integrado de restauração de áudio
Você pode aplicar restauração de áudio aos stems extraídos para ampliar sua faixa de frequências e reduzir alguns artefatos. Ouça o resultado: a restauração não corrige todos os erros de separação.
Melhores stems Suno: por que a música gerada com IA exige um tratamento especial
Suno e outros geradores de música com IA, incluindo Udio e FlowMusic / Producer.ai, costumam produzir arquivos comprimidos ou com largura de banda limitada. Isso impõe um teto de qualidade antes mesmo de separar os stems. Para separar uma música Suno diretamente pelo link, use o separador de stems Suno. O Udio não oferece mais downloads nem stems, então primeiro salve suas músicas Udio como arquivos de áudio.
O problema da dupla compressão
Separar um MP3 Suno com ferramentas básicas divide um áudio que já está comprometido. Os stems herdam:
- Perda severa de altas frequências, muitas vezes sem nada acima de 15 kHz
- Ruído de quantização incorporado ao sinal
- Largura e profundidade estéreo reduzidas
- Artefatos digitais de ressonância
Como a restauração melhora a música gerada com IA
O processo trata essas limitações passo a passo:
- Extração: SAM Audio ou um modelo predefinido separa os stems
- Remoção de artefatos: a restauração neural pode reduzir o ruído de compressão MP3
- Reconstrução de frequências: o modelo prevê e regenera conteúdo harmônico até 20 kHz
- Tratamento estéreo: preserva os sinais estéreo enquanto restaura o detalhe e depois compara de ouvido a largura e a fase com a fonte
Os stems Suno resultantes soam mais próximos de sessões multipista gravadas profissionalmente.
Passo a passo: como obter stems de qualidade com o Neural Analog
Siga estas etapas para obter resultados consistentes. O guia do Studio para separar stems explica cada controle com mais detalhes.
Passo 1: enviar áudio
Arraste e solte seu arquivo ou cole um link público de uma fonte compatível, como Suno, FlowMusic, TopMediaAI, Treblo, Mureka ou YouTube. Os formatos aceitos incluem MP3, WAV, FLAC, M4A e OGG. A duração máxima depende do seu plano e do modelo escolhido.
Passo 2: escolher a estratégia de separação
Para resultados previsíveis, abra Separação e escolha 4 stems para voz, bateria, baixo e outros, ou 6 stems para acrescentar guitarra e piano. Confira a Entrada selecionada. Esses presets executam modelos especializados de stems fixos e oferecem uma separação consistente.
Para instrumentos personalizados, escolha Prompt personalizado para usar o SAM Audio. Confira o Modelo selecionado e descreva o som. Seja específico: electric guitar solo with distortion funciona melhor do que guitar. O SAM Audio retorna dois stems complementares: o som que corresponde ao prompt e o restante da gravação.
Passo 3: configurar o processamento
Processamento estéreo do SAM Audio: o modo padrão Estéreo (centro/diferença) processa separadamente os sinais do centro e de diferença estéreo e depois os recombina. Escolha Estéreo (L/R) para processar os canais esquerdo e direito separadamente, ou Mono para fazer a média deles em um único canal. Esses controles se aplicam ao SAM Audio; os presets de stems fixos usam seus próprios modelos estéreo. Veja quando usar processamento Mid/Side.
Passo 4: processar e baixar
Deixe Melhorar stems desativado para fazer apenas a separação. Confira a estimativa de minutos de processamento descontados do seu saldo, clique em Iniciar extração e aguarde. Faixas curtas costumam terminar em poucos minutos; faixas mais longas e modelos mais pesados levam mais tempo. Ouça cada stem no Studio, abra Exportar e escolha Stems individuais para arquivos separados ou Stems combinados para a mixagem atual.
Passo 5: restaurar os stems extraídos
Se um stem tiver altas frequências ausentes ou danos de compressão audíveis, selecione-o como Entrada em Melhorar, escolha Restauração de música MP3 para instrumentos ou Melhoria do canto para vozes e clique em Iniciar o modelo. Compare o resultado antes de exportar. O guia de restauração de MP3 para WAV explica as opções de modelos. Para processar automaticamente os stems compatíveis após a extração, ative Melhorar stems, selecione o modelo de restauração e confira a estimativa de minutos de processamento adicionais antes de iniciar a extração. Stems limpos não precisam de restauração.
Considerações técnicas para a produção
Ao incluir a extração de stems no seu fluxo de produção, confira estes fatores:
Qualidade do arquivo fonte
A restauração pode reconstruir arquivos comprimidos, mas fontes sem perdas, como WAV ou FLAC, ainda oferecem separação mais precisa. O codificador tem mais informação original para trabalhar, então precisa reconstruir menos.
Se seu instrumento aparece por apenas alguns segundos em um arquivo longo, marque esse intervalo no Studio ou recorte o arquivo antes de enviar. O modelo recebe um alvo mais claro e o processamento fica mais rápido.
Coerência de fase dos stems
Os stems de uma mesma música devem, ao serem somados, recuperar aproximadamente a mixagem original. Se a fase se deslocar, recombiná-los causa filtragem em pente ou cancelamento. Os modelos do Neural Analog foram projetados para preservar as relações de fase, o que importa no mastering de stems e em remixes. Confira somando os stems na sua DAW e comparando com o original.
Audibilidade dos artefatos
Ouça os artefatos comuns de separação:
- Vazamento: instrumentos que aparecem baixinho no stem errado
- Cortes rápidos: o som liga e desliga rapidamente durante a extração
- Transientes borrados: perda de nitidez nos ataques
- Perda de altas frequências: falta de ar e detalhe
A restauração corrige muitos desses problemas, mas uma fonte limpa os reduz na etapa de extração. Depois, use uma DAW para manter apenas as partes de cada stem que soam bem.
Quando usar cada tipo de modelo
Use os presets de stems fixos (BS-RoFormer) quando:
- Você precisa isolar voz, bateria ou baixo padrão
- A velocidade de processamento é essencial
- A mixagem fonte está relativamente limpa
- Você quer resultados previsíveis e testados
Use SAM Audio personalizado quando:
- O instrumento não está coberto pelos presets padrão
- A mixagem é densa e os sons se sobrepõem
- Você precisa separar sons semelhantes, como guitarra solo e guitarra rítmica
- A fonte contém instrumentos incomuns ou sons sintetizados
Use restauração quando necessário:
- Uma fonte MP3 ou de streaming tem danos de compressão audíveis
- O arquivo original está abaixo de 320 kbps e faltam detalhes de alta frequência
- A música gerada com IA tem corte de largura de banda ou artefatos de compressão
- Os stems precisam de reparo antes de um lançamento comercial, após uma conferência de ouvido
Como escolher o melhor fluxo de separação de stems com IA
Comece com uma faixa de teste que você conheça bem. Compare os stems extraídos com a mixagem original para conferir a coerência de fase e o nível de artefatos. Use os presets para separações padrão, SAM Audio para o restante e restauração quando uma fonte comprimida ou gerada com IA precisar de reparo.
Com os modelos de IA e a restauração atuais, os stems extraídos podem se aproximar da sessão multipista original para remixes, samples e análise de mixagens.
Perguntas frequentes sobre separação de stems de qualidade
Qual é o melhor modelo de IA para separar stems?
Para voz, bateria, baixo e instrumentais, os modelos BS-RoFormer e Mel-Band RoFormer têm atualmente as melhores pontuações nos benchmarks públicos. Para instrumentos fora desses stems fixos, um modelo baseado em prompts como o SAM Audio é mais flexível. Veja nossos rankings dos melhores modelos para voz e dos melhores modelos para instrumentos.
O Neural Analog usa Demucs para stems?
Não. Os presets de 4 e 6 stems usam modelos BS-RoFormer, e a extração de instrumentos personalizados usa SAM Audio.
Por que meus stems soam finos ou como se estivessem debaixo d'água?
Normalmente porque a fonte é um MP3 de bitrate baixo ou porque a ferramenta usa um modelo antigo. Comece pela melhor fonte disponível, use um modelo mais recente e restaure os stems depois. Leia se melhorar MP3 corrige stems que soam abafados para saber o que a restauração pode e não pode corrigir.
Guias relacionados
- Remova a bateria de uma música Suno pronta: use a separação de bateria para obter uma faixa sem bateria.
- Substitua a bateria Suno pelo seu próprio kit: remova a bateria gerada com IA e programe um novo groove.
- Converta uma música estéreo para Dolby Atmos: coloque os stems separados em um bed e em objetos Atmos.