Hochwertige KI-Stem-Trennung: saubere Stems mit SAM Audio und BS-RoFormer extrahieren
Hochwertige KI-Stem-Trennung hängt von drei Dingen ab: dem passenden Modell für die Aufgabe, der Verarbeitung des gesamten Songs in Stereo und der Restaurierung der Quelle bei hörbaren Kompressionsschäden. Verwenden Sie ein spezialisiertes Modell für feste Stem-Kategorien wie BS-RoFormer für Gesang, Schlagzeug und Bass sowie Metas SAM Audio für andere Instrumente. Sie erhalten sauberere Stems als mit älteren Werkzeugen wie Spleeter oder frühen Demucs-Versionen.
Produzenten, DJs und Content-Ersteller stehen vor demselben Problem. Sie brauchen sauberen A-cappella-Gesang für einen Remix, einen Song ohne Schlagzeug zum Üben oder ein isoliertes Gitarrenriff zum Sampling. Ältere Trennwerkzeuge hinterlassen verwaschenen Gesang und geisterhafte Schlagzeugartefakte.
Dieser Leitfaden erklärt, was Stems sind, warum die meisten Trennwerkzeuge Artefakte erzeugen und wie Sie Stems für echte Produktionen erhalten, auch aus Suno-Songs.
Was sind Stems? Grundlagen der Audiotrennung
Stems sind einzelne Audiospuren, die aus einem gemischten Song extrahiert werden. Statt einer Stereodatei mit allen Elementen erhalten Sie separate Dateien für Gesang, Schlagzeug, Bass, Klavier und andere Instrumente. Jeder Stem enthält nur das jeweilige Element.
Es gibt trockene Stems ohne Effekte und Stems mit Effekten, etwa Hall und Kompression. Trockene Stems sind die Zutaten vor dem Kochen; Stems mit Effekten sind das fertige Gericht. Die Modelle in diesem Artikel extrahieren ausschließlich Stems mit Effekten. Jeder Stem behält also die Effekte, die er im Mix hatte.
Warum Stems für die heutige Musikproduktion wichtig sind
Stems machen aus einem starren Stereomix flexibel nutzbare Bestandteile. Mit hochwertigen Stems können Sie:
- Karaoke-Versionen durch Entfernen des Gesangs erstellen
- Mashups mit sauber isoliertem A-cappella-Gesang produzieren
- Remixe um den Originalgesang aufbauen, die Idee hinter Spotifys geplanter KI-Remix-Funktion
- Mixe durch Anpassen einzelner Instrumentenpegel neu ausbalancieren
- Songs lernen, indem Sie einzelne Teile solo hören
- Elemente ohne Übersprechen anderer Instrumente samplen
- Problematische Frequenzen in isolierten Spuren korrigieren
Vor KI beruhte die Stem-Trennung auf EQ-Filtern und Phasenauslöschung. Das erzeugte Artefakte und isolierte nie einen Part vollständig. KI-Modelle verbesserten dies, indem sie Klangfarbe und harmonische Struktur erkennen lernten, statt nur Frequenzen zu filtern.
Das Problem der meisten Dienste zur Stem-Trennung
KI-Trennwerkzeuge sind nicht alle gleich. Viele Dienste versprechen „hohe Qualität“, sparen aber bei den Grundlagen:
Demos und Produktionswerkzeuge
Metas SAM-Audio-Spielwiese verarbeitet nur 30-Sekunden-Clips in Mono. Das reicht für eine Demo, aber nicht für einen vollständigen Song in Stereo. Lesen Sie, wie sich Neural Analog von der SAM-Audio-Spielwiese unterscheidet.
Grenzen eines einzigen Modells
Viele Dienste verwenden nur ein Modell und müssen deshalb Kompromisse eingehen. Modelle für feste Stem-Kategorien wie Demucs oder BS-RoFormer eignen sich für vorgegebene Trennungen in Gesang, Schlagzeug, Bass und Rest, können aber keine frei gewählten Instrumente wie Saxofon oder Synthesizer extrahieren. Andere Modelle erlauben freie Extraktion, trennen die üblichen Stems aber weniger sauber als spezialisierte Werkzeuge.
Keine Pipeline zur Audiorestaurierung
Die Trennung komprimierter Quellen wie MP3 oder Streaming-Aufnahmen legt deren vorhandene Artefakte offen. MP3s mit niedriger Bitrate schneiden oft alles oberhalb von etwa 16 kHz ab und fügen Quantisierungsrauschen hinzu, das Transienten verwischt. Ein Trennwerkzeug, das dies ignoriert, isoliert das beschädigte Audio lediglich deutlicher.
Wie SAM Audio die Stem-Trennung verbessert
Metas SAM Audio ist ein allgemeines Modell zur Quellentrennung statt eines spezialisierten Gesangsentferners. Meta beschreibt es als einzelnes Modell, das Text-, visuelle und Zeitbereichs-Prompts akzeptiert, auf einem Transformer mit Flow Matching aufbaut und mit umfangreichen Audiomischungen aus Sprache, Musik und allgemeinen Geräuschen trainiert wurde.
Hören Sie den Unterschied: SAM Audio und führende Lösungen
Unten sehen Sie einen Vergleich aus der Praxis. Wir haben aus einem dichten klassischen Mix den Klavier-Stem isoliert, einmal mit SAM Audio in Neural Analog und einmal mit einem führenden Wettbewerber.
Beispiel: Vergleich der Klavierextraktion
Ein einzelnes Instrument mit dem Prompt 'piano' aus einem dichten Stereomix isolieren.
Die Technik hinter SAM Audio
SAM Audio verwendet einen Transformer mit Flow Matching, um die Zielquelle aus einer gemischten Aufnahme vorherzusagen. In Neural Analog Studio können Sie die Quelle als Text beschreiben und den Zeitbereich markieren, in dem sie vorkommt. Visuelle Prompts gehören zum Forschungsmodell und sind kein Bedienelement der aktuellen Audiooberfläche von Studio. Für Produzenten liegt der Unterschied in der Kontrolle: Das Modell kann Klänge außerhalb der festen Kategorien Gesang, Schlagzeug, Bass und Rest gezielt erfassen.
Der neuronale Audioencoder: warum die Architektur die Qualität bestimmt
Jedes KI-Trennwerkzeug basiert auf einem neuronalen Audioencoder. Er wandelt die rohe Wellenform in eine kompakte Darstellung von Klangfarbe, Tonhöhe, Rhythmus und Stereoposition um. Stellen Sie ihn sich als die „Ohren“ des Modells vor: Wie gut es eine Snare von Gesang unterscheiden kann, hängt davon ab, wie gut dieser Encoder trainiert wurde.
Frühe Trennmodelle wie Spleeter verwendeten CNN-Encoder, die Spektrogramme wie 2D-Bilder behandelten. Sie bewältigten einfache Gesangs- und Schlagzeugtrennungen, hatten aber Schwierigkeiten mit feinen Klangfarbendetails und zeitlicher Konsistenz. Demucs v4 (Hybrid Transformer Demucs) verarbeitet sowohl die Wellenform als auch das Spektrogramm. Das hilft, Transienten und Phase für einen natürlicheren Klang zu erhalten. BS-RoFormer teilt das Spektrogramm in Frequenzbänder und modelliert sie mit Transformer-Schichten. Der zugehörige Fachartikel berichtet einen durchschnittlichen SDR von 9,8 dB im MUSDB18-HQ-Benchmark, mehr als Demucs v4. Unser Vergleich zwischen Spleeter und Demucs behandelt die älteren Modelle ausführlich.
SAM Audio geht mit seinem Perception Encoder Audiovisual (PE-AV) weiter, der mit über 100 Millionen Videoclips trainiert wurde. Weil er aus Videos gelernt hat, verknüpft er Klänge mit den Instrumenten und Handlungen, die sie erzeugen. Das hilft bei einem Prompt wie „guitar“, besonders wenn die Gitarre einen Frequenzbereich mit anderen Instrumenten teilt.
Forschungsarchitektur von SAM Audio
dog barking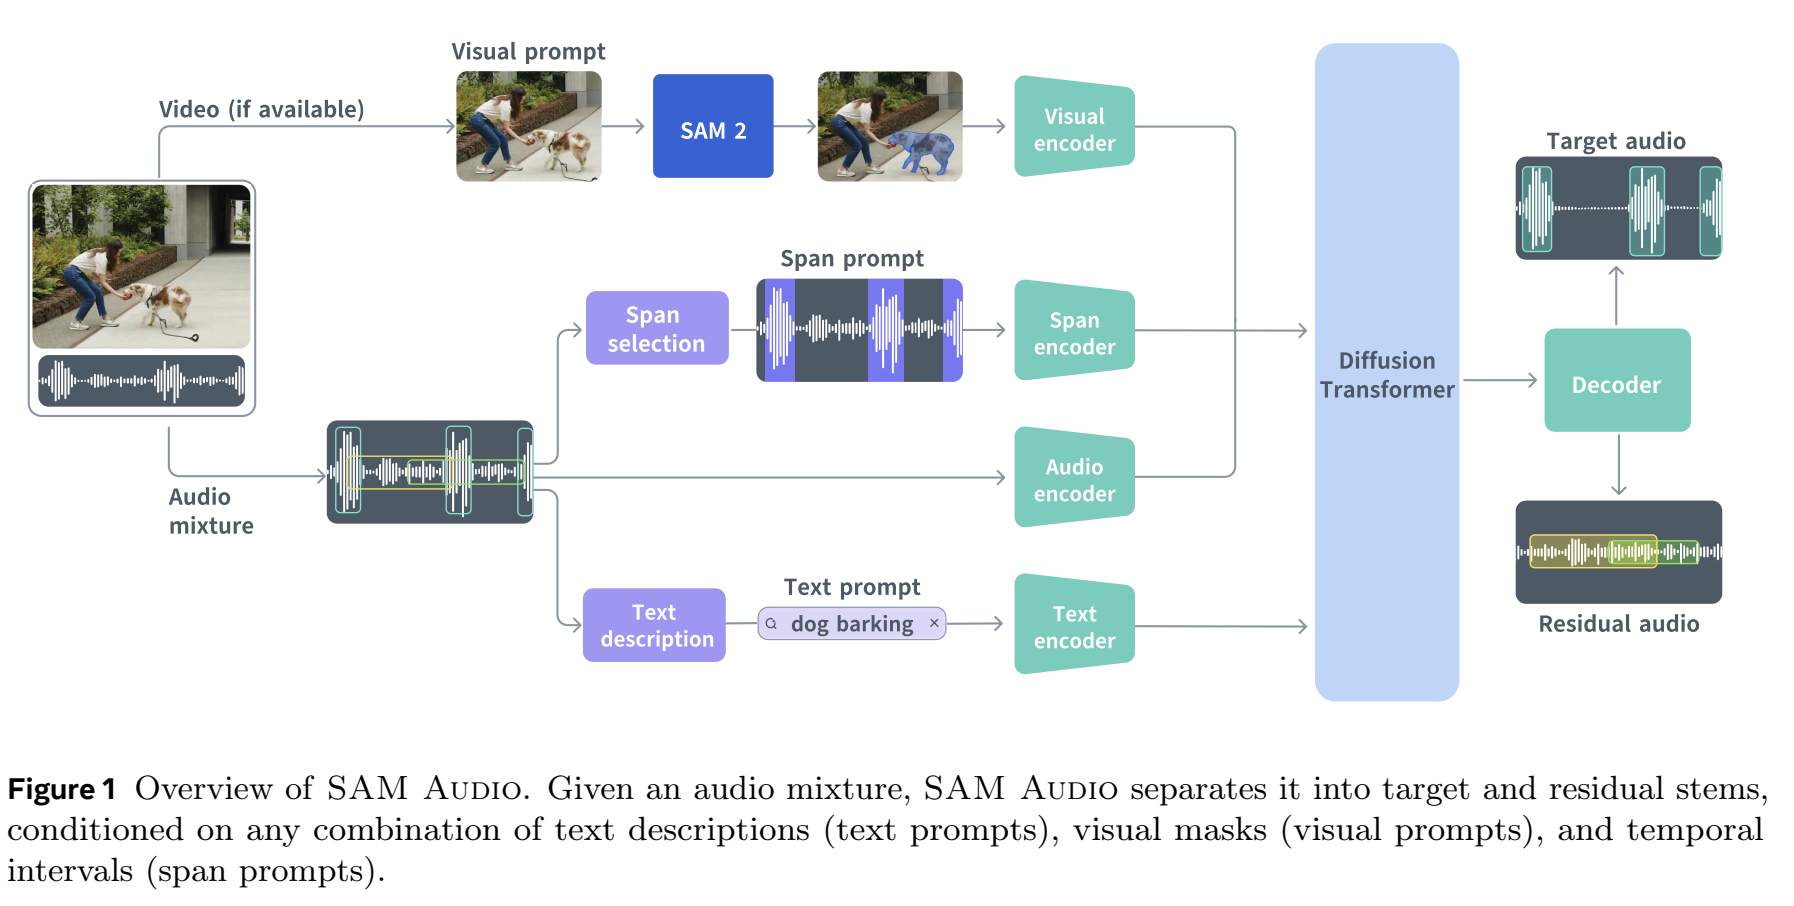
Originalabbildung: Forschungsarchitektur von SAM Audio.
Die Qualität des Encoders beeinflusst die Stem-Qualität auf drei Arten direkt:
- Klangfarbenauflösung: Bessere Encoder trennen Harmonische vom Rauschen, sodass Instrumente ihren Charakter behalten
- Zeitliche Kohärenz: Leistungsfähigere Encoder halten die Trennung über die Zeit konsistent und vermeiden schnelle Aussetzer, die bei günstigeren Werkzeugen häufig sind
- Details: Größere Encoder erfassen Saitenquietschen, Atemgeräusche und Raumatmosphäre
Wenn Sie Trennservices vergleichen, fragen Sie nach dem verwendeten Modell, statt sich auf das Marketing zu verlassen. Nachbearbeitung kann einen älteren Encoder nicht vollständig ausgleichen.
Wie Neural Analog SAM Audio und BS-RoFormer nutzt
Neural Analogs KI-Stem-Trenner macht SAM Audio und BS-RoFormer zu einem praktischen Werkzeug für Musiker.
Anders als die 30-Sekunden-Mono-Demo verarbeitet Neural Analog vollständige Songs in Stereo, sodass die Stems Breite und Tiefe des Originalmixes behalten.
Sie können zwischen SAM Audio und bewährten Presets für feste Stem-Kategorien wählen:
- SAM Audio für die Extraktion frei gewählter Instrumente wie Saxofon, Synthesizer und Streicher
- Presets für schnelle, zuverlässige Trennungen: 4 Stems mit Gesang, Schlagzeug, Bass und Rest oder 6 Stems mit zusätzlicher Gitarre und zusätzlichem Klavier, betrieben mit BS-RoFormer-Modellen, einer neueren Generation fester Stem-Trenner als Demucs
Mit SAM Audio online können Sie einen Prompt schreiben und Zeitbereiche in der Wellenform markieren, wenn der Zielklang nur in einem Teil des Songs vorkommt. Haben Sie Fragen oder Ergebnisse zu teilen? Treten Sie dem Discord von Neural Analog bei.
Integrierte Pipeline zur Audiorestaurierung
Sie können extrahierte Stems durch eine Audiorestaurierung verarbeiten, um ihren Frequenzbereich zu erweitern und einige Artefakte zu reduzieren. Hören Sie das Ergebnis an: Restaurierung behebt nicht jeden Trennfehler.
Bessere Suno-Stems: warum KI-Musik besondere Behandlung braucht
Suno und andere KI-Musikgeneratoren, darunter Udio und FlowMusic / Producer.ai, erzeugen häufig komprimierte Dateien oder Dateien mit begrenzter Bandbreite. Das setzt eine Qualitätsgrenze, bevor die Stem-Trennung überhaupt beginnt. Um einen Suno-Song direkt über seinen Link zu trennen, verwenden Sie den Suno-Stem-Trenner. Udio bietet keine Downloads oder Stems mehr an. Speichern Sie Ihre Udio-Songs deshalb zuerst als Audiodateien.
Das Problem der doppelten Kompression
Wer eine Suno-MP3 mit einfachen Werkzeugen trennt, verarbeitet bereits beeinträchtigtes Audio. Die Stems übernehmen:
- Starken Verlust hoher Frequenzen, oft ohne Inhalte oberhalb von 15 kHz
- Im Signal enthaltenes Quantisierungsrauschen
- Verringerte Stereobreite und Tiefe
- Digitale Nachschwingartefakte
Wie Restaurierung KI-Musik verbessert
Das Verfahren geht diese Grenzen Schritt für Schritt an:
- Extraktion: SAM Audio oder ein Preset-Modell trennt die Stems
- Artefaktentfernung: Neuronale Restaurierung kann MP3-Kompressionsrauschen reduzieren
- Frequenzrekonstruktion: Das Modell sagt harmonische Inhalte voraus und regeneriert sie bis 20 kHz
- Stereoverarbeitung: Stereosignale bleiben erhalten, während Details restauriert werden; anschließend werden Breite und Phase mit der Quelle nach Gehör verglichen
Die resultierenden Suno-Stems klingen näher an professionell aufgenommenen Mehrspur-Sessions.
Schritt für Schritt: hochwertige Stems mit Neural Analog erhalten
Befolgen Sie diese Schritte für konsistente Ergebnisse. Der Studio-Leitfaden zur Stem-Trennung erklärt jedes Bedienelement genauer.
Schritt 1: Audio hochladen
Ziehen Sie Ihre Datei hinein oder fügen Sie einen öffentlichen Link aus einer unterstützten Quelle wie Suno, FlowMusic, TopMediaAI, Treblo, Mureka oder YouTube ein. Unterstützte Uploadformate sind MP3, WAV, FLAC, M4A und OGG. Die maximale Dauer hängt von Ihrem Tarif und dem ausgewählten Modell ab.
Schritt 2: Trennstrategie wählen
Für vorhersehbare Ergebnisse öffnen Sie Trennen und wählen 4 Stems für Gesang, Schlagzeug, Bass und Rest oder 6 Stems für zusätzliche Gitarre und zusätzliches Klavier. Prüfen Sie den ausgewählten Eingang. Diese Presets führen spezialisierte Modelle für feste Stem-Kategorien aus und liefern eine konsistente Trennung.
Für frei gewählte Instrumente wählen Sie Eigener Prompt, um SAM Audio zu nutzen. Prüfen Sie das ausgewählte Modell und beschreiben Sie anschließend den Klang. Seien Sie präzise: electric guitar solo with distortion funktioniert besser als guitar. SAM Audio liefert zwei komplementäre Stems: den zum Prompt passenden Klang und den Rest der Aufnahme.
Schritt 3: Verarbeitung konfigurieren
SAM-Audio-Stereoverarbeitung: Der Standardmodus Stereo (Mitte/Differenz) verarbeitet das Mittensignal und das Stereo-Differenzsignal getrennt und setzt sie anschließend wieder zusammen. Wählen Sie Stereo (L/R), um linken und rechten Kanal getrennt zu verarbeiten, oder Mono, um sie zu einem Kanal zu mitteln. Diese Bedienelemente gelten für SAM Audio; die Presets für feste Stems verwenden eigene Stereomodelle. Lesen Sie, wann Mid/Side-Verarbeitung sinnvoll ist.
Schritt 4: Verarbeiten und herunterladen
Lassen Sie Stems verbessern für reine Trennung ausgeschaltet. Prüfen Sie die geschätzten Verarbeitungsminuten, die von Ihrem Guthaben abgezogen werden, klicken Sie dann auf Extraktion starten und warten Sie. Kurze Songs sind häufig nach wenigen Minuten fertig; längere Songs und aufwendigere Modelle benötigen mehr Zeit. Hören Sie jeden Stem in Studio an, öffnen Sie dann Exportieren und wählen Sie Einzelne Stems für separate Dateien oder Kombinierte Stems für den aktuellen Mix.
Schritt 5: Extrahierte Stems restaurieren
Wenn einem Stem hohe Frequenzen fehlen oder Kompressionsschäden hörbar sind, wählen Sie ihn unter Verbessern als Eingang, wählen MP3-Musikrestaurierung für Instrumente oder MP3-Gesangsrestaurierung für Gesang und klicken auf Modell starten. Vergleichen Sie das Ergebnis vor dem Export. Der Leitfaden zur MP3-zu-WAV-Restaurierung erklärt die Modellwahl. Wenn geeignete Stems stattdessen automatisch nach der Extraktion verarbeitet werden sollen, aktivieren Sie Stems verbessern, wählen das Restaurierungsmodell und prüfen die zusätzlichen geschätzten Verarbeitungsminuten, bevor Sie die Extraktion starten. Saubere Stems brauchen keine Restaurierung.
Technische Aspekte für Produktionsabläufe
Wenn Sie Stem-Extraktion in Ihren Produktionsablauf einbauen, prüfen Sie diese Faktoren:
Qualität der Quelldatei
Restaurierung kann komprimierte Dateien rekonstruieren. Verlustfreie Quellen wie WAV oder FLAC liefern aber weiterhin eine genauere Trennung. Der Encoder hat mehr Originalinformationen zur Verfügung, sodass weniger rekonstruiert werden muss.
Wenn Ihr Instrument in einer langen Datei nur wenige Sekunden vorkommt, markieren Sie diesen Bereich in Studio oder kürzen Sie die Datei vor dem Hochladen. Das Modell erhält eine klarere Zielquelle, und die Verarbeitung wird schneller.
Phasenkohärenz der Stems
Stems aus demselben Song sollten zusammengemischt ungefähr den Originalmix ergeben. Wenn sich ihre Phase verschiebt, entstehen beim Zusammenfügen Kammfiltereffekte oder Auslöschungen. Neural Analogs Modelle sind darauf ausgelegt, Phasenbeziehungen zu erhalten. Das ist für Stem-Mastering und Remixe wichtig. Prüfen Sie dies, indem Sie die Stems in Ihrer DAW summieren und mit dem Original vergleichen.
Hörbarkeit von Artefakten
Achten Sie auf häufige Trennartefakte:
- Übersprechen: Instrumente sind leise im falschen Stem zu hören
- Schnelle Aussetzer: Rasches Ein- und Ausschalten während der Extraktion
- Verwischte Transienten: Verlust klarer Anschläge
- Verlust hoher Frequenzen: Fehlende Luftigkeit und Details
Restaurierung behebt viele dieser Probleme, doch eine saubere Quelle reduziert sie bereits bei der Extraktion. Behalten Sie anschließend in einer DAW nur die Teile jedes Stems, die richtig klingen.
Wann Sie welchen Modelltyp verwenden sollten
Verwenden Sie Presets für feste Stems (BS-RoFormer), wenn:
- Sie Gesang, Schlagzeug oder Bass auf übliche Weise isolieren möchten
- Die Verarbeitungsgeschwindigkeit entscheidend ist
- Der Quellmix relativ sauber ist
- Sie vorhersehbare, erprobte Ergebnisse möchten
Verwenden Sie SAM Audio mit eigenem Prompt, wenn:
- Standard-Presets das Instrument nicht abdecken
- Der Mix dicht ist und sich Klänge überlagern
- Sie ähnliche Klänge trennen müssen, etwa Lead- und Rhythmusgitarre
- Die Quelle ungewöhnliche Instrumente oder synthetisierte Klänge enthält
Verwenden Sie Restaurierung bei Bedarf, wenn:
- Eine MP3- oder Streaming-Quelle hörbare Kompressionsschäden hat
- Die Originaldatei unter 320 kbps liegt und Details in den hohen Frequenzen fehlen
- KI-Musik eine Bandbreitenbegrenzung oder Kompressionsartefakte aufweist
- Stems nach Prüfung durch Anhören vor einer kommerziellen Veröffentlichung repariert werden müssen
Den besten Ablauf zur KI-Stem-Trennung wählen
Beginnen Sie mit einem Testsong, den Sie gut kennen. Vergleichen Sie die extrahierten Stems mit dem Originalmix, um Phasenkohärenz und Artefaktstärke zu prüfen. Nutzen Sie die Presets für Standardtrennungen, SAM Audio für alles andere und Restaurierung, wenn eine komprimierte oder KI-generierte Quelle repariert werden muss.
Mit heutigen KI-Modellen und Restaurierung können extrahierte Stems für Remixe, Samples und Mixanalysen nahe an die ursprüngliche Mehrspur-Session herankommen.
FAQ zur hochwertigen Stem-Trennung
Welches KI-Modell ist am besten für Stem-Trennung?
Für Gesang, Schlagzeug, Bass und Instrumentals erzielen die Modelle BS-RoFormer und Mel-Band RoFormer derzeit die höchsten Werte auf öffentlichen Benchmarks. Für Instrumente außerhalb dieser festen Stems ist ein Prompt-basiertes Modell wie SAM Audio flexibler. Sehen Sie unsere Ranglisten der besten Modelle für Gesang und der besten Modelle für Instrumente.
Verwendet Neural Analog Demucs für Stems?
Nein. Die Presets für 4 und 6 Stems verwenden BS-RoFormer-Modelle, und frei gewählte Instrumente werden mit SAM Audio extrahiert.
Warum klingen meine Stems dünn oder wie unter Wasser?
Meist liegt es an einer MP3-Quelle mit niedriger Bitrate oder daran, dass das Werkzeug ein älteres Modell verwendet. Beginnen Sie mit der besten verfügbaren Quelle, verwenden Sie ein neueres Modell und restaurieren Sie die Stems anschließend. Lesen Sie, ob MP3-Aufwertung dumpf klingende Stems verbessert, um zu erfahren, was Restaurierung beheben kann und was nicht.
Weitere Leitfäden
- Schlagzeug aus einem fertigen Suno-Song entfernen: Nutzen Sie eine Schlagzeugtrennung, um einen Song ohne Schlagzeug zu erhalten.
- Suno-Schlagzeug durch Ihr eigenes Kit ersetzen: Entfernen Sie die KI-Drums und programmieren Sie einen neuen Groove.
- Einen Stereosong in Dolby Atmos umwandeln: Platzieren Sie getrennte Stems in einem Atmos-Bed und in Objekten.