Séparation audio de qualité par IA : extraire des pistes propres avec SAM Audio et BS-RoFormer
Une séparation audio de qualité par IA repose sur trois éléments : le bon modèle pour le travail demandé, le traitement stéréo du morceau entier et la restauration de la source lorsqu'elle présente des dégâts de compression. Utilisez un modèle spécialisé à catégories fixes, comme BS-RoFormer, pour la voix, la batterie et la basse, et SAM Audio de Meta pour les autres instruments. Vous obtenez des pistes plus propres qu'avec les anciens outils de séparation tels que Spleeter ou les premières versions de Demucs.
Producteurs, DJ et créateurs de contenu rencontrent le même problème. Il vous faut une voix a cappella propre pour un remix, un morceau sans batterie pour vous entraîner ou un riff de guitare isolé pour créer un sample. Les anciens outils de séparation laissent des voix brouillonnes et des artefacts de batterie fantomatiques.
Ce guide explique ce que sont les pistes séparées, pourquoi la plupart des outils de séparation introduisent des artefacts et comment obtenir des pistes utilisables dans de vraies productions, y compris à partir de chansons Suno.
Que sont les pistes séparées ? Les bases de la séparation audio
Les pistes séparées, ou stems, sont des pistes audio individuelles extraites d'un morceau mixé. Au lieu d'un seul fichier stéréo contenant tous les éléments, vous obtenez des fichiers distincts pour la voix, la batterie, la basse, le piano et les autres instruments. Chaque piste ne contient que cet élément.
Il existe des pistes sèches sans effets et des pistes avec effets comme la réverbération et la compression. Les pistes sèches sont les ingrédients avant la cuisson ; les pistes avec effets sont le plat terminé. Les modèles présentés ici n'extraient que des pistes avec effets : chaque piste conserve donc les effets qu'elle avait dans le mix.
Pourquoi les pistes séparées comptent dans la production musicale actuelle
Les pistes séparées transforment un mix stéréo figé en éléments modulables. Avec des pistes de qualité, vous pouvez :
- Créer des versions karaoké en supprimant la voix
- Produire des mashups avec des voix a cappella bien isolées
- Construire des remixes autour de la voix originale, le principe de la fonction de remix par IA prévue par Spotify
- Rééquilibrer les mix en ajustant le niveau de chaque instrument
- Apprendre des morceaux en écoutant certaines parties en solo
- Échantillonner des éléments sans les fuites des autres instruments
- Corriger des fréquences problématiques dans des pistes isolées
Avant l'IA, la séparation reposait sur le filtrage par égalisation et l'annulation de phase, qui créaient des artefacts sans jamais isoler complètement une partie. Les modèles d'IA ont amélioré cela en apprenant à reconnaître le timbre et la structure harmonique au lieu de filtrer uniquement les fréquences.
Le problème de la plupart des services de séparation audio
Tous les outils de séparation par IA ne se valent pas. Beaucoup promettent une « haute qualité » tout en négligeant les fondamentaux :
Démonstrations et outils de production
L'espace de démonstration SAM Audio de Meta ne traite que des extraits de 30 secondes en mono. Cela convient à une démo, mais pas à un morceau entier en stéréo. Voyez ce qui distingue Neural Analog de l'espace de démonstration SAM Audio.
Les limites d'un seul modèle
Beaucoup de services utilisent un modèle unique, ce qui impose des compromis. Les modèles à catégories fixes, comme Demucs ou BS-RoFormer, réussissent les séparations prédéfinies : voix, batterie, basse et reste. Ils ne peuvent toutefois pas extraire un instrument personnalisé comme un saxophone ou un synthétiseur. D'autres modèles proposent cette extraction personnalisée, mais séparent les pistes courantes moins proprement que des outils spécialisés.
Aucun pipeline de restauration audio
Séparer des sources compressées comme des MP3 ou des enregistrements issus du streaming révèle leurs artefacts existants. Les MP3 à faible débit coupent souvent tout ce qui dépasse environ 16 kHz et ajoutent du bruit de quantification qui brouille les transitoires. Un outil de séparation qui ignore cela ne fait qu'isoler plus nettement un son endommagé.
Comment SAM Audio fait progresser la séparation audio
SAM Audio de Meta est un modèle général de séparation des sources plutôt qu'un outil spécialisé dans la suppression de la voix. Meta le présente comme un modèle unique qui accepte des consignes textuelles, visuelles et temporelles, construit sur un transformeur à appariement de flux et entraîné sur des mélanges audio à grande échelle couvrant la parole, la musique et les sons courants.
Écoutez la différence : SAM Audio face aux références du secteur
Voici une comparaison en conditions réelles. Nous avons pris un mix classique dense et isolé la piste de piano avec SAM Audio dans Neural Analog et avec un concurrent majeur.
Exemple : comparaison de l'extraction du piano
Isoler un seul instrument dans un mix stéréo dense avec la consigne 'piano'.
La technologie derrière SAM Audio
SAM Audio utilise un transformeur à appariement de flux pour prédire la source cible à partir d'un enregistrement mixé. Dans Neural Analog Studio, vous pouvez décrire la source par écrit et marquer l'intervalle où elle apparaît. Les consignes visuelles font partie du modèle de recherche ; elles ne sont pas une commande de l'interface audio actuelle de Studio. Pour les producteurs, la différence tient au contrôle : le modèle peut cibler des sons en dehors des catégories fixes de voix, batterie, basse et reste.
L'encodeur audio neuronal : pourquoi l'architecture du modèle détermine la qualité
Chaque outil de séparation par IA repose sur un encodeur audio neuronal. Il transforme la forme d'onde brute en une représentation compacte du timbre, de la hauteur, du rythme et du placement stéréo. Voyez-le comme les « oreilles » du modèle : sa capacité à distinguer une caisse claire d'une voix dépend de la qualité de l'entraînement de cet encodeur.
Les premiers modèles de séparation, comme Spleeter, utilisaient des encodeurs CNN qui traitaient les spectrogrammes comme des images 2D. Ils réussissaient les séparations simples de voix et de batterie, mais peinaient à conserver les détails fins du timbre et la cohérence dans le temps. Demucs v4 (Hybrid Transformer Demucs) traite à la fois la forme d'onde et le spectrogramme, ce qui l'aide à préserver les transitoires et la phase pour un son plus naturel. BS-RoFormer découpe le spectrogramme en bandes de fréquences et les modélise avec des couches Transformer. Son article rapporte un SDR moyen de 9,8 dB sur le benchmark MUSDB18-HQ, supérieur à celui de Demucs v4. Notre comparaison de Spleeter et Demucs détaille les anciens modèles.
SAM Audio va plus loin avec son Perception Encoder Audiovisual (PE-AV), entraîné sur plus de 100 millions de clips vidéo. Comme il a appris à partir de vidéos, il associe les sons aux instruments et aux actions qui les produisent. Cela aide lorsque vous donnez une consigne comme « guitar », surtout si la guitare partage une plage de fréquences avec d'autres instruments.
Architecture de recherche de SAM Audio
dog barking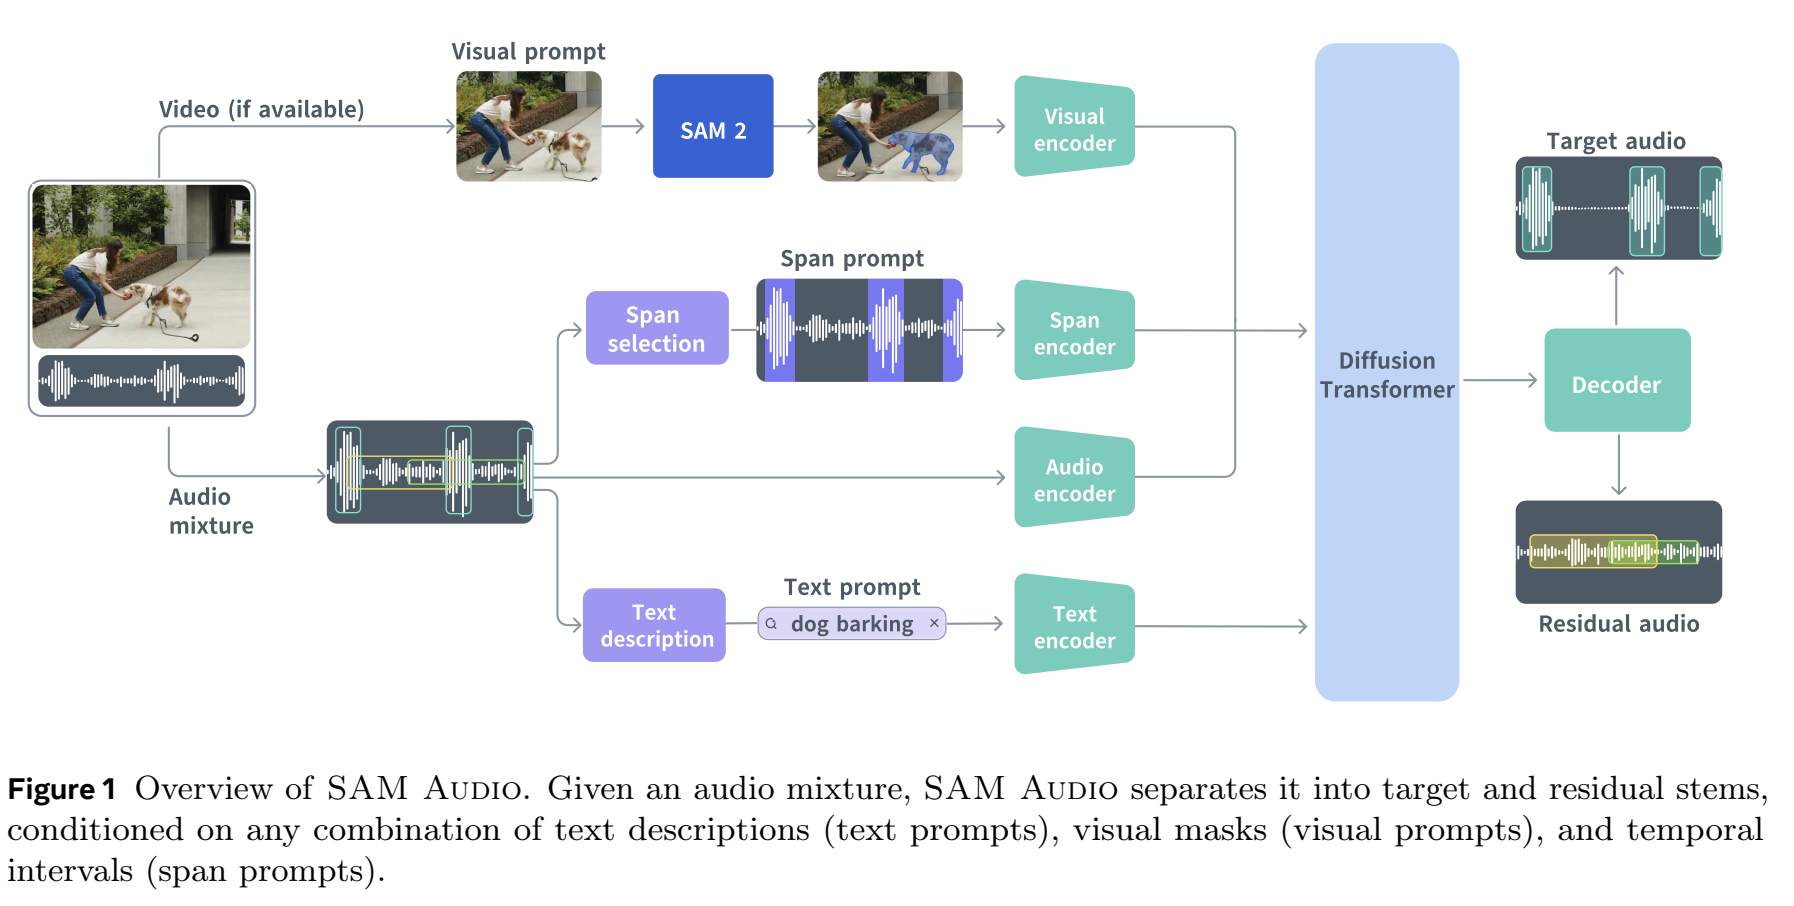
Figure originale: Architecture de recherche de SAM Audio.
La qualité de l'encodeur influe directement sur celle des pistes de trois façons :
- Résolution du timbre : de meilleurs encodeurs séparent les harmoniques du bruit et préservent ainsi le caractère des instruments
- Cohérence temporelle : des encodeurs plus performants maintiennent la séparation dans le temps et évitent les artefacts de coupures rapides fréquents dans les outils moins chers
- Détail : les encodeurs plus grands capturent les grincements des cordes, les respirations et l'ambiance de la pièce
Lorsque vous comparez les services de séparation, demandez quel modèle ils utilisent plutôt que de vous fier au marketing. Le post-traitement ne peut pas compenser entièrement un ancien encodeur.
Comment Neural Analog utilise SAM Audio et BS-RoFormer
Le séparateur de pistes par IA de Neural Analog fait de SAM Audio et BS-RoFormer un outil pratique pour les musiciens.
Contrairement à la démo mono de 30 secondes, Neural Analog traite des morceaux entiers en stéréo complète : les pistes conservent ainsi la largeur et la profondeur du mix original.
Vous pouvez choisir SAM Audio ou des préréglages éprouvés à catégories fixes :
- SAM Audio pour l'extraction d'instruments personnalisés : saxophone, synthétiseur, cordes
- Préréglages pour des séparations rapides et fiables : 4 pistes, voix, batterie, basse et reste, ou 6 pistes avec la guitare et le piano en plus, grâce à des modèles BS-RoFormer, une génération de séparateurs à catégories fixes plus récente que Demucs
Avec SAM Audio en ligne, vous pouvez écrire une consigne et marquer des intervalles sur la forme d'onde lorsque le son cible n'apparaît que dans une partie du morceau. Des questions ou des résultats à partager ? Rejoignez le Discord de Neural Analog.
Un pipeline de restauration audio intégré
Vous pouvez appliquer une restauration audio aux pistes extraites pour étendre leur plage de fréquences et nettoyer certains artefacts. Écoutez le résultat : la restauration ne corrige pas toutes les erreurs de séparation.
De meilleures pistes Suno : pourquoi la musique générée par IA demande un traitement particulier
Suno et d'autres générateurs de musique par IA, dont Udio et FlowMusic / Producer.ai, produisent souvent des fichiers compressés ou limités en bande passante. Cela fixe un plafond de qualité avant même la séparation. Pour séparer une chanson Suno directement depuis son lien, utilisez le séparateur de pistes Suno. Udio ne propose plus de téléchargements ni de pistes séparées : commencez donc par enregistrer vos chansons Udio sous forme de fichiers audio.
Le problème de la double compression
Séparer un MP3 Suno avec des outils simples revient à traiter un son déjà altéré. Les pistes héritent de :
- Fortes pertes de hautes fréquences, souvent sans rien au-dessus de 15 kHz
- Bruit de quantification intégré au signal
- Largeur et profondeur stéréo réduites
- Artefacts numériques de résonance
Comment la restauration améliore la musique générée par IA
Le processus traite ces limites étape par étape :
- Extraction : SAM Audio ou un modèle prédéfini sépare les pistes
- Suppression des artefacts : la restauration neuronale peut réduire le bruit de compression MP3
- Reconstruction des fréquences : le modèle prédit et régénère le contenu harmonique jusqu'à 20 kHz
- Traitement stéréo : préserver les signaux stéréo tout en restaurant les détails, puis comparer à l'écoute la largeur et la phase avec la source
Les pistes Suno obtenues se rapprochent du son de sessions multipistes enregistrées professionnellement.
Pas à pas : obtenir des pistes séparées de qualité avec Neural Analog
Suivez ces étapes pour des résultats réguliers. Le guide Studio de séparation des pistes détaille chaque commande.
Étape 1 : importer l'audio
Glissez-déposez votre fichier ou collez un lien public provenant d'une source prise en charge, comme Suno, FlowMusic, TopMediaAI, Treblo, Mureka ou YouTube. Les formats acceptés à l'importation comprennent MP3, WAV, FLAC, M4A et OGG. La durée maximale dépend de votre abonnement et du modèle choisi.
Étape 2 : choisir une stratégie de séparation
Pour des résultats prévisibles, ouvrez Séparation et choisissez 4 pistes pour la voix, la batterie, la basse et le reste, ou 6 pistes pour ajouter la guitare et le piano. Vérifiez l'Entrée sélectionnée. Ces préréglages exécutent des modèles spécialisés à catégories fixes et donnent une séparation régulière.
Pour des instruments personnalisés, choisissez Prompt personnalisé pour utiliser SAM Audio. Vérifiez le Modèle sélectionné, puis décrivez le son. Soyez précis : electric guitar solo with distortion fonctionne mieux que guitar. SAM Audio renvoie deux pistes complémentaires : le son correspondant à la consigne et le reste de l'enregistrement.
Étape 3 : configurer le traitement
Traitement stéréo de SAM Audio : le mode par défaut Stéréo (centre/différence) traite séparément le signal central et le signal de différence stéréo, puis les recombine. Choisissez Stéréo (L/R) pour traiter séparément les canaux gauche et droit, ou Mono pour en faire la moyenne dans un seul canal. Ces commandes s'appliquent à SAM Audio ; les préréglages à catégories fixes utilisent leurs propres modèles stéréo. Voyez quand utiliser le traitement Mid/Side.
Étape 4 : traiter et télécharger
Laissez Améliorer les pistes désactivé pour effectuer uniquement la séparation. Consultez l'estimation des minutes de traitement déduites de votre solde, puis cliquez sur Lancer l'extraction et patientez. Les morceaux courts sont souvent terminés en quelques minutes ; les morceaux plus longs et les modèles plus lourds prennent davantage de temps. Écoutez chaque piste dans Studio, puis ouvrez Exporter et choisissez Pistes individuelles pour des fichiers séparés ou Pistes combinées pour le mix actuel.
Étape 5 : restaurer les pistes extraites
Si une piste manque de hautes fréquences ou présente des dégâts de compression audibles, sélectionnez-la comme Entrée sous Améliorer, choisissez Réparation de musique MP3 pour les instruments ou Amélioration du chant pour les voix, puis cliquez sur Lancer le modèle. Comparez le résultat avant d'exporter. Le guide de restauration MP3 vers WAV explique les choix de modèles. Pour traiter automatiquement les pistes compatibles après leur extraction, activez plutôt Améliorer les pistes, sélectionnez le modèle de restauration et consultez l'estimation des minutes de traitement supplémentaires avant de lancer l'extraction. Les pistes propres n'ont pas besoin de restauration.
Points techniques à considérer dans les workflows de production
Lorsque vous intégrez l'extraction de pistes à votre workflow de production, vérifiez ces points :
Qualité du fichier source
La restauration peut reconstruire des fichiers compressés, mais les sources sans perte, WAV ou FLAC, donnent toujours une séparation plus précise. L'encodeur dispose de davantage d'informations d'origine, ce qui limite ce qu'il doit reconstruire.
Si votre instrument n'apparaît que quelques secondes dans un fichier long, marquez cet intervalle dans Studio ou découpez le fichier avant de l'importer. La cible est plus claire pour le modèle et le traitement est plus rapide.
Cohérence de phase des pistes
Les pistes d'un même morceau devraient, une fois additionnées, retrouver à peu près le mix original. Si leur phase dérive, les recombiner crée un filtrage en peigne ou des annulations. Les modèles de Neural Analog sont conçus pour préserver les relations de phase, ce qui compte pour le mastering et le remix des pistes. Vérifiez-le en additionnant les pistes dans votre DAW et en les comparant à l'original.
Audibilité des artefacts
Écoutez les artefacts courants de séparation :
- Fuites : des instruments s'entendent faiblement dans la mauvaise piste
- Coupures rapides : le son s'active et se coupe rapidement pendant l'extraction
- Transitoires brouillées : les attaques perdent leur netteté
- Perte de hautes fréquences : il manque de l'air et des détails
La restauration corrige beaucoup de ces défauts, mais une source propre les réduit dès l'extraction. Utilisez ensuite un DAW pour ne garder que les parties de chaque piste qui sonnent bien.
Quand utiliser chaque type de modèle
Utilisez les préréglages à catégories fixes (BS-RoFormer) lorsque :
- Vous voulez isoler les éléments courants : voix, batterie ou basse
- La vitesse de traitement est essentielle
- Le mix source est relativement propre
- Vous voulez des résultats prévisibles et éprouvés
Utilisez SAM Audio avec une consigne personnalisée lorsque :
- L'instrument n'est pas couvert par les préréglages courants
- Le mix est dense et les sons se chevauchent
- Vous devez séparer des sons proches, par exemple une guitare solo et une guitare rythmique
- La source contient des instruments inhabituels ou des sons synthétisés
Utilisez la restauration lorsque c'est nécessaire :
- Une source MP3 ou issue du streaming présente des dégâts de compression audibles
- Le débit du fichier d'origine est inférieur à 320 kbps et des détails manquent dans les hautes fréquences
- La musique générée par IA présente une coupure de bande passante ou des artefacts de compression
- Les pistes nécessitent des réparations avant une sortie commerciale, après vérification à l'écoute
Choisir le meilleur workflow de séparation audio par IA
Commencez avec un morceau de test que vous connaissez bien. Comparez les pistes extraites au mix original pour vérifier la cohérence de phase et le niveau des artefacts. Utilisez les préréglages pour les séparations courantes, SAM Audio pour le reste et la restauration lorsqu'une source compressée ou générée par IA doit être réparée.
Avec les modèles d'IA et la restauration actuels, les pistes extraites peuvent se rapprocher de la session multipiste d'origine pour les remixes, les samples et l'analyse du mix.
FAQ sur la séparation audio de qualité
Quel est le meilleur modèle d'IA pour séparer les pistes ?
Pour la voix, la batterie, la basse et les instrumentaux, les modèles BS-RoFormer et Mel-Band RoFormer obtiennent actuellement les meilleurs résultats sur les benchmarks publics. Pour les instruments hors de ces catégories fixes, un modèle à consignes comme SAM Audio est plus flexible. Consultez nos classements des meilleurs modèles pour la voix et des meilleurs modèles pour les instruments.
Neural Analog utilise-t-il Demucs pour les pistes ?
Non. Les préréglages à 4 pistes et à 6 pistes utilisent des modèles BS-RoFormer, tandis que l'extraction d'instruments personnalisés utilise SAM Audio.
Pourquoi mes pistes sonnent-elles fines ou comme sous l'eau ?
Cela vient généralement d'une source MP3 à faible débit ou d'un outil qui utilise un ancien modèle. Partez de la meilleure source disponible, utilisez un modèle plus récent et restaurez ensuite les pistes. Lisez si l'amélioration des MP3 corrige les pistes au son étouffé pour comprendre ce que la restauration peut et ne peut pas corriger.
Guides associés
- Supprimer la batterie d'une chanson Suno terminée : utilisez la séparation de la batterie pour obtenir un morceau sans batterie.
- Remplacer la batterie Suno par votre propre kit : retirez la batterie générée par IA, puis programmez un nouveau groove.
- Convertir un morceau stéréo en Dolby Atmos : placez les pistes séparées dans un bed et des objets Atmos.