Separacja ścieżek AI wysokiej jakości: jak uzyskać czyste ścieżki z SAM Audio i BS-RoFormer
Separacja ścieżek AI wysokiej jakości sprowadza się do trzech rzeczy: właściwego modelu, przetwarzania całego utworu w stereo i przywrócenia jakości źródła, jeśli wykazuje uszkodzenia od kompresji. Użyj dedykowanego modelu ze stałym zestawem ścieżek, takiego jak BS-RoFormer, do wokalu, perkusji i basu, a SAM Audio od Meta do innych instrumentów. Uzyskasz czystsze ścieżki niż ze starszych narzędzi, takich jak Spleeter czy wczesne wersje Demucs.
Producenci, DJ-e i twórcy treści napotykają ten sam problem. Potrzebujesz czystej acapelli do remiksu, utworu bez perkusji do ćwiczeń lub wyizolowanego riffu gitarowego do samplowania. Starsze narzędzia zostawiają zamulony wokal i widmowe artefakty perkusji.
Poradnik wyjaśnia, czym są ścieżki, dlaczego większość separatorów wprowadza artefakty i jak uzyskać ścieżki przydatne w prawdziwej produkcji, także z piosenek Suno.
Czym są ścieżki? Podstawy separacji audio
Ścieżki, czyli stemy, to osobne nagrania audio wyodrębnione ze zmiksowanej piosenki. Zamiast jednego pliku stereo zawierającego wszystko otrzymujesz osobne pliki wokalu, perkusji, basu, pianina i innych instrumentów. Każda ścieżka zawiera tylko dany element.
Istnieją suche ścieżki (bez efektów) i mokre ścieżki (z zastosowanymi efektami, takimi jak pogłos i kompresja). Suche ścieżki to składniki przed gotowaniem; mokre to gotowe danie. Modele opisane w artykule wyodrębniają wyłącznie mokre ścieżki, więc każda zachowuje efekty, które miała w miksie.
Dlaczego ścieżki są ważne w nowoczesnej produkcji muzycznej
Ścieżki zamieniają nieruchomy miks stereo w elastyczne części. Mając ścieżki wysokiej jakości, możesz:
- Tworzyć podkłady karaoke przez usunięcie wokalu
- Produkować mashupy z czysto wyizolowaną acapellą
- Budować remiksy wokół oryginalnego wokalu, co jest ideą planowanej funkcji remiksów AI Spotify
- Zmieniać balans miksu przez regulację poziomów poszczególnych instrumentów
- Uczyć się piosenek, słuchając wybranych partii solo
- Samplować elementy bez przenikania innych instrumentów
- Naprawiać problematyczne częstotliwości na osobnych ścieżkach
Przed AI separacja opierała się na filtrowaniu EQ i znoszeniu fazy, co tworzyło artefakty i nigdy w pełni nie izolowało partii. Modele AI poprawiły to, ucząc się rozpoznawać barwę i strukturę harmoniczną zamiast jedynie filtrować częstotliwości.
Problem większości usług separacji ścieżek
Separatory AI nie są jednakowe. Wiele usług obiecuje „wysoką jakość”, ale oszczędza na podstawach:
Środowiska demonstracyjne a narzędzia produkcyjne
Środowisko demonstracyjne SAM Audio od Meta przetwarza tylko 30-sekundowe fragmenty w mono. Wystarczy do demonstracji, ale nie do całej piosenki w stereo. Zobacz, czym Neural Analog różni się od demonstracji SAM Audio.
Ograniczenia jednego modelu
Wiele usług używa jednego modelu, co wymusza kompromisy. Modele ze stałym zestawem ścieżek, takie jak Demucs lub BS-RoFormer, dobrze radzą sobie z gotowymi podziałami (wokal, perkusja, bas, pozostałe), ale nie mogą wyodrębniać dowolnych instrumentów, takich jak saksofon czy syntezator. Inne modele oferują dowolną ekstrakcję, ale rozdzielają standardowe ścieżki mniej czysto niż narzędzia specjalistyczne.
Brak procesu restauracji audio
Separacja skompresowanych źródeł, takich jak MP3 czy nagrania ze streamingu, ujawnia istniejące artefakty. MP3 o niższym bitrate często odcina wszystko powyżej około 16 kHz i dodaje szum kwantyzacji rozmywający transjenty. Separator, który to ignoruje, tylko wyraźniej izoluje uszkodzone audio.
Jak SAM Audio rozwija separację ścieżek
SAM Audio od Meta to ogólny model separacji źródeł, a nie dedykowane narzędzie usuwania wokalu. Meta opisuje go jako jeden model przyjmujący prompty tekstowe, wizualne i przedziały czasu, oparty na transformerze dopasowania przepływu i trenowany na dużych mieszaninach audio obejmujących mowę, muzykę i ogólne dźwięki.
Posłuchaj różnicy: SAM Audio a standardy branżowe
Poniżej praktyczne porównanie. Wzięliśmy gęsty miks muzyki klasycznej i wyizolowaliśmy ścieżkę pianina za pomocą SAM Audio (Neural Analog) oraz u czołowego konkurenta.
Przykład: porównanie wyodrębniania pianina
Izolowanie jednego instrumentu z gęstego miksu stereo za pomocą promptu 'piano'.
Technologia SAM Audio
SAM Audio używa transformera dopasowania przepływu, aby przewidzieć docelowe źródło ze zmiksowanego nagrania. W Neural Analog Studio możesz opisać źródło tekstem i zaznaczyć przedział czasu, w którym się pojawia. Prompty wizualne są częścią modelu badawczego, a nie kontrolką w obecnym interfejsie audio Studio. Dla producentów różnicą jest kontrola: model może wskazywać dźwięki poza stałymi kategoriami wokalu, perkusji, basu i pozostałych.
Neuronowy enkoder audio: dlaczego architektura modelu decyduje o jakości
Każdy separator AI opiera się na neuronowym enkoderze audio. Zamienia on surowy przebieg falowy w zwarte przedstawienie barwy, wysokości, rytmu i rozmieszczenia stereo. Pomyśl o nim jak o „uszach” modelu: to, jak dobrze odróżnia werbel od wokalu, zależy od jakości treningu enkodera.
Wczesne modele, takie jak Spleeter, używały enkoderów CNN traktujących spektrogramy jak obrazy 2D. Radziły sobie z podstawowym rozdzielaniem wokalu i perkusji, ale miały trudności z drobnymi szczegółami barwy i spójnością w czasie. Demucs v4 (Hybrid Transformer Demucs) przetwarza zarówno przebieg falowy, jak i spektrogram, co pomaga zachować transjenty i fazę dla naturalniejszego brzmienia. BS-RoFormer dzieli spektrogram na pasma częstotliwości i modeluje je warstwami Transformer. Jego artykuł podaje średni SDR 9,8 dB na benchmarku MUSDB18-HQ, wyższy niż Demucs v4. Nasze porównanie Spleeter i Demucs szczegółowo opisuje starsze modele.
SAM Audio idzie dalej dzięki Perception Encoder Audiovisual (PE-AV), trenowanemu na ponad 100 milionach klipów wideo. Ponieważ uczył się z wideo, łączy dźwięki z instrumentami i działaniami, które je wytwarzają. Pomaga to przy promptach takich jak "guitar", szczególnie gdy gitara dzieli zakres częstotliwości z innymi instrumentami.
Architektura badawcza SAM Audio
dog barking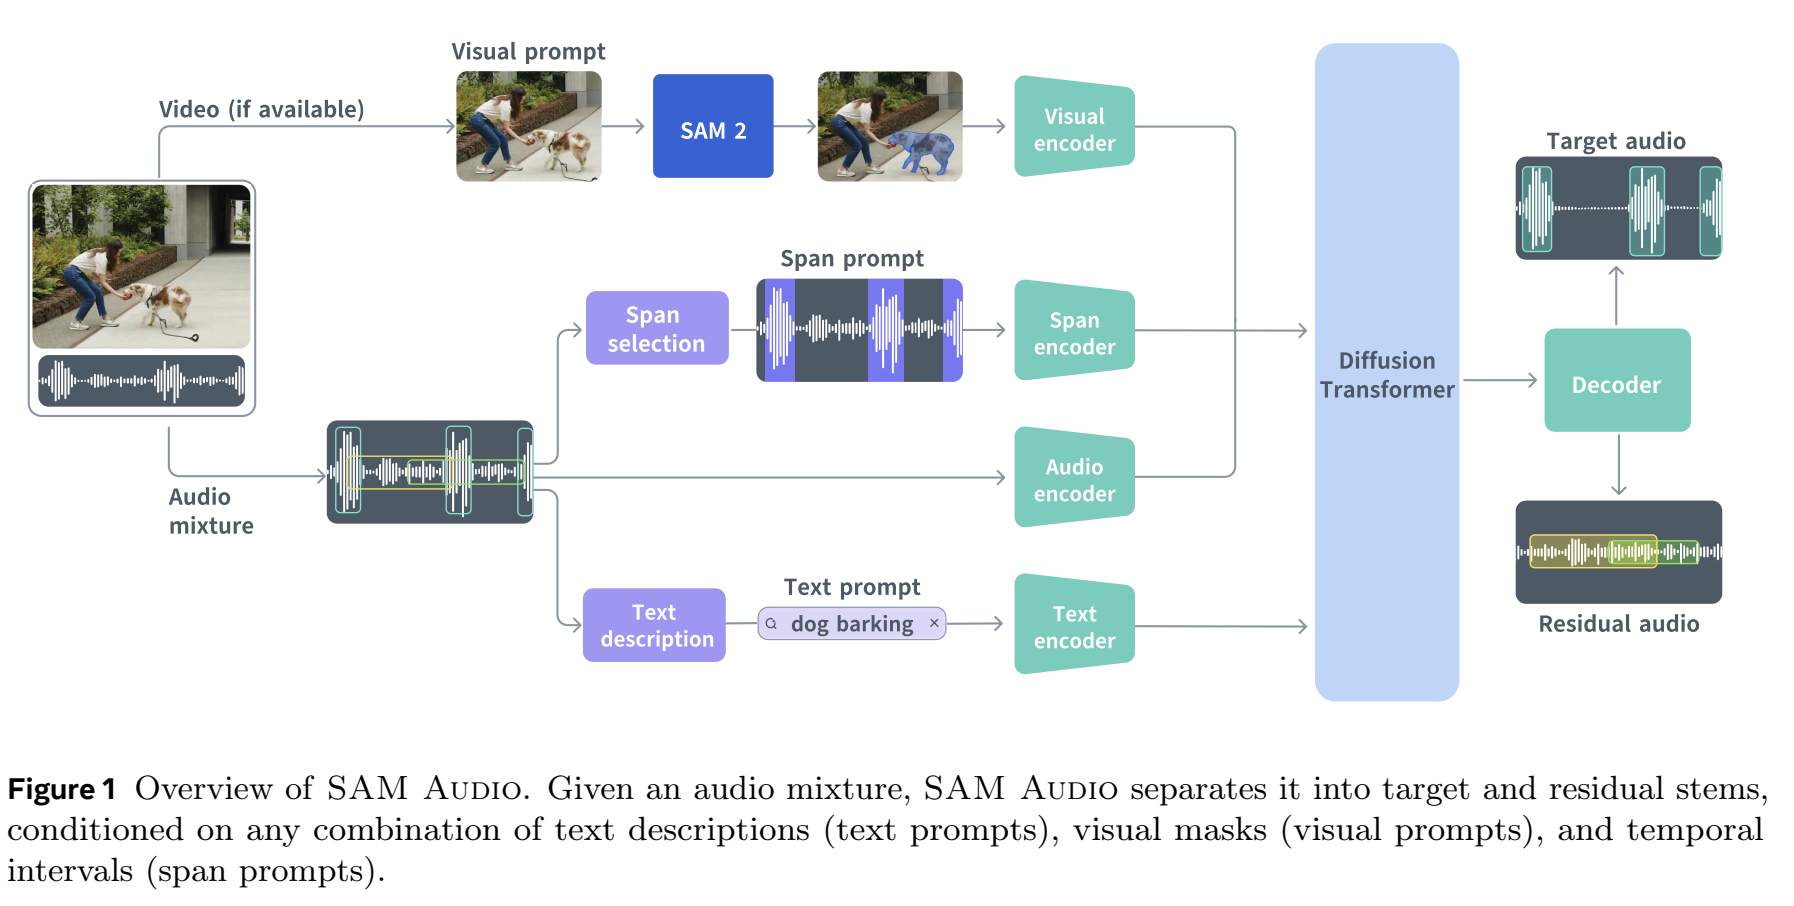
Oryginalny diagram: Architektura badawcza SAM Audio.
Jakość enkodera bezpośrednio wpływa na jakość ścieżek na trzy sposoby:
- Rozdzielczość barwy: lepsze enkodery oddzielają harmoniczne od szumu, więc instrumenty zachowują charakter
- Spójność czasowa: silniejsze enkodery utrzymują separację w czasie, unikając częstych w tańszych narzędziach artefaktów szybkiego włączania i wyłączania
- Szczegóły: większe enkodery wychwytują skrzypienie strun, oddechy i akustykę pomieszczenia
Porównując usługi, pytaj, jaki model uruchamiają, zamiast polegać na marketingu. Obróbka końcowa nie może w pełni nadrobić starszego enkodera.
Jak Neural Analog używa SAM Audio i BS-RoFormer
Separator ścieżek AI Neural Analog zamienia SAM Audio i BS-RoFormer w praktyczne narzędzie dla muzyków.
W przeciwieństwie do 30-sekundowej demonstracji mono Neural Analog przetwarza całe utwory w pełnym stereo, więc ścieżki zachowują szerokość i głębię oryginalnego miksu.
Możesz wybrać SAM Audio lub sprawdzone presety ze stałym zestawem ścieżek:
- SAM Audio do wyodrębniania dowolnych instrumentów (saksofon, syntezator, smyczki)
- Presety do szybszej, niezawodnej separacji: 4 ścieżki (wokal, perkusja, bas, pozostałe) lub 6 ścieżek (dodatkowo gitara i pianino), zasilane modelami BS-RoFormer, nowszym pokoleniem separatorów o stałych ścieżkach niż Demucs
W SAM Audio online możesz napisać prompt i zaznaczyć przedziały na przebiegu falowym, gdy docelowy dźwięk występuje tylko w części utworu. Masz pytania lub wyniki do pokazania? Dołącz do Discorda Neural Analog.
Zintegrowany proces restauracji audio
Wyodrębnione ścieżki można poddać restauracji audio, aby rozszerzyć pasmo i usunąć część artefaktów. Odsłuchaj wynik: restauracja nie naprawia każdego błędu separacji.
Lepsze ścieżki Suno: dlaczego muzyka AI wymaga szczególnego traktowania
Suno i inne generatory muzyki AI, w tym Udio i FlowMusic / Producer.ai, często tworzą pliki skompresowane lub z ograniczonym pasmem. To wyznacza pułap jakości, zanim separacja się zacznie. Aby rozdzielić piosenkę Suno bezpośrednio z linku, użyj separatora Suno. Udio nie oferuje już pobierania ani ścieżek, więc najpierw zapisz piosenki Udio jako pliki audio.
Problem podwójnej kompresji
Rozdzielanie MP3 Suno prostymi narzędziami separuje już uszkodzone audio. Ścieżki dziedziczą:
- Poważną utratę wysokich częstotliwości (często nic powyżej 15 kHz)
- Szum kwantyzacji osadzony w sygnale
- Mniejszą szerokość i głębię stereo
- Artefakty cyfrowego „dzwonienia”
Jak restauracja poprawia muzykę AI
Proces zajmuje się tymi ograniczeniami krok po kroku:
- Wyodrębnianie: SAM Audio lub model presetu rozdziela ścieżki
- Usuwanie artefaktów: restauracja neuronowa może ograniczyć szum kompresji MP3
- Odbudowa częstotliwości: model przewiduje i odtwarza zawartość harmoniczną do 20 kHz
- Obsługa stereo: zachowaj sygnały stereo podczas odbudowy szczegółów, potem porównaj na słuch szerokość i fazę ze źródłem
Wynikowe ścieżki Suno brzmią bliżej profesjonalnych nagrań wielośladowych.
Krok po kroku: jak uzyskać ścieżki wysokiej jakości w Neural Analog
Wykonaj te kroki, aby uzyskać spójne wyniki. Poradnik separacji ścieżek w Studio dokładniej opisuje każdą kontrolkę.
Krok 1: prześlij audio
Przeciągnij i upuść plik albo wklej publiczny link z obsługiwanego źródła, takiego jak Suno, FlowMusic, TopMediaAI, Treblo, Mureka lub YouTube. Obsługiwane formaty to MP3, WAV, FLAC, M4A i OGG. Maksymalna długość zależy od planu i wybranego modelu.
Krok 2: wybierz strategię separacji
Dla przewidywalnych wyników otwórz Separacja ścieżek i wybierz 4 ścieżki dla wokalu, perkusji, basu i pozostałych lub 6 ścieżek, aby dodać gitarę i pianino. Sprawdź wybrane źródło w polu Wejście. Te presety uruchamiają dedykowane modele ze stałymi ścieżkami i dają spójną separację.
Dla dowolnych instrumentów wybierz Własny prompt, aby użyć SAM Audio. Sprawdź wybraną opcję Model, potem opisz dźwięk. Bądź konkretny: electric guitar solo with distortion działa lepiej niż guitar. SAM Audio zwraca dwie uzupełniające się ścieżki: dźwięk pasujący do promptu i resztę nagrania.
Krok 3: skonfiguruj przetwarzanie
Przetwarzanie stereo SAM Audio: domyślny tryb Stereo (środek/różnica) przetwarza sygnał środkowy (Mid) i różnicowy (Side) osobno, a potem łączy je ponownie. Wybierz Stereo (L/R), aby osobno przetwarzać kanały lewy i prawy, albo Mono, aby uśrednić je do jednego kanału. Te kontrolki dotyczą SAM Audio; presety ze stałymi ścieżkami używają własnych modeli stereo. Zobacz, kiedy używać przetwarzania Mid/Side.
Krok 4: przetwórz i pobierz
Do samej separacji pozostaw opcję Popraw ścieżki wyłączoną. Sprawdź szacowaną liczbę minut przetwarzania odliczanych z salda, potem kliknij Rozpocznij wyodrębnianie i poczekaj. Krótkie utwory często kończą się w kilka minut; dłuższe utwory i cięższe modele wymagają więcej czasu. Odsłuchaj każdą ścieżkę w Studio, potem otwórz Eksport i wybierz Osobne ścieżki dla osobnych plików lub Połączone ścieżki dla obecnego miksu.
Krok 5: przywróć jakość wyodrębnionych ścieżek
Jeśli ścieżce brakuje wysokich częstotliwości lub słychać uszkodzenia kompresji, wybierz ją jako źródło w polu Wejście pod Popraw, wybierz Przywracanie jakości muzyki MP3 dla instrumentów lub Poprawa śpiewu dla wokalu i kliknij Uruchom model. Porównaj wynik przed eksportem. Poradnik restauracji MP3 do WAV wyjaśnia wybór modeli. Aby zamiast tego automatycznie przetwarzać po ekstrakcji ścieżki, dla których dostępna jest ta obróbka, włącz Popraw ścieżki, wybierz model restauracji i sprawdź dodatkowe szacowane zużycie minut przetwarzania przed rozpoczęciem ekstrakcji. Czyste ścieżki nie wymagają restauracji.
Kwestie techniczne w procesie produkcyjnym
Dodając wyodrębnianie ścieżek do swojej pracy, sprawdź te czynniki:
Jakość pliku źródłowego
Restauracja może odbudować skompresowane pliki, ale źródła bezstratne (WAV, FLAC) nadal dają dokładniejszą separację. Enkoder ma więcej oryginalnych informacji, więc mniej trzeba rekonstruować.
Jeśli instrument pojawia się tylko przez kilka sekund w długim pliku, zaznacz ten przedział w Studio lub przytnij plik przed przesłaniem. Model otrzymuje wyraźniejszy cel, a przetwarzanie jest szybsze.
Spójność fazowa ścieżek
Ścieżki z tej samej piosenki powinny po zsumowaniu w przybliżeniu dać oryginalny miks. Jeśli ich faza dryfuje, ponowne łączenie powoduje filtrowanie grzebieniowe lub znoszenie. Modele Neural Analog zaprojektowano do zachowania relacji fazowych, co ma znaczenie dla masteringu ścieżek i remiksów. Sprawdź to, sumując ścieżki w DAW i porównując je z oryginałem.
Słyszalność artefaktów
Słuchaj typowych artefaktów separacji:
- Przenikanie: instrumenty słabo słyszalne na niewłaściwej ścieżce
- Przerywanie: szybkie włączanie i wyłączanie podczas wyodrębniania
- Rozmycie: utrata ostrości transjentów
- Utrata wysokich częstotliwości: brak powietrza i szczegółów
Restauracja naprawia wiele z nich, ale czyste źródło ogranicza je już na etapie wyodrębniania. Później użyj DAW, aby zachować tylko te części każdej ścieżki, które brzmią dobrze.
Kiedy używać poszczególnych typów modeli
Użyj presetów ze stałymi ścieżkami (BS-RoFormer), gdy:
- Potrzebujesz standardowej izolacji wokalu, perkusji lub basu
- Szybkość przetwarzania jest kluczowa
- Miks źródłowy jest względnie czysty
- Chcesz przewidywalnych, sprawdzonych wyników
Użyj SAM Audio do dowolnej separacji, gdy:
- Instrument nie jest objęty standardowymi presetami
- Miks jest gęsty, a dźwięki nakładają się
- Musisz rozdzielić podobne dźwięki (na przykład gitarę prowadzącą i rytmiczną)
- Źródło zawiera nietypowe instrumenty lub dźwięki syntetyczne
Użyj restauracji, gdy jest potrzebna:
- MP3 lub źródło streamingowe ma słyszalne uszkodzenia kompresji
- Oryginalny plik ma poniżej 320 kbps i brakuje mu szczegółów wysokich częstotliwości
- Muzyka AI ma odcięte pasmo lub artefakty kompresji
- Po odsłuchaniu okazuje się, że ścieżki wymagają naprawy przed komercyjnym wydaniem
Jak wybrać najlepszy proces separacji ścieżek AI
Zacznij od testowego utworu, który dobrze znasz. Porównaj wyodrębnione ścieżki z oryginalnym miksem, sprawdzając spójność fazową i poziomy artefaktów. Użyj presetów do standardowych podziałów, SAM Audio do reszty, a restauracji wtedy, gdy skompresowane lub wygenerowane przez AI źródło wymaga naprawy.
Dzięki obecnym modelom AI i restauracji wyodrębnione ścieżki mogą zbliżyć się do oryginalnej sesji wielośladowej na potrzeby remiksów, samplowania i analizy miksu.
Pytania o separację ścieżek wysokiej jakości
Jaki model AI jest najlepszy do separacji ścieżek?
Dla wokalu, perkusji, basu i partii instrumentalnych modele BS-RoFormer i Mel-Band RoFormer obecnie osiągają najwyższe wyniki w publicznych benchmarkach. Dla instrumentów poza stałymi ścieżkami model oparty na promptach, taki jak SAM Audio, jest bardziej elastyczny. Zobacz rankingi najlepszych modeli do wokalu oraz najlepszych modeli do instrumentów.
Czy Neural Analog używa Demucs do ścieżek?
Nie. Presety na 4 i 6 ścieżek używają modeli BS-RoFormer, a wyodrębnianie dowolnych instrumentów korzysta z SAM Audio.
Dlaczego ścieżki brzmią cienko lub jak spod wody?
Zwykle źródłem jest MP3 o niskim bitrate albo narzędzie używa starszego modelu. Zacznij od najlepszego dostępnego źródła, użyj nowszego modelu i potem przywróć jakość ścieżek. Przeczytaj, czy poprawa jakości MP3 naprawia stłumione ścieżki, aby poznać możliwości i ograniczenia restauracji.
Powiązane poradniki
- Usuń perkusję z gotowej piosenki Suno: użyj separacji ścieżki perkusji, aby uzyskać utwór bez perkusji.
- Zastąp perkusję Suno własnym zestawem: usuń perkusję AI, potem zaprogramuj nowy groove.
- Przekształć piosenkę stereo w Dolby Atmos: umieść osobne ścieżki w warstwie bed i obiektach Atmos.