Spleeter vs. Demucs 2026: Messwerte und Modelle, die beide übertreffen
Bei Spleeter und Demucs geht es um Geschwindigkeit gegenüber Qualität. Demucs trennt Stems sauberer (9,0 dB SDR für das feinabgestimmte Demucs v4 gegenüber 5,9 dB für Spleeter). Spleeter ist dagegen deutlich schneller und läuft problemlos auf einer einfachen CPU. Im Jahr 2026 erzielen neuere Modelle wie BS-RoFormer höhere Werte als beide.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Entwickelt von | Deezer, 2019 | Meta AI Research, 2022 |
| Funktionsweise | Maskiert ein Spektrogramm (U-Net) | Wellenform- und Spektrogrammzweige mit einem Transformer |
| Qualität (SDR auf MUSDB18) | 5,9 dB | 9,0 dB (feinabgestimmt) |
| Geschwindigkeit | Sehr schnell, gut auf CPU nutzbar | Langsamer, am besten mit GPU |
| Stems | 2, 4 oder 5 | 4 oder 6 mit Gitarre und Klavier |
| Geeignet für | Schnelle Vorschauen, Karaoke, Stapelverarbeitung | Saubere Stems für Remixe und Veröffentlichungen |
Wenn Sie schon einmal Gesang extrahiert oder eine Instrumentalversion für einen Remix erstellt haben, haben Sie wahrscheinlich ein Werkzeug verwendet, das auf einem dieser Modelle basiert. Beide Open-Source-Modelle wurden zu Referenzen für die Stem-Trennung. Ihr Vergleich zeigt weiterhin die Kompromisse zwischen Geschwindigkeit, Artefakten und Qualität.
Was sind Stems und warum ist ihre Trennung so schwierig?
Stems sind die einzelnen Bestandteile eines gemischten Songs, üblicherweise Gesang, Schlagzeug, Bass und der Rest. Produzenten arbeiten im Studio damit, bevor die endgültige Mischung alles zusammenführt.
Sie nach dem Mischen zu trennen, ist so, als wollten Sie einen fertig gebackenen Kuchen wieder in seine Zutaten zerlegen. Instrumente teilen sich dieselben Frequenzbereiche. Die Obertöne des Gesangs überlagern sich mit Gitarrenfrequenzen. Die Transienten der Bassdrum treffen auf Bassnoten. Beckenschläge verteilen sich über das gesamte Stereofeld. Herkömmliche Signalverarbeitung lieferte schwankende Ergebnisse mit vielen Artefakten.
Deep Learning verbesserte das, indem neuronale Netze lernten, Muster zu erkennen, die klassische Signalverarbeitung übersah. Spleeter und Demucs wurden zu den beiden Referenzmodellen und verfolgen sehr unterschiedliche Ansätze.
Geschichte: Spleeter, Demucs und ihre Verbindung zu Paris
Spleeter: schnelle Spektrogramm-Maskierung von Deezer
Im November 2019 veröffentlichte der französische Streamingdienst Deezer Spleeter als kostenloses Open-Source-Werkzeug. Das Team unter Romain Hennequin entwickelte es mit TensorFlow rund um ein konvolutionales neuronales U-Net, das auf Betragsspektrogrammen arbeitet, also Zeit-Frequenz-Darstellungen des Audios.
Spleeter behandelt die Trennung wie Bildsegmentierung. Für jede Zeit-Frequenz-Zelle schätzt es eine weiche Maske, die den Anteil von Gesang, Schlagzeug, Bass oder anderen Klängen angibt. Eine optionale Wiener-Filterung verfeinert die Masken. Anschließend werden die Stems mit der Phase der ursprünglichen Mischung rekonstruiert.
Spleeters Stärke ist die Geschwindigkeit. Es trennt einen vierminütigen Track in Sekunden, erreicht auf GPU die 100-fache Echtzeitgeschwindigkeit und läuft problemlos auf einfachen CPUs. Es bietet Konfigurationen mit 2 Stems (Gesang/Begleitung), 4 Stems und 5 Stems. Es wurde zu einer Referenz für die Forschung und kam in zahllosen Remix-Kanälen auf YouTube zum Einsatz.
Demucs: Trennung im Wellenformbereich von Meta
Während Spleeter auf Geschwindigkeit setzte, konzentrierte sich Meta AI Research, damals Facebook AI Research, auf Qualität. Alexandre Défossez, ebenfalls Franzose, und sein Team stellten Demucs 2019 vor, eine Kurzform von Deep Extractor for MUlti-Channel Sources, mit einem deutlich anderen Ansatz.
Statt auf Spektrogrammen arbeitet Demucs direkt auf rohen Wellenformen und behandelt die Trennung als Rekonstruktionsproblem im Zeitbereich. Die Architektur kombiniert einen konvolutionalen Encoder-Decoder im U-Net-Stil, inspiriert von Wave-U-Net, mit einem bidirektionalen LSTM als Engpass. Dadurch erfasst das Netz längerfristige musikalische Struktur und erhält die Phasenkohärenz.
Demucs entwickelte sich über vier Hauptversionen:
- v1 (2019): reiner Wellenformansatz, der bereits mit Spektrogrammverfahren konkurrierte
- v2 (2020): verfeinertes Training und höhere Effizienz
- v3 „Hybrid Demucs“ (2021): ergänzte einen Spektrogrammzweig und gewann die Music Demixing Challenge mit 7,7 dB SDR auf MUSDB18
- v4 „Hybrid Transformer Demucs“ (2022): ersetzte die innersten Schichten durch einen domänenübergreifenden Transformer und erreichte nach Feinabstimmung 9,0 dB SDR sowie bis zu 9,2 dB in der besten Konfiguration des Papers
Die Sound Demixing Challenge und ein neuer Anfang
Die Sound Demixing Challenge 2023 verschob den Schwerpunkt. Meta, Sony und weitere Organisatoren führten die robuste Trennung musikalischer Quellen ein: Modelle wurden mit Daten trainiert, deren Labels verrauscht waren und deren Stems Übersprechen enthielten. Alexandre Défossez war einer der wichtigsten Organisatoren und wirkte an der Gestaltung der Challenge und den Referenzmodellen mit.
Die wichtigste Erkenntnis: Mehr Trainingsdaten garantieren keine besseren Ergebnisse. Datenqualität und Strategien zur Robustheit sind wichtiger. Verfahren wie das Abschneiden der Verlustfunktion und iterative Verfeinerung verbesserten den SDR auf verrauschten Daten um 0,89 dB.
Kurz danach verließ Défossez Meta und gründete Kyutai mit, ein französisches KI-Forschungslabor. Das Demucs-Repository ist weiterhin online. Laut README arbeitet er jedoch nicht mehr aktiv daran. Erwarten Sie daher keine neuen Funktionen.
Leistung: Kompromisse zwischen Geschwindigkeit und Qualität
Grundgedanke der Architekturen
Spleeter maskiert Spektrogramme. Demucs rekonstruiert Wellenformen. Dieser grundlegende Unterschied bestimmt alles Weitere.
Spleeters Ansatz im Frequenzbereich ist effizient, weil jeder STFT-Frame Tausende Samples zusammenfasst. Die Faltungen laufen deshalb über deutlich weniger Zeitschritte. Der Preis: Das Modell ignoriert die Phase und verwendet die Phase der Mischung wieder. Die feste Zeit-Frequenz-Auflösung der STFT kann scharfe Transienten und gleichmäßige Töne nicht gleichzeitig gut darstellen.
Demucs lernt mit seiner Zeitbereichsmethode eigene Filterbänke über 1D-Faltungen. Es erhält die Phase und verarbeitet Transienten mit Sample-Genauigkeit. In v4 behalten die Transformer-Schichten den Kontext über mehrere Sekunden Audio bei. Das verringert die „Pingpong“-Artefakte, die bei framebasierten Verfahren häufig auftreten.
Hybrid Demucs v3: Wellenform- und Spektrogrammzweig
Skip-Verbindungen zwischen Encoder und Decoder
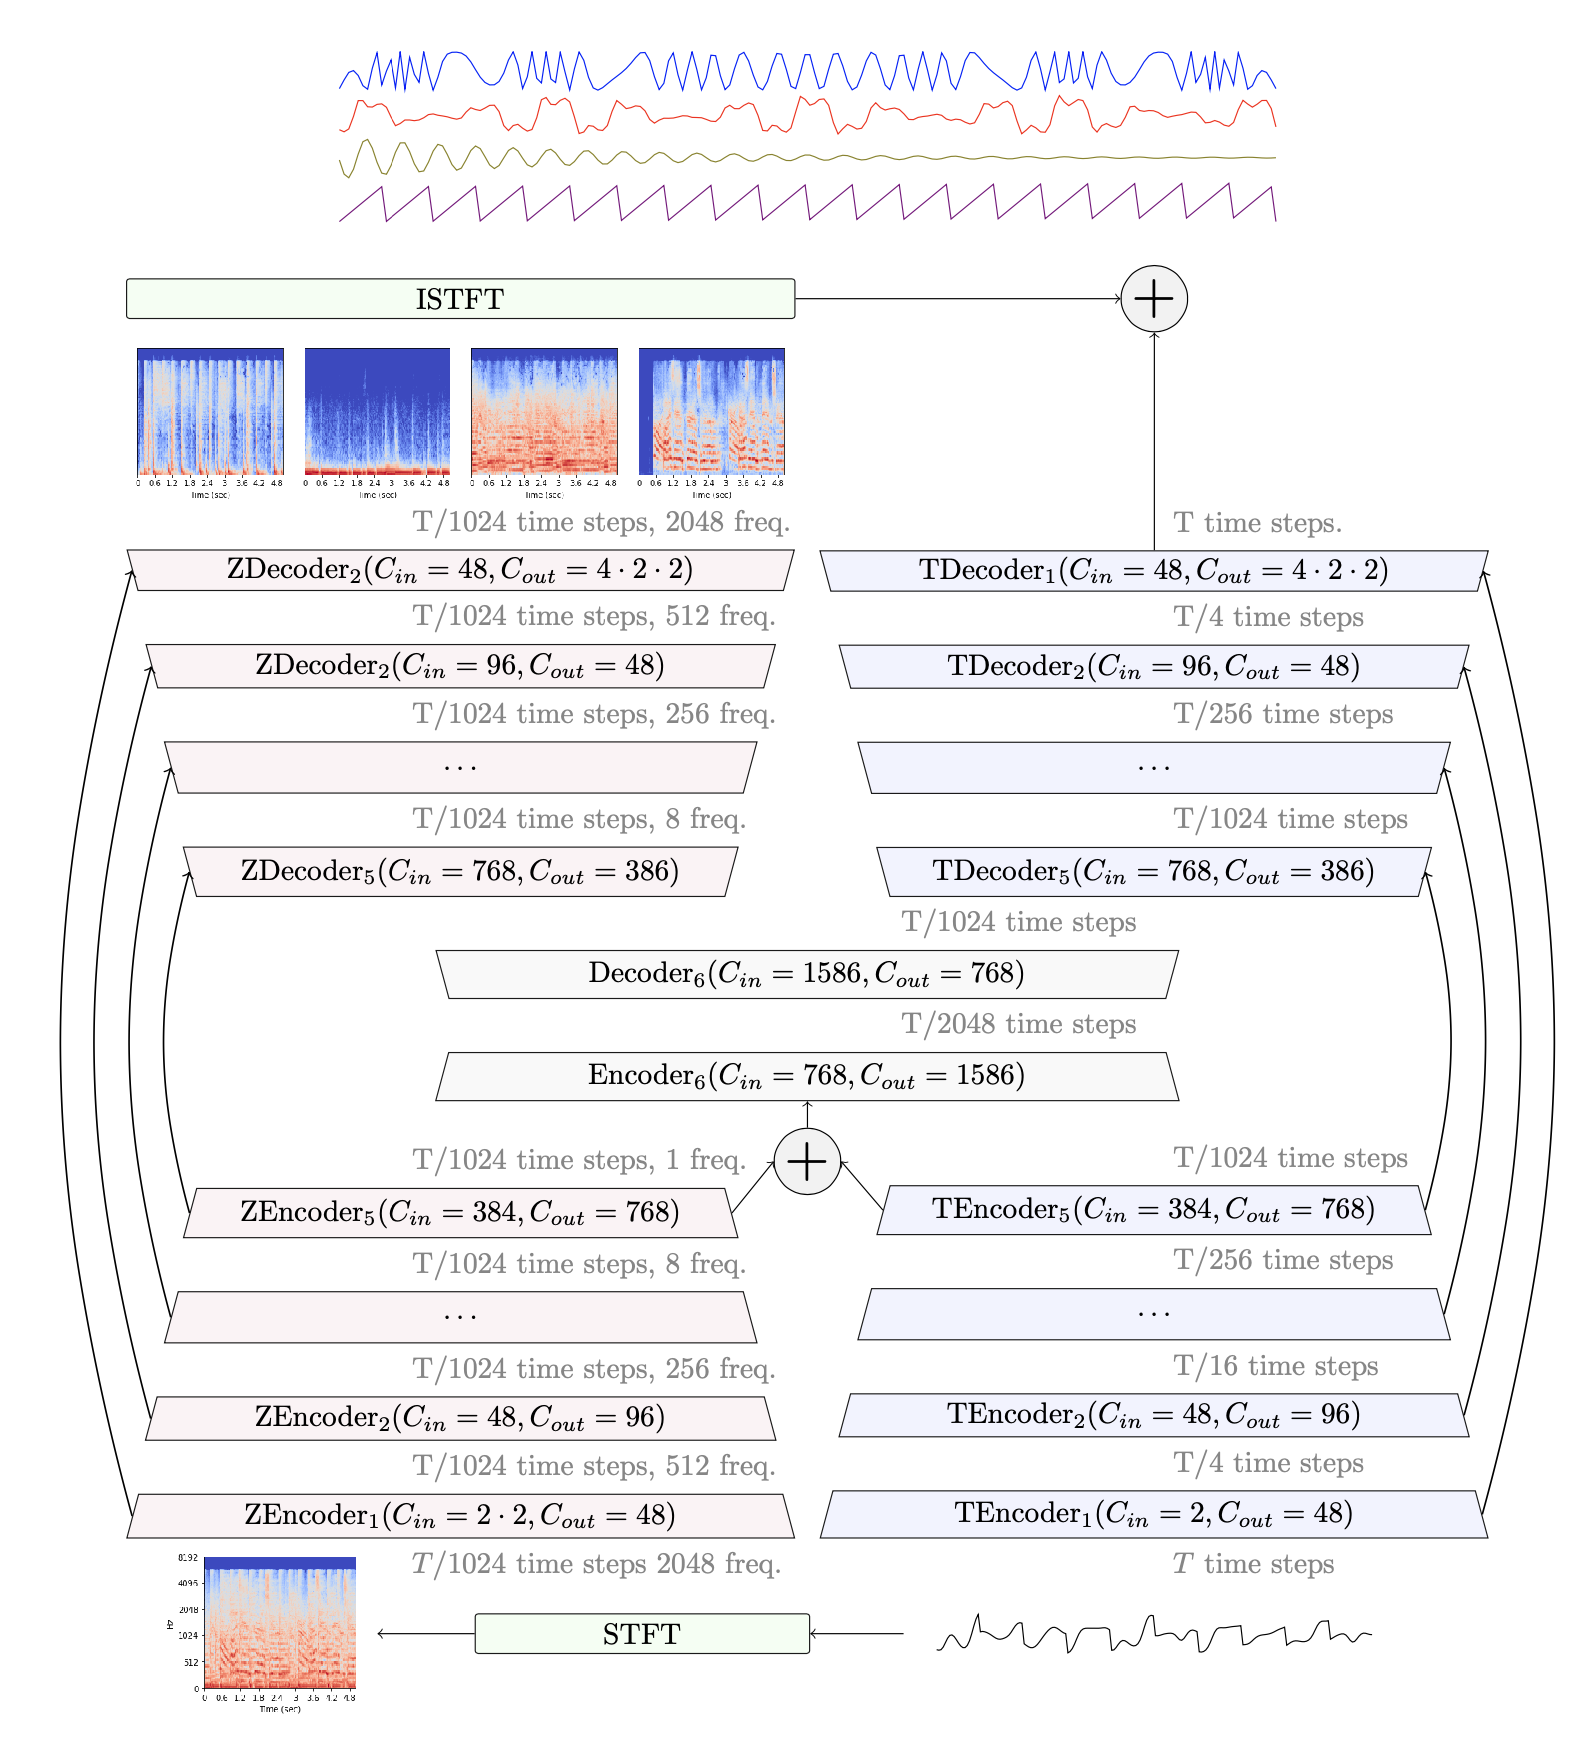
Originalabbildung: Einführung in die Quellentrennung, Abbildung 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Messwerte im Vergleich: Spleeter und Demucs
Diese Werte auf dem MUSDB18-Testdatensatz stammen aus dem offiziellen Demucs-Repository auf GitHub:
| Modell | Bereich | Zusätzliche Trainingsdaten | Gesamt-SDR | MOS-Qualität |
|---|---|---|---|---|
| Spleeter | Spektrogramm | 25.000 Songs | 5,9 dB | k. A. |
| Demucs v2 | Wellenform | Keine (nur MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Hybrid | Keine (nur MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs fine-tuned v4 | Hybrid | 800 Songs | 9,0 dB | k. A. |
Das Signal-zu-Verzerrungs-Verhältnis (SDR) misst, wie sauber ein Modell eine Quelle von der Mischung trennt. Höhere Werte sind besser, doch SDR ersetzt keinen Hörtest. Was Sie in der Praxis von KI-Stems erwarten können, erfahren Sie unter Wie gut ist KI-Stem-Trennung heute?. Der Abstand von ungefähr 3 dB zwischen Spleeter und Demucs v4 ist für Benchmarks groß. Demucs erzielt bei jedem Stem höhere Werte, besonders bei Schlagzeug und Gesang.
Im Vergleichsvideo unten können Sie den Unterschied hören. Demucs-Stems klingen natürlicher und haben weniger Artefakte. Spleeter kann bei komplexem Material metallisches Nachklingen erzeugen.

Auswirkungen in der Praxis
Geschwindigkeit: Spleeter verarbeitet einen 3-minütigen Track auf GPU in etwa 2 Sekunden. Demucs v4 benötigt ungefähr 20 bis 30 Sekunden. Auf CPU braucht Spleeter etwa 30 bis 60 Sekunden; Demucs kann mehr als 5 Minuten benötigen.
Hardware: Spleeter läuft allein auf CPU auf einem Laptop mit 8 GB RAM. Demucs v4 benötigt für eine angemessene Geschwindigkeit eine GPU mit 4 bis 8 GB VRAM. Seine Transformer-Schichten brauchen wegen der Aufmerksamkeitsmatrizen wesentlich mehr Speicher.
Artefakte: Da Spleeter die Phase der Mischung wiederverwendet, kann es „geisterhaften“ Gesang und verschmierte Transienten erzeugen. Demucs v4 klingt natürlicher, kann in stillen Passagen jedoch leises Rauschen zurücklassen.
Robustheit: Die SDX'23-Challenge zeigte, dass Architekturen im Demucs-Stil besser mit beschädigten Trainingsdaten umgehen. Spleeters einfachere Architektur profitiert nicht ohne Weiteres von Verfahren wie gefilterten Datensätzen und dem Abschneiden der Verlustfunktion.
Spleeter oder Demucs: Was sollten Sie verwenden?
Viele Produzenten verwenden je nach Aufgabe beide.
Wann Sie Spleeter verwenden sollten
Verwenden Sie Spleeter, wenn Geschwindigkeit zählt: schnelle A-cappella-Versionen für DJ-Sets, Karaoke-Tracks zum Üben oder die Stapelverarbeitung einer ganzen Sample-Bibliothek. Die 100-fache Echtzeitgeschwindigkeit und die geringen Hardwareanforderungen sind schwer zu übertreffen. Die Qualität reicht für Remixe, bei denen Sie die Stems weiterbearbeiten.
Wann Sie Demucs verwenden sollten
Wählen Sie Demucs v4, wenn Artefakte nicht akzeptabel sind: Stems für offizielle Remixe, Samples für kommerzielle Veröffentlichungen oder eine genaue Analyse einer Darbietung. Die Qualitätsverbesserung von 3 dB und die Phasenkohärenz rechtfertigen die Wartezeit. Bei Material eines bestimmten Genres sollten Sie mit zusätzlichen Daten feinabstimmen, da Demucs mit mehr sauberen Daten besser skaliert.
Spleeter und Demucs kombinieren
Lassen Sie Spleeter Ihren gesamten Katalog verarbeiten, um vielversprechende Tracks zu finden. Verarbeiten Sie die besten Kandidaten anschließend mit Demucs. Für Live-Auftritte trennen Sie im Voraus mit Spleeter. Für die Studioarbeit verwenden Sie Demucs, um die saubersten Stems zu erhalten. Werkzeuge wie Ultimate Vocal Remover bündeln Demucs mit weiteren Trennmodellen hinter einer einfachen grafischen Oberfläche.
Benötigen Sie eine GPU?
Spleeter läuft gut auf CPU, während hochwertige Demucs-Abläufe deutlich von einer GPU profitieren. Für Offline-Stapelverarbeitung oder die Nutzung auf einem Laptop sind Modelle im Spleeter-Stil weiterhin nützlich. Für sauberere Stems rechtfertigen Demucs und neuere hybride Transformer-Modelle meist Cloud-Verarbeitung oder einen leistungsfähigeren lokalen Rechner.
Update 2026: Modelle, die Spleeter und Demucs übertreffen
Spleeter und Demucs sind weiterhin nützliche Referenzen, bilden jedoch nicht mehr die Qualitätsobergrenze der Stem-Trennung.
BS-RoFormer (Band-Split RoPE Transformer) teilt das Spektrogramm in Frequenzbänder und modelliert sie mit Transformer-Schichten. Das Paper berichtet 9,80 dB durchschnittlichen SDR auf MUSDB18-HQ ohne zusätzliche Trainingsdaten. Das ist mehr als die 9,0 dB des feinabgestimmten Demucs v4 mit 800 zusätzlichen Songs. Eine Version, die mit 500 zusätzlichen Songs trainiert wurde, belegte in der Musiktrennung der Sound Demixing Challenge 2023 den ersten Platz.
| Modell | Jahr | Gesamt-SDR (MUSDB18) | Zusätzliche Trainingsdaten |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25.000 Songs |
| HT Demucs fine-tuned (v4) | 2022 | 9,0 dB | 800 Songs |
| BS-RoFormer | 2023 | 9,8 dB | Keine |
Mel-Band RoFormer ist eng verwandt und gruppiert Frequenzen auf der Mel-Skala. Community-Checkpoints beider Modelle bilden heute die Grundlage der meisten hochwertigen Gesangs- und Instrumentalseparatoren. Unser Vergleich der Modelle zur Gesangstrennung bewertet sie anhand echter Tracks. Der Vergleich der Modelle zur Instrumententrennung macht dasselbe für weitere Instrumente.
Neural Analogs KI-Stem-Separator verwendet BS-RoFormer-Modelle für die Presets mit 4 und 6 Stems und SAM Audio, wenn Sie ein Instrument extrahieren möchten, das die Presets nicht abdecken, etwa ein Saxofon oder einen Lead-Synthesizer. Die vollständige Liste finden Sie unter Welche Modelle verwendet Neural Analog zur Stem-Trennung?.
Häufige Fragen zu Spleeter und Demucs
Ist Demucs besser als Spleeter?
Ja, bei der Qualität. Demucs v4 erzielt im MUSDB18-Benchmark etwa 3 dB mehr SDR als Spleeter und hat bei Gesang und Schlagzeug weniger Artefakte. Spleeter ist nur besser, wenn Geschwindigkeit oder ein Rechner ohne GPU wichtiger sind als Qualität.
Was ist besser für Gesang, Spleeter oder Demucs?
Demucs. Spleeter-Gesang klingt oft dünn oder „wässrig“, weil Spleeter die Phase der ursprünglichen Mischung wiederverwendet. Für die saubersten Gesangs- und Instrumentalspuren übertrifft ein BS-RoFormer- oder Mel-Band-RoFormer-Modell meist beide.
Wird Spleeter noch gepflegt?
Spleeter ist weiterhin auf GitHub verfügbar, ist aber ein Modell von 2019 auf TensorFlow-Basis. Die README warnt vor TensorFlow-Problemen auf Apple-M1-Chips. Die meisten neueren Werkzeuge sind auf Demucs oder RoFormer-Modelle umgestiegen.
Was verwendet Ultimate Vocal Remover (UVR)?
UVR ist eine kostenlose Desktop-Anwendung, kein einzelnes Modell. Es bündelt mehrere Modellfamilien, darunter Demucs, MDX-Net und seine eigenen VR Architecture-Modelle. Die Qualität hängt deshalb vom gewählten Modell ab.
Kann ich Demucs ohne GPU verwenden?
Ja, aber es ist langsam. Rechnen Sie auf CPU mit mehreren Minuten pro Song. Ein Online-Stem-Separator führt das Modell stattdessen auf der GPU eines Servers aus. Die Studio-Anleitung zur Stem-Trennung zeigt die Schritte.
Weitere Anleitungen
- Schlagzeug aus einem Suno-Song entfernen: eine praktische Anwendung der Trennung von Schlagzeug-Stems.
- KI-Schlagzeug durch Ihr eigenes Kit ersetzen: Trennen Sie das Schlagzeug und bauen Sie anschließend einen neuen Groove um den Gesang auf.
- MP3-Stems auf WAV-Qualität restaurieren: Rekonstruieren Sie die Höhen, die komprimierte Quellen und die Trennung verlieren.
- Einen Stereo-Song in Dolby Atmos umwandeln: Platzieren Sie getrennte Stems in einer Atmos-Mischung.
- AudioSR von GitHub installieren und ausführen: ein weiteres Open-Source-Audiomodell für die lokale Ausführung mit Python- und PyTorch-Einrichtung.