Spleeter أم Demucs في 2026؟ المقاييس وما يتفوق عليهما
تتلخص المقارنة بين Spleeter وDemucs في السرعة مقابل الجودة. يفصل Demucs المسارات الصوتية بنظافة أكبر (9.0 dB لنسبة SDR في Demucs v4 المضبوط ضبطا دقيقا، مقابل 5.9 dB في Spleeter)، بينما يعمل Spleeter بسرعة أكبر بكثير وبسهولة على معالج CPU متواضع. في 2026، تحقق نماذج أحدث مثل BS-RoFormer درجات أعلى من كليهما.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| الجهة المطورة | Deezer، 2019 | Meta AI Research، 2022 |
| آلية العمل | أقنعة على مخطط طيفي (U-Net) | فرع للموجة الصوتية وفرع للمخطط الطيفي مع Transformer |
| الجودة (SDR على MUSDB18) | 5.9 dB | 9.0 dB (مع ضبط دقيق) |
| السرعة | سريع جدا ويعمل جيدا على CPU | أبطأ، والأفضل استخدام GPU |
| المسارات الصوتية | 2 أو 4 أو 5 | 4 أو 6 مع الغيتار والبيانو |
| الأنسب له | معاينات سريعة، وكاريوكي، ومعالجة دفعات | مسارات أنظف للريمكسات والإصدارات |
إن حاولتم استخراج الغناء أو إنشاء نسخة آلية لريمكس، فمن المحتمل أنكم استخدمتم أداة تعتمد على أحدهما. أصبح النموذجان مفتوحا المصدر مرجعين لفصل المسارات الصوتية، وما زالت المقارنة بينهما توضح المفاضلة بين السرعة والتشوهات والجودة.
ما المسارات الصوتية، ولماذا يصعب فصلها؟
المسارات الصوتية المنفصلة هي مكونات الأغنية الممزوجة، وعادة ما تشمل الغناء والطبول والباس وبقية الأصوات. يعمل المنتجون عليها في الاستوديو قبل أن يجمع المزيج النهائي كل شيء.
فصلها بعد المزج يشبه محاولة إعادة كعكة مخبوزة إلى مكوناتها. تشترك الآلات في النطاقات الترددية نفسها. تتداخل توافقيات الغناء مع ترددات الغيتار، وتتداخل الهجمات العابرة لطبلة الركلة مع نغمات الباس، وتنتشر ضربات الصنج عبر المجال الستيريو كله. كانت معالجة الإشارة التقليدية تترك نتائج متذبذبة مليئة بالتشوهات.
حسن التعلم العميق ذلك بتدريب الشبكات العصبية على التعرف على أنماط لم تلتقطها المعالجة التقليدية للإشارة. أصبح Spleeter وDemucs النموذجين المرجعيين، لكنهما يتبعان نهجين مختلفين جدا.
التاريخ: Spleeter وDemucs وصلتهما بباريس
Spleeter: أقنعة طيفية سريعة من Deezer
في نوفمبر 2019، أطلقت خدمة البث الفرنسية Deezer أداة Spleeter مجانا وبمصدر مفتوح. بناها الفريق بقيادة Romain Hennequin باستخدام TensorFlow، حول شبكة عصبية التفافية من نوع U-Net تعمل على مخططات طيفية للسعة، أي تمثيلات الصوت في الزمن والتردد.
يتعامل Spleeter مع الفصل كما لو كان تجزئة صورة. يتنبأ بقناع ناعم لكل خانة زمنية ترددية، ويقدر مقدار ما ينتمي منها إلى الغناء أو الطبول أو الباس أو بقية الأصوات. تحسن خطوة اختيارية من ترشيح Wiener هذه الأقنعة، ثم يعاد بناء المسارات باستخدام طور المزيج الأصلي.
قوة Spleeter هي السرعة. يفصل مقطعا مدته أربع دقائق في ثوانٍ، ويصل على GPU إلى سرعة تعادل 100 ضعف الزمن الحقيقي، كما يعمل بسهولة على معالجات CPU متواضعة. يوفر إعدادات لمسارين (الغناء والمرافقة) أو 4 أو 5 مسارات. أصبح أساسا للمقارنة في الأبحاث وشغل عددا كبيرا من قنوات الريمكس على YouTube.
Demucs: الفصل في مجال الموجة الصوتية من Meta
بينما ركز Spleeter على السرعة، ركزت Meta AI Research، التي كانت آنذاك Facebook AI Research، على الجودة. قدم Alexandre Défossez، وهو فرنسي أيضا، وفريقه Demucs في 2019، اختصارا لـDeep Extractor for MUlti-Channel Sources، أي المستخرج العميق للمصادر متعددة القنوات، بنهج مختلف جدا.
بدلا من المخططات الطيفية، يعمل Demucs مباشرة على الموجات الصوتية الخام ويتعامل مع الفصل كمشكلة إعادة بناء في المجال الزمني. تجمع بنيته مرمزا ومفكك ترميز التفافيين على نمط U-Net، مستوحى من Wave-U-Net، مع عنق زجاجة من نوع LSTM ثنائي الاتجاه. يتيح ذلك للشبكة التقاط البنية الموسيقية طويلة المدى والحفاظ على اتساق الطور.
تطور Demucs عبر أربعة إصدارات رئيسية:
- v1 (2019): نهج موجي خالص نافس بالفعل الطرق الطيفية
- v2 (2020): تحسين التدريب والكفاءة
- v3 "Hybrid Demucs" (2021): أضاف فرعا طيفيا وفاز بتحدي Music Demixing Challenge، مع SDR يبلغ 7.7 dB على MUSDB18
- v4 "Hybrid Transformer Demucs" (2022): استبدل الطبقات الداخلية بـTransformer يعمل بين المجالين، فبلغ SDR مقدار 9.0 dB مع الضبط الدقيق وحتى 9.2 dB في أفضل إعداد في الورقة
تحدي Sound Demixing Challenge وبداية جديدة
غير تحدي Sound Demixing Challenge 2023 موضع التركيز. نظمته Meta وSony وجهات أخرى، وقدم فصل مصادر موسيقية متينا: تدريب النماذج على بيانات ذات تسميات مشوشة وتسرب بين المسارات. كان Alexandre Défossez من المنظمين الرئيسيين وساهم في تصميم التحدي والنماذج المرجعية.
كانت النتيجة الرئيسية أن زيادة بيانات التدريب لا تضمن نتائج أفضل؛ جودة البيانات واستراتيجيات المتانة أهم. حسنت تقنيات مثل اقتطاع الخسارة والتنقيح التكراري SDR بمقدار 0.89 dB على البيانات المشوشة.
بعد ذلك بوقت قصير، غادر Défossez شركة Meta ليشارك في تأسيس Kyutai، مختبر فرنسي لأبحاث الذكاء الاصطناعي. ما زال مستودع Demucs متاحا، لكن README يذكر أنه لم يعد يعمل عليه بنشاط، فلا تتوقعوا ميزات جديدة.
الأداء: المفاضلة بين السرعة والجودة
فلسفة البنية
يضع Spleeter أقنعة على المخططات الطيفية، ويعيد Demucs بناء الموجات الصوتية. يحكم هذا الاختلاف الأساسي بقية الجوانب.
نهج Spleeter في المجال الترددي كفؤ لأن كل إطار STFT يلخص آلاف العينات، فتعمل الالتفافات على خطوات زمنية أقل بكثير. المقابل هو أن النموذج لا يتعلم الطور، بل يعيد استخدام طور المزيج، وأن الدقة الثابتة في الزمن والتردد لـSTFT لا تمثل جيدا الهجمات العابرة الحادة والنغمات المستقرة معا.
يتعلم نهج Demucs الزمني بنوك مرشحاته بنفسه من خلال التفافات أحادية البعد. يحافظ على الطور ويتعامل مع الهجمات العابرة بدقة العينة. في v4، تحتفظ طبقات Transformer بالسياق عبر ثوانٍ من الصوت، مما يقلل تشوهات «التنقل ذهابا وإيابا» الشائعة في الطرق القائمة على الإطارات.
Hybrid Demucs v3: فرعا الشكل الموجي والمخطط الطيفي
وصلات تجاوز بين المرمّز ومفكّك الترميز
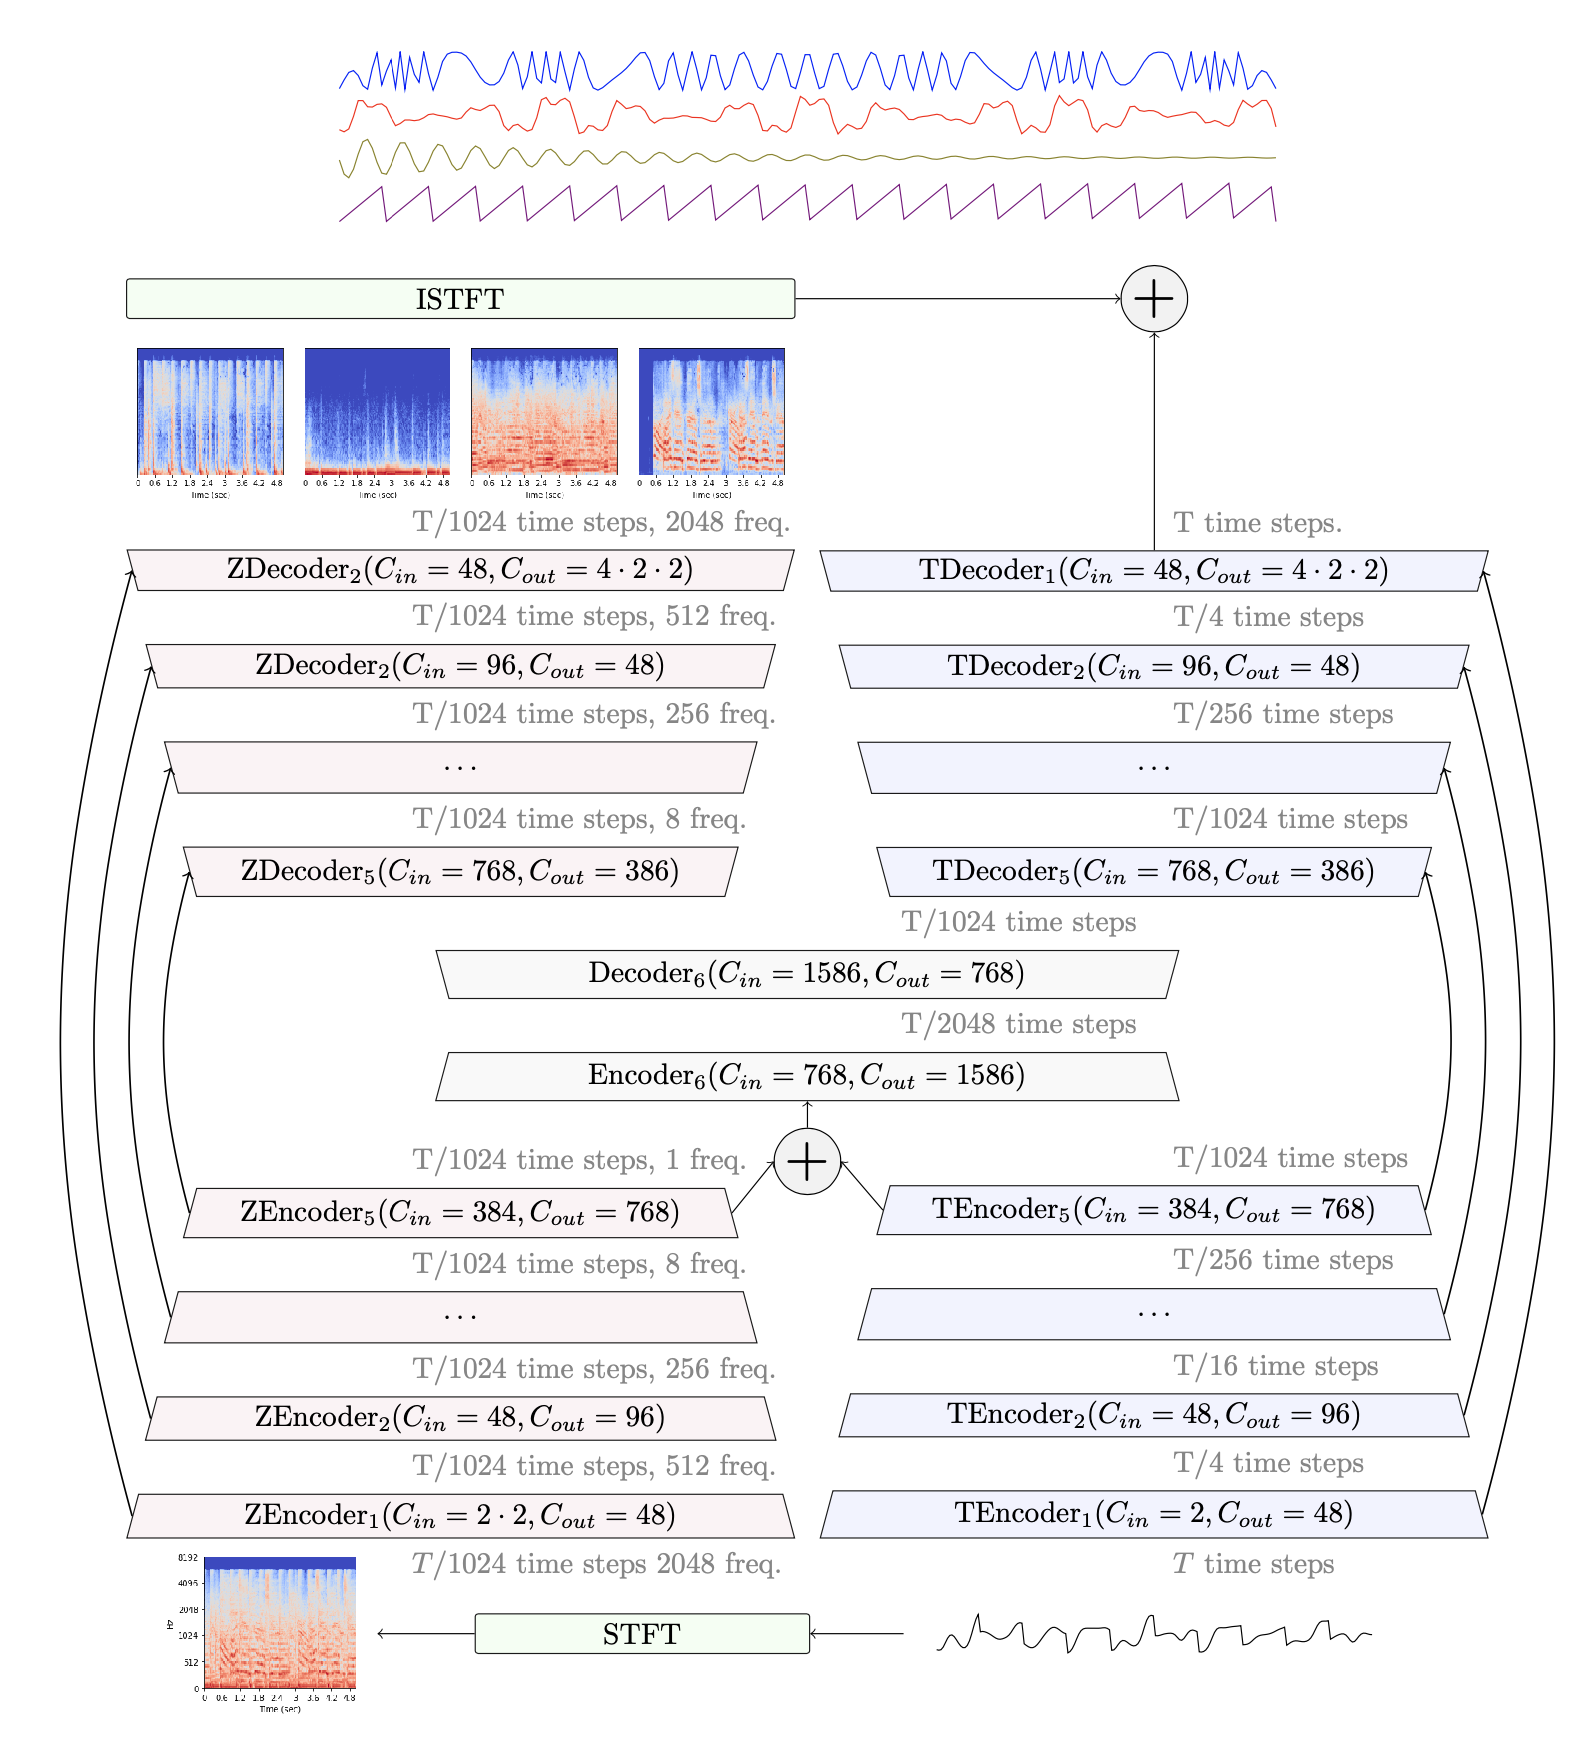
الشكل الأصلي: دليل تمهيدي لفصل المصادر، الشكل 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
أرقام المقارنة المعيارية بين Spleeter وDemucs
تأتي هذه الدرجات على مجموعة اختبار MUSDB18 من مستودع Demucs الرسمي على GitHub:
| النموذج | المجال | بيانات تدريب إضافية | SDR الإجمالي | جودة MOS |
|---|---|---|---|---|
| Spleeter | طيفي | 25 ألف أغنية | 5.9 dB | غير متاحة |
| Demucs v2 | موجي | لا توجد (MUSDB18 فقط) | 6.3 dB | 2.37 |
| Hybrid Demucs v3 | هجين | لا توجد (MUSDB18 فقط) | 7.7 dB | 2.83 |
| HT Demucs مع ضبط دقيق v4 | هجين | 800 أغنية | 9.0 dB | غير متاحة |
تقيس نسبة الإشارة إلى التشوه (SDR) مدى نظافة فصل مصدر عن المزيج. الدرجة الأعلى أفضل، لكن SDR لا يغني عن اختبار الاستماع. لمعرفة ما يمكن توقعه عمليا من مسارات الذكاء الاصطناعي، راجعوا مدى جودة فصل المسارات بالذكاء الاصطناعي اليوم. فارق 3 dB تقريبا بين Spleeter وDemucs v4 كبير في المقاييس المعيارية، ويسجل Demucs درجات أعلى في كل مسار، خاصة الطبول والغناء.
يمكنكم سماع الفرق في فيديو المقارنة أدناه. تبدو مسارات Demucs أكثر طبيعية وبها تشوهات أقل، بينما قد ينتج Spleeter رنينا معدنياً مع المواد المعقدة.

آثار الأداء في الاستخدام الفعلي
السرعة: يعالج Spleeter مقطعا مدته 3 دقائق في نحو ثانيتين على GPU. يحتاج Demucs v4 إلى نحو 20 إلى 30 ثانية. على CPU، يحتاج Spleeter إلى نحو 30 إلى 60 ثانية، وقد يحتاج Demucs إلى أكثر من 5 دقائق.
العتاد: يعمل Spleeter على CPU وحده في حاسوب محمول بذاكرة RAM سعتها 8 GB. يحتاج Demucs v4 إلى GPU بذاكرة VRAM سعتها 4 إلى 8 GB لسرعة معقولة، وتستهلك طبقات Transformer ذاكرة أكبر بكثير بسبب مصفوفات الانتباه.
التشوهات: لأن Spleeter يعيد استخدام طور المزيج، قد ينتج غناء «شبحيا» وهجمات عابرة مطموسة. يبدو Demucs v4 أكثر طبيعية، لكنه قد يترك ضجيجا منخفض المستوى في المقاطع الصامتة.
المتانة: أظهر تحدي SDX'23 أن البنى المشابهة لـDemucs تتحمل بيانات التدريب الفاسدة بشكل أفضل. لا تستفيد بنية Spleeter الأبسط بسهولة من تقنيات مثل مجموعات البيانات المرشحة واقتطاع الخسارة.
Spleeter أم Demucs: أيهما تستخدمون؟
يستخدم كثير من المنتجين كليهما حسب المهمة.
متى تستخدمون Spleeter؟
استخدموا Spleeter عندما تكون السرعة مهمة: نسخ سريعة بالغناء وحده لعروض DJ، أو مسارات كاريوكي للتدريب، أو معالجة مكتبة عينات صوتية كاملة في دفعة واحدة. يصعب التفوق على سرعته التي تعادل 100 ضعف الزمن الحقيقي واحتياجاته المتواضعة للعتاد، وتكفي جودته للريمكسات التي ستعالجون فيها المسارات لاحقا.
متى تستخدمون Demucs؟
اختاروا Demucs v4 عندما لا يمكنكم قبول التشوهات: مسارات لريمكسات رسمية، أو عينات لإصدارات تجارية، أو تحليل دقيق لأداء موسيقي. التحسن بمقدار 3 dB واتساق الطور يبرران الانتظار. إن كانت موادكم من نوع موسيقي معين، أجروا ضبطا دقيقا ببيانات إضافية، لأن بنية Demucs تستفيد بصورة أفضل من البيانات النظيفة.
الجمع بين Spleeter وDemucs
شغلوا Spleeter على مكتبتكم الموسيقية كلها للعثور على المقاطع الواعدة، ثم عالجوا الاختيارات النهائية باستخدام Demucs. للأداء الحي، افصلوا المسارات مسبقا باستخدام Spleeter. للعمل في الاستوديو، استخدموا Demucs لمسارات أنظف. تجمع أدوات مثل Ultimate Vocal Remover بين Demucs ونماذج فصل أخرى خلف واجهة رسومية بسيطة.
هل تحتاجون إلى GPU؟
يعمل Spleeter جيدا على CPU، بينما تستفيد مسارات العمل عالية الجودة مع Demucs كثيرا من GPU من حيث سرعة المعالجة. لمعالجة الدفعات دون اتصال أو على حاسوب محمول، تظل النماذج المشابهة لـSpleeter مفيدة. للحصول على مسارات أنظف، تبرر نماذج Demucs والنماذج الهجينة الأحدث القائمة على Transformer عادة المعالجة السحابية أو جهازا محليا أقوى.
تحديث 2026: ما الذي يتفوق على Spleeter وDemucs؟
يبقى Spleeter وDemucs مرجعين مفيدين، لكنهما لم يعودا سقف الجودة في فصل المسارات.
يقسم BS-RoFormer (Band-Split RoPE Transformer) المخطط الطيفي إلى نطاقات ترددية ويعالجها بطبقات Transformer. تذكر ورقته متوسط SDR مقداره 9.80 dB على MUSDB18-HQ دون بيانات تدريب إضافية، أعلى من 9.0 dB التي حققها Demucs v4 المضبوط ضبطا دقيقا مع 800 أغنية إضافية. فازت نسخة مدربة بـ500 أغنية إضافية بالمركز الأول في مسار فصل الموسيقى في تحدي Sound Demixing Challenge 2023.
| النموذج | السنة | SDR الإجمالي (MUSDB18) | بيانات تدريب إضافية |
|---|---|---|---|
| Spleeter | 2019 | 5.9 dB | 25 ألف أغنية |
| HT Demucs مع ضبط دقيق (v4) | 2022 | 9.0 dB | 800 أغنية |
| BS-RoFormer | 2023 | 9.8 dB | لا توجد |
Mel-Band RoFormer قريب منه، لكنه يجمع الترددات على مقياس ميل. تشغل نقاط حفظ النموذجين التي يشاركها المجتمع الآن معظم أدوات فصل الغناء والموسيقى الآلية المتقدمة. ترتب مقارنتنا لنماذج فصل الغناء النماذج حسب أدائها على مقاطع حقيقية، وتفعل مقارنة نماذج فصل الآلات الشيء نفسه لبقية الآلات.
تستخدم أداة فصل المسارات بالذكاء الاصطناعي من Neural Analog نماذج BS-RoFormer لإعدادي 4 و6 مسارات، وSAM Audio عندما تريدون استخراج آلة لا تشملها الإعدادات، مثل الساكسوفون أو صوت رئيسي من آلة تركيب صوتي. راجعوا النماذج التي تستخدمها Neural Analog لفصل المسارات للقائمة الكاملة.
أسئلة شائعة عن Spleeter وDemucs
هل Demucs أفضل من Spleeter؟
نعم من حيث الجودة. يسجل Demucs v4 نسبة SDR أعلى بحوالي 3 dB من Spleeter في معيار MUSDB18، ويترك تشوهات أقل في الغناء والطبول. لا يكون Spleeter أفضل إلا عندما تكون السرعة أو الاعتماد على جهاز CPU فقط أهم من الجودة.
أيهما أفضل للغناء: Spleeter أم Demucs؟
Demucs. يبدو غناء Spleeter غالبا رقيقا أو «كأنه تحت الماء» لأنه يعيد استخدام طور المزيج الأصلي. للحصول على أنظف غناء وموسيقى آلية، يتفوق نموذج BS-RoFormer أو Mel-Band RoFormer عادة على كليهما.
هل ما زال Spleeter قيد الصيانة؟
ما زال Spleeter متاحا على GitHub، لكنه نموذج من 2019 مبني على TensorFlow، ويحذر README من مشكلات TensorFlow على شرائح Apple M1. انتقلت معظم الأدوات الأحدث إلى Demucs أو نماذج RoFormer.
ماذا تستخدم Ultimate Vocal Remover (UVR)؟
UVR تطبيق مجاني لسطح المكتب، وليس نموذجا واحدا. يجمع عائلات نماذج عدة، منها Demucs وMDX-Net ونماذج VR Architecture الخاصة به، لذا تعتمد جودته على النموذج الذي تختارونه.
هل يمكنكم استخدام Demucs دون GPU؟
نعم، لكنه بطيء. توقعوا عدة دقائق لكل أغنية على CPU. تشغل أداة فصل المسارات عبر الإنترنت النموذج على GPU في الخادم بدلا من ذلك. يوضح دليل الاستوديو لفصل المسارات الخطوات.
أدلة مرتبطة
- إزالة الطبول من أغنية Suno: استخدام عملي لفصل مسار الطبول.
- استبدال طبول الذكاء الاصطناعي بمجموعة الطبول الخاصة بكم: افصلوا الطبول، ثم ابنوا إيقاعا جديدا حول الغناء.
- ترميم مسارات MP3 إلى جودة WAV: أعيدوا بناء الترددات العالية التي يفقدها الضغط والفصل.
- تحويل أغنية ستيريو إلى Dolby Atmos: ضعوا المسارات المنفصلة في مزيج Atmos.
- تثبيت AudioSR وتشغيله من GitHub: نموذج صوتي آخر مفتوح المصدر يمكن تشغيله محليا، مع إعداد Python وPyTorch.