كيفية تحسين ملفات MP3 المضغوطة بفقدان البيانات إلى WAV عالي الجودة
لتحسين MP3 إلى WAV مع زيادة حقيقية في الجودة، تحتاجون إلى الترميم بالذكاء الاصطناعي، لا إلى محوّل صيغ. تحويل MP3 إلى WAV يكبّر الملف لكنه يترك الصوت كما هو تماما، لأن ضغط MP3 يحذف معلومات صوتية نهائيا لتوفير المساحة. الأدوات التقليدية لا تستطيع عكس ذلك.
يستطيع الترميم بالذكاء الاصطناعي إعادة بناء جزء مما فُقد. تعيد الخدمات المسرّعة بوحدات GPU، مثل Neural Analog، بناء الترددات العالية المفقودة، وتزيل تشوهات الضغط، وتستعيد التفاصيل التوافقية بدلا من إعادة تغليف البيانات نفسها. إنه الفرق بين تكبير صورة متكسرة البكسلات واستخدام الذكاء الاصطناعي لملء التفاصيل المفقودة.
يشرح هذا الدليل لماذا لا يكفي التحويل البسيط، وكيف يعمل الترميم العصبي، ومتى يحسن موسيقاكم فعليا. لتجربته على ملفكم، افتحوا أداة تحسين صوت MP3 إلى WAV.
لماذا لا يحسن تحويل MP3 إلى WAV جودة الصوت
يتخلص ضغط MP3 مما يتوقع المرمّز أنكم لن تلاحظوه. يحذف التفاصيل التي تخفيها أصوات أخرى، ويضيف ضجيج التكميم، ويطبق مرشح تمرير منخفض يعتمد تردد قطعه على معدل البت. ملف MP3 بمعدل 128 kbps يقطع عادة كل ما فوق 16 kHz. وحتى MP3 بمعدل 320 kbps قد يقطع الترددات فوق 20.5 kHz، حسب إعدادات المرمّز. النتيجة هي فقدان التفاصيل التوافقية وإضافة تشوهات.
عند تحويل MP3 إلى WAV في Audacity أو iTunes، يُفك ترميز MP3 إلى PCM غير مضغوط فحسب. إذا رفعتم معدل أخذ العينات أيضا، فإن أداة إعادة أخذ العينات تستوفي بين العينات الموجودة. لا تضيف أي من الخطوتين تفاصيل ولا تستعيد ما حذفه المرمّز. يظهر المخطط الطيفي النطاق الفارغ نفسه في الترددات العالية، لكن داخل ملف أكبر.
لهذا يحتفظ المحترفون بماسترات دون فقدان بيانات. بعد مرور الصوت بمرمّز ذي فقدان، لا يستطيع التحويل البسيط استعادته.
متى يكفي تحويل MP3 إلى WAV ببساطة
إذا كنتم تحتاجون إلى WAV فقط لأن DAW أو محرر الفيديو أو جهة التوزيع تطلبه، فالتحويل البسيط مناسب. يحافظ على الصوت كما هو ويتجنب إضافة ضغط عند التحرير والتصدير مجددا. مع FFmpeg، يكفي أمر واحد:
ffmpeg -i input.mp3 output.wavاستخدموا الترميم بالذكاء الاصطناعي حين تريدون صوتا أفضل، لا لمجرد تغيير الصيغة.
كيف تفحصون MP3 لمعرفة إن كانت الترددات العالية مفقودة
افتحوا الملف في أداة المخطط الطيفي المجانية عبر الإنترنت. غالبا ما يظهر MP3 المضغوط بفقدان البيانات خطا أفقيا حادا عند توقف الترددات العالية، ويكون عادة قرب 16 kHz في ملف 128 kbps. إذا كان الطيف فوق الخط مظلما، فهناك محتوى يمكن للترميم إعادة بنائه.
مواصفات جودة الصوت التي تهم فعلا
تشرح هذه المواصفات ما يحدد جودة الصوت، ولماذا تبدو الملفات المرممة أفضل.
معدل أخذ العينات: 44.1 kHz مقابل 48 kHz
44.1 kHz، أي 44,100 عينة في الثانية، هو معيار CD. يمكنه تمثيل ترددات حتى 22.05 kHz، فوق حد السمع البشري البالغ نحو 20 kHz. يُستخدم 48 kHz كثيرا في إنتاج الفيديو ويوفر هامشا إضافيا بسيطا.
تستخدم معظم خدمات بث الموسيقى 44.1 kHz، عادة مع ضغط ذي فقدان فوق ذلك. عند تحسين MP3، يعيد الترميم بناء التفاصيل الترددية المفقودة ويصدّر ملفا مناسبا للإنتاج. حسب النموذج المختار، يحافظ Neural Analog على مصادر 44.1 kHz عند 44.1 kHz، أو ينشئ مخرجات فائقة الدقة بمعدل 48 kHz. لمثال تطبيقي، راجعوا ترميم 203 مؤثرات صوتية من RPG Maker 2000 من 22.05 kHz إلى 48 kHz باستخدام UniverSR.
عمق البت: WAV بعمق 16 بت مقابل 24 بت
يحدد عمق البت النطاق الديناميكي: الفرق بين أخفت الأصوات وأعلاها التي يستطيع الملف احتواءها.
- 16 بت: نطاق ديناميكي 96 dB. مناسب للتوزيع النهائي، مثل CD والبث.
- 24 بت: نطاق ديناميكي نظري 144 dB. مفضل للإنتاج والمزج والترميم.
في ملف 16 بت، تكون المقاطع الهادئة أقرب إلى أرضية ضجيج التكميم، لذا فإن رفعها لاحقا يرفع الضجيج أيضا. يوفر 24 بت هامشا لتغيير المستويات أثناء المعالجة دون إضافة ضجيج مسموع.
لماذا تهم الترددات العالية حتى 20 kHz
تعيد معظم الأجهزة الصوتية إنتاج الصوت من 20 Hz إلى 20 kHz، وهو النطاق الذي يستطيع الشباب سماعه. مع التقدم في السن والتعرض لبيئات صاخبة، مثل السيارات والآلات والحفلات والموسيقى العالية في المطاعم، ينخفض الحد الأعلى عادة إلى 16 إلى 18 kHz.
جرّبوا اختبار السمع المجاني عبر الإنترنت لفحص أي من هذه الترددات تستطيعون سماعها.
ولا يدرك البشر جميع الترددات بالجهارة نفسها. عند مستوى الإشارة نفسه، تبدو الترددات القريبة من نطاق الصوت البشري أعلى من الترددات شديدة الانخفاض أو الارتفاع.
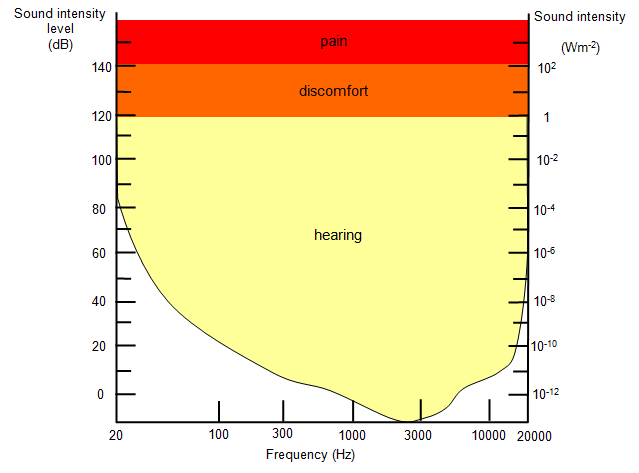
يظل المحتوى عالي التردد مهما حتى إن لم تستطيعوا سماع نغمة صافية فوق 15 kHz. فهو يشكل الإحساس المكاني والاستجابة العابرة: تقع الصنوج ولمعة الأوتار والإحساس بالاتساع في الغناء ضمن هذا النطاق. كما يغير طريقة استجابة الضواغط ومحددات المستوى وEQ والارتداد للإشارة.
يزيل MP3 الكثير من هذا النطاق، خصوصا عند معدلات البت المنخفضة. تعيد استعادة الطيف بناء هذه الترددات من أنماط متعلّمة. حتى إن لم تسمعوا نغمة صافية بتردد 18 kHz، يمكنكم إدراك الاتساع والمساحة اللذين أعادهما الترميم، ولهذا تبدو الأغاني المرممة أوسع وأكثر انفتاحا.
لماذا تبدو الموسيقى المبثوثة وموسيقى الذكاء الاصطناعي مضغوطة
يبث Spotify وApple Music وYouTube صوتا مضغوطا بفقدان البيانات لمعظم المستمعين. حتى إعدادات الجودة العالية ذات الفقدان تحذف بيانات. كثيرا ما تصدّر مولدات موسيقى الذكاء الاصطناعي مثل Suno ملفات MP3 محدودة النطاق الترددي، ويرجع ذلك جزئيا إلى تدريب نماذجها على صوت مضغوط. لم يعد Udio يوفر التنزيل؛ احفظوا تسجيلا بدلا من ذلك.
يضع ذلك سقفا للجودة: قد تبدو أغنية ممتازة مكتومة رغم ذلك. يرفع تحسين الجودة هذا السقف باستعادة النطاق الترددي المفقود.
كيف يعمل ترميم الصوت بالذكاء الاصطناعي؟
إليكم شرحا مبسطا لطريقة عمل نموذج الترميم في Neural Analog.
تعلّم الخصائص الإحصائية للإشارة
يتدرب النموذج على ملايين أزواج الأغاني: ماسترات استوديو نقية ونسخها بصيغة MP3. يتعلم ما يدمره الضغط وما يميز الموسيقى الطبيعية. مثلا، ينتج عزف أوتار الغيتار توافقات محددة، وللغناء رنينات صوتية يمكن توقعها، وتحتاج الطبول إلى اتساق الطور.
إعادة البناء بتقسيم النطاقات
يُقسم الطيف إلى نطاقات فرعية. تُحفظ الترددات المنخفضة إلى حد كبير لأن الضغط نادرا ما يضرها، بينما يعاد بناء النطاقات الوسطى والعالية باستخدام البنية التوافقية المتعلّمة. يبقي ذلك الترددات المنخفضة السليمة دون تغيير ويركز العمل على النطاق المتضرر.
الاتساق في المجال الزمني
يحافظ النموذج على اتساق الطور في التفاصيل الجديدة: تتوافق الترددات العالية المضافة مع توقيت الموجة الأصلية. يتجنب ذلك تأثير الفلانجر وطمس الصوت، فتبدو النتيجة طبيعية بدلا من أن تبدو معالجة.
التحسين من أجل الإدراك السمعي
تُقيّم مخرجات النموذج بمقاييس جودة موضوعية واختبارات استماع بشرية. الهدف هو الأمانة الموسيقية، وليس الدقة التقنية وحدها: ترددات عالية أوضح، وأصوات عابرة أكثر إحكاما، ومشهد صوتي أوسع.
قبل وبعد: أمثلة على ترميم MP3
تنتج مولدات موسيقى ذكاء اصطناعي كثيرة ملفات MP3 تنقطع عند نحو 16 kHz لأن بيانات تدريبها مضغوطة. تبدو جيدة، لكنها تفتقر إلى تفاصيل الترددات العالية في الماستر الاحترافي.
يرممها Neural Analog إلى WAV بترددات مستعادة حتى 20 kHz. يظهر الفرق بوضوح أكبر في الترددات العالية والمقاطع الخالية من الطبول. استمعوا إلى الصنوج وذيول الارتداد والزقزقات الرقمية.
استعادة الترددات العالية المفقودة
كثيرا ما تفتقر الموسيقى منخفضة معدل أخذ العينات والتسجيلات القديمة والأغاني المولدة بالذكاء الاصطناعي إلى الترددات العالية. يعيد Neural Analog بناءها.
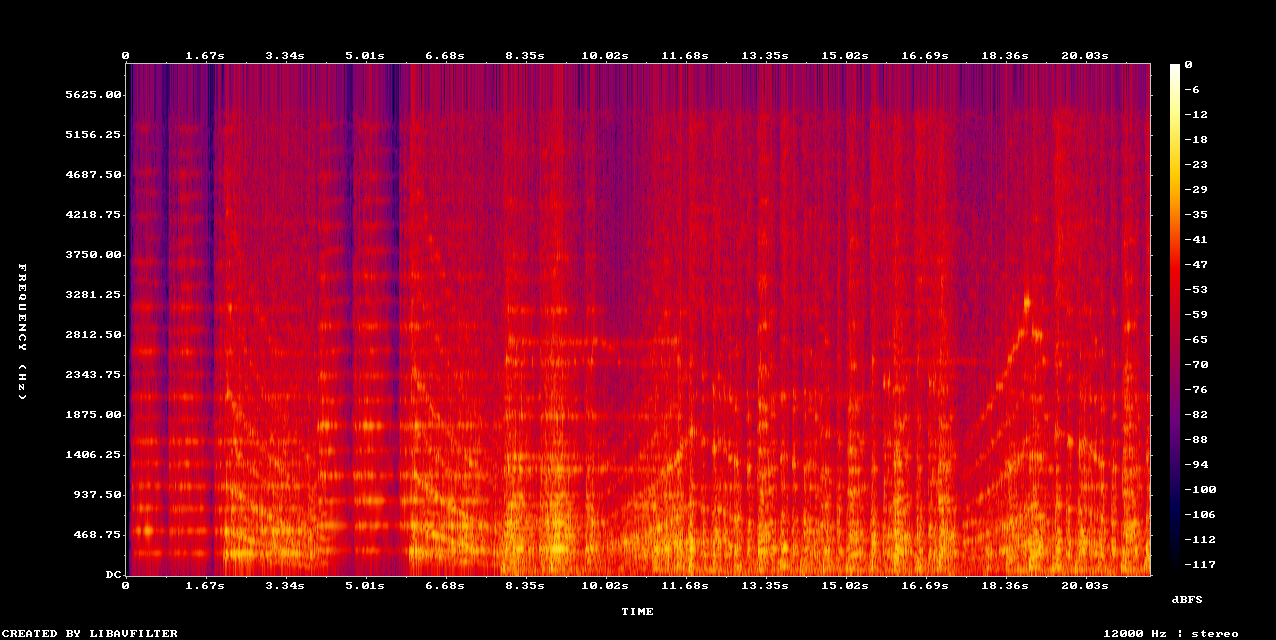
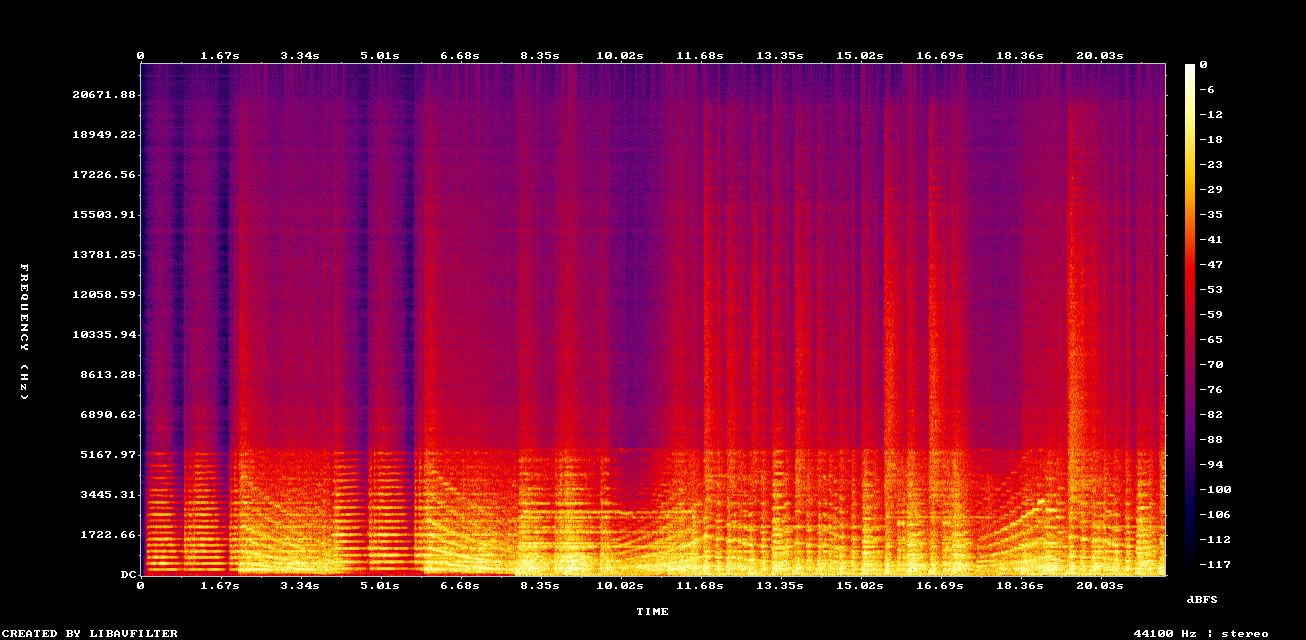
مثال: Music Upscaler على تسجيل MP3 منخفض الجودة
إزالة قص القمم من التسجيلات الرديئة
يحدث قص القمم حين تتجاوز الإشارة أقصى مستوى يستطيع الملف تخزينه، فتتسطح قمم الموجة. يزيل Neural Analog تشوهات قص القمم مع الحفاظ على ارتفاع صوت الأغنية.
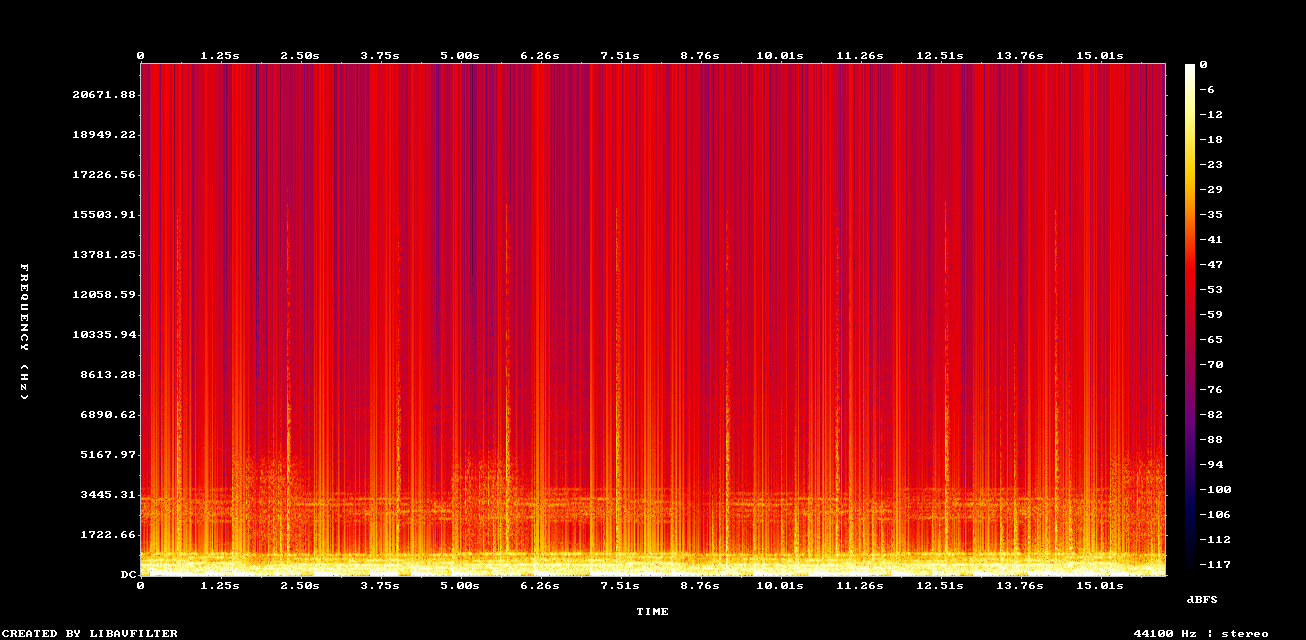
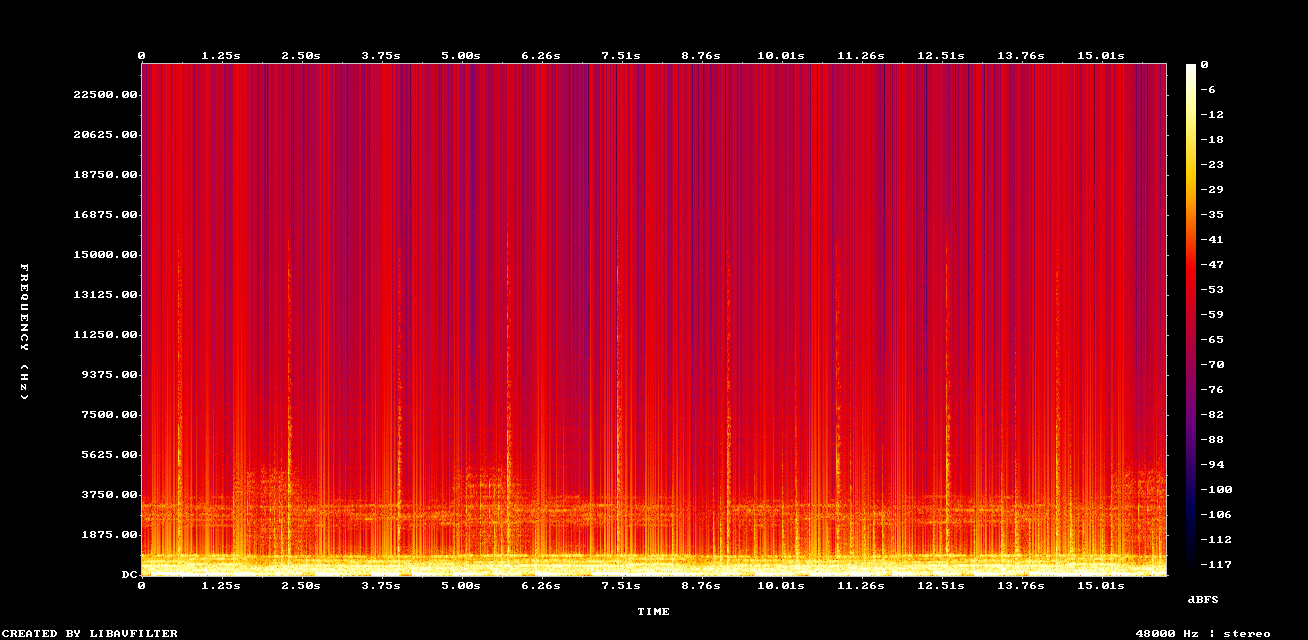
مثال: تحسين ملف MP3 قديم باستخدام Remove Clipping + DACVAE
تحسين جودة الكلام باللغة الإنجليزية
يحسن نموذج NovaSR جودة مسارات الصوت البشري والغناء والكلام.
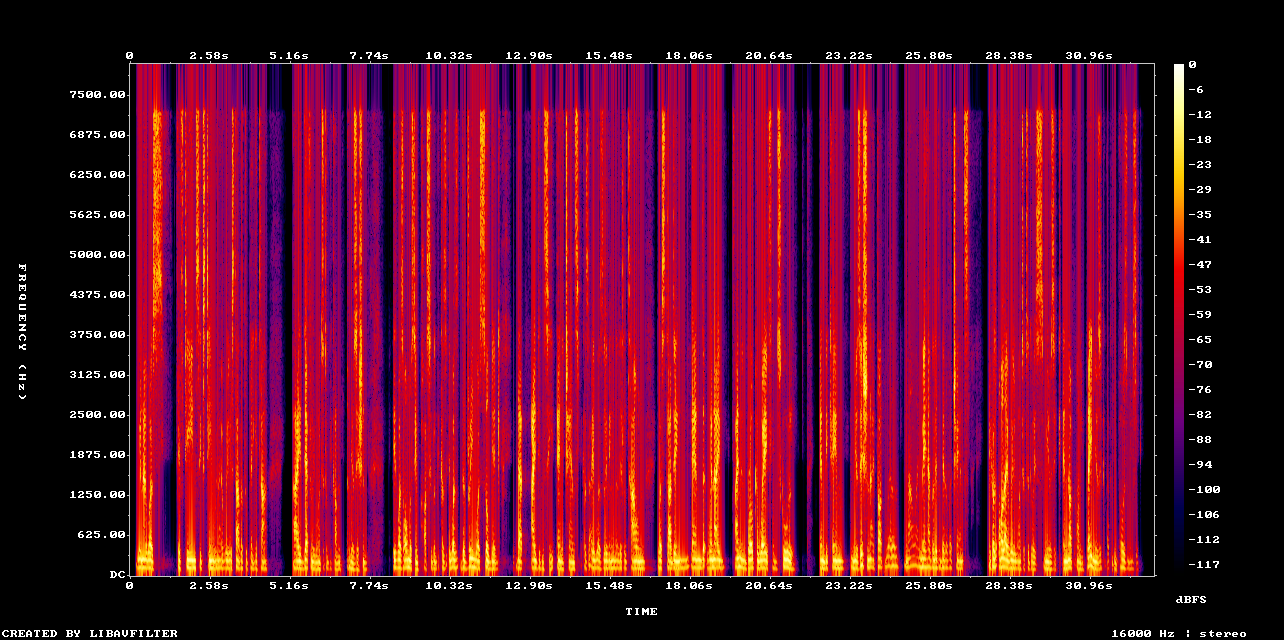
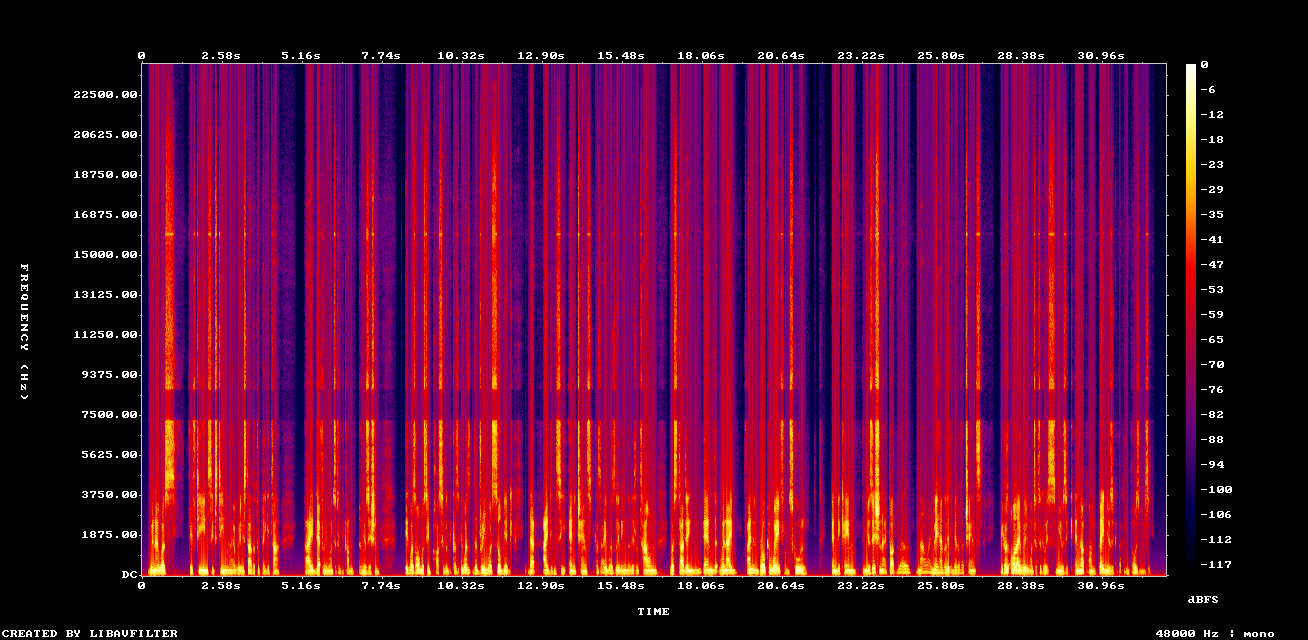
مثال: كلام محسن باستخدام NovaSR (أحادي)
متى ينبغي تحسين صوت MP3؟
تحسين جودة موسيقى الذكاء الاصطناعي
إذا استخدمتم Suno أو Udio أو FlowMusic / Producer.ai أو مولدا آخر للموسيقى بالذكاء الاصطناعي، فقد تبدؤون بصوت مضغوط. حسّنوا الجودة مباشرة بعد التوليد حين يبدو المصدر محدود النطاق أو مليئا بالتشوهات، كي تمزجوا انطلاقا من مادة أفضل. لأغاني Suno، يغطي تحسين جودة صوت Suno AI سير العمل الكامل للترميم وفصل المسارات والماسترينغ، ويشرح إصلاح جودة أغاني الذكاء الاصطناعي مسارا بمسار نموذج الترميم المناسب للغناء والطبول والباص.
تحسين تنزيلات MP3 من متاجر الموسيقى إلى WAV
تبيع Beatport وBandcamp ومتاجر أخرى ملفات MP3 أحيانا لأسباب تتعلق بالترخيص. حسّنوها إلى WAV قبل استخراج العينات أو إعادة المزج أو الأرشفة، كما يوضح شرح سبب تحسين عينات MP3 قبل استخدامها في أغنية.
استعادة الترددات العالية لإعادة الماسترينغ
تمتلئ مكتبات MP3 القديمة من سنوات 2000 بملفات 128 kbps. رمموها للتشغيل على أنظمة عالية المستوى. يظهر الفرق بوضوح في سماعات رأس جيدة أو سماعات الاستوديو المرجعية.
إعداد الصوت للماسترينغ
لا تجروا الماسترينغ مباشرة لملف MP3. رمموه أولا، لأن الماسترينغ يعمل أفضل مع صوت كامل الطيف (هل يمكن إجراء الماسترينغ لملفات MP3؟). ثم اختاروا جهارة مستهدفة بمساعدة دليل LUFS لماسترينغ موسيقى الذكاء الاصطناعي.
تحسين MP3 إلى WAV باستخدام Neural Analog في ثلاث خطوات
لا تحتاجون إلى تثبيت Python أو إدارة تعريفات GPU أو تنزيل نماذج بحجم عدة GB. إن أردتم تشغيل نموذج على جهازكم، فاتبعوا دليل تثبيت AudioSR من GitHub. يغطي دليل البدء بتحسين الصوت الخطوات نفسها داخل الاستوديو.
الخطوة 1: استيراد الصوت ارفعوا MP3 أو الصقوا رابطا من Suno أو YouTube أو FlowMusic أو TopMediaAI أو مصدر آخر مدعوم.
الخطوة 2: إعادة البناء العصبية افتحوا تحسين، واختاروا ترميم موسيقى MP3، ثم انقروا بدء تشغيل النموذج. يعالج Neural Analog صوتكم بالذكاء الاصطناعي التوليدي. غالبا ما تنتهي المهام القصيرة خلال دقائق قليلة، أما الملفات الأطول والنماذج الأثقل فتستغرق وقتا أطول.
الخطوة 3: تنزيل WAV حددوا النتيجة المرممة، وانقروا تصدير، واختاروا WAV أو FLAC أو MP3. نزّلوا الملف، ثم استوردوه إلى DAW واعملوا انطلاقا من النسخة الأعلى جودة. يشرح دليل التصدير كل صيغة وخيار تنزيل.
لا حاجة لسطر الأوامر أو إعداد GPU محلي.
أسئلة شائعة حول تحسين MP3 إلى WAV
هل يمكن فعلا سماع الترددات المرممة فوق 16 kHz؟
نعم، حسب العمر وصحة السمع. مثلا، يستطيع كثير من المستمعين الأصغر سنا سماع نغمة 17.4 kHz المسماة Mosquitone.
جرّبوا اختبار السمع المجاني لمعرفة إن كنتم تسمعون هذه الترددات.
تؤثر هذه الترددات أيضا في الإدراك المكاني ووضوح الأصوات العابرة. حتى إن لم تسمعوا موجة جيبية صافية بتردد 18 kHz، يمكنكم إدراك الاتساع والعمق المستعادين، ولهذا يبدو الصوت عالي الدقة أكثر انفتاحا.
ما الفرق بين تحسين MP3 إلى WAV والتحويل البسيط؟
يفك التحويل البسيط ترميز MP3 فقط، ويستخدم الاستيفاء أيضا عند إعادة أخذ العينات. لا يضيف تفاصيل. يجري Neural Analog إعادة بناء توليدية، شبيهة بتحسين دقة الصور بالذكاء الاصطناعي: يتوقع المحتوى التوافقي المفقود ويضيفه.
هل يضيف النموذج ضجيجا فحسب؟
لا. بخلاف أدوات التحسين التي تضيف ضجيجا أبيض ليبدو الصوت أكثر امتلاء، يعيد الترميم العصبي بناء إشارة متسقة. يتعلم النموذج التمييز بين المحتوى الموسيقي وتشوهات الضغط، فيزيل التشوهات ويعيد بناء الموسيقى. تظهر هذه البنية في المخططات الطيفية المعاد بناؤها.
هل يستطيع الترميم إصلاح أغنيتي ذات المزج الرديء؟
يزيل الترميم التشوهات ويوسع النطاق الترددي. يمكنه إصلاح بعض أضرار قص القمم أو الضغط، لكنه لا يصلح توازن الارتداد أو الباص العكر أو مشكلات التوزيع الموسيقي. هذه مشكلات مزج. لمعالجتها، افصلوا الأغنية باستخدام أداة فصل المسارات بالذكاء الاصطناعي من Neural Analog، ورمموا المسارات الفردية أو أعيدوا موازنتها، ثم أجروا الماسترينغ للمزيج النهائي. يشرح فصل المسارات عالي الجودة بالذكاء الاصطناعي نموذج الفصل المناسب لكل مسار.
هل الترميم مجاني؟
يتيح Neural Analog ترميم مقتطفات صوتية قصيرة مجانا لاختبار الجودة. يستخدم الصوت الأطول رصيد دقائق المعالجة: تُستخدم الدقائق المشمولة أولا، ثم أي دقائق إضافية اشتريتموها.
هل ينبغي التحسين إلى 48 kHz أم 44.1 kHz؟
تستخدم معظم مولدات الذكاء الاصطناعي وخدمات بث الموسيقى 44.1 kHz، وهو المعدل الذي ستصدرون به عادة. يحافظ ترميم MP3 في Neural Analog على مصادر 44.1 kHz عند 44.1 kHz، بينما تنتج نماذج الدقة الفائقة 48 kHz. الفرق بين 44.1 kHz و48 kHz صغير مقارنة بالفارق بين الصوت المضغوط والصوت المرمم، لذا ركزوا على جودة الترميم بدلا من معدل أخذ العينات.
مقارنة تحسين الجودة والتحويل والماسترينغ
| الميزة | التحويل البسيط | الماسترينغ (EQ/الضغط) | ترميم Neural Analog |
|---|---|---|---|
| الطريقة | فك الترميز والاستيفاء | ضبط الترددات والديناميكيات | إعادة بناء بالذكاء الاصطناعي التوليدي |
| توسيع النطاق الترددي | لا | لا | نعم (استعادة حتى 20 kHz) |
| إزالة التشوهات | لا | غالبا ما يزيدها سوءا | نعم (فك التكميم) |
| العملية | تغيير الصيغة أو إعادة أخذ العينات | تحسين نهائي | ترميم |
| الأنسب | تغيير الصيغة بسرعة | اللمسات النهائية | استعادة الجودة |
هل يلغي ضغط البث أثر الترميم؟
جودة Spotify العالية جدا هي Ogg Vorbis بمعدل 320 kbps، وتستخدم تدفقات Apple Music القياسية AAC بمعدل 256 kbps. كلاهما ذو فقدان. يضغط YouTube أيضا كل شيء بكثافة.
سيظل البث النهائي مضغوطا، لكن إذا رفعتم WAV مرمما، فسترمّز المنصة من صوت كامل الطيف. إعادة ترميز MP3 مضغوط أصلا تضيف جولة ثانية من التشوهات فوق الأولى.
لمنتجي الموسيقى، يكون التسلسل: ترميم → مزج → ماسترينغ → توزيع. تجاوز الترميم يشبه التصوير بعدسة متسخة: يمكنكم تصحيح الألوان لاحقا، لكن الضبابية تبقى.
كيف تحافظون على جودة الصوت المرمم بعد التحسين
يعود MP3 إلى عصر الإنترنت الهاتفي وأجهزة iPod بسعة 5 GB. مع النطاق الترددي وأدوات الذكاء الاصطناعي اليوم، لم يعد هناك سبب كبير للعمل من صوت متضرر.
مع Neural Analog، ترفعون MP3 وتنزّلون WAV بترددات مرممة حتى 20 kHz. احتفظوا بملف WAV المرمم مصدرا للمزج والماسترينغ والأرشفة والتوزيع، وتجنبوا تحويله مجددا إلى MP3 حتى مرحلة التسليم النهائية. حسّنوا أول MP3 لديكم إلى WAV.