非可逆圧縮のMP3を高音質WAVにする方法
MP3を実際に音質の良いWAVにするには、形式変換ではなくAI修復が必要です。MP3をWAVに変換するとファイルは大きくなりますが、音はまったく変わりません。MP3圧縮は容量を減らすために音声情報を永久に捨てるからです。従来のツールでは元に戻せません。
AI修復は、失われた内容の一部を再構成できます。Neural AnalogなどのGPUで高速化されたサービスは、同じデータを別の形式に詰め替えるだけでなく、欠けた高域を再構成し、圧縮アーティファクトを取り除き、倍音の細部を修復します。粗い写真を単に拡大することと、AIで欠けた細部を埋めることの違いです。
このガイドでは、単純な変換で改善しない理由、ニューラル修復の仕組み、実際に音楽が改善する場面を説明します。ご自身のファイルで試すには、MP3からWAVへのオーディオアップスケーラーを開いてください。
MP3をWAVに変換しても音質が改善しない理由
MP3圧縮は、エンコーダーが気づかれないと予測した音を捨てます。他の音に隠れた細部を除去し、量子化ノイズを加え、ビットレートによってカットオフが変わるローパスフィルターをかけます。128 kbpsのMP3は通常、16 kHzより上をすべてカットします。エンコーダーの設定によっては、320 kbpsのMP3でも20.5 kHzより上の周波数をカットすることがあります。その結果、倍音の細部が失われ、アーティファクトが加わります。
AudacityやiTunesでMP3をWAVに変換しても、MP3を非圧縮PCMにデコードするだけです。サンプルレートも上げる場合、リサンプラーは既存のサンプル間を補間します。どちらの処理も細部を追加せず、エンコーダーが消したものを取り戻しません。スペクトログラムには同じ高域の空白が残り、ファイルだけが大きくなります。
プロがロスレスのマスターを保管するのは、そのためです。一度非可逆エンコーダーを通った音声は、単なる変換では取り戻せません。
単純なMP3からWAVへの変換で十分な場合
DAW、動画編集ソフト、配信業者がWAVを求めているだけなら、単純な変換で十分です。音をそのまま保ち、再編集や書き出し時に圧縮が重なるのを避けられます。FFmpegなら、1つのコマンドで変換できます。
ffmpeg -i input.mp3 output.wav形式を変えたいだけでなく、音を良くしたいときにAI修復を使ってください。
MP3に高域が欠けているか確認する方法
無料のオンラインスペクトログラムでファイルを開いてください。非可逆圧縮のMP3には、高域が途切れる場所に鋭い水平線が現れることがよくあります。128 kbpsのファイルでは、多くの場合約16 kHzです。その線より上のスペクトルが暗ければ、修復で再構成できる部分があります。
音質に本当に関わるオーディオ仕様
これらの仕様は、音質を決める要素と、修復したファイルが良く聞こえる理由を説明します。
サンプルレート:44.1 kHzと48 kHz
44.1 kHzは毎秒44,100サンプルで、CDの標準です。人間の聴覚の上限とされる約20 kHzを超え、22.05 kHzまでの周波数を表現できます。48 kHzは動画制作でよく使われ、少し広い余裕を持たせられます。
多くの音楽配信は44.1 kHzを使い、通常はさらに非可逆圧縮を加えます。MP3をアップスケーリングすると、修復によって欠けた周波数の細部が再構成され、制作に適したファイルが書き出されます。選ぶモデルによって、Neural Analogは44.1 kHzのソースを44.1 kHzのまま保つか、48 kHzの超解像出力を生成します。実例はUniverSRでRPG Maker 2000の効果音203個を22.05 kHzから48 kHzに修復をご覧ください。
ビット深度:16ビットと24ビットのWAV
ビット深度はダイナミックレンジ、つまりファイルに収められる最も小さい音と最も大きい音の差を決めます。
- 16ビット:ダイナミックレンジは96 dB。最終配布(CD、配信)に十分です。
- 24ビット:理論上のダイナミックレンジは144 dB。制作、ミックス、修復に適しています。
16ビットのファイルでは静かな部分が量子化ノイズの底に近いため、後で音量を上げるとノイズも上がります。24ビットなら余裕があるので、処理中にレベルを変えても耳に聞こえるノイズを増やさずに済みます。
最大20 kHzの高域が重要な理由
多くのオーディオ機器は20 Hzから20 kHzまでを再生します。これは若い人が聞き取れる範囲です。加齢や、車、機械、コンサート、飲食店の大音量の音楽といった騒がしい環境への曝露により、上限は通常16〜18 kHzに下がります。
無料のオンライン聴力テストで、この範囲のどの周波数が聞こえるか確認してください。
人間は、どの周波数も同じ大きさに感じるわけではありません。同じ信号レベルなら、人の声に近い帯域は、非常に低い音や高い音より大きく聞こえます。
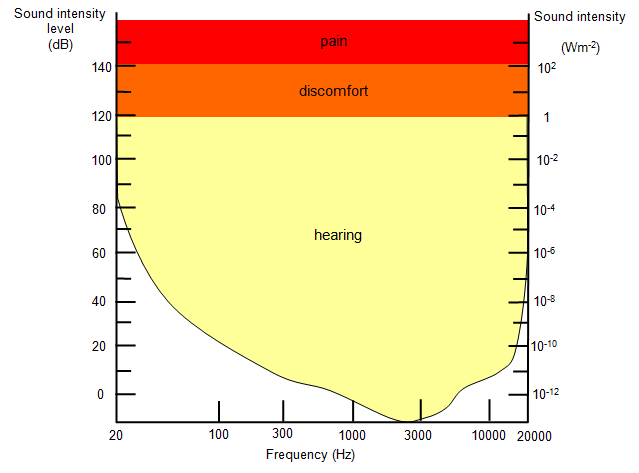
15 kHzより上の純音が聞こえなくても、高域の成分は重要です。空間の感覚とトランジェント応答を形作るからです。シンバル、弦のきらめき、ボーカルの「空気感」はこの範囲にあります。コンプレッサー、リミッター、EQ、リバーブが信号に反応する仕方も変わります。
MP3は、特に低ビットレートでこの帯域の多くを捨てます。スペクトル修復は、学習したパターンから周波数を再構成します。18 kHzの純音が聞こえなくても、修復された「空気感」や空間は感じ取れます。そのため修復後の曲は、より広く開放的に聞こえます。
配信音楽とAI音楽が圧縮された音に聞こえる理由
Spotify、Apple Music、YouTubeは、多くのリスナーに非可逆圧縮の音声を配信します。「高音質」の非可逆設定でもデータは捨てられます。SunoなどのAI音楽生成ツールは、帯域が制限されたMP3を書き出すことがよくあります。モデルが圧縮音声で学習したことも一因です。Udioはダウンロードの提供を終了したため、代わりに再生音を録音して保存してください。
これが音質の上限になります。良い曲でも、こもって聞こえることがあります。アップスケーリングは、欠けた周波数帯域を修復してその上限を引き上げます。
AIオーディオ修復の仕組み
Neural Analogの修復モデルが動く仕組みを、簡単に説明します。
信号の統計的な特徴を学習
モデルは、きれいなスタジオマスターとそのMP3版という数百万組の曲で学習します。圧縮が何を失わせるか、自然な音楽がどのようなものかを学びます。例えば、ギターのストロークは特定の倍音を生み、ボーカルには予測できるフォルマントがあり、ドラムには位相の整合性が必要です。
帯域を分けて再構成
スペクトルをサブバンドに分けます。低域は圧縮で損なわれることが少ないため、大部分を保ちます。一方、中域と高域は学習した倍音構造を使って再構成します。これにより、無傷の低域は変えず、損傷した帯域に処理を集中できます。
時間領域の整合性
モデルは、新たな細部の位相の整合性を保ちます。加えた高域を、元の波形のタイミングに合わせます。フランジングや音のにじみを避け、加工された感じではなく自然な音にします。
聴感に合わせた最適化
モデルの出力は、客観的な音質指標と人による試聴テストで評価します。目標は技術的な正確さだけでなく、音楽としての忠実さです。クリアな高域、引き締まったトランジェント、広いサウンドステージを目指します。
処理前後:MP3修復の例
多くのAI音楽生成ツールは、学習データが圧縮されていたため、約16 kHzで途切れるMP3ファイルを生成します。良い音でも、プロのマスターにある高域の細部が欠けています。
Neural Analogは、それらを高域を20 kHzまで修復したWAVに修復します。違いは高域やドラムのない部分で最も分かりやすくなります。シンバル、リバーブの余韻、デジタルのさえずるような音に注目してください。
欠けた高域を修復
低サンプルレートの音楽、古い録音、AIが生成した曲には、高域が欠けていることがよくあります。Neural Analogはそれを再構成します。
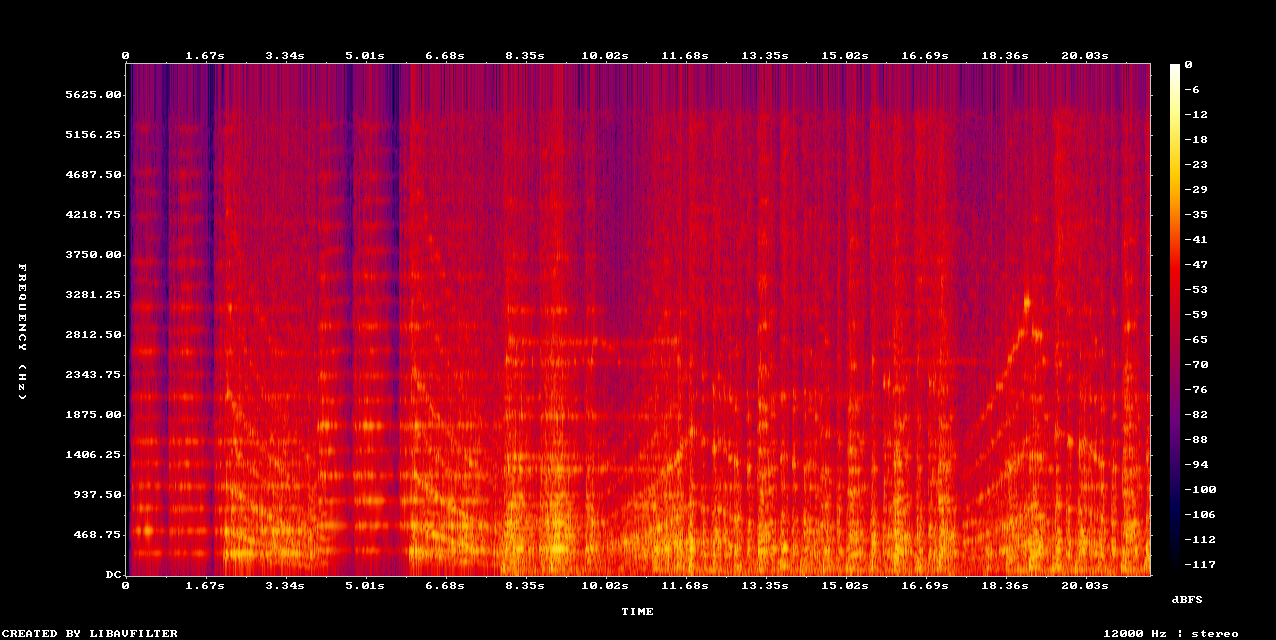
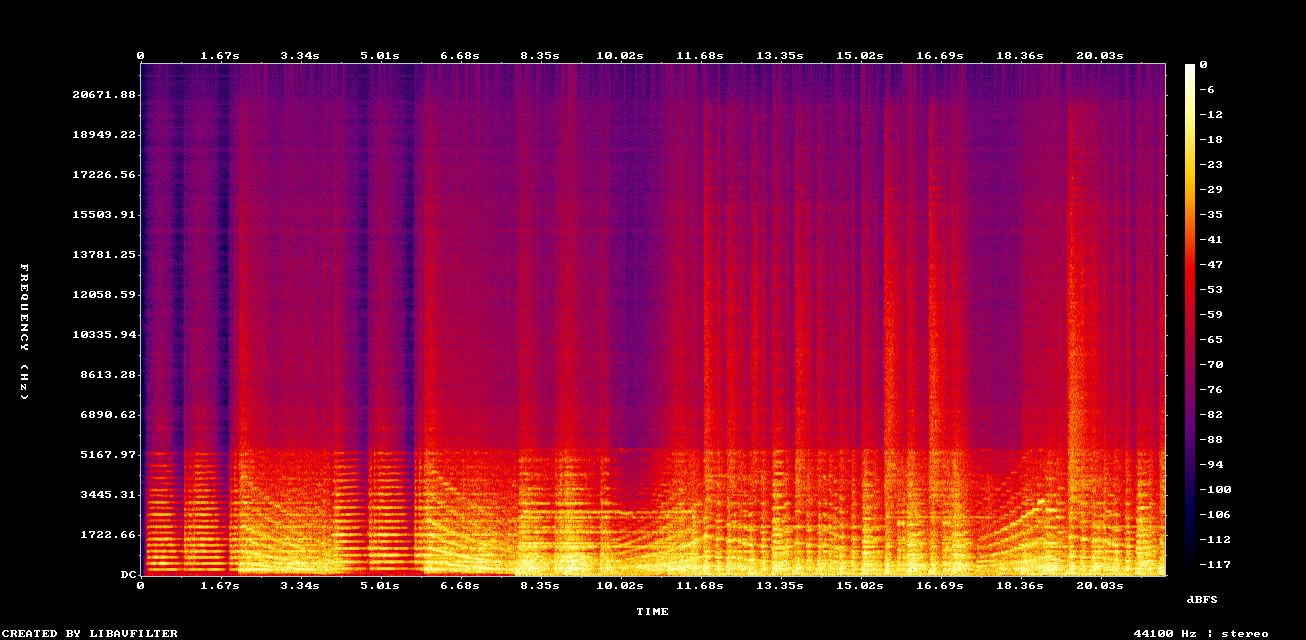
例:低音質のMP3録音にMusic Upscalerを適用
低品質な録音のクリッピングを除去
クリッピングは、信号がファイルに保存できる最大レベルを超え、波形のピークが平らになることで起こります。Neural Analogは曲の音量を保ちながら、クリッピングのアーティファクトを取り除きます。
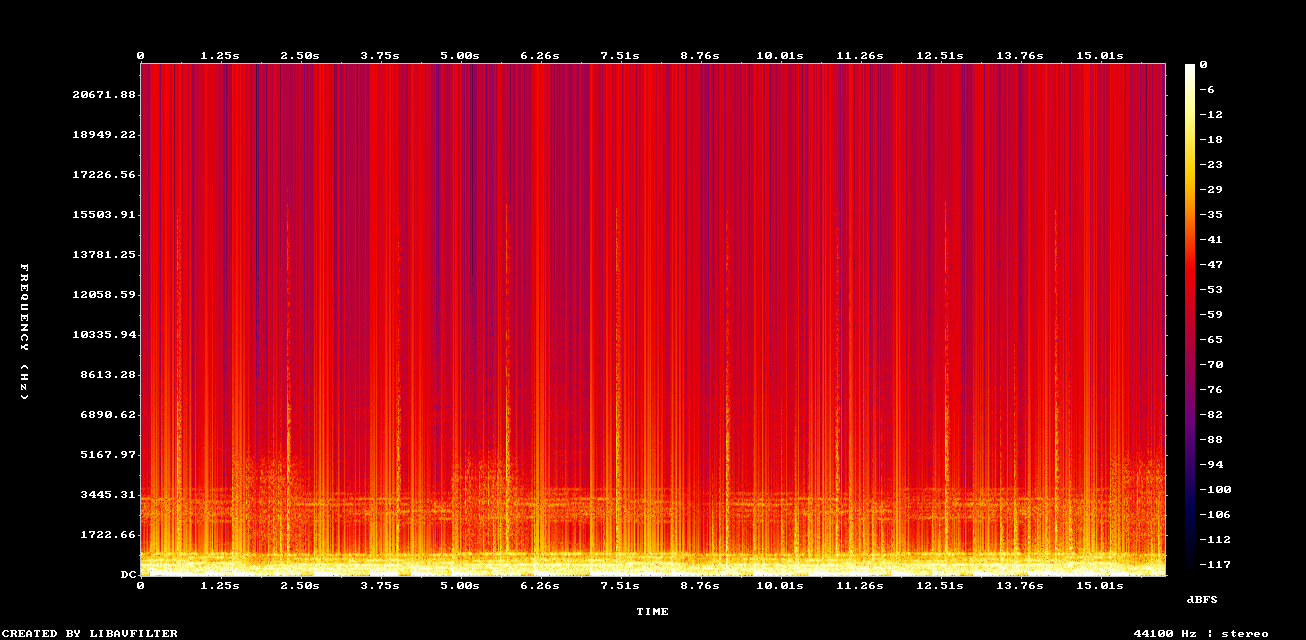
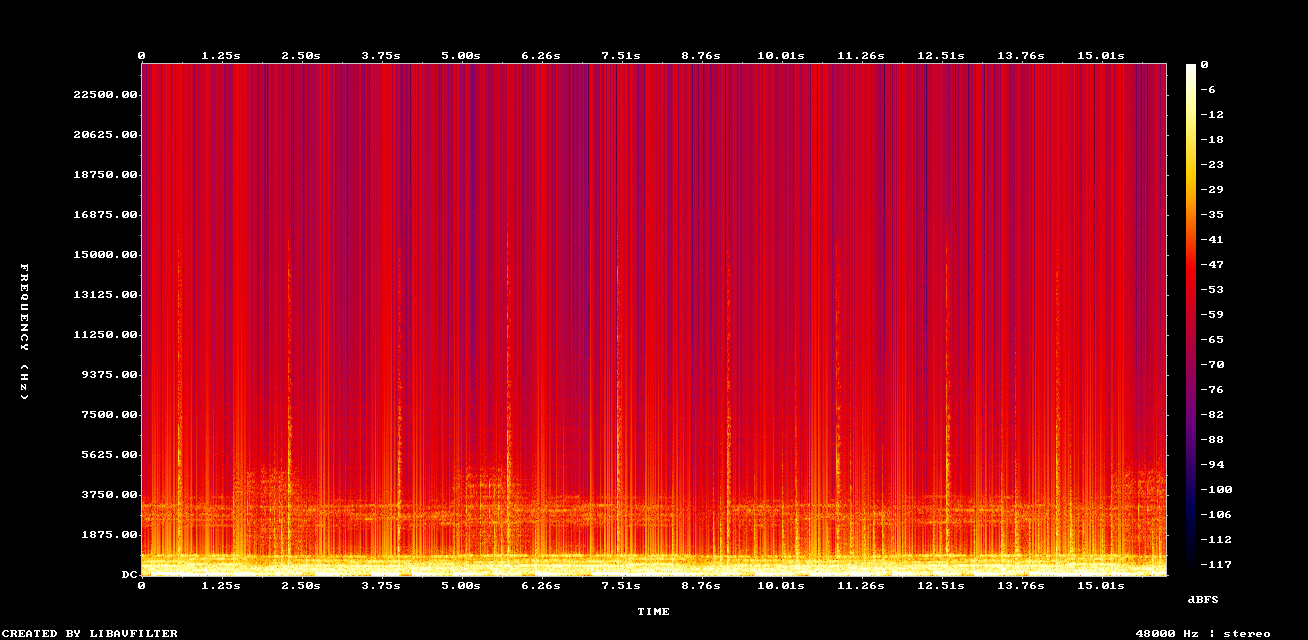
例:古いMP3ファイルをRemove Clipping + DACVAEでアップスケーリング
英語の音声を音質改善
NovaSRモデルは、ボーカルトラック、歌声、話し声をアップスケーリングします。
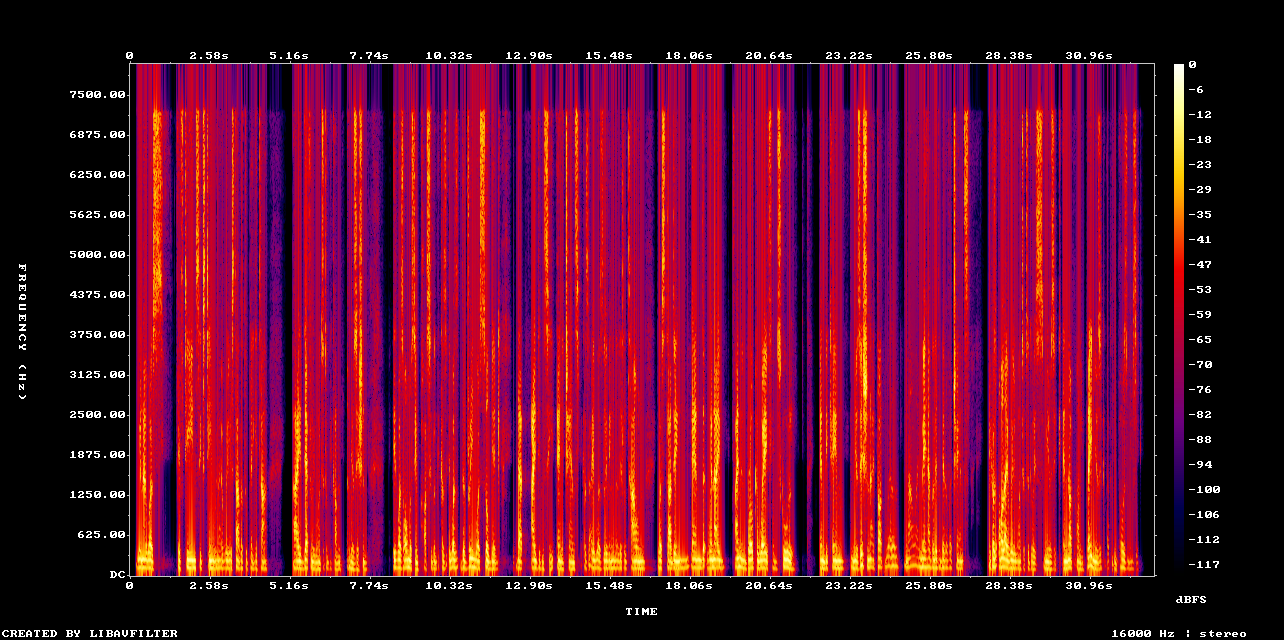
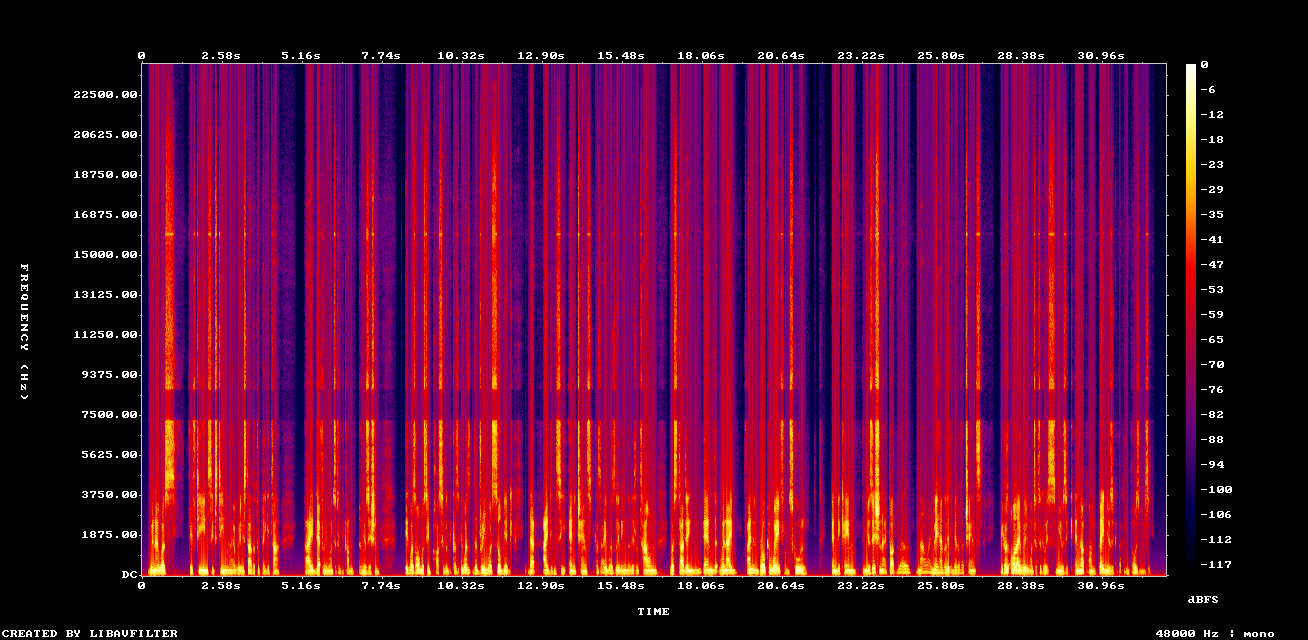
例:NovaSRで音質改善した話し声(モノラル)
MP3をアップスケーリングするのはどんなとき?
AI音楽の音質を改善
Suno、Udio、FlowMusic / Producer.aiなどのAI音楽生成ツールを使う場合、圧縮音声から作業を始めることがあります。ソースの帯域が狭かったりアーティファクトが多かったりするなら、生成直後にアップスケーリングしてください。より良い素材でミックスを始められます。Sunoの曲については、Suno AIの音質を改善する方法で修復、ステム、マスタリングの全工程を説明しています。AIの曲をステムごとに音質改善する方法では、ボーカル、ドラム、ベースに適した修復モデルを紹介します。
音楽ストアのMP3をWAVに音質改善
Beatport、Bandcampなどのストアは、ライセンスの都合でMP3を売ることがあります。サンプルの抽出、リミックス、保管の前にWAVへアップスケーリングしてください。詳しくは曲に使う前にMP3サンプルをアップスケーリングする理由をご覧ください。
リマスターに向けて高域を修復
2000年代の古いMP3ライブラリには、128 kbpsのファイルが多くあります。高級オーディオシステムでの再生に向けて修復してください。良いヘッドホンやスタジオモニターなら、違いは明確です。
マスタリング用の音声を準備
MP3をそのままマスタリングしないでください。全帯域がある音声で最も効果を発揮するため、先に修復します(MP3ファイルをマスタリングできますか?)。その後、AI音楽マスタリングのLUFSガイドで目標ラウドネスを選びます。
Neural AnalogでMP3をWAVにする3つの手順
Pythonのインストールも、GPUドライバーの管理も、数GBのモデルのダウンロードも不要です。自分のマシンでモデルを動かしたい場合は、AudioSRのGitHubインストールガイドに従ってください。音質改善の入門ガイドでも、Studioでの同じ手順を説明しています。
手順1:音声をインポート MP3をアップロードするか、Suno、YouTube、FlowMusic、TopMediaAIなど、対応するソースのリンクを貼り付けます。
手順2:ニューラル再構成 音質改善を開き、MP3音楽の修復を選んで、モデルの実行を開始をクリックします。Neural Analogが生成AIで音声を処理します。短いジョブは数分で終わることが多いですが、長いファイルや重いモデルはさらに時間がかかります。
手順3:WAVをダウンロード 修復した結果を選び、書き出しをクリックして、WAV、FLAC、MP3を選びます。ダウンロードしたファイルをDAWにインポートし、より高音質の音声で制作してください。書き出しガイドで各形式とダウンロードオプションを説明しています。
コマンドラインや手元のGPUの設定は不要です。
MP3からWAVへの音質改善に関するよくある質問
修復された16 kHzより上の周波数は本当に聞こえますか?
はい。ただし年齢や聴覚の状態によります。例えば、若いリスナーの多くは「Mosquitone」と呼ばれる17.4 kHzの音を聞き取れます。
無料の聴力テストで、これらの周波数が聞こえるか確認してください。
これらの周波数は、空間知覚やトランジェントの明瞭さにも影響します。18 kHzの純粋な正弦波が聞こえなくても、修復された「空気感」や奥行きは感じられます。高解像度の音声が開放的に感じられる理由です。
MP3からWAVへのアップスケーリングと単純な変換の違いは?
単純な変換はMP3をデコードするだけで、リサンプリングする場合は補間も行います。細部は追加されません。Neural Analogは生成による再構成を行います。AI画像のアップスケーリングに似た方法で、欠けた倍音成分を予測して補います。
モデルはノイズを加えるだけですか?
いいえ。音を「豊か」に感じさせるためにホワイトノイズを重ねる音質改善ツールとは異なり、ニューラル修復は整合性のある信号を再構成します。モデルは音楽の成分と圧縮アーティファクトを見分けるように学習し、アーティファクトを取り除いて音楽を再構成します。再構成後のスペクトログラムには、その構造が現れます。
ミックスの悪い曲を修復で直せますか?
修復はアーティファクトを取り除き、帯域を広げます。一部のクリッピングや圧縮による損傷は直せますが、リバーブのバランス、濁ったベース、アレンジの問題は直せません。それらはミックスの問題です。対処するには、Neural AnalogのAIステム分離ツールで曲を分離し、各ステムを修復するかバランスを整えてから、完成したミックスをマスタリングしてください。高品質なAIステム分離では、各ステムに使う分離モデルを説明しています。
修復は無料ですか?
Neural Analogでは、短い音声の抜粋を無料で修復して音質を試せます。長い音声には分単位の処理枠を使います。まず付与された処理枠が使われ、その後に購入した追加の処理枠が使われます。
48 kHzと44.1 kHzのどちらにアップスケーリングすべきですか?
多くのAI生成ツールや音楽配信サービスは44.1 kHzを使い、通常はそのレートでリリースします。Neural AnalogのMP3修復は44.1 kHzのソースを44.1 kHzのまま保ち、超解像モデルは48 kHzを出力します。44.1 kHzと48 kHzの差は、圧縮音声と修復音声の差に比べれば小さいため、サンプルレートより修復の品質に注目してください。
アップスケーリング、変換、マスタリングの比較
| 機能 | 単純な変換 | マスタリング(EQ/コンプレッション) | Neural Analogの修復 |
|---|---|---|---|
| 方法 | デコードと補間 | 周波数とダイナミクスの調整 | 生成AIによる再構成 |
| 帯域の拡張 | なし | なし | あり(20 kHzまで修復) |
| アーティファクトの除去 | なし | 悪化させることが多い | あり(逆量子化) |
| 処理 | 形式変更またはリサンプリング | 仕上げ | 修復 |
| 適した用途 | 手早い形式変更 | 最終仕上げ | 音質の回復 |
配信の圧縮で修復が無駄になりますか?
Spotifyの「非常に高い」音質は320 kbpsのOgg Vorbisで、Apple Musicの標準配信は256 kbpsのAACです。どちらも非可逆圧縮です。YouTubeもすべてを強く圧縮します。
最終的な配信音声も圧縮されますが、修復したWAVをアップロードすれば、サービスは全帯域の音声からエンコードできます。圧縮済みのMP3を再エンコードすると、最初のアーティファクトに次のアーティファクトが重なります。
制作の順序は、修復 → ミックス → マスタリング → 配信です。修復を飛ばすのは、汚れたレンズで撮影するようなものです。後で色調整はできても、ぼやけは残ります。
アップスケーリング後の修復した音質を保つ方法
MP3は、ダイヤルアップ接続や5 GBのiPodが使われていた時代の形式です。今の帯域幅とAIツールがあれば、劣化した音声で制作する理由はほとんどありません。
Neural AnalogにMP3をアップロードすると、最大20 kHzまで周波数を修復したWAVをダウンロードできます。そのWAVをミックス、マスタリング、保管、配信のソースとして残し、最終納品までMP3に戻さないでください。最初のMP3をWAVにアップスケーリングしてみましょう。