Spleeter или Demucs в 2026: результаты тестов и что лучше обеих моделей
Выбор между Spleeter и Demucs сводится к скорости и качеству. Demucs разделяет стемы чище: 9,0 dB SDR у дообученной Demucs v4 против 5,9 dB у Spleeter. Зато Spleeter значительно быстрее и нормально работает на скромном CPU. В 2026 году новые модели, например BS-RoFormer, показывают результаты выше обеих.
| Spleeter | Demucs v4 (HT Demucs) | |
|---|---|---|
| Разработчик | Deezer, 2019 | Meta AI Research, 2022 |
| Принцип работы | Маскирование спектрограммы (U-Net) | Ветви волновой формы и спектрограммы с Transformer |
| Качество (SDR на MUSDB18) | 5,9 dB | 9,0 dB (после дообучения) |
| Скорость | Очень высокая, хорошо работает на CPU | Медленнее, лучше с GPU |
| Стемы | 2, 4 или 5 | 4 или 6 с гитарой и фортепиано |
| Лучше подходит для | Быстрых превью, караоке, пакетной обработки | Чистых стемов для ремиксов и релизов |
Если вы пробовали выделить вокал или сделать инструментальную версию для ремикса, то, вероятно, использовали инструмент на основе одной из этих моделей. Обе модели с открытым исходным кодом стали ориентирами для разделения на стемы, и их сравнение по-прежнему показывает компромиссы между скоростью, артефактами и качеством.
Что такое стемы и почему их так трудно разделить?
Стемы — отдельные компоненты сведённой песни: обычно вокал, ударные, бас и всё остальное. Продюсеры работают с ними в студии до финального сведения, которое объединяет всё.
Разделить их после сведения — как попытаться разобрать готовый торт на исходные ингредиенты. Инструменты занимают одни и те же диапазоны частот. Гармоники вокала перекрываются с частотами гитары. Атаки бочки накладываются на басовые ноты. Удары тарелок распространяются по всему стереополю. Традиционная обработка сигналов давала неустойчивое звучание с множеством артефактов.
Глубокое обучение улучшило ситуацию: нейронные сети научились распознавать закономерности, которые упускала классическая обработка сигналов. Spleeter и Demucs стали двумя эталонными моделями с очень разными подходами.
История Spleeter и Demucs: связь с Парижем
Spleeter: быстрое маскирование спектрограмм от Deezer
В ноябре 2019 года французский стриминговый сервис Deezer выпустил Spleeter как бесплатный инструмент с открытым исходным кодом. Команда под руководством Romain Hennequin создала его на TensorFlow вокруг свёрточной нейронной сети U-Net, работающей с амплитудными спектрограммами, то есть частотно-временными представлениями аудио.
Spleeter рассматривает разделение как сегментацию изображения. Для каждой частотно-временной ячейки он предсказывает мягкую маску, оценивая, какая её доля относится к вокалу, ударным, басу или остальному. Необязательный этап фильтрации Винера уточняет маски, а стемы реконструируются с фазой исходного микса.
Сильная сторона Spleeter — скорость. Он разделяет 4-минутную запись за секунды, достигая скорости в 100 раз быстрее реального времени на GPU, и нормально работает на скромных CPU. Есть конфигурации на 2 стема (вокал/аккомпанемент), 4 и 5 стемов. Он стал базовой моделью для исследований и основой множества YouTube-каналов с ремиксами.
Demucs: разделение во временной области от Meta
Пока Spleeter делал ставку на скорость, Meta AI Research, тогда Facebook AI Research, сосредоточилась на качестве. Alexandre Défossez, тоже француз, и его команда представили Demucs в 2019 году. Название — сокращение Deep Extractor for MUlti-Channel Sources; подход был совсем другим.
Вместо спектрограмм Demucs работает напрямую с исходными волновыми формами и рассматривает разделение как задачу реконструкции во временной области. Архитектура сочетает свёрточные кодировщик и декодировщик в стиле U-Net, вдохновлённые Wave-U-Net, с двунаправленным LSTM в узком центральном слое. Так сеть улавливает длительную музыкальную структуру и сохраняет согласованность фазы.
Demucs прошла через четыре основные версии:
- v1 (2019): только волновые формы, уже на уровне спектрограммных методов
- v2 (2020): улучшенное обучение и повышение эффективности
- v3 "Hybrid Demucs" (2021): добавлена ветвь спектрограммы, победа в Music Demixing Challenge с 7,7 dB SDR на MUSDB18
- v4 "Hybrid Transformer Demucs" (2022): самые глубокие слои заменены междоменным Transformer, результат 9,0 dB SDR после дообучения и до 9,2 dB в лучшей конфигурации статьи
Sound Demixing Challenge и новый этап
Sound Demixing Challenge 2023 сменил акцент. Конкурс, организованный Meta, Sony и другими, ввёл устойчивое разделение музыкальных источников: обучение на данных с шумными метками и проникновением звуков между стемами. Alexandre Défossez был одним из главных организаторов и участвовал в разработке конкурса и базовых моделей.
Главный вывод: больше обучающих данных не гарантирует лучший результат. Качество данных и стратегии устойчивости важнее. Такие методы, как усечение значений функции потерь и итеративное уточнение, улучшили SDR на 0,89 dB на шумных данных.
Вскоре Défossez ушёл из Meta и стал сооснователем Kyutai, французской исследовательской лаборатории ИИ. Репозиторий Demucs всё ещё доступен, но README сообщает, что он больше не занимается им активно, поэтому новых функций ждать не стоит.
Производительность: компромиссы между скоростью и качеством
Принципы архитектуры
Spleeter маскирует спектрограммы. Demucs реконструирует волновые формы. Это основное различие определяет всё остальное.
Частотный подход Spleeter эффективен, потому что каждый кадр STFT обобщает тысячи отсчётов, и свёртки выполняются по значительно меньшему числу временных шагов. Цена этого: модель не учитывает фазу, повторно используя фазу микса, а фиксированное частотно-временное разрешение STFT не позволяет хорошо представлять и резкие атаки, и устойчивые тоны одновременно.
Временной метод Demucs обучает собственные банки фильтров через одномерные свёртки (1D). Он сохраняет фазу и обрабатывает атаки с точностью до отсчёта. В v4 слои Transformer удерживают контекст нескольких секунд аудио, уменьшая артефакты «пинг-понга», характерные для покадровых методов.
Hybrid Demucs v3: ветви волновой формы и спектрограммы
Обходные связи кодировщика и декодировщика
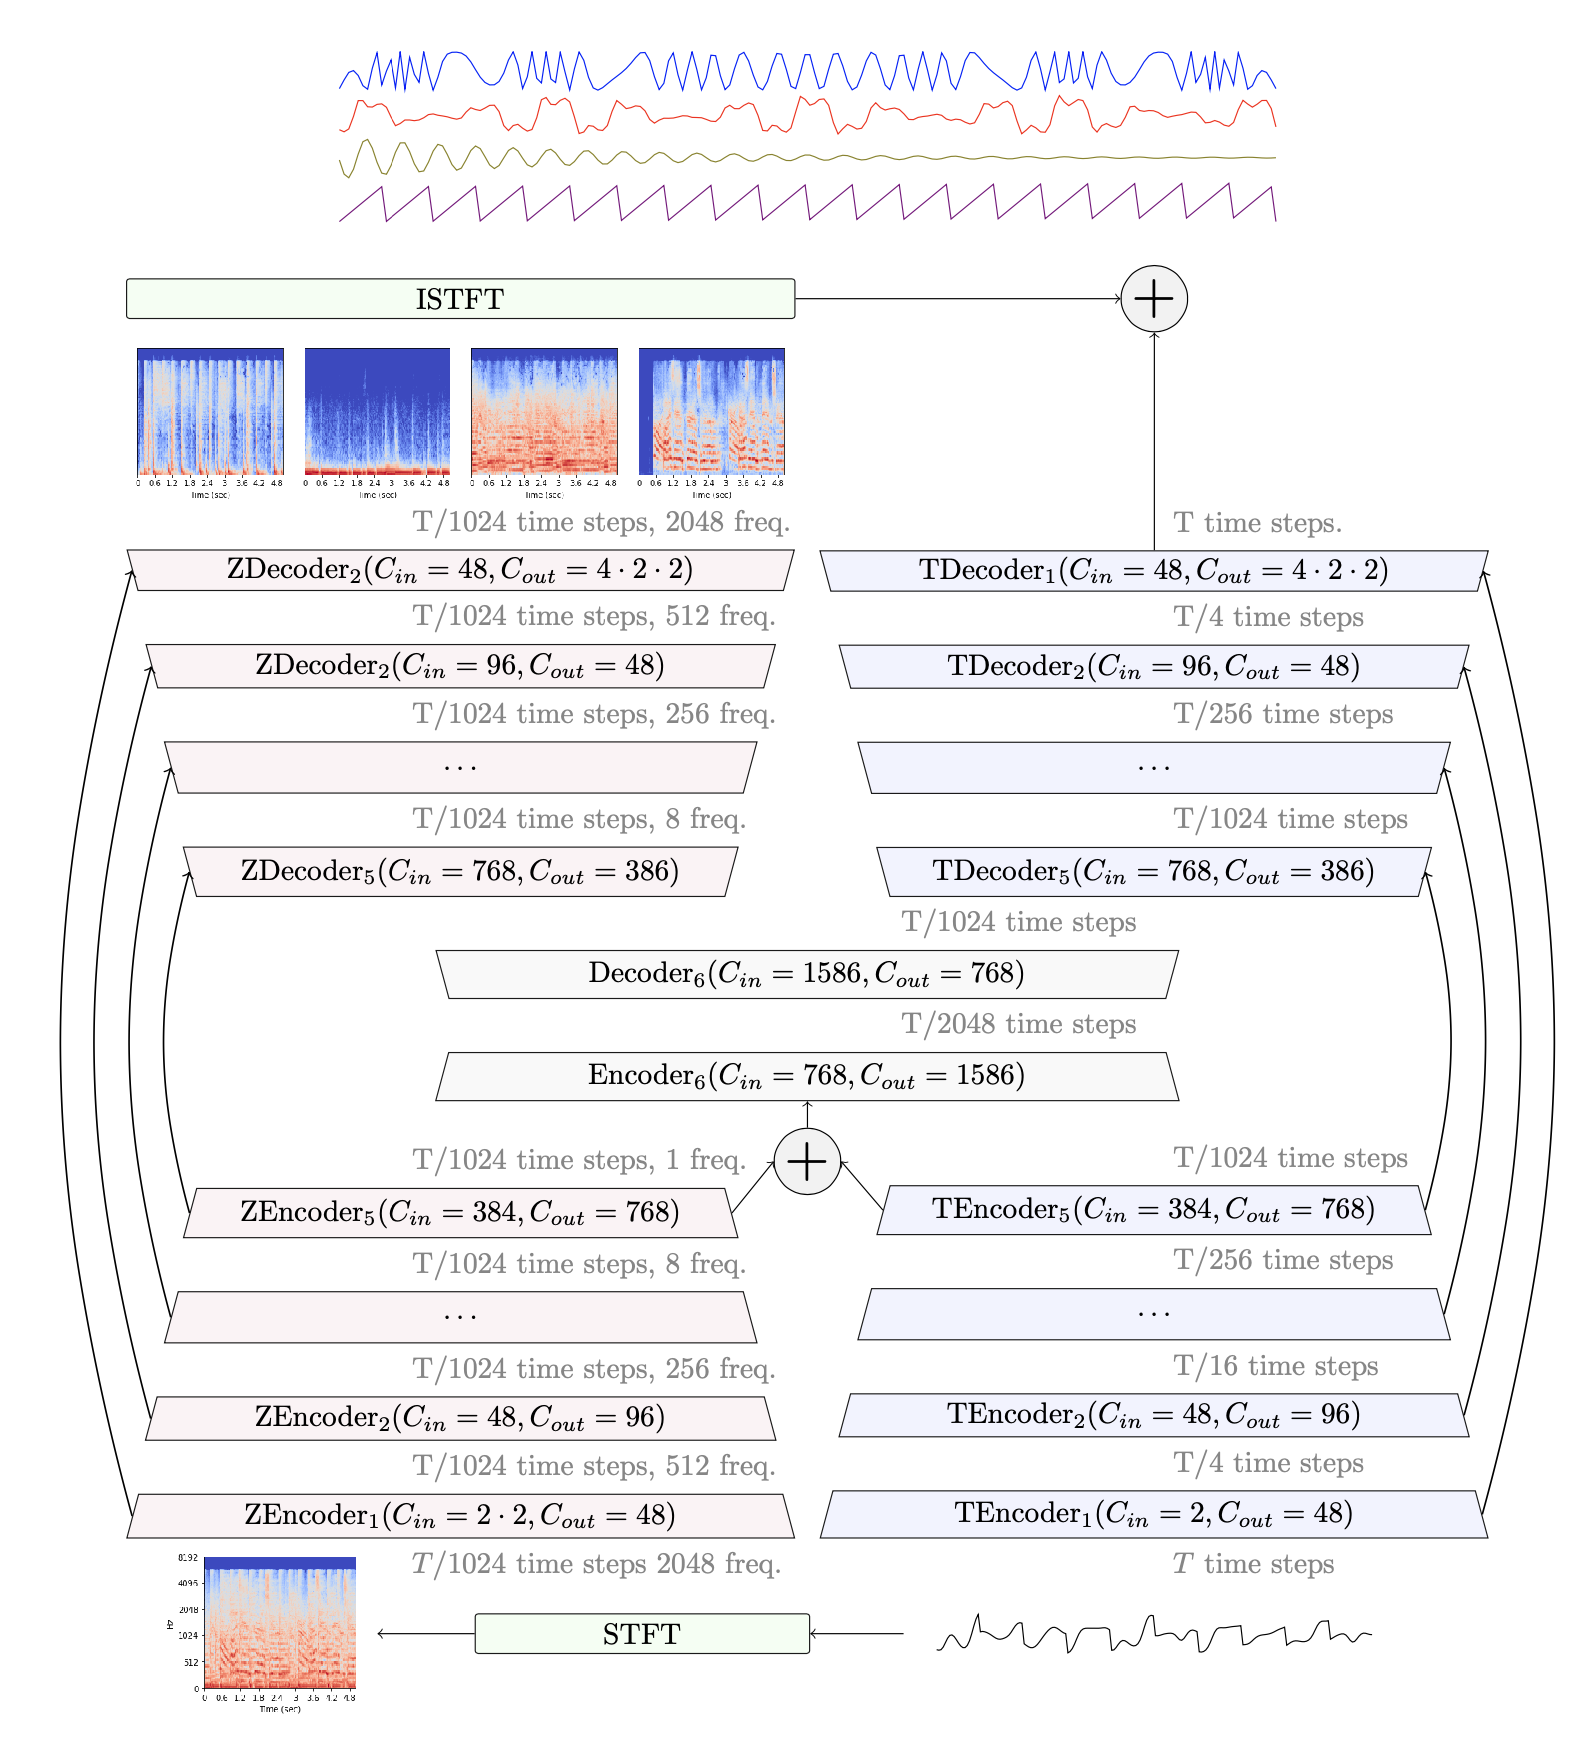
Оригинальная иллюстрация: Введение в разделение источников, рисунок 2 (Woosung Choi, Alexandre Defossez, Haohe Liu).
Результаты тестов Spleeter и Demucs
Эти оценки на тестовом наборе MUSDB18 взяты из официального GitHub-репозитория Demucs:
| Модель | Область обработки | Дополнительные обучающие данные | Общий SDR | Качество MOS |
|---|---|---|---|---|
| Spleeter | Спектрограмма | 25 000 песен | 5,9 dB | нет данных |
| Demucs v2 | Волновая форма | Нет (только MUSDB18) | 6,3 dB | 2,37 |
| Hybrid Demucs v3 | Гибридная | Нет (только MUSDB18) | 7,7 dB | 2,83 |
| HT Demucs v4 после дообучения | Гибридная | 800 песен | 9,0 dB | нет данных |
Отношение сигнала к искажениям (SDR) измеряет, насколько чисто модель выделяет источник из микса. Чем выше, тем лучше, но SDR не заменяет прослушивание. О практических ожиданиях от ИИ-стемов читайте, насколько качественно ИИ разделяет стемы сегодня. Разница примерно 3 dB между Spleeter и Demucs v4 велика по меркам тестов; Demucs получает более высокие оценки для каждого стема, особенно ударных и вокала.
Разницу можно услышать в видео ниже. Стемы Demucs звучат естественнее, с меньшим числом артефактов, тогда как Spleeter может давать металлический звон на сложном материале.

Что производительность означает на практике
Скорость: Spleeter обрабатывает 3-минутную запись примерно за 2 секунды на GPU. Demucs v4 требуется от 20 до 30 секунд. На CPU Spleeter занимает примерно от 30 до 60 секунд, а Demucs может потребоваться более 5 минут.
Оборудование: Spleeter работает только на CPU на ноутбуке с 8 GB оперативной памяти RAM. Demucs v4 для разумной скорости нужен GPU с видеопамятью VRAM от 4 до 8 GB; слои Transformer расходуют значительно больше памяти из-за матриц внимания.
Артефакты: поскольку Spleeter повторно использует фазу микса, он может давать «призрачный» вокал и размазанные атаки. Demucs v4 звучит естественнее, но может оставлять тихий шум в паузах.
Устойчивость: конкурс SDX'23 показал, что архитектуры в стиле Demucs лучше справляются с испорченными обучающими данными. Более простая архитектура Spleeter не позволяет легко получить пользу от таких методов, как фильтрация наборов данных и усечение значений функции потерь.
Spleeter или Demucs: что выбрать?
Многие продюсеры используют обе модели в зависимости от задачи.
Когда использовать Spleeter
Используйте Spleeter, когда важна скорость: быстрые акапеллы для DJ-сетов, караоке для практики или пакетная обработка всей библиотеки сэмплов. Скорость в 100 раз быстрее реального времени и скромные требования к оборудованию трудно превзойти; качества хватает для ремиксов, где стемы будут обрабатываться дальше.
Когда использовать Demucs
Выбирайте Demucs v4, когда артефакты неприемлемы: стемы для официальных ремиксов, сэмплы для коммерческих релизов или подробный анализ исполнения. Преимущество 3 dB по качеству и согласованность фазы оправдывают ожидание. Для материала конкретного жанра дообучайте с дополнительными данными, поскольку архитектура Demucs лучше масштабируется с чистыми данными.
Как сочетать Spleeter и Demucs
Обработайте весь каталог Spleeter, чтобы найти перспективные записи, а затем выбранные варианты обработайте Demucs. Для живых выступлений заранее разделяйте материал Spleeter. Для студийной работы используйте Demucs ради самых чистых стемов. Инструменты вроде Ultimate Vocal Remover объединяют Demucs и другие модели разделения в простом графическом интерфейсе.
Нужен ли GPU?
Spleeter нормально работает на CPU, а для качественного разделения с Demucs рекомендуется GPU, чтобы обработка не занимала слишком много времени. Для автономной или пакетной обработки на ноутбуке модели в стиле Spleeter по-прежнему полезны. Для более чистых стемов Demucs и новые гибридные модели с Transformer обычно оправдывают облачную обработку или более мощный локальный компьютер.
Обновление 2026 года: что лучше Spleeter и Demucs
Spleeter и Demucs всё ещё полезны как ориентиры, но уже не задают потолок качества разделения на стемы.
BS-RoFormer (Band-Split RoPE Transformer) разделяет спектрограмму на частотные полосы и моделирует их слоями Transformer. Его статья сообщает о среднем SDR 9,80 dB на MUSDB18-HQ без дополнительных обучающих данных, выше 9,0 dB у дообученной Demucs v4 с 800 дополнительными песнями. Версия с 500 дополнительными песнями в обучении заняла первое место в музыкальном направлении Sound Demixing Challenge 2023.
| Модель | Год | Общий SDR (MUSDB18) | Дополнительные обучающие данные |
|---|---|---|---|
| Spleeter | 2019 | 5,9 dB | 25 000 песен |
| HT Demucs после дообучения (v4) | 2022 | 9,0 dB | 800 песен |
| BS-RoFormer | 2023 | 9,8 dB | Нет |
Mel-Band RoFormer — близкая модель, группирующая частоты по шкале мел. Обученные веса обеих моделей, подготовленные сообществом, сегодня лежат в основе большинства высококачественных инструментов выделения вокала и инструментальной части. Наше сравнение моделей выделения вокала оценивает их на реальных записях, а сравнение моделей выделения инструментов делает то же для остальных инструментов.
ИИ-разделение на стемы в Neural Analog использует модели BS-RoFormer для пресетов на 4 и 6 стемов, а SAM Audio — когда нужно выделить инструмент, которого нет в пресетах, например саксофон или солирующий синтезатор. Полный список приведён в ответе на вопрос, какие модели Neural Analog использует для разделения на стемы.
FAQ: Spleeter и Demucs
Demucs лучше Spleeter?
Да, по качеству. Demucs v4 получает SDR примерно на 3 dB выше Spleeter на тесте MUSDB18 и даёт меньше артефактов на вокале и ударных. Spleeter лучше только тогда, когда скорость или работа исключительно на CPU важнее качества.
Что лучше для вокала: Spleeter или Demucs?
Demucs. Вокал Spleeter часто звучит тонко или «водянисто», поскольку Spleeter повторно использует фазу исходного микса. Для максимально чистого вокала и инструментальной части модель BS-RoFormer или Mel-Band RoFormer обычно превосходит обе.
Spleeter всё ещё поддерживается?
Spleeter всё ещё доступен на GitHub, но это модель 2019 года на TensorFlow, и README предупреждает о проблемах TensorFlow на чипах Apple M1. Большинство новых инструментов перешло на Demucs или модели RoFormer.
Что использует Ultimate Vocal Remover (UVR)?
UVR — бесплатное настольное приложение, а не одна модель. Оно объединяет несколько семейств моделей, включая Demucs, MDX-Net и собственные модели VR Architecture, поэтому качество зависит от выбранной модели.
Можно ли использовать Demucs без GPU?
Да, но медленно. На CPU ожидайте несколько минут на песню. Онлайн-разделение на стемы вместо этого запускает модель на серверном GPU. Руководство Studio по разделению на стемы показывает шаги.
Связанные руководства
- Убрать ударные из песни Suno: практическое применение выделения стема ударных.
- Заменить ИИ-ударные своей установкой: выделите ударные, затем создайте новый грув вокруг вокала.
- Восстановить стемы MP3 до качества WAV: реконструируйте высокие частоты, потерянные из-за сжатых источников и разделения.
- Преобразовать стереопесню в Dolby Atmos: разместите разделённые стемы в миксе Atmos.
- Установить и запустить AudioSR из GitHub: ещё одна аудиомодель с открытым исходным кодом для локального запуска, с настройкой Python и PyTorch.