Neural Analog(声智模拟) 指南
核心任务改善低质量音频
修复 MP3 压缩损伤,重建 AI 音乐中薄弱的高频,或去除稳定的噪声。在处理整首歌曲前,先在较短的出问题片段上测试模型。
根据问题选择流程
| 你听到的声音 | 从...开始 |
|---|---|
| 暗淡的MP3/网络导入、模糊的镲片、拖尾的瞬态 | 恢复 MP3 音质 |
| 高频缺失或混乱的 AI 歌曲 | 提升 AI 生成音乐的音质 / UniverSR(高频修复) |
| 持续嘶嘶声或背景噪声 | 去除噪声与嘶声 |
| 有噪声或混响的语音/人声 | RE-USE(语音增强) |
本示例展示如何识别并减少 Suno 生成的音频中常听到的持续嘶嘶声。

在 Studio 中运行模型
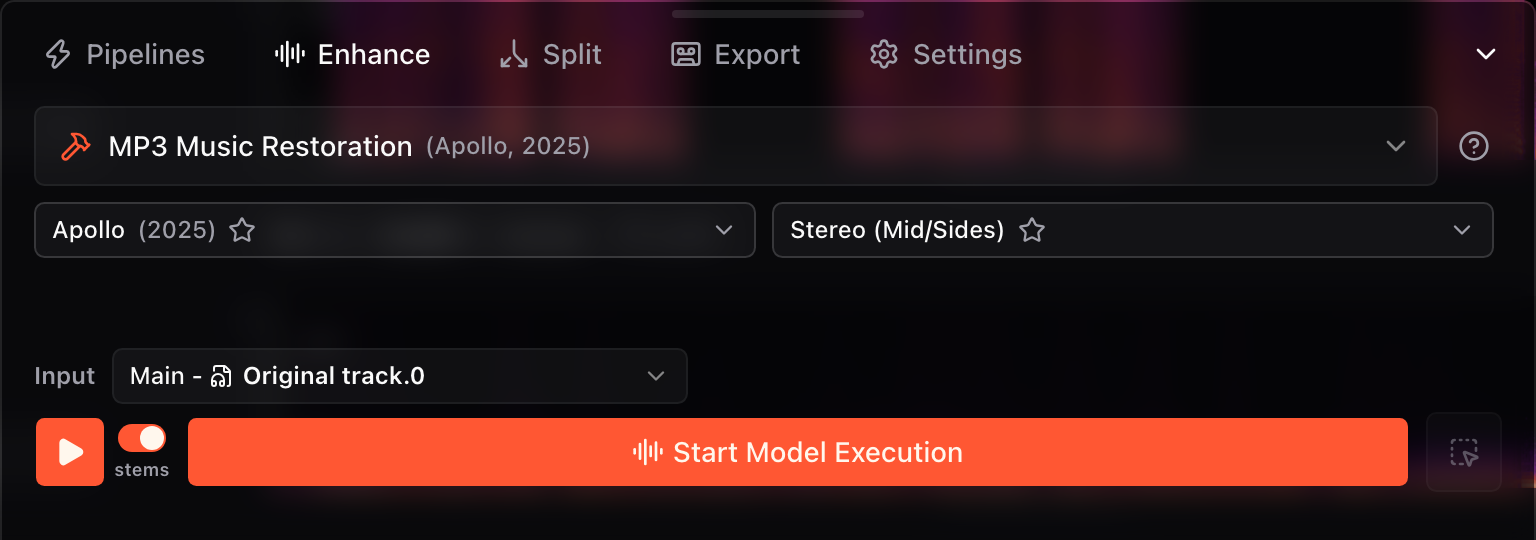
- 打开 管线 用于命名流程,或 增强 以直接选择一个模型。
- 导入的文件会默认用作输入音频。只有在需要处理其他版本、分轨或当前混音时,才更改输入。
- 选择模型,并设置其强度和声道选项。
- 了解 处理分钟数的计算方式 并选择 开始模型执行.
先测试一个短片段
- 找出一段 10 到 30 秒、缺陷容易听出的片段。
- 在波形的该部分上拖动。所选范围即为处理时长。请参阅 波形选区 了解其他区域控制项。
- 在将范围替换为更长选区之前,先运行并比较结果。
查看橙色修复版本
完成的结果会显示在同一音轨的版本菜单中,并带有橙色修复图标。选择它并使用 之前 / 之后 滑块将其与源进行比较。当测试并非改进时,请保留原始版本。