نموذج RAVE من IRCAM: إضافات VST ونماذج جاهزة وتدريب
نموذج RAVE من IRCAM نموذج صوت عصبي يعمل في الوقت الفعلي ويحول أي صوت إلى اللون الصوتي الذي تدرب عليه. يمكنكم تشغيل نماذج RAVE المدربة مسبقا في محطة العمل الصوتية الرقمية باستخدام Neutone FX أو RAVE VST، أو تحميلها في Max/MSP أو Pure Data باستخدام nn~، أو تدريب نموذجكم بحزمة Python المسماة acids-rave.
كيفية استخدام RAVE: بداية سريعة
| الهدف | الأداة | ما تحتاجون إليه |
|---|---|---|
| تشغيل نماذج RAVE في محطة العمل الصوتية الرقمية | Neutone FX (إضافة VST/AU مجانية) | أي محطة عمل صوتية رقمية. تُنزَّل النماذج المدربة مسبقا من داخل الإضافة. |
| تشغيل نماذج RAVE في محطة العمل الصوتية الرقمية | RAVE VST (نسخة تجريبية) | تنزيل من IRCAM Forum. أُرشف مستودع المصدر في يونيو 2023، ونسخة Windows برنامج مستقل فقط. |
| استخدام RAVE في Max/MSP أو Pure Data | الملحق nn~ | Max أو Pd، مع ملف نموذج .ts |
| تنزيل نماذج مدربة مسبقا | قائمة نماذج RAVE الرسمية | ملفات .ts مصدرة بوضع البث لـnn~ |
| تدريب نموذجكم | acids-rave على Python | بطاقة NVIDIA بذاكرة من 5 إلى 32 GB، وبضع ساعات من الصوت، وحوالي 3 أيام |
لتثبيت nn~، نزلوا أحدث إصدار وفكوا ضغطه في Documents/Max [your version]/Packages/ لـMax، أو Documents/Pd/externals/ لـPure Data. ضعوا نماذج .ts في مجلد nn_tilde/models.

ما نموذج IRCAM RAVE لتركيب الصوت في الوقت الفعلي؟
RAVE اختصار لـRealtime Audio Variational autoEncoder، أي مشفر تلقائي تغايري للصوت في الوقت الفعلي. أصدره باحثون في IRCAM بباريس أواخر 2021، ويتعلم ترميز الأصوات في تمثيل مضغوط ثم فك ترميزها إلى صوت. تخيلوا تدريب حاسوب على رسم مخطط لما يسمعه، ثم إعادة رسم ذلك المخطط كمحاكاة مقنعة للصوت الأصلي.
ينفذ ذلك بسرعة تكفي للعمل في الوقت الفعلي داخل محطة العمل الصوتية الرقمية أو تجهيز الأداء المباشر.
من أنشأ RAVE ومتى؟
طور RAVE كل من Antoine Caillon، الذي يعمل الآن في Google DeepMind، وPhilippe Esling من فريق ACIDS في IRCAM بباريس.
سبق للفريق استكشاف نموذج DDSP من Google (معالجة الإشارات الرقمية القابلة للتفاضل)، وعرضه في مارس 2021، لكنه أراد نموذجا أكثر مرونة يتعامل مع أي نوع من الأصوات، لا الآلات الموسيقية وحدها.
كان الهدف نموذجا يعمل على عتاد عادي ويقدم صوتا بجودة استوديو. عرضوه في ورقتهم المنشورة عام 2021، «RAVE: مشفر تلقائي تغايري لتركيب صوت عصبي سريع وعالي الجودة».
بنية RAVE: كيف يعمل هذا المشفر التلقائي التغايري؟
RAVE مشفر تلقائي: شبكة عصبية تتعلم ضغط البيانات في «فضاء كامن» مضغوط، ثم فك ضغطها مرة أخرى.
RAVE: تدريب على مرحلتين
المرحلة 1: تعلم التمثيل
المرحلة 2: الضبط الدقيق الخصومي
مخطط التدريب مقتبس من ورقة RAVE الأصلية. في المرحلة 1، يُدرَّب المشفر ومفكك الترميز باستخدام دالة خسارة طيفية متعددة النطاقات. في المرحلة 2، تُجمَّد معاملات المشفر ويُوقَف انتشار التدرجات عبر التمثيل الكامن، ويُدرَّب مفكك الترميز والمميز. يبقى تحليل PQMF وتركيبه ثابتين.
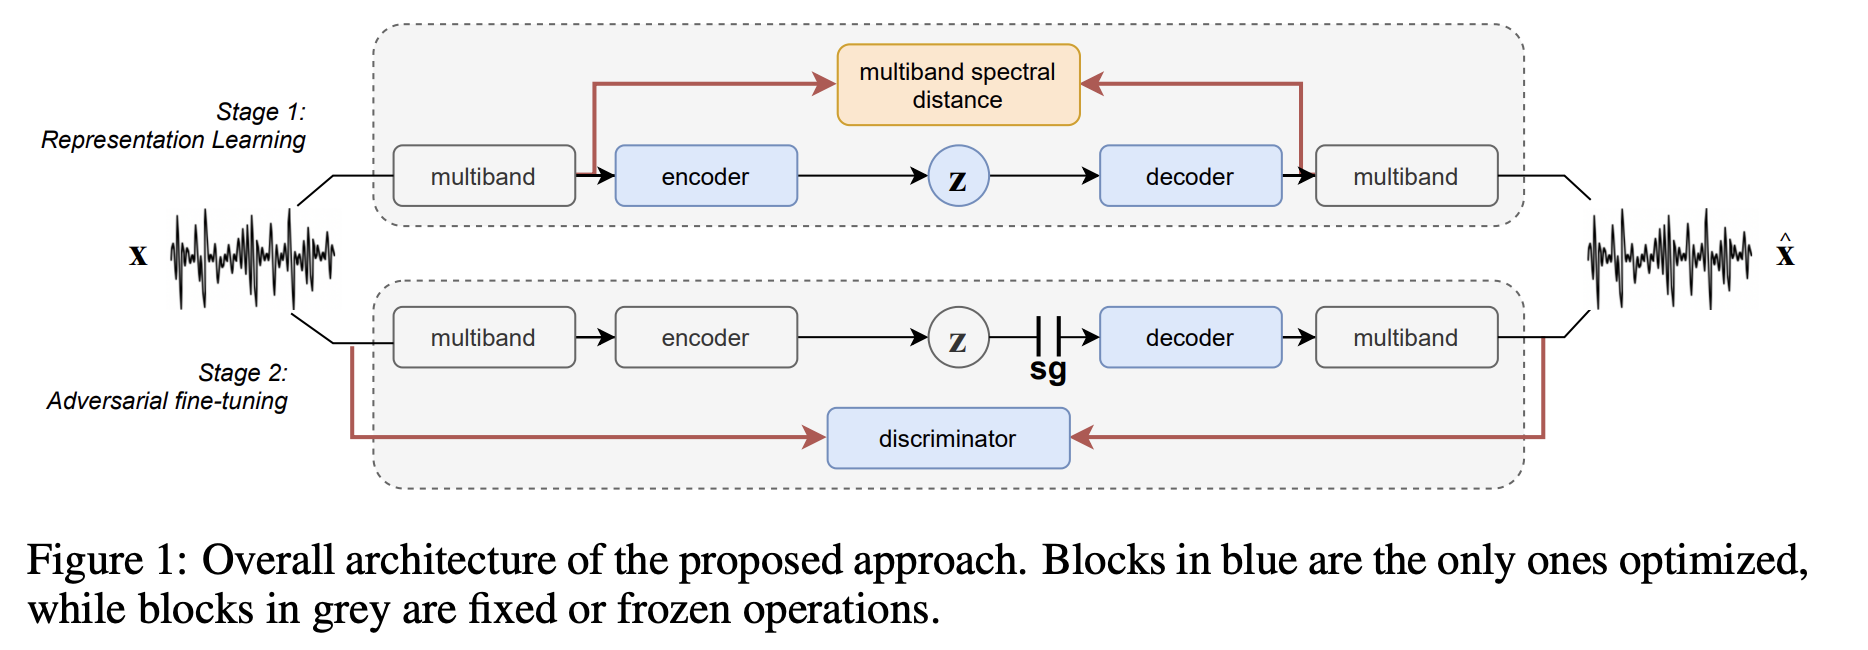
الشكل الأصلي: RAVE: تدريب على مرحلتين.
كيف يعمل تدريب RAVE على مرحلتين؟
تخيلوا تدريب موسيقي على مرحلتين:
-
المرحلة 1: تعلم الاستماع (تعلم التمثيل)
- يتعلم المشفر ضغط الصوت في مجموعة صغيرة من الأرقام (الفضاء الكامن)
- يتعلم مفكك الترميز إعادة بناء الصوت من هذه الأرقام
- يستخدم التدريب دالة خسارة طيفية تقارن المحتوى الترددي للصوت الأصلي والمعاد بناؤه
-
المرحلة 2: تعلم الارتجال (الضبط الدقيق الخصومي)
- تُجمَّد معاملات المشفر (فهو يعرف بالفعل كيف يستمع)
- تُضاف شبكة «مميز»: ناقد يحكم على مدى واقعية الصوت المعاد بناؤه
- يتعلم مفكك الترميز من هذه الملاحظات لإنتاج صوت أكثر إقناعا
المكونات التقنية الأساسية
- مرشحات PQMF: يقسم RAVE الصوت إلى عدة نطاقات ترددية فرعية قبل المعالجة، مما يجعله أكثر كفاءة
- الوضعان السببي وغير السببي: يقلل الوضع السببي بعض الجودة مقابل زمن استجابة أقل في الاستخدام المباشر
- تكوينات متعددة: من "raspberry" الخفيف (يعمل على Raspberry Pi) إلى "v3" عالي الجودة
لتفاصيل التنفيذ، راجعوا مستودع RAVE الرسمي على GitHub، الذي يتضمن ملفات التكوين وتعريفات النماذج.

كيف تدربون نماذج RAVE على بيانات صوتية خاصة؟
هل تريدون نموذجا يحول صوتكم إلى ساكسفون؟ يتطلب تدريب RAVE معرفة بـPython وبطاقة رسومية. يوثق مستودع RAVE الرسمي العملية كاملة.
متطلبات إعداد مجموعة البيانات
لتدريب نموذج RAVE، تحتاجون إلى:
- 2 إلى 3 ساعات من صوت نظيف (كلما زادت كان أفضل)
- تسجيلات بجودة استوديو لأن RAVE يتعلم كل شيء، بما في ذلك الضوضاء والصدى
- أصوات متنوعة إذا أردتم مرونة في الاستخدام
لبناء مجموعة بيانات من مزيج موسيقي كامل، اعزلوا الآلة أولا باستخدام فصل المسارات بالذكاء الاصطناعي بجودة عالية. تنتقل عيوب الفصل إلى النموذج أيضا، لذا استخدموا أنظف مسارات يمكنكم الحصول عليها. يشرح دليل فصل المسارات الطريقة في Neural Analog.
تثبيت RAVE وإعداد مجموعة البيانات
ثبتوا PyTorch وTorchAudio المناسبين لبطاقتكم الرسومية أولا، ثم RAVE. تحتاجون أيضا إلى FFmpeg؛ في بيئة conda، ثبتوه باستخدام conda:
pip install acids-rave
conda install ffmpeg
تحول المعالجة المسبقة ملفات الصوت إلى تنسيق مجموعة بيانات RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1استخدموا --channels 1 للصوت الأحادي أو --channels 2 للستيريو. أضيفوا --lazy للتدريب مباشرة على ملفات مضغوطة مثل MP3، لكن توقعوا حملا أعلى بكثير على المعالج المركزي أثناء التدريب. لجميع المعاملات، راجعوا وثائق إعداد بيانات RAVE.
عملية تدريب RAVE والتكوينات
ابدؤوا التدريب باسم التكوين:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1اختاروا التكوين المناسب لبطاقتكم الرسومية. الحد الأدنى لذاكرة البطاقة مأخوذ من ملف README الرسمي:
| التكوين | الحد الأدنى لذاكرة البطاقة الرسومية | الاستخدام المناسب |
|---|---|---|
raspberry | 5 GB | نموذج خفيف للعمل في الوقت الفعلي على Raspberry Pi 4 |
onnx | 6 GB | تكوين v1 دون ضوضاء للتصدير إلى ONNX |
v1 | 8 GB | النموذج المستمر الأصلي |
v2_small | 8 GB | نقل اللون الصوتي للأصوات المستقرة |
v2 | 16 GB | النموذج المستمر المحسن وخيار افتراضي جيد |
discrete | 18 GB | نموذج متقطع مشابه لـSoundStream أو EnCodec |
v3 | 32 GB | أعلى جودة، مع نقل الأسلوب (AdaIN) |
يمكنكم جمع تكوين مع خيارات مثل causal (زمن استجابة أقل) أو noise. يدرب دفتر Colab مجتمعي لـRAVEv2، المرتبط من README، النموذج على بطاقات Google إذا لم تتوفر لديكم بطاقة.
ما يمكن توقعه أثناء التدريب:
- المرحلة 1 (حوالي 1 مليون خطوة): تبدأ جودة الصوت ضعيفة وتتحسن تدريجيا
- المرحلة 2 (التدريب الخصومي): تتحسن الجودة بوضوح
- الوقت الإجمالي: حوالي 3 أيام على بطاقة RTX 3080
تشرح دفاتر تدريب RAVE التي ساهم بها المجتمع العملية خطوة بخطوة.
تصدير نماذج RAVE للاستخدام في الوقت الفعلي
التصدير مهم للاستخدام في الوقت الفعلي. استخدموا الخيار --streaming لتفعيل عمليات الالتفاف مع التخزين المؤقت، مما يمنع عيوب الطقطقة:
rave export --run /path/to/your/run --streamingالنتيجة ملف TorchScript بامتداد .ts يمكن لـnn~ تحميله. لمعاملات التصدير وحل المشكلات، راجعوا وثائق تصدير RAVE.
الاستدلال بنموذج RAVE وخيارات الاستخدام في الوقت الفعلي
لا تريدون انتظار 3 أيام للتدريب؟ يمكنكم تجربة نماذج RAVE المدربة مسبقا في عدة أدوات. وتحمل هذه الأدوات أيضا النماذج التي تدربونها بأنفسكم. يحدد جواب استخدام نموذج مدرب في محطة العمل الصوتية الرقمية الإضافة المناسبة لكل نوع من النماذج.
Neutone FX: إضافة VST/AU مجانية لنماذج RAVE
Neutone FX إضافة VST/AU مجانية تستضيف نماذج RAVE. إنها إضافة Neutone الأصلية من 2022، وتدار الآن كمنصة مفتوحة. ثبتوها لتحميل مجموعة من النماذج المدربة مسبقا مباشرة في محطة العمل الصوتية الرقمية (Ableton وLogic وReaper وغيرها).

RAVE VST من IRCAM (تجريبي ومؤرشف)
أصدر IRCAM أيضا RAVE VST، بنسخ VST وAU وبرنامج مستقل. له وضعان: reconstruction لإعادة البناء، ويعالج الصوت الوارد من محطة العمل الصوتية الرقمية، وprior للتوليد، ويولد الصوت بالتحرك في الفضاء الكامن ذاتيا. ينزل Model Explorer النماذج المدربة مسبقا، ويمكنكم استيراد نماذجكم إذا صدرتموها باستخدام --stereo true.
أُرشف مستودع rave_vst في يونيو 2023، لذا لا تتوقعوا إصلاحات. لا تتوفر على Windows إلا نسخة مستقلة تجريبية، ويجب على مستخدمي Mac M1 بناء البرنامج بأنفسهم. يوصي المطورون باستخدام nn~ بدلا منه للعمل في الوقت الفعلي.
التكامل مع Max/MSP وPure Data باستخدام nn~
للأداء المباشر، يحمل الملحق nn~ نماذج RAVE مباشرة في Max/MSP وPure Data. يتيح التحكم المباشر بالفضاء الكامن والتطبيع التكيفي لكل عينة لنقل الأسلوب. ويعمل أيضا على منصات مدمجة مثل Raspberry Pi لتجهيزات محمولة. تشغل اللوحات نفسها إضافات مضخمات غيتار عصبية مثل ToobAmp وStompbox. إذا كانت لوحتكم NVIDIA Jetson Nano، تذكروا أنها لا تحتوي على مخرج صوت تناظري: أضيفوا بطاقة صوت I2S مثل Raspiaudio Audio+ أولا.
قيود أداء RAVE والتنبيهات التقنية
تعرفوا على هذه القيود قبل الاعتماد على RAVE:
- زمن الاستجابة: توقعوا تأخيرا ملحوظا حتى في الوضع السببي، وعلى أجهزة Apple Silicon المتقدمة أيضا. قد يناسب ذلك الاستوديو، لكن اختبروا بعناية قبل استخدام RAVE كآلة للأداء المباشر.
- تسريع البطاقة الرسومية: يستخدم النموذج عمليات التفاف صغيرة كثيرة تحدها سرعة الوصول إلى الذاكرة أكثر من القدرة الحسابية، لذا لا يتوازى بكفاءة. للاستخدام في الوقت الفعلي، غالبا ما تتجاوز كلفة تشغيل البطاقة الرسومية الفائدة، إلا عند معالجة دفعات.
- جودة الصوت: قد يقدم RAVE صوتا لافتا، لكنه لا يطابق دائما دقة التركيب التقليدي أو النماذج العصبية الأكثر تقدما مثل نماذج الانتشار.
- صعوبة التدريب: يتطلب تدريب RAVE خبرة في تعلم الآلة ومعالجة الصوت، إلى جانب عتاد قوي.
ما بعد RAVE: Neutone Morpho ونموذج AFTER
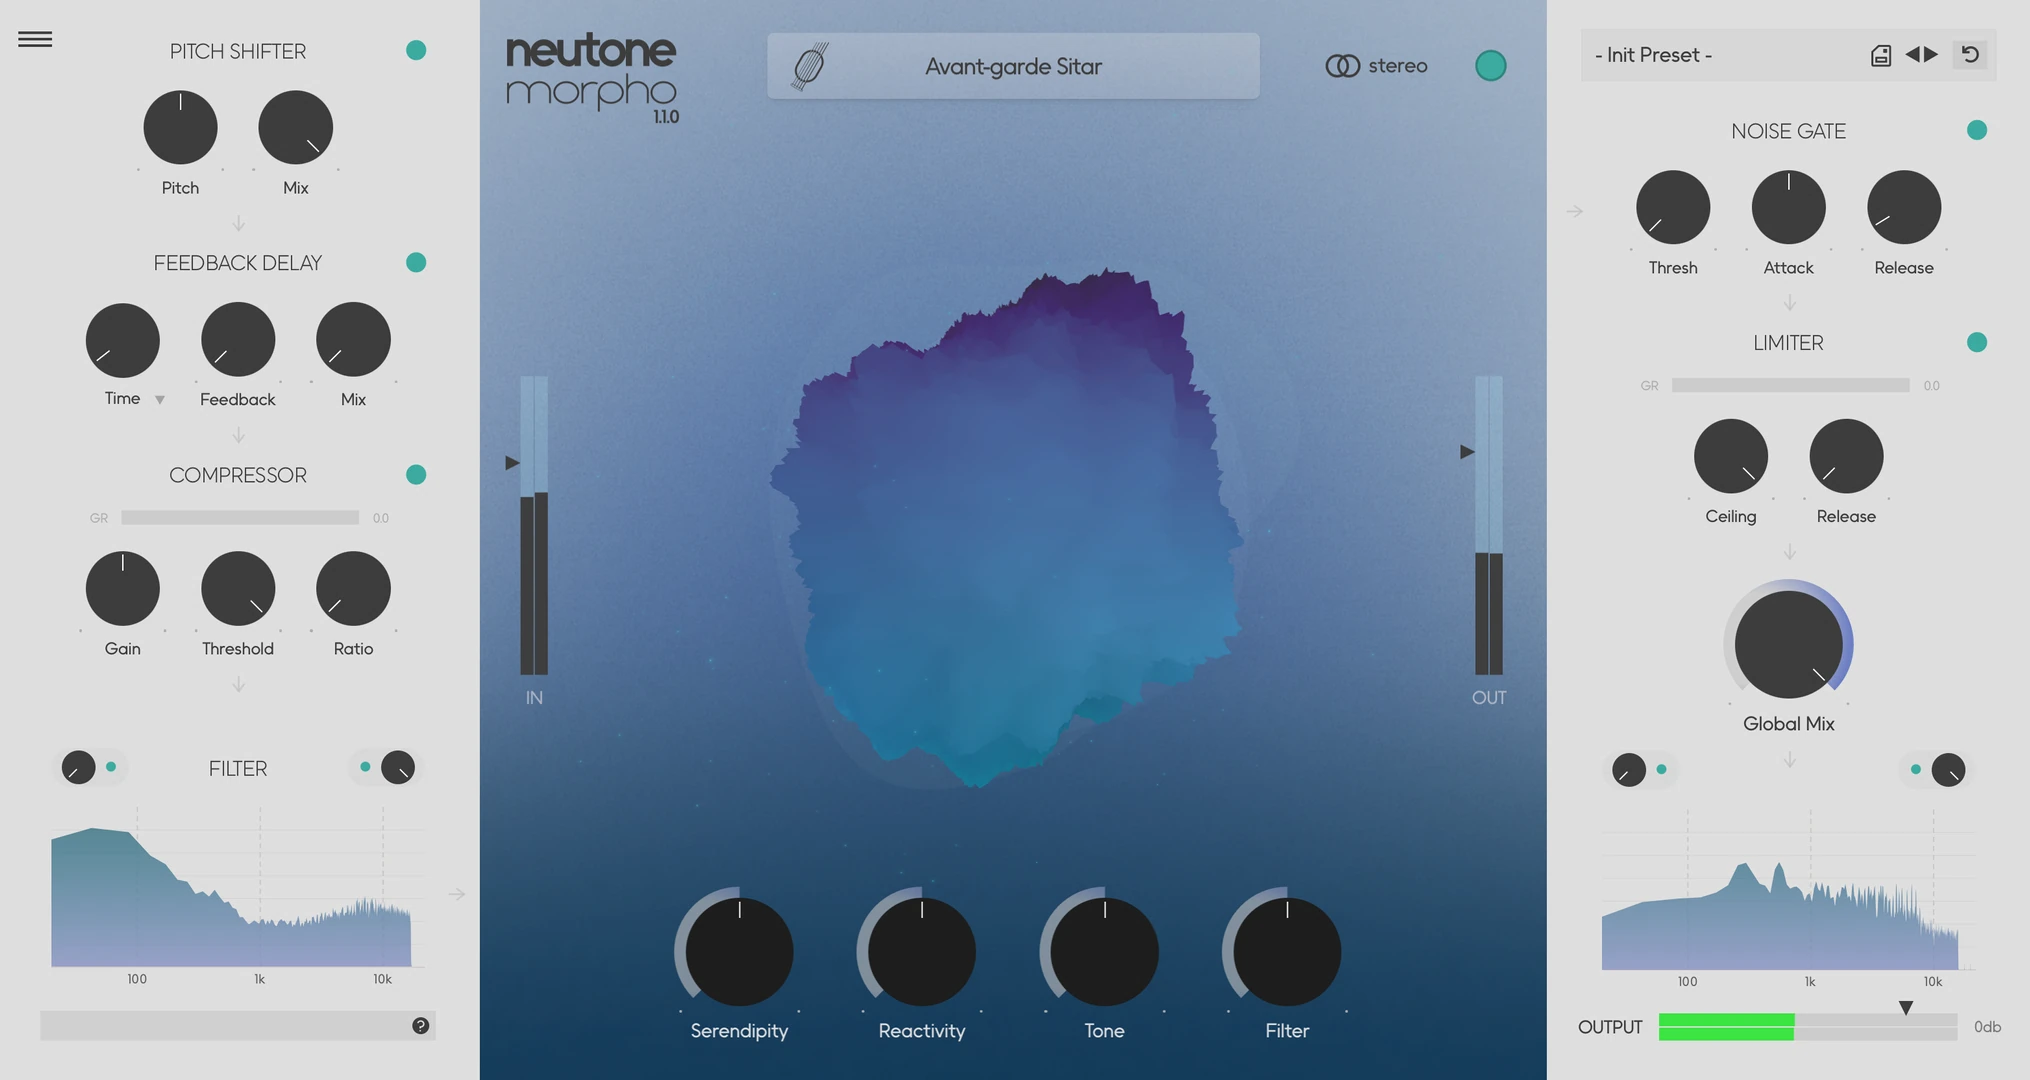
Neutone Morpho: تطور تجاري لـRAVE (2024)
في فبراير 2024، أصدر فريق Neutone بقيادة Nao Tokui Morpho، خلفا تجاريا لإضافة FX المجانية. RAVE هو المحرك المخصص للأبحاث ومفتوح المصدر. يجمع Morpho تقنية مشابهة في منتج مكتمل للموسيقيين والمنتجين، مقابل مرونة أقل.
نموذج AFTER: بديل قائم على الانتشار من IRCAM
أصدر فريق ACIDS نفسه في IRCAM أيضا AFTER (Audio Features Transfer and Exploration in Real-time، أي نقل خصائص الصوت واستكشافها في الوقت الفعلي)، وهو نموذج قائم على الانتشار. يهدف إلى إتاحة تعديل أسهل، مع تحكم في اللون الصوتي في الوقت الفعلي مثل آلة تركيب صوتي تقليدية.
لتغيير أسلوب أغنية كاملة بأمر نصي، بدلا من صوت واحد، يحافظ ريمكس بالذكاء الاصطناعي على مسار الغناء ويعيد توليد الآلات باستخدام Stable Audio 3.
أسئلة شائعة عن RAVE
أين يمكن تنزيل نماذج RAVE المدربة مسبقا؟
يسرد IRCAM نماذج البث في صفحة نماذج RAVE الرسمية. يمكن لـNeutone FX وRAVE VST أيضا تنزيل النماذج من داخل الإضافة. افحصوا ترخيص كل نموذج قبل استخدامه في إصدار تجاري.
ما مقدار الصوت اللازم لتدريب RAVE؟
خططوا لتوفير 2 إلى 3 ساعات من صوت نظيف من مصدر واحد. يتعلم RAVE كل شيء في التسجيلات، بما في ذلك الضوضاء وصدى الغرفة. لأرقام DDSP وAFTER، راجعوا كمية البيانات اللازمة لتدريب نموذج.
هل يمكن تدريب RAVE على Mac؟
ليس خيارا مناسبا. يطلب دليل RAVE من UAL Creative Computing Institute بطاقة NVIDIA تدعم CUDA بذاكرة 8 GB على الأقل، وينصح بتجنب macOS. استخدموا بطاقة رسومية سحابية أو دفتر Colab المجتمعي بدلا من ذلك.
لماذا يصدر نموذج RAVE طقطقة في Max؟
صُدّر النموذج دون --streaming. أعيدوا تصديره مع هذا الخيار.
RAVE أم DDSP؟
يحتاج DDSP إلى حوالي 10 دقائق من الصوت فقط، لكنه لا ينمذج إلا الآلات ذات النغمات محددة الارتفاع التي تعزف نغمة واحدة في كل مرة. يتعامل RAVE مع أي صوت، بما في ذلك الطبول والأصوات البشرية والأنسجة الصوتية، لكنه يحتاج إلى ساعات من الصوت وأيام من التدريب.