Model RAVE od IRCAM: VST, gotowe modele i trening
Model RAVE od IRCAM to neuronowy model audio działający w czasie rzeczywistym, który przekształca dowolny dźwięk w barwę, na której został wytrenowany. Gotowe modele RAVE można uruchamiać w DAW za pomocą Neutone FX lub RAVE VST, wczytywać w Max/MSP lub Pure Data przez nn~ albo trenować własne z pakietem Python acids-rave.
Jak używać RAVE: szybki start
| Cel | Narzędzie | Czego potrzebujesz |
|---|---|---|
| Uruchamiać modele RAVE w DAW | Neutone FX (darmowe VST/AU) | Dowolny DAW. Gotowe modele pobiera się wewnątrz wtyczki. |
| Uruchamiać modele RAVE w DAW | RAVE VST (beta) | Plik do pobrania z IRCAM Forum. Repozytorium źródłowe zarchiwizowano w czerwcu 2023 roku, a wersja Windows jest wyłącznie samodzielną aplikacją. |
| Używać RAVE w Max/MSP lub Pure Data | Moduł zewnętrzny nn~ | Max lub Pd oraz plik modelu .ts |
| Pobrać gotowe modele | Oficjalna lista modeli RAVE | Eksporty strumieniowe .ts dla nn~ |
| Wytrenować własny model | acids-rave w Python | GPU NVIDIA z pamięcią od 5 do 32 GB, kilka godzin audio i około 3 dni |
Aby zainstalować nn~, pobierz najnowsze wydanie i rozpakuj je do Documents/Max [your version]/Packages/ dla Max albo Documents/Pd/externals/ dla Pure Data. Umieść modele .ts w folderze nn_tilde/models.

Czym jest IRCAM RAVE do syntezy audio w czasie rzeczywistym?
RAVE oznacza Realtime Audio Variational autoEncoder, czyli wariacyjny autoenkoder audio działający w czasie rzeczywistym. Model udostępniony pod koniec 2021 roku przez badaczy IRCAM w Paryżu uczy się kodować dźwięki w zwartej reprezentacji, a następnie dekodować ją z powrotem do audio. Wyobraź sobie, że uczysz komputer szkicować to, co słyszy, a potem na podstawie szkicu tworzyć przekonującą imitację oryginalnego dźwięku.
Robi to na tyle szybko, by działać w czasie rzeczywistym w DAW lub zestawie do występów na żywo.
Kto stworzył RAVE i kiedy?
RAVE opracowali Antoine Caillon, który obecnie pracuje w Google DeepMind, oraz Philippe Esling z paryskiego zespołu ACIDS w IRCAM.
Zespół wcześniej badał model Google DDSP (Differentiable Digital Signal Processing, różniczkowalne cyfrowe przetwarzanie sygnałów), prezentując go w marcu 2021 roku, ale chciał bardziej elastycznego modelu obsługującego dowolny rodzaj dźwięku, nie tylko instrumenty muzyczne.
Celem był model działający na standardowym sprzęcie i zapewniający audio o jakości studyjnej. Przedstawiono go w publikacji z 2021 roku „RAVE: wariacyjny autoenkoder do szybkiej neuronowej syntezy audio wysokiej jakości”.
Architektura RAVE: jak działa ten wariacyjny autoenkoder
RAVE to autoenkoder: sieć neuronowa ucząca się kompresować dane do zwartej „przestrzeni ukrytej”, a potem dekompresować je z powrotem.
RAVE: trening w dwóch etapach
Etap 1: uczenie reprezentacji
Etap 2: dostrajanie przeciwstawne
Schemat treningu opracowany na podstawie oryginalnej publikacji o RAVE. W etapie 1 enkoder i dekoder są trenowane z wielopasmową funkcją straty widmowej. W etapie 2 enkoder zostaje zamrożony, propagacja gradientów przez kod ukryty jest zatrzymana, a dekoder i dyskryminator są trenowane. Analiza i synteza PQMF pozostają stałe.
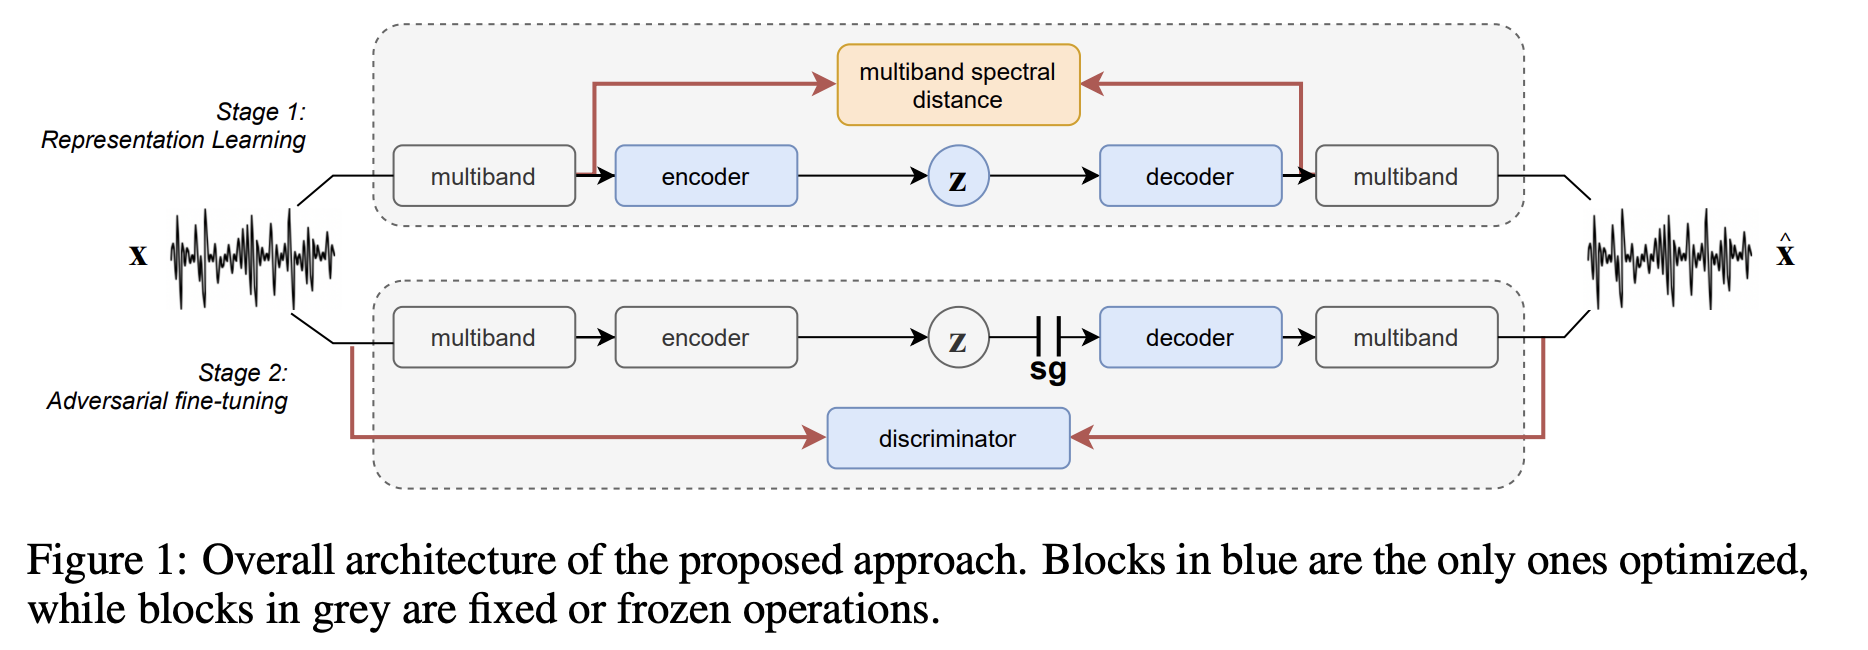
Oryginalny diagram: RAVE: trening w dwóch etapach.
Jak działa dwuetapowy trening RAVE
Wyobraź sobie naukę muzyka w dwóch fazach:
-
Faza 1: nauka słuchania (uczenie reprezentacji)
- Enkoder uczy się ściskać audio do zwartego zestawu liczb, czyli przestrzeni ukrytej
- Dekoder uczy się rekonstruować audio z tych liczb
- Trening wykorzystuje widmową funkcję straty, która porównuje zawartość częstotliwościową oryginalnego i zrekonstruowanego audio
-
Faza 2: nauka improwizacji (dostrajanie przeciwstawne)
- Enkoder zostaje zamrożony, ponieważ już umie słuchać
- Dodawana jest sieć „dyskryminatora”: krytyk oceniający, czy zrekonstruowane audio brzmi prawdziwie
- Dekoder uczy się z tej informacji zwrotnej tworzyć bardziej przekonujące audio
Kluczowe elementy techniczne
- Filtry PQMF: RAVE dzieli audio na kilka podpasm częstotliwości przed przetwarzaniem, co zwiększa wydajność
- Tryby przyczynowy i nieprzyczynowy: tryb przyczynowy poświęca część jakości na rzecz mniejszego opóźnienia podczas występów na żywo
- Wiele konfiguracji: od lekkiej "raspberry", działającej na Raspberry Pi, do wysokiej jakości "v3"
Szczegóły implementacji znajdziesz w oficjalnym repozytorium RAVE na GitHub, zawierającym pliki konfiguracji i definicje modeli.

Jak trenować modele RAVE na własnych danych audio?
Chcesz modelu zmieniającego twój głos w saksofon? Trening RAVE wymaga znajomości Python i GPU. Oficjalne repozytorium RAVE dokumentuje cały proces.
Wymagania dotyczące przygotowania zbioru danych
Do treningu modelu RAVE potrzebujesz:
- Od 2 do 3 godzin czystego audio; im więcej, tym lepiej
- Nagrań o jakości studyjnej, ponieważ RAVE uczy się wszystkiego, także szumu i pogłosu
- Różnorodnych dźwięków, jeśli zależy ci na wszechstronności
Aby zbudować zbiór danych z pełnych miksów, najpierw wyodrębnij instrument przez wysokiej jakości podział na ścieżki AI. Artefakty separacji również trafią do modelu, więc używaj możliwie najczystszych ścieżek. Poradnik podziału na ścieżki pokazuje, jak zrobić to w Neural Analog.
Zainstaluj RAVE i przygotuj zbiór danych
Najpierw zainstaluj PyTorch i TorchAudio dla swojego GPU, potem RAVE. Potrzebujesz również FFmpeg; w środowisku conda zainstaluj go przez conda:
pip install acids-rave
conda install ffmpeg
Przetwarzanie wstępne zamienia pliki audio na format zbioru danych RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Użyj --channels 1 dla mono lub --channels 2 dla stereo. Dodaj --lazy, aby trenować bezpośrednio na skompresowanych plikach, takich jak MP3, ale spodziewaj się znacznie większego obciążenia CPU podczas treningu. Wszystkie parametry znajdziesz w dokumentacji przygotowania zbioru danych RAVE.
Proces treningu i konfiguracje RAVE
Uruchom trening, podając nazwę konfiguracji:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Wybierz konfigurację pasującą do swojego GPU. Minimalne wymagania pamięci GPU pochodzą z oficjalnego README:
| Konfiguracja | Min. pamięć GPU | Zastosowanie |
|---|---|---|
raspberry | 5 GB | Lekki model do pracy w czasie rzeczywistym na Raspberry Pi 4 |
onnx | 6 GB | v1 bez szumu do eksportu ONNX |
v1 | 8 GB | Oryginalny model ciągły |
v2_small | 8 GB | Transfer barwy dźwięków stacjonarnych |
v2 | 16 GB | Ulepszony model ciągły i dobry wybór domyślny |
discrete | 18 GB | Model dyskretny podobny do SoundStream lub EnCodec |
v3 | 32 GB | Najwyższa jakość z transferem stylu (AdaIN) |
Konfigurację można łączyć z opcjami takimi jak causal (mniejsze opóźnienie) lub noise. Społecznościowy notatnik Colab dla RAVEv2, do którego odsyła README, umożliwia trening na GPU Google, jeśli nie masz własnego.
Czego spodziewać się podczas treningu:
- Faza 1 (~1 mln kroków): jakość audio początkowo jest słaba i stopniowo się poprawia
- Faza 2 (trening przeciwstawny): jakość wyraźnie wzrasta
- Łączny czas: około 3 dni na GPU RTX 3080
Notatniki do treningu RAVE przygotowane przez społeczność prowadzą przez proces krok po kroku.
Eksport modeli RAVE do pracy w czasie rzeczywistym
Sposób eksportu jest ważny dla pracy w czasie rzeczywistym. Użyj flagi --streaming, aby włączyć buforowane sploty, które zapobiegają artefaktom w postaci trzasków:
rave export --run /path/to/your/run --streamingWynikiem jest plik TorchScript .ts, który może wczytać nn~. Parametry eksportu i rozwiązywanie problemów opisuje dokumentacja eksportu RAVE.
Uruchamianie modelu RAVE i opcje pracy w czasie rzeczywistym
Nie chcesz czekać 3 dni na trening? Możesz wypróbować gotowe modele RAVE w kilku narzędziach. Wczytują one również modele wytrenowane samodzielnie, a FAQ o używaniu wytrenowanego modelu w DAW wymienia wtyczki dla poszczególnych typów modeli.
Neutone FX: darmowa wtyczka VST/AU dla modeli RAVE
Neutone FX to darmowa wtyczka VST/AU obsługująca modele RAVE. To oryginalna wtyczka Neutone z 2022 roku, dziś rozwijana jako otwarta platforma. Zainstaluj ją, aby wczytywać kolekcję gotowych modeli bezpośrednio w DAW, takim jak Ableton, Logic, Reaper i inne.

RAVE VST od IRCAM: beta, projekt zarchiwizowany
IRCAM udostępnił również własny RAVE VST, z wersjami VST, AU i samodzielną aplikacją. Ma dwa tryby: reconstruction przetwarza audio z DAW, a prior samodzielnie generuje dźwięk, przemieszczając się po przestrzeni ukrytej. Model Explorer pobiera gotowe modele; możesz też importować własne, jeśli wyeksportujesz je z --stereo true.
Repozytorium rave_vst zarchiwizowano w czerwcu 2023 roku, więc nie oczekuj poprawek. Dla Windows istnieje tylko eksperymentalna samodzielna aplikacja, a użytkownicy Mac z M1 muszą sami skompilować wersję dla siebie. Do pracy w czasie rzeczywistym twórcy zalecają zamiast tego nn~.
Integracja Max/MSP i Pure Data przez nn~
Podczas występów na żywo moduł zewnętrzny nn~ wczytuje modele RAVE bezpośrednio w Max/MSP i Pure Data. Umożliwia bezpośrednie manipulowanie przestrzenią ukrytą oraz adaptacyjną normalizację instancji (Adaptive Instance Normalization) do transferu stylu. Działa też na platformach wbudowanych, takich jak Raspberry Pi, do przenośnych instalacji. Te same płytki obsługują neuronowe wtyczki wzmacniaczy gitarowych, takie jak ToobAmp i Stompbox. Jeśli masz NVIDIA Jetson Nano, pamiętaj, że nie ma analogowego wyjścia audio: najpierw dodaj kartę dźwiękową I2S, na przykład Raspiaudio Audio+.
Ograniczenia wydajności i techniczne zastrzeżenia dotyczące RAVE
Poznaj te ograniczenia, zanim zaczniesz polegać na RAVE:
- Opóźnienie: nawet w trybie przyczynowym spodziewaj się zauważalnej latencji, także na wydajnych Apple Silicon. W studiu to dopuszczalne, ale dokładnie przetestuj RAVE, zanim użyjesz go jako instrumentu na żywo.
- Przyspieszenie GPU: model używa wielu małych splotów ograniczonych szybkością dostępu do pamięci, a nie mocą obliczeniową, więc słabo się zrównolegla. W czasie rzeczywistym narzut GPU często przewyższa korzyści, chyba że przetwarzasz wsadowo.
- Jakość audio: RAVE może brzmieć imponująco, ale może nie dorównać wierności tradycyjnej syntezy lub bardziej zaawansowanych modeli neuronowych, na przykład dyfuzyjnych.
- Trudny trening: trenowanie modelu RAVE wymaga wiedzy o uczeniu maszynowym i przetwarzaniu audio oraz mocnego sprzętu.
Następcy RAVE: Neutone Morpho i model AFTER
Neutone Morpho: komercyjny rozwój RAVE (2024)
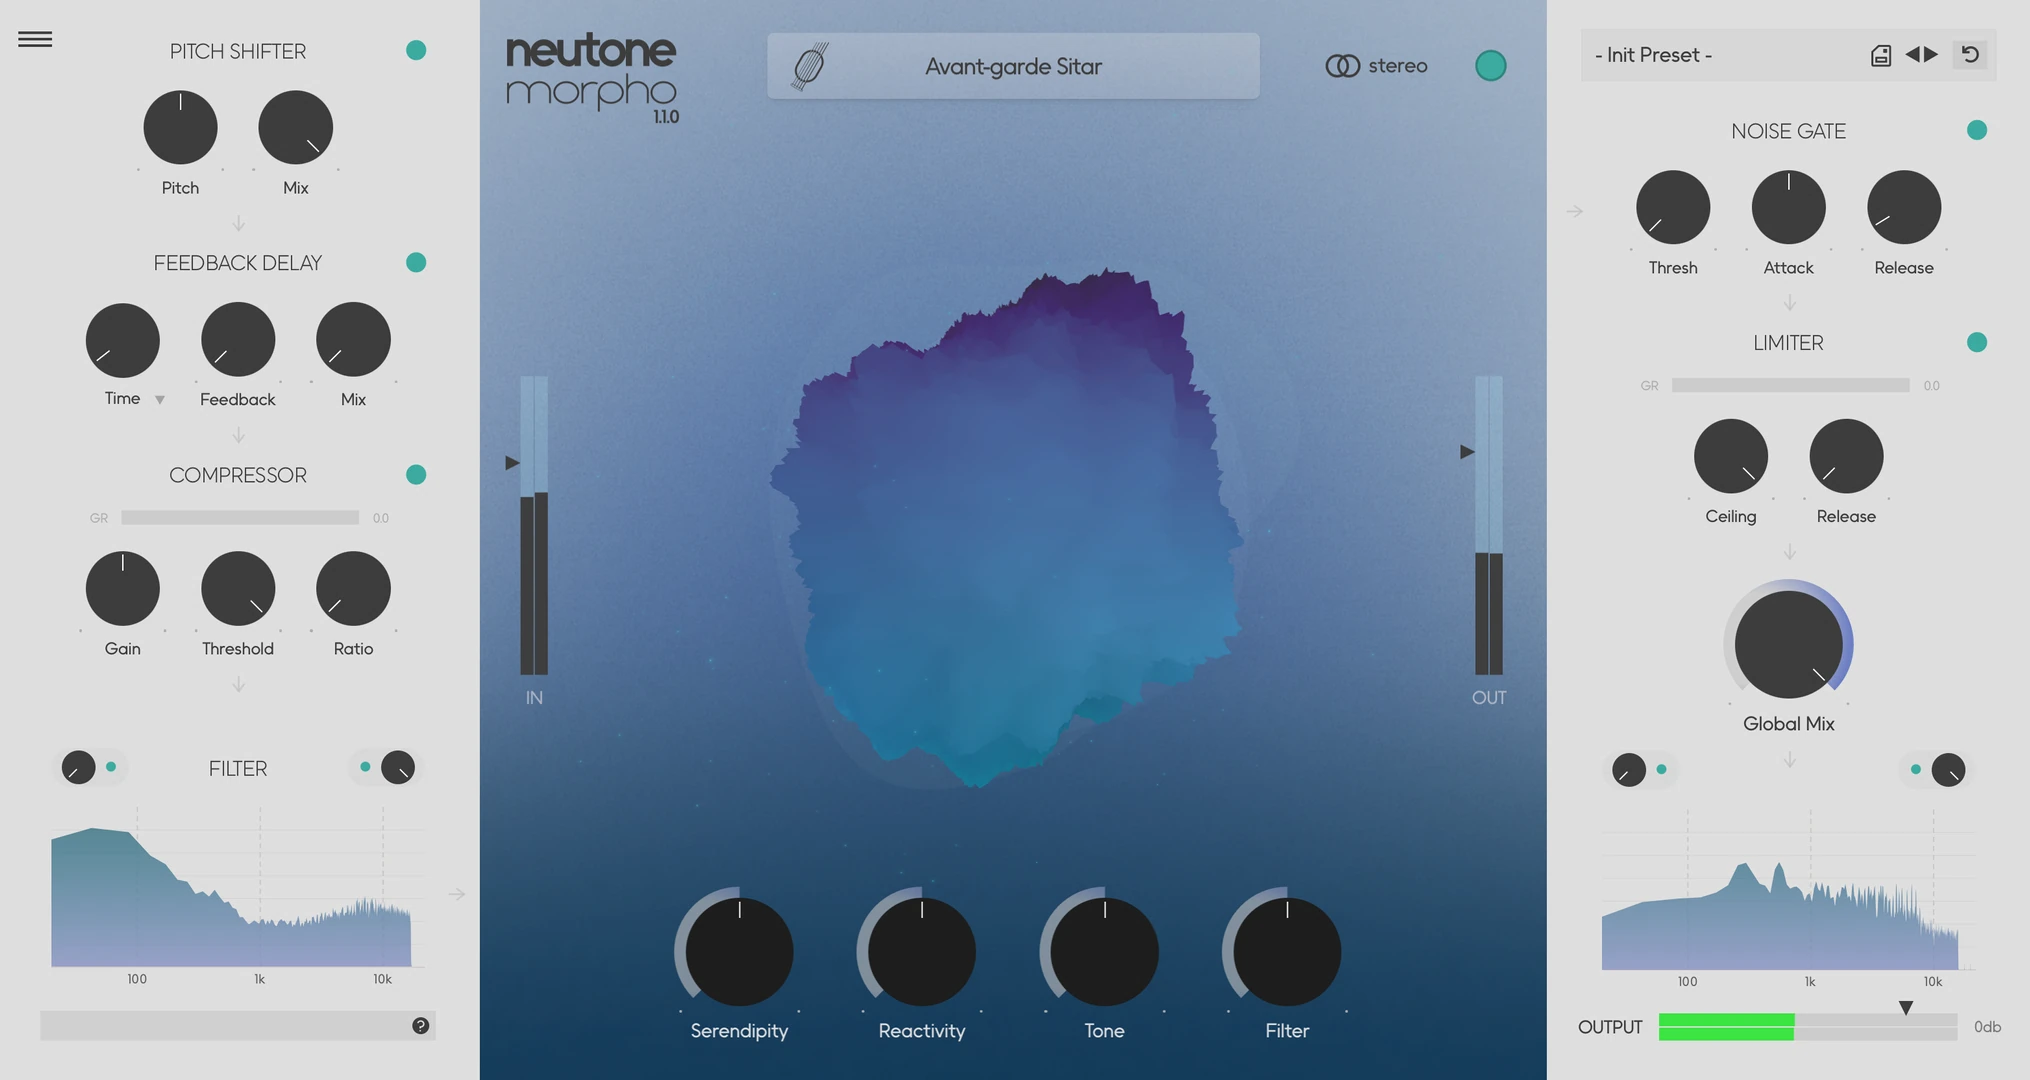
W lutym 2024 roku zespół Neutone kierowany przez Nao Tokui udostępnił Morpho, komercyjnego następcę darmowej wtyczki FX. RAVE jest silnikiem badawczym o otwartym kodzie. Morpho opakowuje podobną technologię w dopracowany produkt dla muzyków i producentów kosztem elastyczności.
Model AFTER: dyfuzyjna alternatywa od IRCAM
Ten sam zespół IRCAM ACIDS udostępnił też AFTER (Audio Features Transfer and Exploration in Real-time), model dyfuzyjny. Ma oferować więcej możliwości regulacji, z kontrolą barwy w czasie rzeczywistym jak w tradycyjnym syntezatorze.
Aby zmienić styl całego utworu na podstawie polecenia tekstowego, a nie pojedynczy dźwięk, remiks AI zachowuje ścieżkę wokalu i generuje na nowo warstwę instrumentalną za pomocą Stable Audio 3.
FAQ o RAVE
Gdzie mogę pobrać gotowe modele RAVE?
IRCAM udostępnia modele strumieniowe na oficjalnej stronie modeli RAVE. Neutone FX i RAVE VST także pobierają modele wewnątrz wtyczki. Zanim użyjesz modelu w komercyjnym wydaniu, sprawdź jego licencję.
Ile audio potrzebuję do treningu RAVE?
Zaplanuj od 2 do 3 godzin czystego audio z jednego źródła. RAVE uczy się wszystkiego w nagraniach, w tym szumu i pogłosu pomieszczenia. Dane dla DDSP i AFTER znajdziesz w odpowiedzi na pytanie ile danych potrzeba do treningu modelu.
Czy mogę trenować RAVE na Mac?
To nie jest dobry wybór. Poradnik RAVE od UAL Creative Computing Institute wymaga GPU NVIDIA z obsługą CUDA i przynajmniej 8 GB pamięci oraz odradza macOS. Zamiast tego użyj GPU w chmurze lub społecznościowego notatnika Colab.
Dlaczego mój model RAVE trzaska w Max?
Model wyeksportowano bez --streaming. Wyeksportuj go ponownie z tą flagą.
RAVE czy DDSP?
DDSP potrzebuje tylko około 10 minut audio, ale modeluje wyłącznie monofoniczne instrumenty o określonej wysokości dźwięku. RAVE obsługuje dowolny dźwięk, także perkusję, głosy i tekstury, lecz wymaga godzin audio i dni treningu.