Model AFTER od IRCAM: konfiguracja, gotowe modele i trenowanie
Model AFTER od IRCAM to neuronowy model syntezy dźwięku, którym muzycy mogą sterować w czasie rzeczywistym i polifonicznie za pomocą znajomych sygnałów wejściowych: nut MIDI lub wysokości i głośności innego sygnału audio.
Aby go wypróbować, pobierz gotowe modele i patche Max z udostępnionego folderu IRCAM, zainstaluj rozszerzenie nn~ i otwórz patch w Max lub urządzenia Max for Live w Ableton Live. Aby wytrenować własny model, zainstaluj pakiet Python z GitHub i wykonaj opisane poniżej kroki.

Czym jest model AFTER?
AFTER to skrót od Audio Features Transfer and Exploration in Real-time. Oddziela ekspresję muzyczną (strukturę) od tożsamości dźwięku (barwy), dzięki czemu można zmieniać je niezależnie.
Wcześniejsze modele działające jak „czarna skrzynka” generują dźwięk z abstrakcyjnych współrzędnych latentnych, którymi trudno sterować. AFTER zamiast tego przyjmuje konkretne parametry sterujące. Możesz zastosować wykonanie jednego instrumentu (na przykład krzywą wysokości głosu) do wyuczonej barwy innego albo grać modelem wyłącznie przez MIDI. W przeciwieństwie do DDSP, które śledzi tylko jedną wysokość dźwięku naraz, AFTER może grać akordy z MIDI, jeśli zostało wytrenowane na danych polifonicznych.
Aby zmienić styl gotowej piosenki zamiast pojedynczego wykonania, remiks AI zachowuje ścieżkę wokalu i generuje od nowa podkład instrumentalny na podstawie promptu tekstowego.
Historia i pochodzenie: zespół ACIDS
AFTER powstało podczas badań doktoranckich, które Nils Demerlé prowadził w IRCAM (Instytucie Badań i Koordynacji Akustyki i Muzyki) w Paryżu. Pracował w grupie ACIDS, w której działali też Ninon Devis, Philippe Esling, Guillaume Doras i David Genova, aby rozwiązać problem wariacyjnych autoenkoderów (VAE).
VAE, takie jak model RAVE, dobrze kompresują audio, ale wysokość i barwa często mieszają się w tych samych wymiarach latentnych („splątanie”), dlatego trudno kontrolować je osobno. Zespół przedstawił rozwiązanie w pracy „Łączenie sterowania dźwiękiem i transferu stylu z wykorzystaniem dyfuzji latentnej” w sierpniu 2024 roku. Celem było przeniesienie jakości dźwięku modeli dyfuzyjnych do muzycznego wykonania na żywo.

Jak działa AFTER? Architektura dyfuzji latentnej
AFTER wykorzystuje warunkową dyfuzję latentną. Zamiast powoli generować surowe próbki audio jedna po drugiej, działa w skompresowanej przestrzeni „latentnej”, którą zapewnia wstępnie wytrenowany autoenkoder.

Struktura a barwa
AFTER dzieli dźwięk na dwa strumienie:
- Struktura (cechy lokalne): Konkretne parametry sterujące zmieniające się w czasie.
- Wejście audio: Wysokość (f_0) i głośność (z korekcją A).
- Wejście MIDI: Polifoniczna reprezentacja w edytorze piano roll.
- Barwa (cechy globalne): Wyuczony wektor reprezentacji, który pozostaje stały w czasie i opisuje tożsamość dźwięku (na przykład „wiolonczela”, „gitara z przesterem”).
Etapy przetwarzania
- Kompresja (kodek): Neuronowy kodek audio (zwykle autoenkoder RAVE) kompresuje wejściowy dźwięk do wektorów latentnych o małej liczbie wymiarów.
- Warunkowanie: System wyodrębnia krzywe wysokości i głośności (za pomocą narzędzi takich jak CREPE lub Basic Pitch), aby zbudować warunek struktury.
- Dyfuzja latentna: Warunkowa sieć U-Net przewiduje latentne reprezentacje audio na podstawie struktury i docelowej barwy.
- Dekodowanie: Kodek audio dekoduje przewidywane reprezentacje latentne z powrotem do surowych przebiegów fali.
Jak trenować modele AFTER
Trenowanie ma trzy etapy. Repozytorium AFTER na GitHub zawiera kompletne skrypty. Zainstaluj AFTER w środowisku Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Przygotowanie zbioru danych
Potrzebujesz zbioru danych audio, zwykle ponad 1 godziny dla dobrych wyników (ile danych potrzebują DDSP, RAVE i AFTER). Jeśli wybrany instrument jest zmiksowany z innymi, najpierw wyodrębnij go przez wysokiej jakości separację ścieżek AI.
- Przetwarzanie wstępne: Skrypt
after prepare_datasetanalizuje audio i wyodrębnia cechy referencyjne. - Narzędzia: Wykorzystuje Basic Pitch od Spotify do transkrypcji MIDI oraz narzędzia do wyodrębniania głośności z audio. Dane są przechowywane w bazie LMDB, która zapewnia szybki dostęp podczas treningu.
- Najpierw sprawdź transkrypcję: Aby usłyszeć, jak dobrze twój materiał zamienia się w nuty przed długim treningiem, wypróbuj konwersję audio na MIDI na krótkim fragmencie. Poradnik konwersji audio na MIDI opisuje kroki w Studio.
Najpierw przygotuj zbiór przebiegów fali dla autoenkodera:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Trenowanie autoenkodera (kodeka)
Przed trenowaniem modelu dyfuzyjnego potrzebujesz „kodeka” kompresującego audio.
- Opcja A: Wytrenuj nowy przyczynowy autoenkoder z wieloskalową widmową funkcją straty i adwersarialną zawiasową funkcją straty.
- Opcja B: Użyj gotowego kodeka z udostępnionego folderu IRCAM lub modelu RAVE jako podstawy. Będzie to szybsze, jeśli istnieje już dobry model dla twojego rodzaju audio.
Dla opcji A wytrenuj i wyeksportuj autoenkoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Eksport tworzy export.ts do przetwarzania poza czasem rzeczywistym i export_stream.ts do pracy w czasie rzeczywistym.
3. Trenowanie modelu dyfuzyjnego
Na tym etapie model uczy się, jak sygnały sterujące przekładają się na dźwięk.
- Cel: Model minimalizuje błąd przewidywania szumu (MSE). Innymi słowy, uczy się usuwać szum krok po kroku, aż pozostanie docelowy dźwięk.
- Rozdzielenie cech: Kryterium adwersarialne karze model, gdy enkoder barwy przechwytuje informacje o wysokości dźwięku. Dzięki temu oba parametry sterujące pozostają niezależne.
Zakoduj audio za pomocą kodeka, a następnie wytrenuj model dyfuzyjny:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Eksport do pracy w czasie rzeczywistym
Wyeksportuj za pomocą after export dla urządzenia Audio-to-Audio lub after export_midi dla urządzenia MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Eksport zapisuje także mapę latentną .png. README zaleca przechowywanie jej razem z plikiem .ts.
Jak używać AFTER w czasie rzeczywistym: Max for Live i Max/MSP
Integracja z Max for Live (M4L)
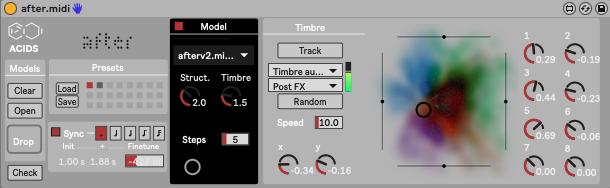
Dla użytkowników Ableton Live AFTER udostępnia dwa urządzenia Max for Live, które łączą Live z modelem.
Pierwsze to Audio-to-Audio. Wykorzystuje wejście sidechain (na przykład twój głos) do sterowania wysokością i głośnością modelu neuronowego.
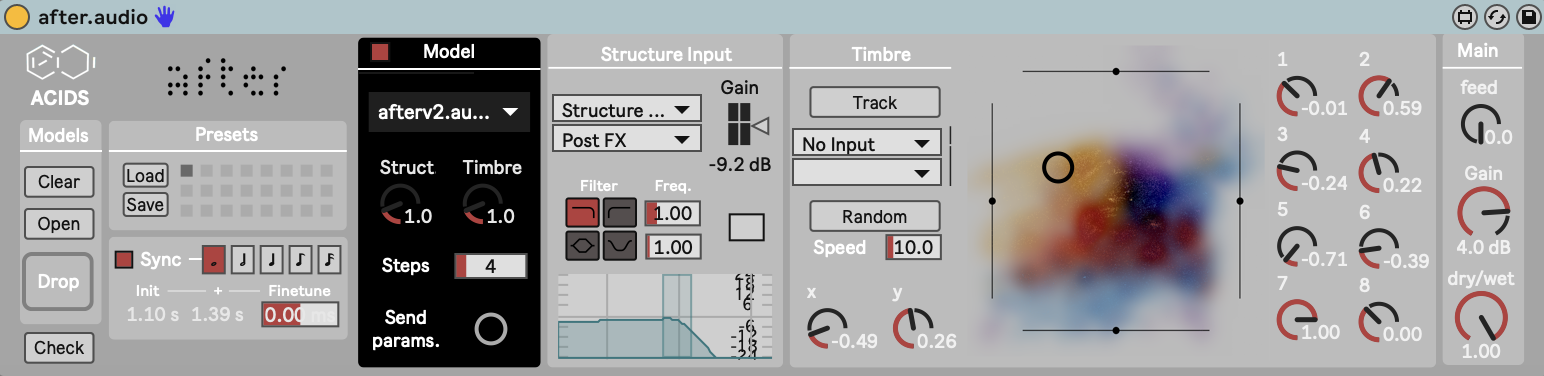
Drugie to MIDI-to-Audio. Przekazuje modelowi nuty MIDI jako wejściową strukturę piano roll. Dzięki architekturze dyfuzji latentnej obsługuje polifonię, jeśli model wytrenowano na danych polifonicznych. Aby zagrać to samo MIDI przy użyciu nagranych sampli, wczytaj instrument SFZ w sforzando.
Max/MSP i nn~
Dla programistów AFTER działa w Max/MSP przez rozszerzenie nn~, które wczytuje wyeksportowane modele TorchScript (pliki .ts) bezpośrednio do patcha.
Jakie jest opóźnienie AFTER?
AFTER działa inaczej niż jednoprzebiegowe modele jednokierunkowe, takie jak RAVE, ponieważ dyfuzja wymaga kilku kroków.
Opóźnienie: Każdy krok odszumiania dodaje obliczenia, więc implementacja działająca w czasie rzeczywistym ma zwykle od 200 do 500 ms opóźnienia. AFTER generuje audio na bieżąco, ale gra przypomina raczej korzystanie z przewidywalnego opóźnienia niż z instrumentu reagującego natychmiast. Podczas występów niektórzy artyści stosują podejście z „zapętlaniem”: AFTER odtwarza każdą frazę w następnym cyklu pętli. Do instrumentu reagującego natychmiast lepiej nadają się małe sieci, takie jak w darmowych neuronowych wtyczkach wzmacniaczy gitarowych.
Wykorzystanie GPU: Wnioskowanie działa przez nn~, które obsługuje przyspieszenie GPU, ale w praktyce użytkownicy zauważają niewielką różnicę. Ponieważ dyfuzja jest iteracyjna, obciążenie CPU pozostaje wysokie w porównaniu ze standardowym DSP.
Pytania o AFTER
Czy istnieje wtyczka VST AFTER?
Nie. Oficjalne repozytorium oferuje urządzenia Max for Live dla Ableton Live i patche Max działające przez nn~. Nie wspomina o wtyczce VST ani AU.
Gdzie są gotowe modele AFTER?
IRCAM udostępnia gotowe modele, gotowe kodeki i patche Max w udostępnionym folderze, do którego prowadzi link w README AFTER.
Czy AFTER to to samo co IRCAMAX?
Nie. IRCAMAX to komercyjny pakiet urządzeń Max for Live od IRCAM, sprzedawany przez Ableton. AFTER jest modelem badawczym zespołu ACIDS w IRCAM z publicznym kodem na GitHub.
AFTER czy RAVE?
RAVE jest modelem jednoprzebiegowym o niższym opóźnieniu, ale jego parametry sterujące to abstrakcyjne wymiary latentne. AFTER dodaje do kodeka konkretne sterowanie wysokością, głośnością i polifonicznym MIDI, kosztem większego opóźnienia oraz obciążenia CPU.