IRCAM AFTER: cài đặt, mô hình có sẵn và huấn luyện
Mô hình AFTER của IRCAM là mô hình tổng hợp âm thanh bằng mạng nơron mà nhạc sĩ có thể điều khiển theo thời gian thực và đa âm bằng các đầu vào quen thuộc: nốt MIDI hoặc cao độ và độ lớn của một tín hiệu âm thanh khác.
Để dùng thử, hãy tải các mô hình huấn luyện sẵn và patch Max từ thư mục dùng chung của IRCAM, cài đối tượng ngoài nn~, rồi mở patch trong Max hoặc các thiết bị Max for Live trong Ableton Live. Để huấn luyện mô hình riêng, hãy cài gói Python từ GitHub và làm theo các bước huấn luyện dưới đây.

Mô hình AFTER là gì?
AFTER là viết tắt của Audio Features Transfer and Exploration in Real-time. Nó tách cách thể hiện âm nhạc (cấu trúc) khỏi đặc trưng của âm thanh (âm sắc), để bạn có thể thay đổi từng phần độc lập.
Các mô hình “hộp đen” trước đây tạo âm thanh từ những tọa độ tiềm ẩn trừu tượng khó điều khiển. Thay vào đó, AFTER sử dụng các tín hiệu điều khiển tường minh. Bạn có thể áp dụng cách chơi của một nhạc cụ, chẳng hạn đường cao độ của giọng hát, vào âm sắc đã học của nhạc cụ khác, hoặc chơi mô hình hoàn toàn bằng MIDI. Khác với DDSP chỉ bám theo một cao độ tại mỗi thời điểm, AFTER có thể chơi hợp âm từ MIDI khi được huấn luyện trên dữ liệu đa âm.
Để đổi phong cách của một bài hát hoàn chỉnh thay vì một phần biểu diễn riêng lẻ, AI remix giữ lại stem giọng hát và tái tạo phần nhạc không lời từ lời nhắc văn bản.
Lịch sử và nguồn gốc: nhóm ACIDS
AFTER xuất phát từ nghiên cứu tiến sĩ của Nils Demerlé tại IRCAM (Viện Nghiên cứu và Điều phối Âm học/Âm nhạc) ở Paris. Ông làm việc trong nhóm ACIDS cùng Ninon Devis, Philippe Esling, Guillaume Doras và David Genova để giải quyết một hạn chế của bộ tự mã hóa biến phân (VAE).
Các VAE như mô hình RAVE nén âm thanh tốt, nhưng cao độ và âm sắc thường bị trộn trong cùng các chiều tiềm ẩn, gọi là “đan xen”, nên khó điều khiển riêng. Nhóm trình bày giải pháp trong bài báo “Kết hợp điều khiển âm thanh và chuyển đổi phong cách bằng khuếch tán tiềm ẩn” vào tháng 8 năm 2024. Mục tiêu là mang chất lượng âm thanh của mô hình khuếch tán vào biểu diễn âm nhạc trực tiếp.

AFTER hoạt động như thế nào? Kiến trúc khuếch tán tiềm ẩn
AFTER sử dụng khuếch tán tiềm ẩn có điều kiện. Thay vì tạo từng mẫu âm thanh thô một cách chậm chạp, nó xử lý trong không gian “tiềm ẩn” đã nén do bộ tự mã hóa huấn luyện sẵn cung cấp.

Cấu trúc và âm sắc
AFTER chia âm thanh thành hai luồng:
- Cấu trúc (đặc trưng cục bộ): Các tín hiệu điều khiển tường minh thay đổi theo thời gian.
- Đầu vào âm thanh: Cao độ (f_0) và độ lớn (trọng số A).
- Đầu vào MIDI: Biểu diễn đa âm trên lưới nốt piano.
- Âm sắc (đặc trưng toàn cục): Vectơ nhúng đã học, không đổi theo thời gian và biểu thị đặc trưng của âm thanh, chẳng hạn “đàn cello” hoặc “guitar méo tiếng”.
Các bước xử lý
- Nén (bộ mã hóa/giải mã): Bộ mã hóa/giải mã âm thanh nơron, thường là bộ tự mã hóa RAVE, nén âm thanh đầu vào thành các vectơ tiềm ẩn có số chiều thấp.
- Tạo điều kiện: Hệ thống trích xuất các đường cao độ và độ lớn bằng công cụ như CREPE hoặc Basic Pitch để tạo điều kiện về cấu trúc.
- Khuếch tán tiềm ẩn: U-Net có điều kiện dự đoán biểu diễn tiềm ẩn của âm thanh dựa trên cấu trúc và âm sắc đích.
- Giải mã: Bộ mã hóa/giải mã âm thanh chuyển các biểu diễn tiềm ẩn đã dự đoán trở lại thành dạng sóng thô.
Cách huấn luyện mô hình AFTER
Huấn luyện gồm ba giai đoạn. Kho GitHub của AFTER chứa đầy đủ tập lệnh. Hãy cài AFTER trong môi trường Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Chuẩn bị tập dữ liệu
Bạn cần một tập dữ liệu âm thanh, thường là hơn 1 giờ để có kết quả tốt (lượng dữ liệu cần cho DDSP, RAVE và AFTER). Nếu nhạc cụ cần dùng đang lẫn với các nhạc cụ khác, hãy tách nó trước bằng tách stem AI chất lượng cao.
- Tiền xử lý: Tập lệnh
after prepare_datasetphân tích âm thanh và trích xuất các đặc trưng chuẩn làm mục tiêu học. - Công cụ: Nó dùng Basic Pitch của Spotify để chép nốt MIDI và các công cụ trích xuất độ lớn cho âm thanh. Dữ liệu được lưu trong cơ sở dữ liệu LMDB để truy cập nhanh khi huấn luyện.
- Kiểm tra chép nốt trước: Để nghe xem tư liệu của bạn chuyển thành nốt tốt đến đâu trước khi bắt đầu một lần huấn luyện dài, hãy thử chuyển âm thanh sang MIDI với một đoạn ngắn. Hướng dẫn chuyển âm thanh sang MIDI trình bày các bước trong Studio.
Trước hết, hãy chuẩn bị tập dữ liệu dạng sóng cho bộ tự mã hóa:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Huấn luyện bộ tự mã hóa (bộ mã hóa/giải mã)
Trước khi huấn luyện mô hình khuếch tán, bạn cần một “bộ mã hóa/giải mã” để nén âm thanh.
- Phương án A: Huấn luyện bộ tự mã hóa nhân quả mới với hàm mất mát phổ đa thang đo và hàm mất mát bản lề đối kháng.
- Phương án B: Dùng bộ mã hóa/giải mã huấn luyện sẵn từ thư mục dùng chung của IRCAM, hoặc dùng mô hình RAVE làm phần xử lý nền. Cách này nhanh hơn nếu đã có mô hình tốt cho loại âm thanh của bạn.
Với phương án A, hãy huấn luyện và xuất bộ tự mã hóa:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
Quá trình xuất tạo export.ts để xử lý không theo thời gian thực và export_stream.ts để xử lý theo thời gian thực.
3. Huấn luyện mô hình khuếch tán
Ở giai đoạn này, mô hình học cách ánh xạ tín hiệu điều khiển thành âm thanh.
- Mục tiêu: Mô hình giảm thiểu sai số dự đoán nhiễu (MSE). Nói cách khác, nó học cách loại bỏ nhiễu từng bước cho đến khi chỉ còn âm thanh đích.
- Tách biệt: Một tiêu chí đối kháng phạt mô hình mỗi khi bộ mã hóa âm sắc thu nhận thông tin về cao độ. Điều này giữ cho hai phần điều khiển độc lập.
Hãy mã hóa âm thanh bằng bộ mã hóa/giải mã, rồi huấn luyện mô hình khuếch tán:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Xuất để dùng theo thời gian thực
Xuất bằng after export cho thiết bị Audio-to-Audio, hoặc after export_midi cho thiết bị MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
Quá trình xuất còn ghi bản đồ tiềm ẩn dạng .png. README yêu cầu giữ nó cùng tệp .ts.
Cách dùng AFTER theo thời gian thực: Max for Live và Max/MSP
Tích hợp Max for Live (M4L)
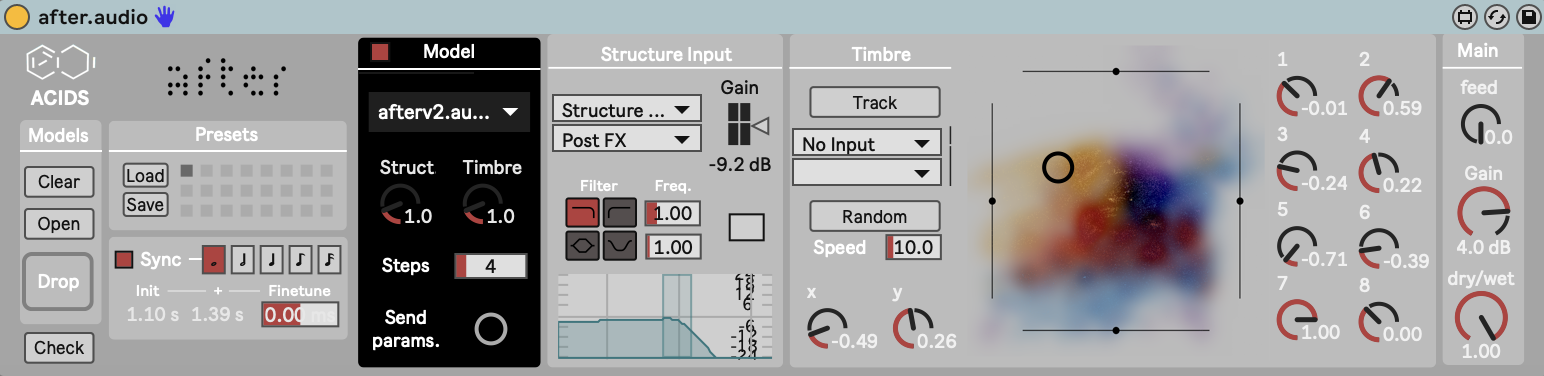
Với người dùng Ableton Live, AFTER cung cấp hai thiết bị Max for Live kết nối Live với mô hình.
Thiết bị thứ nhất là Audio-to-Audio. Nó dùng đầu vào sidechain, chẳng hạn giọng nói của bạn, để điều khiển cao độ và độ lớn của mô hình nơron.
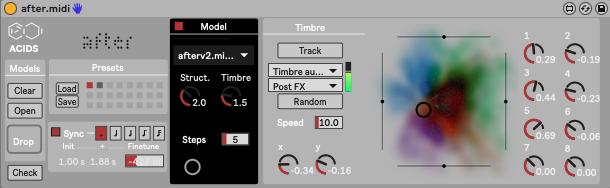
Thiết bị thứ hai là MIDI-to-Audio. Nó đưa nốt MIDI vào mô hình dưới dạng đầu vào cấu trúc trên lưới nốt piano. Nhờ kiến trúc khuếch tán tiềm ẩn, mô hình hỗ trợ đa âm khi được huấn luyện trên dữ liệu đa âm. Để chơi cùng MIDI đó bằng các mẫu âm thanh đã thu thay thế, hãy nạp nhạc cụ SFZ trong sforzando.
Max/MSP và nn~
Với nhà phát triển, AFTER chạy trong Max/MSP qua đối tượng ngoài nn~, có thể nạp trực tiếp mô hình TorchScript đã xuất (tệp .ts) vào patch.
Độ trễ của AFTER là bao nhiêu?
AFTER hoạt động khác các mô hình truyền thẳng chỉ chạy một lượt như RAVE, vì khuếch tán cần nhiều bước.
Độ trễ: Mỗi bước khử nhiễu làm tăng khối lượng tính toán, nên bản triển khai thời gian thực thường có độ trễ 200 đến 500 ms. AFTER tạo âm thanh ngay trong quá trình chơi, nhưng cảm giác giống chơi qua một độ trễ có thể dự đoán hơn là một nhạc cụ phản hồi tức thì. Khi biểu diễn trực tiếp, một số nghệ sĩ dùng cách “phát lặp”: AFTER phát lại từng câu nhạc ở chu kỳ lặp tiếp theo. Nếu cần nhạc cụ phản hồi tức thì, các mạng nhỏ như trong plugin ampli guitar nơron miễn phí phù hợp hơn.
Sử dụng GPU: Suy luận chạy qua nn~, có hỗ trợ tăng tốc GPU, nhưng thực tế người dùng nhận thấy ít khác biệt. Do khuếch tán là quá trình lặp, mức sử dụng CPU vẫn cao so với DSP thông thường.
Câu hỏi thường gặp về AFTER
Có plugin AFTER VST không?
Không. Kho mã chính thức cung cấp thiết bị Max for Live cho Ableton Live và các patch Max chạy qua nn~. Kho này không đề cập plugin VST hay AU.
Mô hình AFTER huấn luyện sẵn ở đâu?
IRCAM cung cấp mô hình huấn luyện sẵn, bộ mã hóa/giải mã huấn luyện sẵn và patch Max trong thư mục dùng chung được liên kết từ README của AFTER.
AFTER có giống IRCAMAX không?
Không. IRCAMAX là gói thiết bị Max for Live thương mại của IRCAM do Ableton bán. AFTER là mô hình nghiên cứu của nhóm ACIDS tại IRCAM, có mã nguồn công khai trên GitHub.
Nên chọn AFTER hay RAVE?
RAVE là mô hình chạy một lượt với độ trễ thấp hơn, nhưng điều khiển qua các chiều tiềm ẩn trừu tượng. AFTER bổ sung điều khiển tường minh về cao độ, độ lớn và MIDI đa âm trên nền bộ mã hóa/giải mã, đổi lại độ trễ và tải CPU cao hơn.