IRCAM AFTER: installatie, vooraf getrainde modellen en training
Het AFTER-model van IRCAM is een neuraal audiosynthesemodel dat muzikanten in realtime en polyfoon kunnen besturen met vertrouwde invoer: MIDI-noten of de toonhoogte en luidheid van een ander audiosignaal.
Om het te proberen download je de vooraf getrainde modellen en Max-patches uit de gedeelde map van IRCAM, installeer je de nn~-extensie en open je de patch in Max of de Max for Live-devices in Ableton Live. Wil je je eigen model trainen, installeer dan het Python-pakket van GitHub en volg de trainingsstappen hieronder.

Wat is het AFTER-model?
AFTER staat voor Audio Features Transfer and Exploration in Real-time. Het scheidt muzikale expressie (structuur) van de identiteit van de klank (klankkleur), zodat je beide onafhankelijk kunt veranderen.
Eerdere modellen werken als een 'zwarte doos': ze genereren geluid uit abstracte latente coördinaten die moeilijk te sturen zijn. AFTER gebruikt in plaats daarvan expliciete stuurparameters. Je kunt het spel van het ene instrument (zoals de toonhoogtecurve van een stem) toepassen op de aangeleerde klankkleur van een ander, of het model volledig via MIDI bespelen. Anders dan DDSP, dat maar één toonhoogte tegelijk volgt, kan AFTER MIDI-akkoorden spelen als het op polyfone data is getraind.
Wil je een voltooide song een andere stijl geven in plaats van één uitvoering, dan behoudt AI-remix het zangspoor en genereert het de instrumentale partij opnieuw op basis van een tekstprompt.
Geschiedenis en oorsprong: het ACIDS-team
AFTER komt voort uit het promotieonderzoek van Nils Demerlé bij IRCAM (Instituut voor Onderzoek en Coördinatie van Akoestiek en Muziek) in Parijs. Hij werkte in de ACIDS-groep met Ninon Devis, Philippe Esling, Guillaume Doras en David Genova om een beperking van variationale auto-encoders (VAE's) aan te pakken.
VAE's zoals het RAVE-model comprimeren audio goed, maar toonhoogte en klankkleur raken vaak vermengd in dezelfde latente dimensies ('verstrengeling'), waardoor ze moeilijk apart te sturen zijn. Het team presenteerde zijn oplossing in het artikel 'Audiobediening en stijloverdracht combineren met latente diffusie' in augustus 2024. Het doel was de audiokwaliteit van diffusiemodellen naar live muziekuitvoering te brengen.

Hoe werkt AFTER? Architectuur met latente diffusie
AFTER gebruikt voorwaardelijke latente diffusie. In plaats van langzaam ruwe audiosamples één voor één te genereren, werkt het in een gecomprimeerde 'latente' ruimte van een vooraf getrainde auto-encoder.

Structuur tegenover klankkleur
AFTER splitst geluid in twee stromen:
- Structuur (lokale kenmerken): Expliciete stuurparameters die in de tijd veranderen.
- Audio-invoer: Toonhoogte (f_0) en luidheid (A-gewogen).
- MIDI-invoer: Een polyfone pianorollweergave.
- Klankkleur (globale kenmerken): Een aangeleerde representatievector die in de tijd vast blijft en de identiteit van de klank weergeeft (bijvoorbeeld 'cello', 'gitaar met distortion').
Verwerkingsstappen
- Compressie (de codec): Een neurale audiocodec (meestal een RAVE-auto-encoder) comprimeert binnenkomende audio tot laagdimensionale latente vectoren.
- Voorwaarden opbouwen: Het systeem haalt toonhoogte- en luidheidscurves uit de audio (met tools zoals CREPE of Basic Pitch) om de structuurvoorwaarde te maken.
- Latente diffusie: Een voorwaardelijk U-Net voorspelt de latente audiorepresentaties op basis van de structuur en de gewenste klankkleur.
- Decoderen: De audiocodec decodeert de voorspelde latente representaties terug naar ruwe golfvormen.
Hoe je AFTER-modellen traint
Training bestaat uit drie fasen. De AFTER-repository op GitHub bevat alle scripts. Installeer AFTER in een Python 3.12-omgeving:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Dataset voorbereiden
Je hebt een audiodataset nodig, meestal meer dan 1 uur voor goede resultaten (hoeveel data DDSP, RAVE en AFTER elk nodig hebben). Is het gewenste instrument met andere instrumenten gemixt, isoleer het dan eerst met hoogwaardige AI-stemseparatie.
- Voorbewerking: Het script
after prepare_datasetanalyseert de audio en haalt de referentiekenmerken eruit. - Hulpmiddelen: Het gebruikt Spotify's Basic Pitch voor MIDI-transcriptie en luidheidsextractoren voor audio. De gegevens worden in een LMDB-database opgeslagen voor snelle toegang tijdens het trainen.
- Controleer eerst de transcriptie: Wil je horen hoe goed je materiaal in noten wordt omgezet voordat je lang gaat trainen, probeer dan audio-naar-MIDI-conversie op een kort fragment. De audio-naar-MIDI-handleiding beschrijft de stappen in Studio.
Bereid eerst een golfvormdataset voor de auto-encoder voor:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Auto-encoder trainen (de codec)
Voordat je het diffusiemodel traint, heb je een 'codec' nodig die audio comprimeert.
- Optie A: Train een nieuwe causale auto-encoder met een spectrale verliesfunctie op meerdere schalen en een adversariële scharnierverliesfunctie.
- Optie B: Gebruik een vooraf getrainde codec uit de gedeelde map van IRCAM of een RAVE-model als basis. Dat gaat sneller als er al een goed model voor jouw soort audio bestaat.
Train en exporteer de auto-encoder voor optie A:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
De export maakt export.ts voor verwerking buiten realtime en export_stream.ts voor realtime gebruik.
3. Diffusiemodel trainen
In deze fase leert het model hoe stuursignalen in geluid worden omgezet.
- Doel: Het model minimaliseert een voorspellingsfout voor ruis (MSE). Met andere woorden: het leert stap voor stap ruis te verwijderen totdat de gewenste klank overblijft.
- Ontkoppeling: Een adversarieel criterium bestraft het model zodra de klankkleurencoder toonhoogteinformatie oppikt. Zo blijven beide stuurparameters onafhankelijk.
Codeer je audio met de codec en train daarna het diffusiemodel:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Exporteren voor realtime gebruik
Exporteer met after export voor het Audio-to-Audio-device, of met after export_midi voor het MIDI-to-Audio-device:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
De export schrijft ook een latente kaart als .png. De README vraagt je die bij het .ts-bestand te bewaren.
AFTER in realtime gebruiken: Max for Live en Max/MSP
Integratie met Max for Live (M4L)
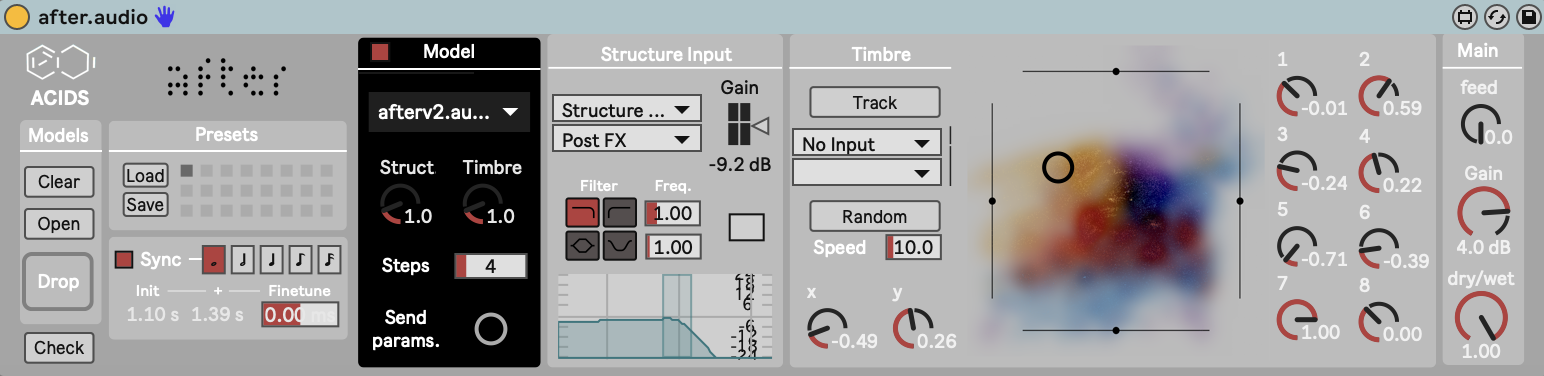
Voor Ableton Live-gebruikers biedt AFTER twee Max for Live-devices die Live met het model verbinden.
Het eerste is Audio-to-Audio. Dit gebruikt een sidechain-invoer (bijvoorbeeld je stem) om de toonhoogte en luidheid van het neurale model te sturen.
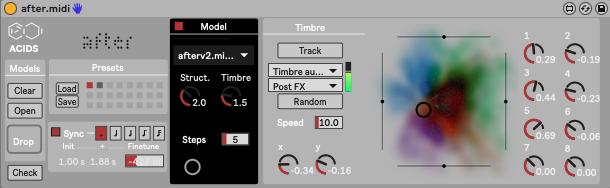
Het tweede is MIDI-to-Audio. Dit voert MIDI-noten als pianorollstructuur aan het model. Dankzij de architectuur met latente diffusie ondersteunt het polyfonie als het model op polyfone data is getraind. Wil je dezelfde MIDI met opgenomen samples afspelen, laad dan een SFZ-instrument in sforzando.
Max/MSP en nn~
Voor ontwikkelaars draait AFTER binnen Max/MSP via de nn~-extensie, die geëxporteerde TorchScript-modellen (.ts-bestanden) rechtstreeks in een patch laadt.
Hoeveel vertraging heeft AFTER?
AFTER werkt anders dan feedforwardmodellen die maar één doorgang maken, zoals RAVE, omdat diffusie meerdere stappen nodig heeft.
Vertraging: Elke stap van ruisverwijdering voegt rekenwerk toe, waardoor de realtime implementatie meestal 200 tot 500 ms vertraging heeft. AFTER genereert audio tijdens het spelen, maar het voelt meer alsof je door een voorspelbare vertraging speelt dan op een direct reagerend instrument. In livesets gebruiken sommige artiesten daarom een 'lusaanpak': AFTER speelt elke frase in de volgende luscyclus terug. Voor een instrument dat meteen reageert zijn kleine netwerken zoals die in gratis neurale gitaarversterkerplugins geschikter.
GPU-gebruik: Inferentie loopt via nn~, dat GPU-versnelling ondersteunt, maar in de praktijk merken gebruikers weinig verschil. Omdat diffusie iteratief is, blijft het CPU-gebruik hoog vergeleken met gewone DSP.
Veelgestelde vragen over AFTER
Is er een AFTER VST-plugin?
Nee. De officiële repository biedt Max for Live-devices voor Ableton Live en Max-patches die via nn~ draaien. Er wordt geen VST- of AU-plugin genoemd.
Waar staan de vooraf getrainde AFTER-modellen?
IRCAM host vooraf getrainde modellen, vooraf getrainde codecs en Max-patches in een gedeelde map waarnaar de AFTER-README verwijst.
Is AFTER hetzelfde als IRCAMAX?
Nee. IRCAMAX is een commercieel pakket Max for Live-devices van IRCAM dat door Ableton wordt verkocht. AFTER is een onderzoeksmodel van het ACIDS-team van IRCAM met openbare code op GitHub.
AFTER of RAVE?
RAVE verwerkt audio in één doorgang en heeft minder vertraging, maar de stuurparameters zijn abstracte latente dimensies. AFTER voegt expliciete toonhoogte-, luidheids- en polyfone MIDI-bediening toe boven op een codec, ten koste van meer vertraging en CPU-gebruik.