Modelo AFTER de IRCAM: instalación, modelos preentrenados y entrenamiento
El modelo AFTER de IRCAM es un modelo de síntesis de audio neuronal que los músicos pueden controlar en tiempo real y de forma polifónica mediante entradas familiares: notas MIDI o la altura y el nivel sonoro de otra señal de audio.
Para probarlo, descarga los modelos preentrenados y los patches de Max de la carpeta compartida de IRCAM, instala el objeto externo nn~ y abre el patch en Max o los dispositivos Max for Live en Ableton Live. Para entrenar tu propio modelo, instala el paquete de Python desde GitHub y sigue los pasos de entrenamiento que se indican más abajo.

¿Qué es el modelo AFTER?
AFTER significa Audio Features Transfer and Exploration in Real-time. Separa la expresión musical (estructura) de la identidad sonora (timbre) para que puedas modificar cada una de forma independiente.
Los modelos anteriores de "caja negra" generan sonido a partir de coordenadas latentes abstractas difíciles de controlar. AFTER utiliza controles explícitos. Puedes aplicar la interpretación de un instrumento, como la curva de altura de una voz, al timbre aprendido de otro, o tocar el modelo exclusivamente desde MIDI. A diferencia de DDSP, que solo sigue una altura a la vez, AFTER puede tocar acordes desde MIDI cuando se ha entrenado con datos polifónicos.
Para cambiar el estilo de una canción terminada en lugar de una sola interpretación, el remix con IA conserva la pista vocal y regenera el instrumental a partir de un prompt de texto.
Historia y origen: el equipo ACIDS
AFTER surge de la investigación doctoral de Nils Demerlé en IRCAM (Instituto de Investigación y Coordinación Acústica/Música), en París. Trabajó en el grupo ACIDS con Ninon Devis, Philippe Esling, Guillaume Doras y David Genova para abordar una limitación de los autoencoders variacionales (VAE).
Los VAE, como el modelo RAVE, comprimen bien el audio, pero la altura y el timbre suelen acabar mezclados en las mismas dimensiones latentes ("entrelazamiento"), por lo que resulta difícil controlarlos por separado. El equipo presentó su solución en el artículo "Combinar el control de audio y la transferencia de estilo mediante difusión latente" en agosto de 2024. El objetivo era llevar la calidad de audio de los modelos de difusión a las actuaciones musicales en directo.

¿Cómo funciona AFTER? Arquitectura de difusión latente
AFTER utiliza difusión latente condicional. En vez de generar muestras de audio sin procesar una a una, lo que es lento, trabaja en un espacio "latente" comprimido que proporciona un autoencoder preentrenado.

Estructura frente a timbre
AFTER divide el sonido en dos flujos:
- La estructura (características locales): controles explícitos que varían con el tiempo.
- Entrada de audio: altura (f_0) y nivel sonoro (con ponderación A).
- Entrada MIDI: representación polifónica en piano roll.
- El timbre (características globales): un vector de representación aprendido que permanece fijo en el tiempo y representa la identidad del sonido, por ejemplo "violonchelo" o "guitarra distorsionada".
Pasos del procesamiento
- Compresión (el códec): un códec de audio neuronal, normalmente un autoencoder RAVE, comprime el audio entrante en vectores latentes de baja dimensión.
- Condicionamiento: el sistema extrae curvas de altura y nivel sonoro con herramientas como CREPE o Basic Pitch para construir la condición de estructura.
- Difusión latente: una U-Net condicional predice las representaciones latentes del audio a partir de la estructura y el timbre objetivo.
- Decodificación: el códec de audio decodifica las representaciones latentes predichas para reconstruir formas de onda sin procesar.
Cómo entrenar modelos AFTER
El entrenamiento consta de tres etapas. El repositorio de AFTER en GitHub contiene los scripts completos. Instala AFTER en un entorno Python 3.12:
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. Preparación del conjunto de datos
Necesitas un conjunto de datos de audio, normalmente de más de 1 hora para obtener buenos resultados (cuántos datos necesitan DDSP, RAVE y AFTER). Si el instrumento que buscas está mezclado con otros, aíslalo primero mediante separación de pistas con IA de alta calidad.
- Preprocesamiento: el script
after prepare_datasetanaliza el audio y extrae las características de referencia. - Herramientas: utiliza Basic Pitch de Spotify para la transcripción MIDI y extractores de nivel sonoro para el audio. Los datos se guardan en una base de datos LMDB para acceder a ellos rápidamente durante el entrenamiento.
- Comprueba primero la transcripción: para escuchar cómo se convierte tu material en notas antes de un entrenamiento largo, prueba la conversión de audio a MIDI con un fragmento corto. La guía de audio a MIDI explica los pasos en Studio.
Primero prepara un conjunto de datos de formas de onda para el autoencoder:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. Entrenamiento del autoencoder (el códec)
Antes de entrenar el modelo de difusión, necesitas un "códec" que comprima el audio.
- Opción A: entrena un autoencoder causal nuevo con una pérdida espectral multiescala y una pérdida de bisagra adversaria.
- Opción B: usa un códec preentrenado de la carpeta compartida de IRCAM o un modelo RAVE como motor. Es más rápido si ya existe un buen modelo para tu tipo de audio.
Para la opción A, entrena y exporta el autoencoder:
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
La exportación crea export.ts para procesamiento fuera de tiempo real y export_stream.ts para tiempo real.
3. Entrenamiento del modelo de difusión
En esta etapa, el modelo aprende a relacionar las señales de control con el sonido.
- Objetivo: el modelo minimiza un error de predicción de ruido (MSE). En otras palabras, aprende a eliminar ruido paso a paso hasta que queda el sonido objetivo.
- Desentrelazamiento: un criterio adversario penaliza al modelo cuando el codificador de timbre recoge información de altura. Esto mantiene independientes los dos controles.
Codifica el audio con el códec y después entrena el modelo de difusión:
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. Exportación para uso en tiempo real
Exporta con after export para el dispositivo Audio-to-Audio, o con after export_midi para el dispositivo MIDI-to-Audio:
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
La exportación también crea un mapa latente .png. El README pide que lo conserves junto con el archivo .ts.
Cómo usar AFTER en tiempo real: Max for Live y Max/MSP
Integración con Max for Live (M4L)
Para usuarios de Ableton Live, AFTER ofrece dos dispositivos Max for Live que conectan Live con el modelo.
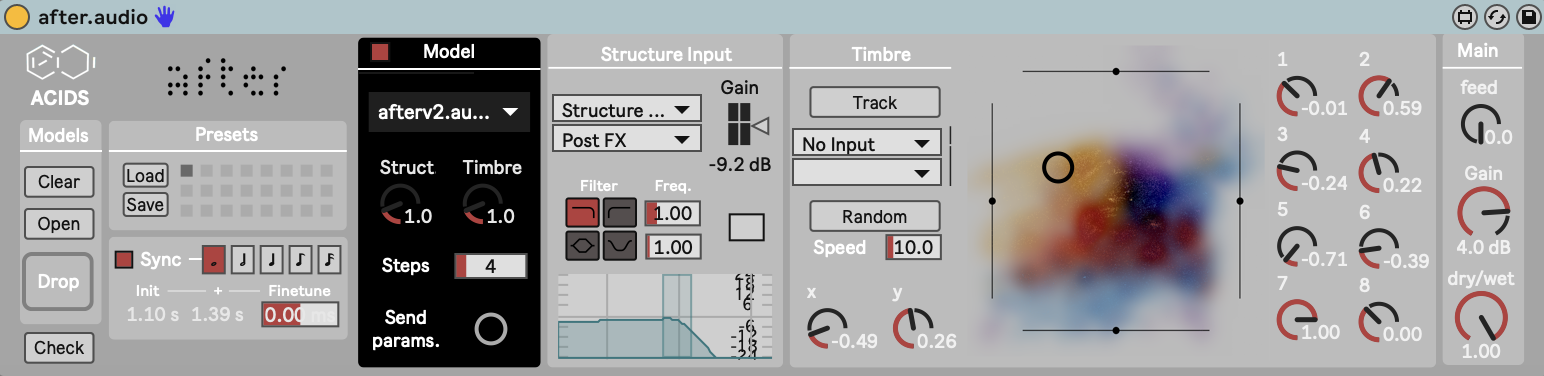
El primero es Audio-to-Audio. Utiliza una entrada sidechain, por ejemplo tu voz, para controlar la altura y el nivel sonoro del modelo neuronal.
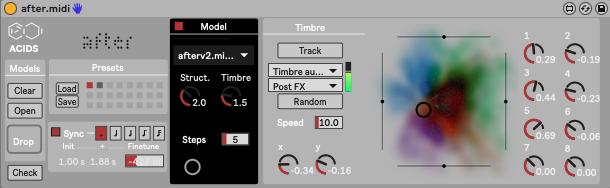
El segundo es MIDI-to-Audio. Envía notas MIDI al modelo como una entrada de estructura en piano roll. Gracias a la arquitectura de difusión latente, admite polifonía cuando el modelo se ha entrenado con datos polifónicos. Para tocar el mismo MIDI con muestras grabadas, carga un instrumento SFZ en sforzando.
Max/MSP y nn~
Para desarrolladores, AFTER funciona dentro de Max/MSP mediante el objeto externo nn~, que carga modelos TorchScript exportados (archivos .ts) directamente en un patch.
¿Cuál es la latencia de AFTER?
AFTER se comporta de forma distinta a modelos de propagación hacia delante en una sola pasada, como RAVE, porque la difusión necesita varios pasos.
Latencia: cada paso de eliminación de ruido añade cálculos, por lo que la implementación en tiempo real suele tener entre 200 y 500 ms de latencia. AFTER genera audio sobre la marcha, pero tocarlo se parece más a hacerlo con un retardo predecible que con un instrumento instantáneo. En actuaciones en directo, algunos artistas utilizan un enfoque de "grabador de bucles": AFTER reproduce cada frase en el siguiente ciclo del bucle. Para un instrumento que responda al instante, encajan mejor las redes pequeñas, como las de los plugins neuronales de amplis de guitarra gratuitos.
Uso de GPU: la inferencia se ejecuta mediante nn~, que admite aceleración por GPU, pero en la práctica los usuarios notan poca diferencia. Como la difusión es iterativa, el uso de CPU sigue siendo alto frente al DSP estándar.
Preguntas frecuentes sobre AFTER
¿Existe un plugin VST de AFTER?
No. El repositorio oficial ofrece dispositivos Max for Live para Ableton Live y patches de Max que funcionan mediante nn~. No menciona ningún plugin VST o AU.
¿Dónde están los modelos AFTER preentrenados?
IRCAM aloja modelos preentrenados, códecs preentrenados y patches de Max en una carpeta compartida enlazada desde el README de AFTER.
¿AFTER es lo mismo que IRCAMAX?
No. IRCAMAX es un paquete comercial de dispositivos Max for Live de IRCAM, vendido por Ableton. AFTER es un modelo de investigación del equipo ACIDS de IRCAM con código público en GitHub.
¿AFTER o RAVE?
RAVE es un modelo de una sola pasada con menor latencia, pero sus controles son dimensiones latentes abstractas. AFTER añade control explícito de altura, nivel sonoro y MIDI polifónico sobre un códec, a cambio de más latencia y consumo de CPU.