IRCAM AFTERモデル:導入、学習済みモデルとトレーニング
IRCAMのAFTERモデルは、MIDIノートや別の音声信号の音高とラウドネスといった身近な入力を使って、ミュージシャンがリアルタイムでポリフォニックに制御できるニューラルオーディオ合成モデルです。
試すには、IRCAMの共有フォルダーから学習済みモデルとMaxパッチをダウンロードし、nn~外部オブジェクトをインストールして、Maxでパッチを開くか、Ableton LiveでMax for Liveデバイスを開いてください。独自のモデルを学習させる場合は、GitHubのPythonパッケージをインストールし、以下の学習手順に従います。

AFTERモデルとは?
AFTERはAudio Features Transfer and Exploration in Real-timeの略です。音楽的な表現(構造)と音の個性(音色)を分離することで、それぞれを独立して変更できます。
従来の「ブラックボックス」モデルは、操作しにくい抽象的な潜在座標から音を生成します。AFTERでは、代わりに明示的な制御信号を使います。ある楽器の演奏表現(例えば声の音高の曲線)を、別の楽器から学習した音色に適用したり、MIDIだけでモデルを演奏したりできます。一度に1つの音高だけを追うDDSPと異なり、AFTERはポリフォニックなデータで学習されていれば、MIDIで和音を演奏できます。
個々の演奏ではなく完成した楽曲のスタイルを変えるには、AIリミックスを使います。ボーカルステムを保持し、テキストプロンプトからインストゥルメンタルを再生成します。
歴史と起源:ACIDSチーム
AFTERは、パリのIRCAM(音響/音楽の研究と連携を行う研究所)で行われたNils Demerléの博士研究から生まれました。彼はACIDSグループでNinon Devis、Philippe Esling、Guillaume Doras、David Genovaとともに、変分オートエンコーダー(VAE)の限界に取り組みました。
RAVEモデルのようなVAEは音声をうまく圧縮できますが、音高と音色が同じ潜在次元に混ざる「絡み合い」が起こりやすく、個別に制御しにくくなります。チームは2024年8月の論文*「潜在拡散を用いた音声制御とスタイル変換の組み合わせ」*で解決策を発表しました。目標は、拡散モデルの音質をライブ演奏に持ち込むことでした。

AFTERの仕組み:潜在拡散アーキテクチャ
AFTERは条件付き潜在拡散を使います。時間のかかる生の音声サンプルの逐次生成ではなく、学習済みオートエンコーダーが提供する圧縮された「潜在」空間で処理します。

構造と音色
AFTERは音を2つの流れに分けます。
- **構造(局所特徴):**時間とともに変化する明示的な制御信号です。
- **音声入力:**音高(f_0)とラウドネス(A特性)。
- **MIDI入力:**ポリフォニックなピアノロール表現。
- **音色(大域特徴):**時間とともに変化せず、音の個性を表す学習済みの埋め込みベクトルです。例えば「チェロ」や「歪ませたギター」を表します。
処理の手順
- 圧縮(コーデック): ニューラルオーディオコーデック(通常はRAVEオートエンコーダー)が、入力音声を低次元の潜在ベクトルに圧縮します。
- **条件の構築:**CREPEやBasic Pitchなどのツールで音高とラウドネスの曲線を抽出し、構造の条件を作ります。
- **潜在拡散:**条件付きU-Netが、構造と目標の音色に基づいて音声の潜在表現を予測します。
- **デコード:**オーディオコーデックが、予測された潜在表現を生の波形に戻します。
AFTERモデルの学習方法
学習は3段階で行います。AFTERのGitHubリポジトリにすべてのスクリプトがあります。Python 3.12環境にAFTERをインストールしてください。
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. データセットの準備
音声のデータセットが必要です。良好な結果を得るには、通常1時間を超えるデータを用意します(DDSP、RAVE、AFTERそれぞれに必要なデータ量)。目的の楽器が他の楽器と混ざっている場合は、まず高品質なAIステム分離で取り出してください。
- 前処理:
after prepare_datasetスクリプトが音声を解析し、正解となる特徴を抽出します。 - ツール:MIDI採譜にはSpotifyのBasic Pitchを、音声にはラウドネス抽出ツールを使います。データは学習中に素早くアクセスできるよう、LMDBデータベースに保存されます。
- **まず採譜を確認:**長い学習を始める前に、素材がどの程度うまく音符に変換されるか聴くには、短い抜粋で音声からMIDIへの変換を試してください。音声をMIDIに変換するガイドでは、Studioでの手順を紹介しています。
まず、オートエンコーダー用の波形データセットを準備します。
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. オートエンコーダーの学習(コーデック)
拡散モデルを学習させる前に、音声を圧縮する「コーデック」が必要です。
- 方法A: マルチスケールのスペクトル損失と敵対的ヒンジ損失を使い、新しい因果的オートエンコーダーを学習させます。
- 方法B:IRCAMの共有フォルダーにある学習済みコーデック、またはRAVEモデルをバックエンドに使います。その音声の種類に適したモデルがすでにあれば、この方法のほうが速くなります。
方法Aでは、オートエンコーダーを学習させてエクスポートします。
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_nameエクスポートすると、非リアルタイム処理用のexport.tsと、リアルタイム処理用のexport_stream.tsが生成されます。
3. 拡散モデルの学習
この段階では、制御信号が音にどう対応するかをモデルが学習します。
- **目的:モデルはノイズ予測誤差(MSE)**を最小化します。つまり、目標の音が残るまで段階的にノイズを除去する方法を学びます。
- **分離:**音色エンコーダーが音高情報を捉えるたびに、敵対的な基準がモデルにペナルティを与えます。これによって2つの制御を独立に保ちます。
コーデックで音声をエンコードしてから、拡散モデルを学習させます。
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. リアルタイム使用向けのエクスポート
Audio-to-Audioデバイス用にはafter export、MIDI-to-Audioデバイス用にはafter export_midiでエクスポートします。
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.tsエクスポート時には、.png形式の潜在空間マップも生成されます。READMEでは、このファイルを.tsファイルと一緒に保管するよう案内しています。
AFTERをリアルタイムで使う方法:Max for LiveとMax/MSP
Max for Live(M4L)との連携
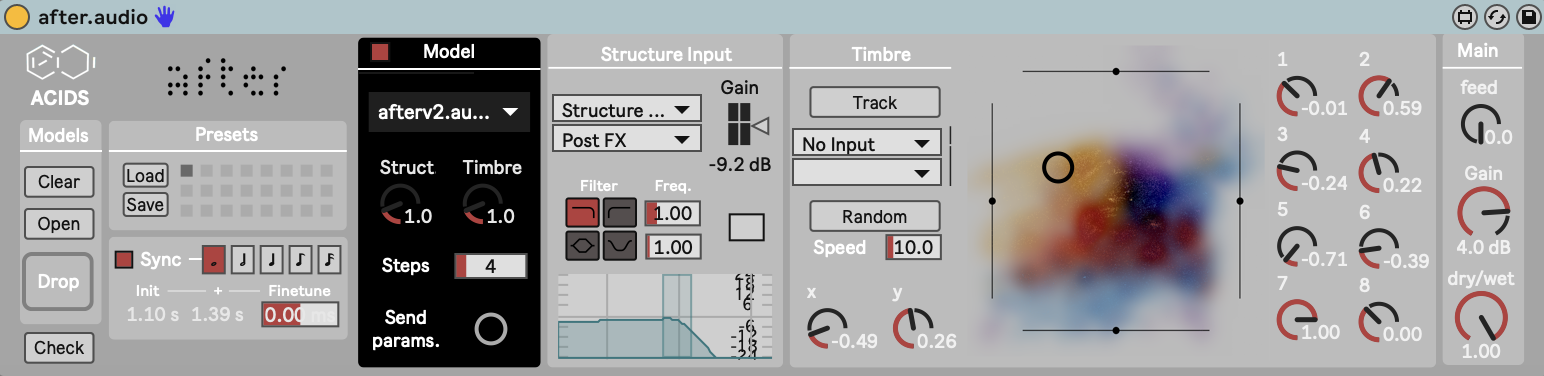
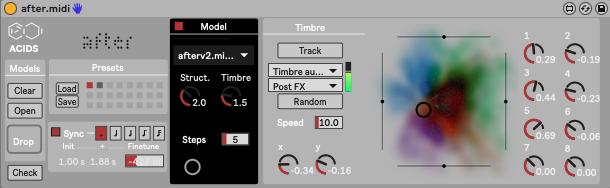
Ableton Liveのユーザー向けに、AFTERはLiveとモデルを接続する2つのMax for Liveデバイスを提供しています。
1つ目は**Audio-to-Audio。**声などのサイドチェーン入力を使い、ニューラルモデルの音高とラウドネスを動かします。
2つ目は**MIDI-to-Audio。**MIDIノートをピアノロール形式の構造入力としてモデルに送ります。潜在拡散アーキテクチャによって、モデルがポリフォニックなデータで学習されていれば、ポリフォニックな演奏に対応します。同じMIDIを録音済みサンプルで演奏するには、sforzandoにSFZ楽器を読み込んでください。
Max/MSPとnn~
開発者はnn~外部オブジェクトを通じて、Max/MSP内でAFTERを動かせます。エクスポートされたTorchScriptモデル(.tsファイル)を、パッチに直接読み込みます。
AFTERの遅延はどのくらいですか?
拡散には複数のステップが必要なため、AFTERはRAVEのような1回の処理で出力する順伝播モデルとは異なる動作をします。
遅延:ノイズ除去の各ステップで計算量が増えるため、リアルタイム実装には通常200〜500 msの遅延があります。AFTERは演奏に合わせて音声を生成しますが、即座に反応する楽器というより、予測可能な遅延を通して演奏する感覚です。ライブでは「ループ再生」の方式を使うアーティストもいます。AFTERが各フレーズを次のループ周期に再生する使い方です。即座に反応する楽器には、無料のニューラルギターアンププラグインで使われる小さなネットワークのほうが適しています。
**GPUの利用:**推論はGPUアクセラレーションに対応するnn~を通じて行われますが、実際にはユーザーが感じる差はわずかです。拡散は反復処理なので、CPU使用率は標準的なDSPより高いままです。
AFTERのよくある質問
AFTERのVSTプラグインはありますか?
いいえ。公式リポジトリには、Ableton Live用のMax for Liveデバイスとnn~で動くMaxパッチがあります。VSTやAUプラグインへの言及はありません。
AFTERの学習済みモデルはどこにありますか?
IRCAMは共有フォルダーで、学習済みモデル、学習済みコーデック、Maxパッチを公開しています。AFTERのREADMEからリンクされています。
AFTERとIRCAMAXは同じものですか?
いいえ。IRCAMAXは、IRCAMによる商用のMax for Liveデバイスパックで、Abletonが販売しています。AFTERはIRCAMのACIDSチームによる研究モデルで、GitHubにコードが公開されています。
AFTERとRAVEのどちらを選ぶべきですか?
RAVEは、1回の処理で出力する、遅延の小さいモデルですが、制御は抽象的な潜在次元で行います。AFTERはコーデックの上に明示的な音高、ラウドネス、ポリフォニックMIDIの制御を加えるため、遅延とCPU負荷が増えます。