IRCAM AFTER 모델: 설치, 사전 학습 모델과 훈련
IRCAM의 AFTER 모델은 음악가가 익숙한 입력인 MIDI 음표 또는 다른 오디오 신호의 음높이와 음량으로 실시간 다성 제어가 가능한 신경망 오디오 합성 모델입니다.
사용해 보려면 IRCAM 공유 폴더에서 사전 학습 모델과 Max 패치를 다운로드하고, nn~ 외부 객체를 설치한 다음 Max에서 패치를 열거나 Ableton Live에서 Max for Live 디바이스를 여세요. 자신의 모델을 훈련하려면 GitHub의 Python 패키지를 설치하고 아래 훈련 단계를 따르세요.

AFTER 모델이란?
AFTER는 Audio Features Transfer and Exploration in Real-time의 약자입니다. 음악적 표현인 구조와 소리의 정체성인 음색을 분리해 각각 독립적으로 바꿀 수 있습니다.
기존의 ‘블랙박스’ 모델은 제어하기 어려운 추상적인 잠재 좌표에서 소리를 생성합니다. AFTER는 명시적인 제어 신호를 사용합니다. 한 악기의 연주 표현, 예를 들어 목소리의 음높이 곡선을 다른 악기에서 학습한 음색에 적용하거나, MIDI만으로 모델을 연주할 수 있습니다. 한 번에 하나의 음높이만 따라가는 DDSP와 달리, AFTER는 다성 데이터로 훈련된 경우 MIDI로 코드를 연주할 수 있습니다.
개별 연주가 아니라 완성된 곡의 스타일을 바꾸려면 AI 리믹스를 사용하세요. 보컬 스템을 유지하고 텍스트 프롬프트를 바탕으로 반주를 다시 생성합니다.
역사와 기원: ACIDS 팀
AFTER는 파리의 IRCAM(음향/음악 연구 및 조정 연구소)에서 진행한 Nils Demerlé의 박사 연구에서 나왔습니다. 그는 ACIDS 그룹에서 Ninon Devis, Philippe Esling, Guillaume Doras, David Genova와 함께 변분 오토인코더(VAE)의 한계를 해결하고자 했습니다.
RAVE 모델과 같은 VAE는 오디오를 잘 압축하지만 음높이와 음색이 같은 잠재 차원에 섞이는 ‘얽힘’이 자주 생겨, 둘을 따로 제어하기 어렵습니다. 연구팀은 2024년 8월 논문 *‘잠재 확산을 이용한 오디오 제어와 스타일 전이의 결합’*에서 해결책을 발표했습니다. 목표는 확산 모델의 오디오 품질을 라이브 음악 연주에 적용하는 것이었습니다.

AFTER의 작동 방식: 잠재 확산 아키텍처
AFTER는 조건부 잠재 확산을 사용합니다. 느린 방식인 원시 오디오 샘플의 순차 생성 대신, 사전 학습된 오토인코더가 제공하는 압축된 ‘잠재’ 공간에서 작업합니다.

구조와 음색
AFTER는 소리를 두 흐름으로 나눕니다.
- 구조(국소 특징): 시간에 따라 변하는 명시적인 제어 신호입니다.
- 오디오 입력: 음높이(f_0)와 음량(A 가중치).
- MIDI 입력: 다성 피아노 롤 표현.
- 음색(전역 특징): 시간에 따라 고정되어 소리의 정체성을 나타내는 학습된 임베딩 벡터입니다. 예를 들면 ‘첼로’나 ‘디스토션 기타’입니다.
처리 단계
- 압축(코덱): 신경망 오디오 코덱, 보통 RAVE 오토인코더가 입력 오디오를 저차원 잠재 벡터로 압축합니다.
- 조건 구성: 시스템이 CREPE나 Basic Pitch 같은 도구로 음높이와 음량 곡선을 추출해 구조 조건을 만듭니다.
- 잠재 확산: 조건부 U-Net이 구조와 목표 음색을 바탕으로 오디오의 잠재 표현을 예측합니다.
- 디코딩: 오디오 코덱이 예측된 잠재 표현을 다시 원시 파형으로 디코딩합니다.
AFTER 모델 훈련 방법
훈련은 세 단계로 진행됩니다. AFTER GitHub 저장소에 전체 스크립트가 있습니다. Python 3.12 환경에 AFTER를 설치하세요.
git clone https://github.com/acids-ircam/AFTER.git
cd AFTER/
pip install -e .1. 데이터셋 준비
오디오 데이터셋이 필요하며, 좋은 결과를 얻으려면 보통 1시간 넘는 오디오가 필요합니다(DDSP, RAVE, AFTER에 각각 필요한 데이터 양). 원하는 악기가 다른 악기와 섞여 있다면 먼저 고품질 AI 스템 분리로 분리하세요.
- 전처리:
after prepare_dataset스크립트가 오디오를 분석하고 정답 기준 특징을 추출합니다. - 도구: MIDI 전사에는 Spotify의 Basic Pitch를, 오디오에는 음량 추출 도구를 사용합니다. 데이터는 훈련 중 빠르게 접근할 수 있도록 LMDB 데이터베이스에 저장됩니다.
- 전사 결과 먼저 확인: 긴 훈련을 시작하기 전에 자료가 얼마나 잘 음표로 변환되는지 들어 보려면 짧은 구간으로 오디오를 MIDI로 변환해 보세요. 오디오를 MIDI로 변환하는 가이드에 Studio에서 진행하는 단계가 나와 있습니다.
먼저 오토인코더용 파형 데이터셋을 준비하세요.
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_audio --save_waveform True2. 오토인코더 훈련(코덱)
확산 모델을 훈련하기 전에 오디오를 압축하는 ‘코덱’이 필요합니다.
- 방법 A: 다중 스케일 스펙트럼 손실과 적대적 힌지 손실을 사용해 새로운 인과적 오토인코더를 훈련합니다.
- 방법 B: IRCAM 공유 폴더의 사전 학습 코덱이나 RAVE 모델을 백엔드로 사용합니다. 해당 오디오 유형에 적합한 모델이 이미 있다면 이 방법이 더 빠릅니다.
방법 A를 선택했다면 오토인코더를 훈련하고 내보내세요.
after train_autoencoder --name AE_model_name --db_path /dataset/path_audio --config AE_4096 --gpu 0
after export_autoencoder --model_path autoencoder_runs/AE_model_name
내보내면 비실시간 처리용 export.ts와 실시간 처리용 export_stream.ts가 생성됩니다.
3. 확산 모델 훈련
이 단계에서 모델은 제어 신호가 소리로 매핑되는 방식을 학습합니다.
- 목표: 모델은 **노이즈 예측 오차(MSE)**를 최소화합니다. 즉, 목표 소리가 남을 때까지 단계적으로 노이즈를 제거하는 법을 학습합니다.
- 분리: 음색 인코더가 음높이 정보를 포착할 때마다 적대적 기준이 모델에 페널티를 줍니다. 이로써 두 제어 요소의 독립성을 유지합니다.
코덱으로 오디오를 인코딩한 다음 확산 모델을 훈련하세요.
after prepare_dataset --input_path /audio/folder --output_path /dataset/path_latent --emb_model_path AE_model_run/export.ts
after train --name diff_model_name --db_path /dataset/path_latent --emb_model_path AE_model_run/export.ts --config audio
4. 실시간 사용을 위한 내보내기
Audio-to-Audio 디바이스용으로는 after export를, MIDI-to-Audio 디바이스용으로는 after export_midi를 사용해 내보내세요.
after export --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
after export_midi --model_path after_runs/diff_model_name --emb_model_path AE_model_run/export_stream.ts
내보내기 과정에서는 .png 잠재 공간 지도도 생성됩니다. README에서는 이 파일을 .ts 파일과 함께 보관하도록 안내합니다.
AFTER 실시간 사용 방법: Max for Live와 Max/MSP
Max for Live(M4L) 통합
Ableton Live 사용자를 위해 AFTER는 Live와 모델을 연결하는 두 가지 Max for Live 디바이스를 제공합니다.
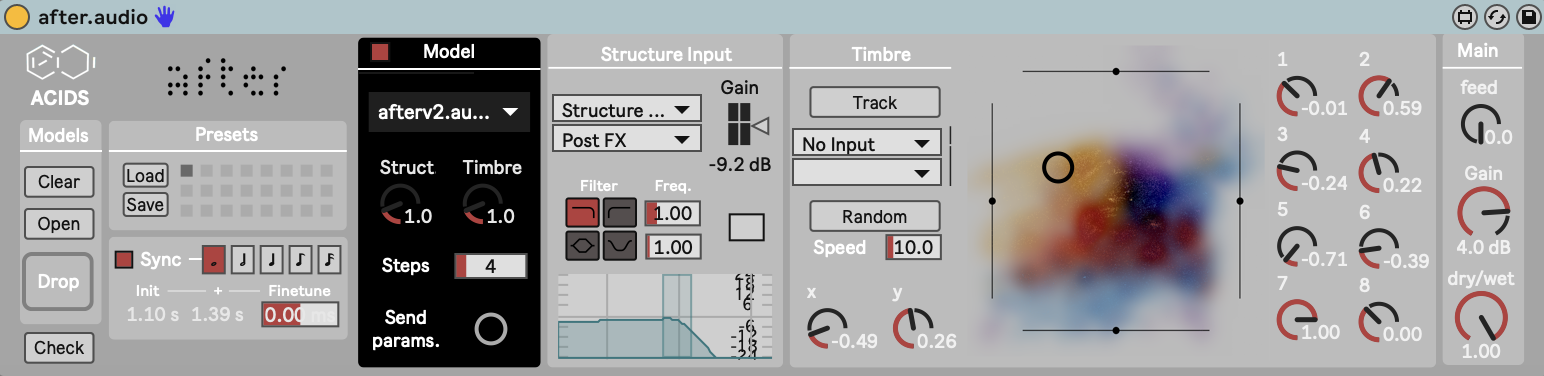
첫 번째는 Audio-to-Audio입니다. 목소리 같은 사이드체인 입력으로 신경망 모델의 음높이와 음량을 제어합니다.
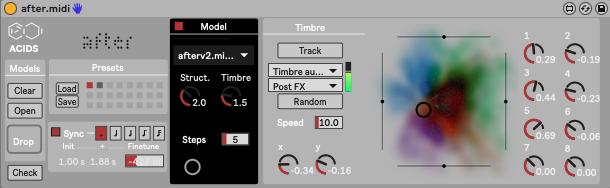
두 번째는 MIDI-to-Audio입니다. MIDI 음표를 피아노 롤 구조 입력으로 모델에 전달합니다. 잠재 확산 아키텍처 덕분에 다성 데이터로 훈련된 모델은 다성 연주를 지원합니다. 같은 MIDI를 녹음된 샘플로 연주하려면 sforzando에서 SFZ 악기를 불러오세요.
Max/MSP와 nn~
개발자는 nn~ 외부 객체를 통해 Max/MSP 안에서 AFTER를 실행할 수 있습니다. 이 객체는 내보낸 TorchScript 모델(.ts 파일)을 패치에 직접 불러옵니다.
AFTER의 지연은 어느 정도인가요?
확산에는 여러 단계가 필요하므로 AFTER는 RAVE 같은 단일 패스 순방향 모델과 다르게 작동합니다.
지연: 잡음을 제거하는 단계마다 연산이 늘어나므로 실시간 구현에서는 보통 200~500 ms의 지연이 생깁니다. AFTER는 연주에 맞춰 오디오를 생성하지만, 즉시 반응하는 악기보다는 예측 가능한 지연을 거쳐 연주하는 느낌에 가깝습니다. 라이브 공연에서 일부 아티스트는 ‘루프 재생’ 방식을 사용합니다. AFTER가 각 프레이즈를 다음 루프 주기에 재생하는 방식입니다. 즉시 반응하는 악기가 필요하다면 무료 신경망 기타 앰프 플러그인에 쓰이는 작은 네트워크가 더 적합합니다.
GPU 활용: 추론은 GPU 가속을 지원하는 nn~를 통해 실행되지만, 실제로 사용자가 느끼는 차이는 작습니다. 확산은 반복적으로 진행되므로 CPU 사용량은 표준 DSP에 비해 여전히 높습니다.
AFTER 자주 묻는 질문
AFTER VST 플러그인이 있나요?
없습니다. 공식 저장소에서는 Ableton Live용 Max for Live 디바이스와 nn~로 실행하는 Max 패치를 제공합니다. VST나 AU 플러그인은 언급하지 않습니다.
AFTER 사전 학습 모델은 어디에 있나요?
IRCAM은 공유 폴더에 사전 학습 모델, 사전 학습 코덱, Max 패치를 제공합니다. AFTER README에 이 폴더의 링크가 있습니다.
AFTER와 IRCAMAX는 같은 것인가요?
아닙니다. IRCAMAX는 IRCAM의 상용 Max for Live 디바이스 팩으로 Ableton에서 판매합니다. AFTER는 IRCAM ACIDS 팀의 연구 모델이며 GitHub에 코드가 공개되어 있습니다.
AFTER와 RAVE 중 무엇을 선택해야 하나요?
RAVE는 지연이 더 짧은 단일 패스 모델이지만 추상적인 잠재 차원으로 제어합니다. AFTER는 코덱 위에 명시적인 음높이, 음량, 다성 MIDI 제어를 추가하며, 그 대신 지연과 CPU 사용량이 늘어납니다.