DDSP 가이드: Magenta DDSP VST, 학습과 작동 원리
DDSP(미분 가능한 디지털 신호 처리)는 Google Magenta의 오픈 소스 라이브러리로, 신경망이 오실레이터, 필터링된 노이즈, 리버브 같은 전통적인 소리 생성기를 제어하게 합니다. Magenta는 2024년에 DDSP VST를 보관 상태로 전환했지만 무료 플러그인은 여전히 다운로드하여 Windows와 macOS에서 실행할 수 있습니다. 무료 Google Colab 노트북에서 자신만의 악기 모델을 학습할 수도 있습니다.
이 가이드는 이 두 가지 실용적인 작업부터 시작합니다. 이어서 DDSP의 작동 원리와 한계, 이를 대체한 새로운 모델을 설명합니다.
지금 DDSP 사용하기: 빠른 시작
DDSP VST 다운로드 및 설치
- macOS 또는 Windows용 플러그인을 다운로드하세요. 두 링크 모두 공식 DDSP VST 저장소에서 제공합니다.
- 파일의 압축을 푸세요. 두 플러그인이 들어 있습니다. DDSP Effect는 목소리 같은 입력 오디오를 악기 소리로 바꾸고, DDSP Synth는 MIDI로 연주합니다.
- macOS에서는
/Library/Audio/Plug-Ins/Components(AU)와/Library/Audio/Plug-Ins/VST3에 복사하세요. Windows에서는 VST3 파일을C:\Program Files\Common Files\VST3에 복사하세요. - DAW에서 플러그인을 다시 검색하세요.
공식 Linux 빌드는 없습니다. 설치 없이 DDSP를 들어 보려면 Tone Transfer 웹 데모를 이용하세요.
자신만의 DDSP 악기 학습하기
Magenta의 DDSP VST 학습 노트북은 Google Colab에서 실행되므로 로컬 GPU가 필요하지 않습니다.
- Google Drive 폴더에
.wav또는.mp3오디오를 최소 10분 넣으세요. 같은 마이크와 같은 공간에서 한 번의 녹음 세션으로 녹음한 단음 오디오, 즉 한 번에 한 음만 나는 소리를 사용하세요. - 노트북을 열고 설치 셀을 실행한 다음(약 5분), 학습 셀을 실행하고 폴더를 선택하세요.
- 기다리세요. 무료 Colab에서는 약 2~3시간, Colab Pro+에서는 1시간 미만이 걸립니다. Colab 연결이 끊기면 같은 폴더로 셀을 다시 실행하세요. 학습이 이어집니다.
- 다운로드한 모델 폴더를 플러그인의 모델 폴더에 압축 해제하세요. Mac에서는
~/Documents/Magenta/DDSP/Models이며, 플러그인 안에서도 열 수 있습니다.
노트북에 따르면 보통 30,000~50,000 학습 스텝 이후 좋은 결과가 나옵니다. 너무 적게 학습하면 소리가 밋밋하고, 너무 많이 학습하면 소리가 끊기거나 음량이 크게 튈 수 있습니다.
역사와 발전: Magenta에서 최신 플러그인까지
Magenta 연구소(2016~2024년)
Google의 Magenta는 2016년 음악과 예술을 위한 머신러닝 오픈 소스 연구 프로젝트로 시작했습니다. 많은 음악 생성 도구를 공개했지만 2024년까지 대부분의 프로젝트가 보관 상태로 전환되었습니다.
Open NSynth Super(2017년)
DDSP 이전에 Magenta는 NSynth를 기반으로 한 하드웨어 악기 Open NSynth Super를 선보였습니다. NSynth 데이터셋에는 1,006개 악기의 단일 음 샘플 약 305,000개가 있습니다. Raspberry Pi와 맞춤형 PCB로 만든 이 기기는 악기 소리 사이를 실시간으로 변형하며 연주할 수 있게 했습니다.
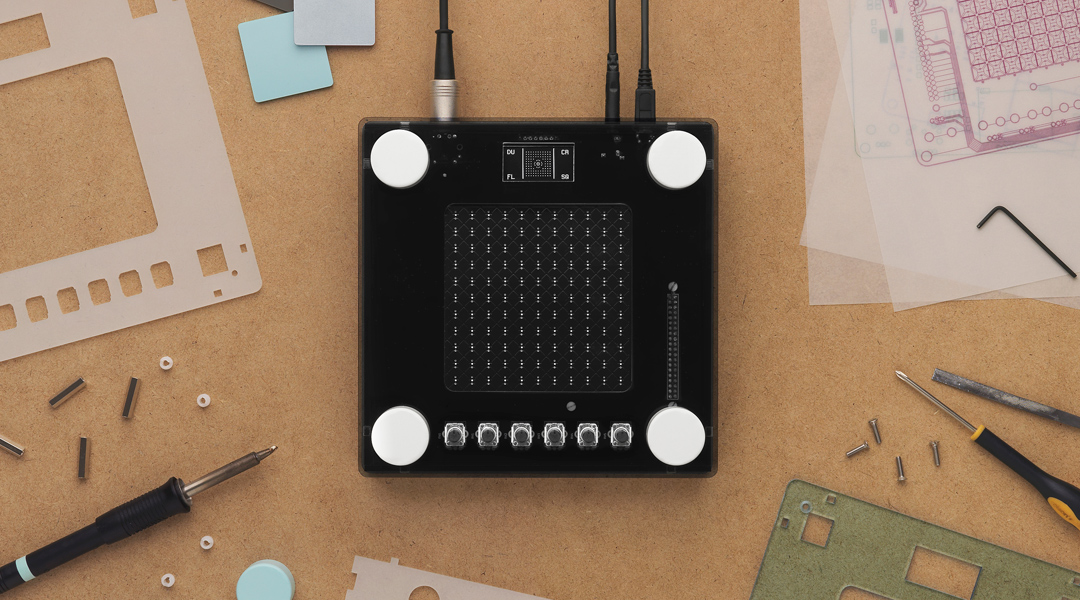
WaveNet 계열의 오토인코더인 NSynth 모델은 계산 비용 때문에 16-bit/16 kHz 오디오로 제한되어 출력이 뚜렷한 로파이 음질로 들립니다. 오디오 엔지니어 Joe Boston은 이를 "입자가 거친" 소리라고 표현했지만 외부 효과를 거쳐 창작에 활용했습니다. 하드웨어 프로젝트는 2025년 8월에 보관 상태로 전환되었습니다.
DDSP와 Tone Transfer(2020년)
2020년에 Magenta는 일반적인 신호 처리 모듈의 미분 가능한 버전을 소개한 DDSP 라이브러리와 ICLR 논문을 공개했습니다. Tone Transfer 웹 데모는 노래 같은 녹음을 바이올린, 색소폰, 트럼펫, 플루트 소리로 바꿀 수 있게 했습니다.
모델은 악기당 약 10분의 단음 오디오로 학습한 RNN 기반 오토인코더였습니다. 데모는 작동했지만 16 kHz 출력과 제한적인 연주 표현 모델링이 한계였습니다.
MIDI DDSP와 VST 플러그인(2022~2024년)
Magenta는 2022년 1월 MIDI DDSP로 DDSP를 확장했습니다. 단음 MIDI 시퀀스에서 악기 오디오를 직접 합성합니다. 신경망 모델 대신 녹음된 샘플로 MIDI를 연주하려면 무료 sforzando 플레이어에 SFZ 악기를 불러오세요.
2022년 6월에는 DAW에서 실시간 음색 변환을 수행하는 DDSP VST 플러그인을 공개했습니다. 두 프로젝트 모두 2024년에 보관 상태로 전환되었습니다. MIDI DDSP는 2월, VST는 10월입니다.

MAWF 오디오 플러그인(2023년)
Tone Transfer의 전 기술 책임자이며 2020년부터 ByteDance에서 일한 Hanoi Hantrakul(yaboihanoi)은 2023년 MAWF를 출시했습니다. 이 무료 VST/AU 플러그인은 48 kHz 실시간 신경망 오디오 합성을 수행해 초기 DDSP 구현의 16 kHz 한계를 없앴습니다.

DDSP는 어떻게 작동하나요? 오토인코더와 DSP의 결합
DDSP는 디코더가 파형을 직접 생성하는 대신 모듈식 DSP 구성 요소를 구동하는 오토인코더입니다.
DDSP 오토인코더 구조
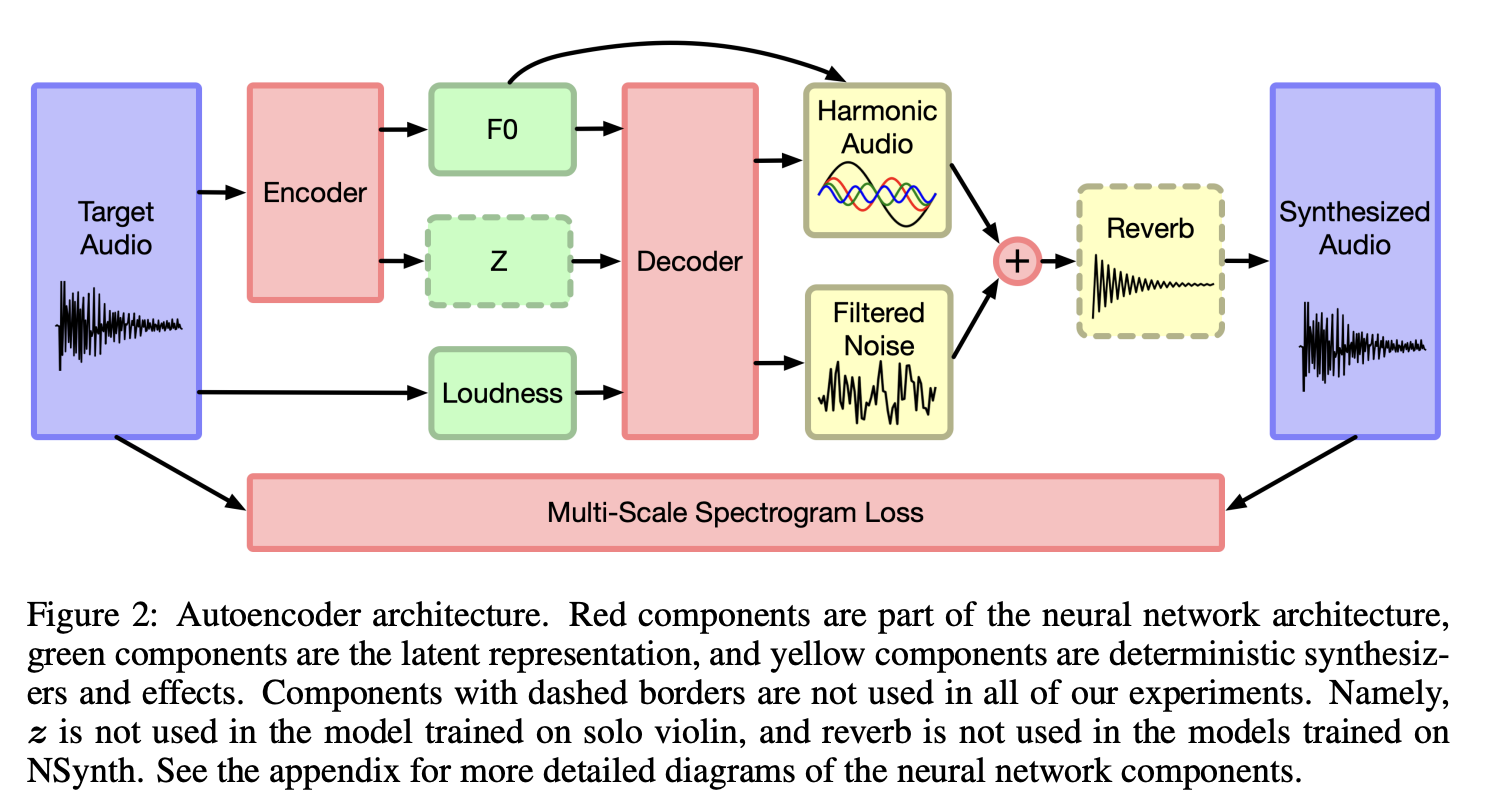
원본 도식: DDSP 오토인코더 구조.
인코더
인코더는 입력 오디오를 두 제어 곡선으로 바꿉니다. **기본 주파수(f0, 음높이)**는 사전 학습된 CREPE 음높이 추적기로 추정하고, 라우드니스는 신호에서 직접 계산합니다. 선택적 잔차 인코더(MFCC 시퀀스에 적용하는 GRU)는 음높이와 라우드니스가 포착하지 못하는 음색 세부를 위한 잠재 벡터를 추가합니다. 이 저차원 신호들이 연주를 표현합니다.
디코더와 합성 모듈
순환 디코더(GRU)는 제어 신호를 세 가지 DSP 구성 요소의 매개변수로 변환합니다.
- 배음 가산 합성기: 기본 주파수의 배수에 최대 100개의 정현파 부분음을 생성해 음높이가 있는 소리 부분을 만듭니다.
- 필터링된 노이즈 합성기: 시간에 따라 바뀌는 FIR 필터로 백색 잡음을 가공해 숨소리와 활 마찰음을 모델링합니다.
- 미분 가능한 리버브: 학습된 임펄스 응답으로 공간의 음향 특성을 추가합니다.
모든 구성 요소가 미분 가능하므로 전체 모델은 다중 스케일 스펙트럼 손실로 처음부터 끝까지 학습됩니다. 오디오를 샘플 단위로 생성하는 대신 프레임마다 수백 개의 합성 매개변수를 예측합니다.
연구용 DDSP 모델 학습
DDSP VST에서 연주할 모델은 위의 빠른 시작에 소개한 DDSP VST 학습 노트북을 사용하세요. 구조나 손실을 바꾸려면 라이브러리의 Colab 튜토리얼부터 시작하세요. 기본적인 Python 지식이 필요하며, 전처리, 설정, Colab GPU 학습을 다룹니다.
실시간 사용을 위한 DDSP 플러그인
Magenta의 공식 프로젝트는 보관 상태지만 다음 도구로 여전히 DAW에서 DDSP를 실행할 수 있습니다.
1. Magenta DDSP VST(보관됨)
공식 DDSP VST는 실험용으로 여전히 작동합니다. 설치 방법은 위의 빠른 시작을 확인하세요. 다섯 악기 모델을 포함하고 MIDI와 오디오 입력을 모두 받습니다. 사용자들은 출력에 강한 리버브가 있다고 보고하며, 아티팩트를 가리는 듯합니다.
2. Neutone FX 플랫폼
Neutone FX는 DDSP 기반 음색 변환 네트워크를 포함해 커뮤니티가 학습한 모델을 실행하는 무료 플러그인을 제공합니다. 원래 Magenta 악기에 더해 수십 개 모델을 사용할 수 있습니다.

3. yaboihanoi의 MAWF(추천)
MAWF 플러그인은 DAW 안에서 48 kHz DDSP 합성을 실행합니다. 여러 악기 모델을 제공하며 현재 가장 잘 다듬어진 DDSP 구현입니다.

다만 MAWF 다운로드 사이트는 2025년 11월부터 접속되지 않고 있습니다. 플러그인을 받을 다른 곳을 찾으면 이 글을 업데이트하겠습니다.
DDSP에는 어떤 한계가 있나요?
DDSP의 한계는 구조와 합성 방식에서 비롯됩니다.
- 단음만 지원: DDSP 모델은 다성 오디오를 생성할 수 없습니다. 단음 녹음으로 학습했으며 배음 합성기는 각 시점에 하나의 기본 주파수만 있다고 가정합니다.
- 음질: MAWF의 48 kHz 모델은 더 좋게 들리지만 초기 16 kHz 구현은 금속성 아티팩트가 있고 고역이 부족합니다. 오디오 초해상도 모델로 이전 렌더링에서 빠진 고역을 재생성할 수 있습니다. GitHub에서 AudioSR을 설치하고 실행하는 방법이나 UniverSR로 22 kHz RPG Maker 효과음을 48 kHz로 복원한 과정을 확인하세요.
- 제한적인 GPU 병렬 처리: 순환 계층은 프레임을 차례로 처리하므로 합성곱 모델처럼 GPU에서 시간 축을 병렬 처리할 수 없습니다.
DDSP 이후: RAVE, DDSP-CNN-Tiny와 AFTER
RAVE(2021년)
RAVE는 RNN 대신 인과적 CNN을 사용해 더 빠른 학습과 48 kHz 합성, 더 나은 음색 모델링을 제공합니다. 적대적 학습(판별기)으로 다듬은 변분 오토인코더이며, 비슷한 데이터량으로 더 높은 음질의 소리를 만듭니다.
DDSP-CNN-Tiny(2022년)
DDSP-CNN-Tiny는 DDSP의 RNN을 경량 CNN으로 바꿔 모델을 줄이고 추론 속도를 높입니다. 음질은 비슷하게 유지하며 CPU에서 실시간으로 실행됩니다. NAM과 AIDA-X 같은 무료 신경망 기타 앰프 플러그인도 CPU에서 작은 네트워크를 실행합니다. Václav Volhejn이 ETH Zurich 학위 논문을 위해 개발했으며, 실시간 DDSP에 관한 그의 논문은 훌륭한 기술 자료입니다.
AFTER(2024년)
AFTER 모델은 신경망 오디오 코덱 위에서 잠재 확산을 수행해 스튜디오급 음질의 합성을 구현합니다. DDSP보다 계산량이 많지만 음색 변환의 아티팩트가 훨씬 적어 전문 제작에 더 적합합니다.
DDSP FAQ
Magenta DDSP는 아직 유지보수되나요?
일부만 그렇습니다. ddsp 라이브러리는 보관 상태가 아니며 아직 커밋이 이루어집니다. Magenta는 MIDI DDSP를 2024년 2월, DDSP VST를 2024년 10월에 보관 상태로 전환했으므로 플러그인에는 업데이트가 없습니다. 이 가이드를 2026년 10월에 업데이트했을 때 플러그인 다운로드와 학습 노트북은 여전히 작동했습니다.
DDSP VST는 Linux에서 작동하나요?
공식 Linux 빌드는 없습니다. 직접 소스 코드로 빌드해야 합니다.
DDSP로 화음을 연주할 수 있나요?
아니요. DDSP 모델은 단음으로, 한 번에 하나의 음높이만 따라갑니다. 다성 MIDI 제어에는 AFTER를 살펴보세요.
DDSP와 RAVE 중 무엇을 학습해야 하나요?
약 10분의 오디오와 무료 Colab GPU만 있고 음높이가 있는 악기 하나를 대상으로 한다면 DDSP를 선택하세요. 드럼, 질감, 목소리를 포함해 어떤 소리든 다루려면 RAVE를 선택하세요. RAVE는 몇 시간의 오디오와 며칠간의 GPU 학습이 필요합니다. FAQ는 DDSP, RAVE, AFTER에 필요한 학습 오디오량과 DAW에서 각 학습 모델을 연주하는 플러그인을 비교합니다.