Руководство по DDSP: Magenta DDSP VST, обучение и принцип работы
DDSP (дифференцируемая цифровая обработка сигналов) — библиотека Google Magenta с открытым исходным кодом, которая позволяет нейросети управлять классическими генераторами звука: осцилляторами, фильтрованным шумом и реверберацией. Magenta архивировала DDSP VST в 2024 году, но бесплатный плагин по-прежнему можно скачать и запустить в Windows и macOS. Можно также обучить собственную модель инструмента в бесплатном блокноте Google Colab.
Руководство начинается с этих двух практических шагов. Затем оно объясняет, как работает DDSP, в чём его ограничения и какие новые модели пришли ему на смену.
Как использовать DDSP сегодня: быстрый старт
Скачайте и установите DDSP VST
- Скачайте плагин для macOS или Windows. Обе ссылки взяты из официального репозитория DDSP VST.
- Распакуйте файл. В нём два плагина: DDSP Effect, превращающий входящее аудио (например, ваш голос) в инструмент, и DDSP Synth, на котором играют с помощью MIDI.
- В macOS скопируйте их в
/Library/Audio/Plug-Ins/Components(AU) и/Library/Audio/Plug-Ins/VST3. В Windows скопируйте файлы VST3 вC:\Program Files\Common Files\VST3. - Повторно просканируйте плагины в DAW.
Официальной сборки для Linux нет. Чтобы услышать DDSP без установки, попробуйте веб-демонстрацию Tone Transfer.
Обучите собственный инструмент DDSP
Блокнот Magenta для обучения DDSP VST работает в Google Colab, поэтому локальный GPU не нужен:
- Поместите не менее 10 минут аудио
.wavили.mp3в папку Google Drive. Используйте одноголосное аудио (по одной ноте за раз) из одной сессии записи, с тем же микрофоном и в той же комнате. - Откройте блокнот, выполните ячейку установки (около 5 минут), затем ячейку обучения и выберите свою папку.
- Подождите. Обучение занимает примерно от 2 до 3 часов в бесплатном Colab и менее часа в Colab Pro+. Если Colab отключится, снова выполните ячейку с той же папкой: обучение продолжится.
- Распакуйте скачанную папку модели в папку моделей плагина. На Mac это
~/Documents/Magenta/DDSP/Models; её также можно открыть из самого плагина.
В блокноте отмечено, что хорошие результаты обычно появляются после выполнения от 30 000 до 50 000 шагов обучения. При слишком малом числе шагов звук невыразителен; слишком большое число может вызвать прерывистое звучание и сильные скачки громкости.
История и развитие: от Magenta к современным плагинам
Исследовательская лаборатория Magenta (2016-2024)
Google запустила Magenta в 2016 году как исследовательский проект с открытым кодом о машинном обучении для музыки и искусства. Проект выпустил множество инструментов генерации музыки, но к 2024 году большинство его проектов было архивировано.
Open NSynth Super (2017)
До DDSP Magenta представила Open NSynth Super, аппаратный инструмент на основе NSynth. Датасет NSynth содержит около 305 000 образцов отдельных нот от 1 006 инструментов. Устройство на Raspberry Pi и специально разработанной печатной плате позволяло исполнителям плавно переходить между звуками инструментов в реальном времени.
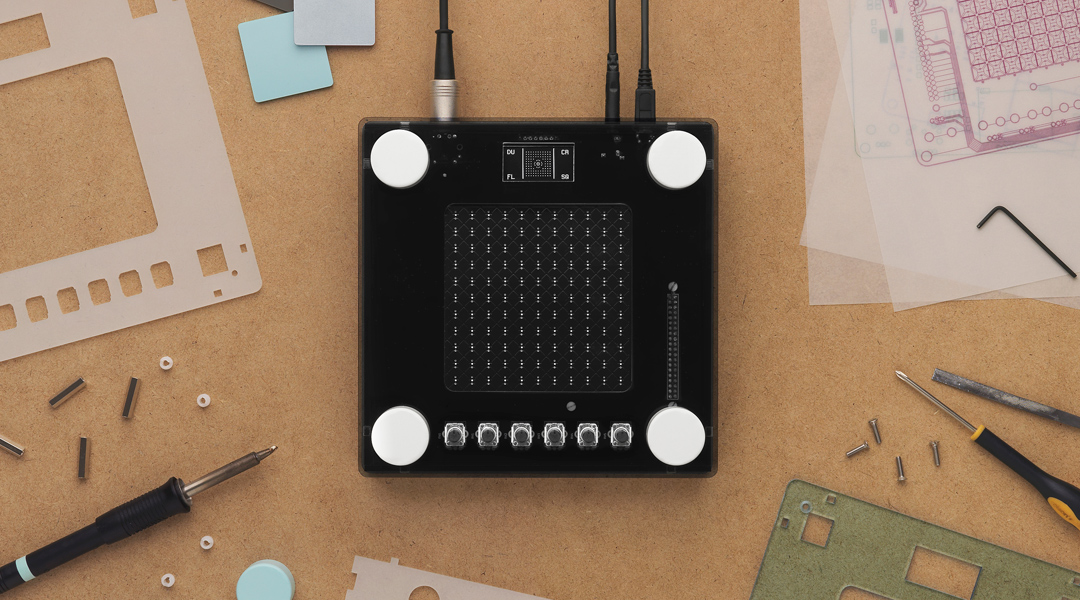
Модель NSynth, автоэнкодер в стиле WaveNet, была ограничена аудио 16 бит/16 kHz из-за вычислительной стоимости, поэтому результат заметно звучит в духе лоуфай. Аудиоинженер Joe Boston назвал звук «зернистым», но нашёл ему творческое применение, пропуская через внешние эффекты. Аппаратный проект архивировали в августе 2025 года.
DDSP и Tone Transfer (2020)
В 2020 году Magenta опубликовала библиотеку DDSP и статью ICLR, представившую дифференцируемые версии распространённых модулей обработки сигналов. Веб-демонстрация Tone Transfer позволяла превращать записи, например пение, в скрипку, саксофон, трубу или флейту.
Модели были автоэнкодерами на основе RNN, обученными примерно на 10 минутах одноголосного аудио для каждого инструмента. Демонстрация работала, но выход с частотой 16 kHz и ограниченное моделирование артикуляции сдерживали её возможности.
MIDI DDSP и VST-плагин (2022-2024)
В январе 2022 года Magenta расширила DDSP проектом MIDI DDSP. Он синтезирует аудио инструмента непосредственно из одноголосных MIDI-последовательностей. Чтобы воспроизводить MIDI через записанные сэмплы вместо нейросетевой модели, загрузите инструмент SFZ в бесплатный проигрыватель sforzando.
В июне 2022 года Magenta выпустила плагин DDSP VST для переноса тембра в реальном времени в DAW. Оба проекта архивировали в 2024 году: MIDI DDSP в феврале, VST в октябре.

Аудиоплагин MAWF (2023)
Hanoi Hantrakul (yaboihanoi), бывший технический руководитель Tone Transfer, работающий в ByteDance с 2020 года, выпустил MAWF в 2023 году. Бесплатный плагин VST/AU выполняет нейросетевой синтез аудио в реальном времени при 48 kHz, снимая ограничение в 16 kHz ранних реализаций DDSP.

Как работает DDSP? Автоэнкодеры встречаются с DSP
DDSP — автоэнкодер, декодер которого управляет модульными компонентами DSP вместо непосредственной генерации волновой формы.
Архитектура автоэнкодера DDSP
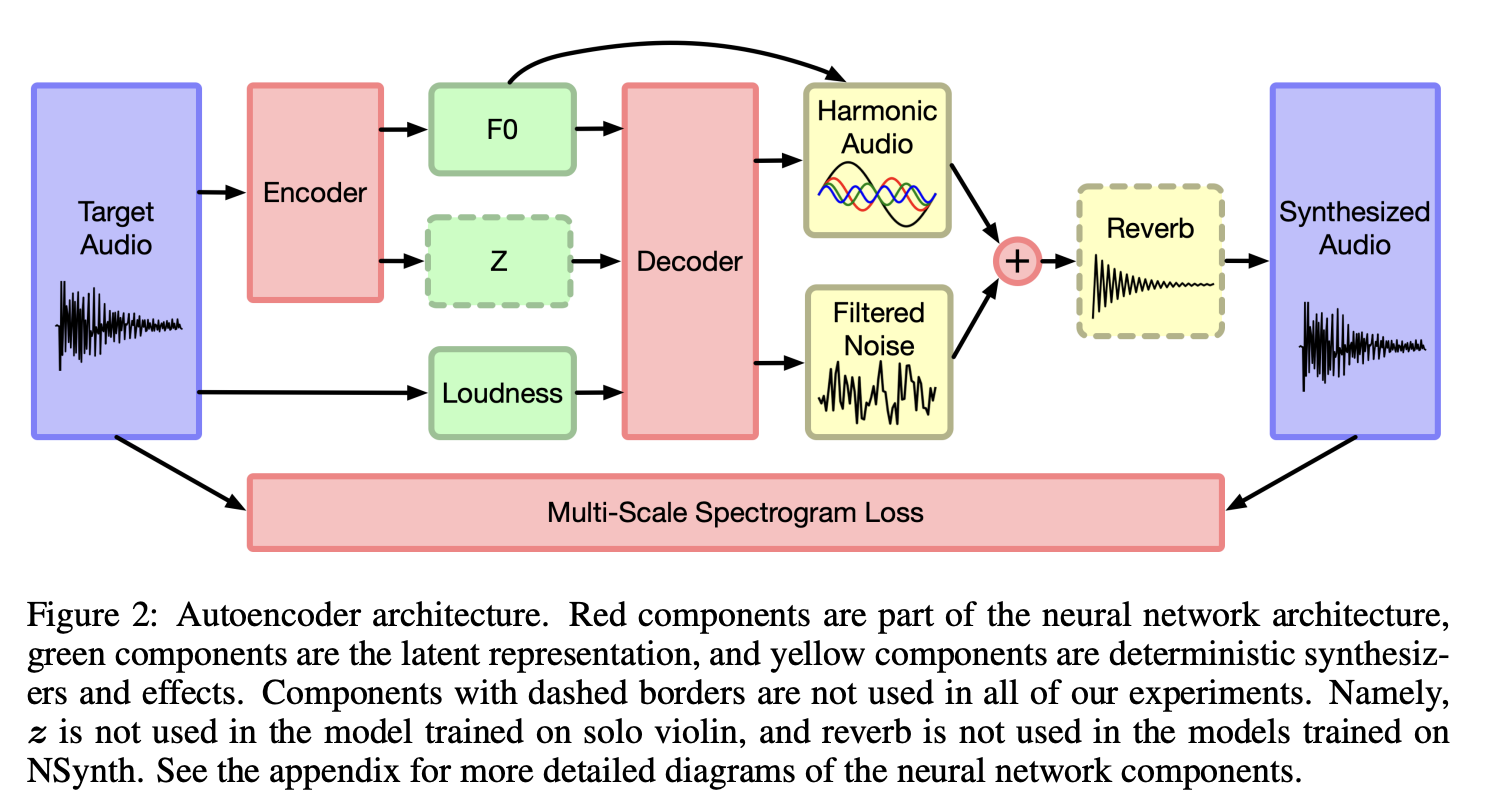
Оригинальная иллюстрация: Архитектура автоэнкодера DDSP.
Энкодер
Энкодер преобразует входящее аудио в две управляющие кривые: основную частоту (f0, высоту тона), которую оценивает предварительно обученный трекер высоты тона CREPE, и громкость, вычисляемую прямо из сигнала. Необязательный остаточный энкодер (GRU, обрабатывающий MFCC) добавляет латентный вектор для деталей тембра, которых не передают высота тона и громкость. Эти низкоразмерные сигналы описывают исполнение.
Декодер и модули синтеза
Рекуррентный декодер (GRU) отображает управляющие сигналы в параметры трёх компонентов DSP:
- Гармонический аддитивный синтезатор: генерирует до 100 синусоидальных составляющих на частотах, кратных основной, для тональной части звука.
- Синтезатор фильтрованного шума: формирует белый шум с помощью меняющихся во времени FIR-фильтров, моделируя шум дыхания и смычка.
- Дифференцируемая реверберация: добавляет акустику помещения через обучаемую импульсную характеристику.
Каждый компонент дифференцируем, поэтому вся модель обучается сквозным образом с многомасштабной спектральной функцией потерь. Она предсказывает сотни параметров синтеза на кадр, а не генерирует аудио отсчёт за отсчётом.
Обучение моделей DDSP для исследований
Для модели, которую будете использовать в DDSP VST, возьмите блокнот обучения DDSP VST, описанный выше в быстром старте. Чтобы изменить архитектуру или функцию потерь, начните с учебных материалов библиотеки в Colab. Они требуют базовых навыков Python и охватывают предобработку, настройку и обучение на GPU Colab.
Плагины DDSP для работы в реальном времени
Официальные проекты Magenta архивированы, но DDSP по-прежнему можно запускать в DAW с помощью этих инструментов:
1. Magenta DDSP VST (в архиве)
Официальный DDSP VST всё ещё работает для экспериментов (шаги установки приведены выше в быстром старте). Он включает пять моделей инструментов и принимает MIDI и аудио. Пользователи сообщают об обильной реверберации на выходе, которая, похоже, маскирует артефакты.
2. Платформа Neutone FX
Neutone FX предлагает бесплатный плагин, запускающий модели, обученные сообществом, включая сети переноса тембра на основе DDSP. Он даёт продюсерам доступ к десяткам моделей помимо исходных инструментов Magenta.

3. MAWF от yaboihanoi (рекомендуется)
Плагин MAWF выполняет синтез DDSP при 48 kHz внутри DAW. Он поставляется с несколькими моделями инструментов и является наиболее отточенной из доступных реализаций DDSP.

Однако сайт скачивания MAWF не работает с ноября 2025 года. Я обновлю статью, если найду другой источник плагина.
Какие ограничения есть у DDSP?
Ограничения DDSP обусловлены архитектурой и подходом к синтезу:
- Только одноголосное аудио: модели DDSP не могут генерировать полифоническое аудио. Они обучены на одноголосных записях, а гармонический синтезатор предполагает одну основную частоту на каждом временном шаге.
- Качество аудио: модели MAWF с 48 kHz звучат лучше, но исходные реализации с 16 kHz имеют металлические артефакты и мало высокочастотного содержимого. Модель повышения разрешения аудио может заново сформировать недостающие верхние частоты старых рендеров: смотрите как установить и запустить AudioSR из GitHub или как UniverSR восстановила звуковые эффекты RPG Maker с 22 kHz до 48 kHz.
- Ограниченное распараллеливание на GPU: рекуррентные слои обрабатывают кадры друг за другом, поэтому модель не может распараллеливать обработку во времени на GPU так, как свёрточные модели.
После DDSP: RAVE, DDSP-CNN-Tiny и AFTER
RAVE (2021)
RAVE использует каузальные CNN вместо RNN, обеспечивая более быстрое обучение и синтез при 48 kHz, а также лучшее моделирование тембра. Это вариационный автоэнкодер, доработанный с помощью состязательного обучения (дискриминатора), который достигает более высокой точности звучания при сопоставимом объёме данных.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny заменяет RNN в DDSP лёгкими CNN, уменьшая модель и ускоряя инференс. Качество аудио остаётся сопоставимым, а модель работает в реальном времени на CPU. Небольшие сети на CPU также лежат в основе бесплатных нейросетевых гитарных усилителей, таких как NAM и AIDA-X. Václav Volhejn разработал модель для своей диссертации в ETH Zurich, а его работа о DDSP в реальном времени будет полезным техническим чтением.
AFTER (2024)
Модель AFTER запускает латентную диффузию поверх нейросетевого аудиокодека, достигая синтеза студийного качества. Ей требуется больше вычислений, чем DDSP, но перенос тембра даёт гораздо меньше артефактов, поэтому она лучше подходит для профессионального продакшена.
Вопросы о DDSP
Поддерживается ли ещё Magenta DDSP?
Частично. Библиотека ddsp не архивирована и по-прежнему получает коммиты. Magenta архивировала MIDI DDSP в феврале 2024 года и DDSP VST в октябре 2024 года, поэтому плагин не обновляется. Ссылки на скачивание плагина и блокнот обучения всё ещё работали при обновлении этого руководства в октябре 2026 года.
Работает ли DDSP VST в Linux?
Официальной сборки для Linux нет. Потребуется самостоятельно собрать плагин из исходного кода.
Может ли DDSP играть аккорды?
Нет. Модели DDSP одноголосные: они следуют одной высоте тона за раз. Для управления полифоническим MIDI обратите внимание на AFTER.
DDSP или RAVE: что обучать?
Выбирайте DDSP для одного инструмента с определённой высотой тона, если у вас есть только около 10 минут аудио и бесплатный GPU Colab. Выбирайте RAVE для любых звуков, включая ударные, текстуры и голоса. RAVE нужно несколько часов аудио и дни обучения на GPU. В FAQ сравниваются объёмы обучающего аудио для DDSP, RAVE и AFTER и плагины для воспроизведения каждой обученной модели в DAW.