Panduan DDSP: Magenta DDSP VST, Pelatihan, dan Cara Kerjanya
DDSP (pemrosesan sinyal digital yang dapat didiferensiasikan) adalah pustaka open-source Google Magenta yang memungkinkan jaringan neural mengendalikan pembangkit suara klasik: osilator, derau terfilter, dan reverberasi. Magenta mengarsipkan DDSP VST pada 2024, tetapi plugin gratis ini masih dapat diunduh dan dijalankan di Windows dan macOS. Anda juga dapat melatih model instrumen sendiri dalam notebook Google Colab gratis.
Panduan ini dimulai dengan dua langkah praktis tersebut. Selanjutnya, panduan menjelaskan cara kerja DDSP, keterbatasannya, dan model lebih baru yang menggantikannya.
Cara Menggunakan DDSP Saat Ini: Memulai dengan Cepat
Unduh dan Pasang DDSP VST
- Unduh plugin untuk macOS atau Windows. Kedua tautan berasal dari repositori resmi DDSP VST.
- Ekstrak file. Isinya dua plugin: DDSP Effect, yang mengubah audio masuk (seperti suara Anda) menjadi instrumen, dan DDSP Synth, yang Anda mainkan dengan MIDI.
- Di macOS, salin ke
/Library/Audio/Plug-Ins/Components(AU) dan/Library/Audio/Plug-Ins/VST3. Di Windows, salin file VST3 keC:\Program Files\Common Files\VST3. - Pindai ulang plugin di DAW Anda.
Tidak ada build Linux resmi. Untuk mendengar DDSP tanpa memasang apa pun, coba demo web Tone Transfer.
Latih Instrumen DDSP Anda Sendiri
Notebook pelatihan DDSP VST Magenta berjalan di Google Colab, sehingga Anda tidak membutuhkan GPU lokal:
- Masukkan setidaknya 10 menit audio
.wavatau.mp3ke folder Google Drive. Gunakan audio monofonik (satu nada pada satu waktu) dari satu sesi rekaman, dengan mikrofon dan ruangan yang sama. - Buka notebook, jalankan sel pemasangan (sekitar 5 menit), lalu jalankan sel pelatihan dan pilih folder Anda.
- Tunggu. Pelatihan membutuhkan sekitar 2 hingga 3 jam di Colab gratis dan kurang dari satu jam di Colab Pro+. Jika Colab terputus, jalankan sel lagi dengan folder yang sama dan pelatihan dilanjutkan.
- Ekstrak folder model yang diunduh ke folder model plugin. Di Mac, lokasinya
~/Documents/Magenta/DDSP/Models, dan Anda juga dapat membukanya dari dalam plugin.
Notebook menyebutkan bahwa hasil yang baik biasanya muncul setelah 30.000 hingga 50.000 langkah pelatihan. Terlalu sedikit langkah terdengar hambar; terlalu banyak dapat menyebabkan suara tersendat dan lonjakan volume besar.
Sejarah dan Perkembangan: Dari Magenta ke Plugin Modern
Laboratorium Riset Magenta (2016-2024)
Magenta Google diluncurkan pada 2016 sebagai proyek riset open-source tentang pembelajaran mesin untuk musik dan seni. Proyek ini merilis banyak alat pembangkit musik, tetapi sebagian besar proyeknya sudah diarsipkan pada 2024.
Open NSynth Super (2017)
Sebelum DDSP, Magenta memperkenalkan Open NSynth Super, instrumen perangkat keras berbasis NSynth. Dataset NSynth berisi sekitar 305.000 sampel nada tunggal dari 1.006 instrumen. Perangkat ini dibangun dengan Raspberry Pi dan PCB khusus, serta memungkinkan pemain beralih secara mulus di antara suara instrumen secara real time.
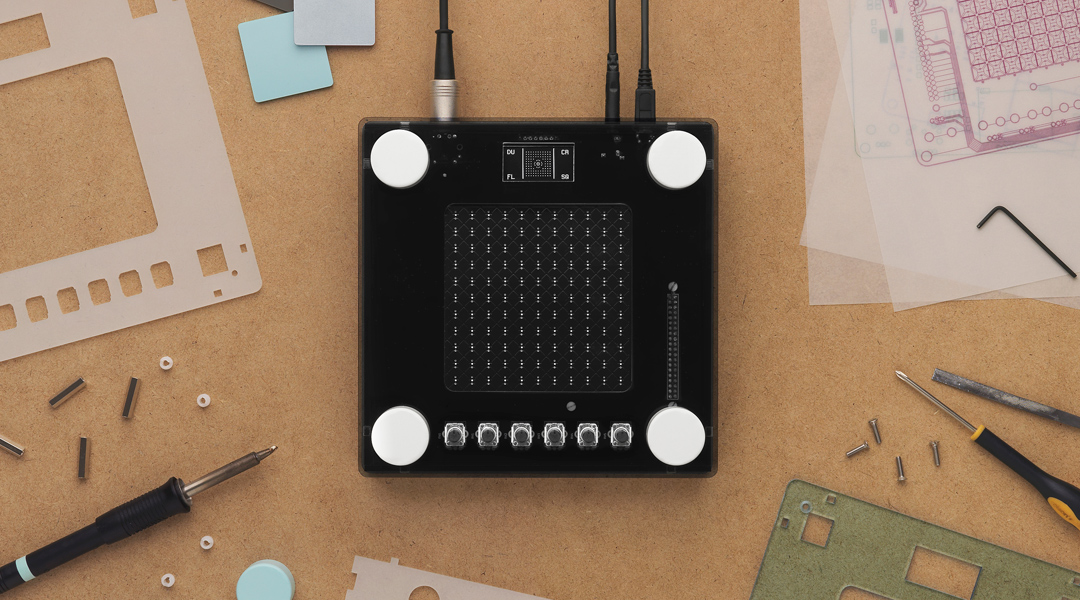
Model NSynth, autoencoder bergaya WaveNet, terbatas pada audio 16-bit/16 kHz karena biaya komputasinya, sehingga output terdengar jelas lo-fi. Teknisi audio Joe Boston menggambarkannya sebagai “bertekstur kasar”, tetapi menemukan penggunaan kreatif dengan memprosesnya melalui efek eksternal. Proyek perangkat keras ini diarsipkan pada Agustus 2025.
DDSP dan Tone Transfer (2020)
Pada 2020, Magenta menerbitkan pustaka DDSP dan makalah ICLR, yang memperkenalkan versi yang dapat didiferensiasikan dari modul pemrosesan sinyal umum. Demo web Tone Transfer memungkinkan pengguna mengubah rekaman, seperti nyanyian, menjadi biola, saksofon, trompet, atau seruling.
Modelnya berupa autoencoder berbasis RNN yang dilatih dengan sekitar 10 menit audio monofonik per instrumen. Demo tersebut berfungsi, tetapi output 16 kHz dan pemodelan artikulasi terbatas menahan kemampuannya.
MIDI DDSP dan Plugin VST (2022-2024)
Magenta memperluas DDSP dengan MIDI DDSP pada Januari 2022. Model ini menyintesis audio instrumen langsung dari rangkaian MIDI monofonik. Untuk memainkan MIDI melalui sampel rekaman alih-alih model neural, muat instrumen SFZ di pemutar sforzando gratis.
Pada Juni 2022, Magenta merilis plugin DDSP VST untuk transfer timbre real time di DAW. Kedua proyek diarsipkan pada 2024: MIDI DDSP pada Februari, dan VST pada Oktober.

Plugin Audio MAWF (2023)
Hanoi Hantrakul (yaboihanoi), mantan pemimpin teknis Tone Transfer yang bekerja di ByteDance sejak 2020, meluncurkan MAWF pada 2023. Plugin VST/AU gratis ini menjalankan sintesis audio neural real time pada 48 kHz, menghilangkan batas 16 kHz pada implementasi DDSP terdahulu.

Bagaimana DDSP Bekerja? Autoencoder Bertemu DSP
DDSP adalah autoencoder yang decodernya menggerakkan komponen DSP modular alih-alih menghasilkan bentuk gelombang secara langsung.
Arsitektur autoencoder DDSP
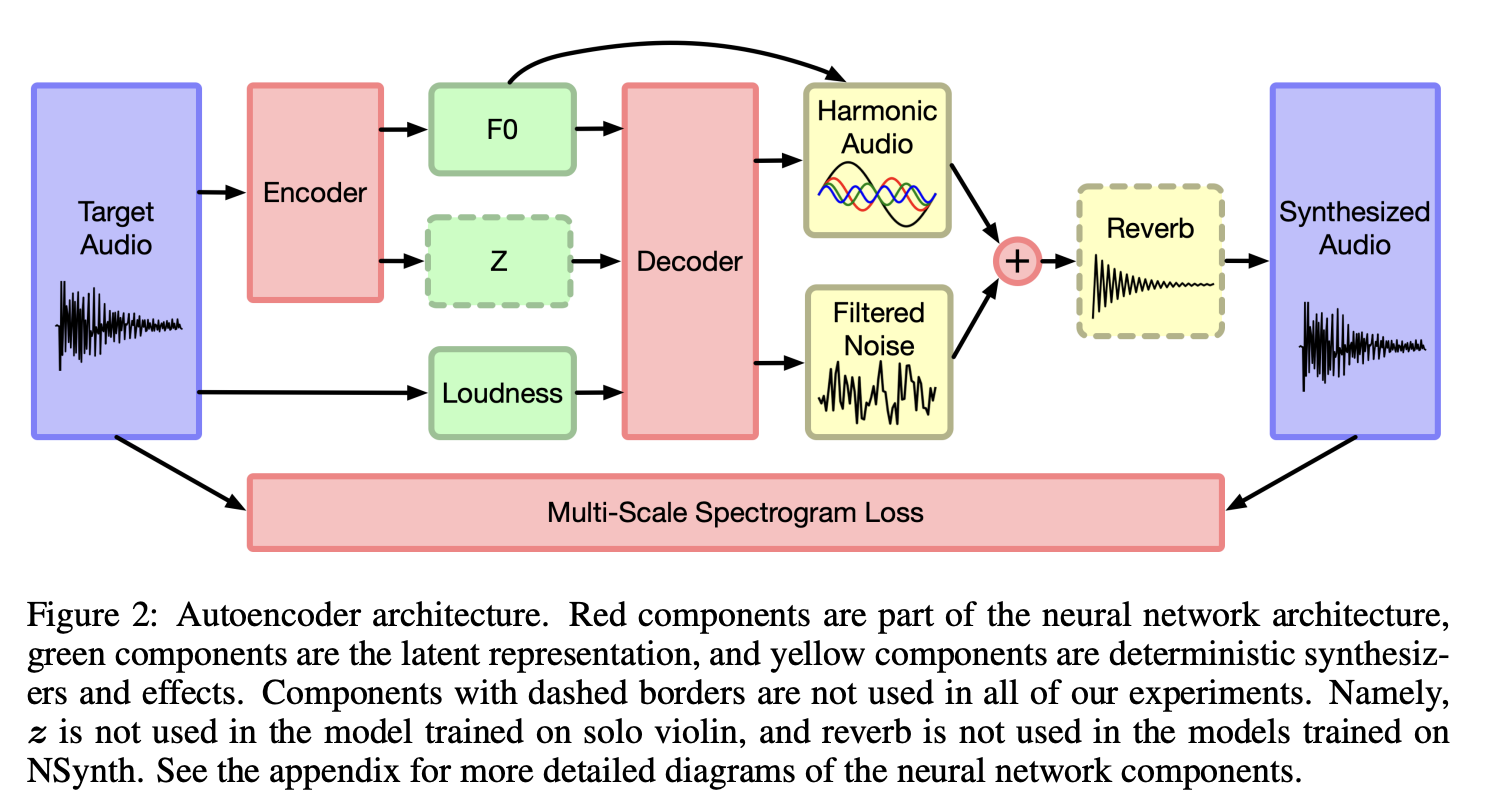
Diagram asli: Arsitektur autoencoder DDSP.
Encoder
Encoder mengubah audio input menjadi dua kurva kendali: frekuensi dasar (f0, tinggi nada), yang diperkirakan dengan pelacak tinggi nada CREPE pralatih, dan kenyaringan, yang dihitung langsung dari sinyal. Encoder residual opsional (GRU yang memproses MFCC) menambahkan vektor laten untuk detail timbre yang tidak ditangkap oleh tinggi nada dan kenyaringan. Sinyal berdimensi rendah ini menggambarkan penampilan musik.
Decoder dan Modul Sintesis
Decoder rekuren (GRU) memetakan sinyal kendali ke parameter tiga komponen DSP:
- Penyintesis aditif harmonik: menghasilkan hingga 100 parsial sinusoidal pada kelipatan frekuensi dasar untuk bagian suara bernada.
- Penyintesis derau terfilter: membentuk derau putih dengan filter FIR yang berubah sepanjang waktu untuk memodelkan derau napas dan penggesek.
- Reverberasi yang dapat didiferensiasikan: menambahkan akustik ruangan melalui respons impuls yang dipelajari.
Setiap komponen dapat didiferensiasikan, sehingga seluruh model dilatih dari awal hingga akhir dengan loss spektral multiskala. Model memprediksi ratusan parameter sintesis per frame alih-alih menghasilkan audio sampel demi sampel.
Melatih Model DDSP untuk Riset
Untuk model yang akan Anda mainkan di DDSP VST, gunakan notebook pelatihan DDSP VST yang dijelaskan pada bagian memulai dengan cepat di atas. Untuk mengubah arsitektur atau loss, mulai dari tutorial Colab pustaka ini. Tutorial membutuhkan keterampilan Python dasar dan membahas prapemrosesan, konfigurasi, serta pelatihan pada GPU Colab.
Plugin DDSP untuk Penggunaan Real Time
Proyek resmi Magenta diarsipkan, tetapi Anda masih dapat menjalankan DDSP dalam DAW dengan alat berikut:
1. Magenta DDSP VST (Diarsipkan)
DDSP VST resmi masih berfungsi untuk eksperimen (lihat langkah pemasangan pada bagian memulai dengan cepat di atas). Plugin ini menyertakan lima model instrumen dan menerima input MIDI maupun audio. Pengguna melaporkan reverberasi berat pada output, yang tampaknya menyamarkan artefak.
2. Platform Neutone FX
Neutone FX menawarkan plugin gratis yang menjalankan model hasil pelatihan komunitas, termasuk jaringan transfer timbre berbasis DDSP. Plugin ini memberi produser akses ke puluhan model di luar instrumen Magenta asli.

3. MAWF oleh yaboihanoi (Direkomendasikan)
Plugin MAWF menjalankan sintesis DDSP pada 48 kHz di dalam DAW Anda. Plugin ini dilengkapi beberapa model instrumen dan merupakan implementasi DDSP paling matang yang tersedia.

Namun, situs unduhan MAWF tidak dapat diakses sejak November 2025. Saya akan memperbarui artikel ini jika menemukan sumber lain untuk plugin tersebut.
Apa Keterbatasan DDSP?
Batas DDSP berasal dari arsitektur dan pendekatan sintesisnya:
- Hanya monofonik: model DDSP tidak dapat menghasilkan audio polifonik. Model dilatih dengan rekaman monofonik, dan penyintesis harmonik mengasumsikan satu frekuensi dasar pada setiap langkah waktu.
- Kualitas audio: model 48 kHz MAWF terdengar lebih baik, tetapi implementasi 16 kHz asli memiliki artefak metalik dan sedikit konten frekuensi tinggi. Model super-resolusi audio dapat membangun ulang frekuensi tinggi yang hilang pada hasil render lama: lihat cara memasang dan menjalankan AudioSR dari GitHub, atau bagaimana UniverSR memulihkan efek suara RPG Maker 22 kHz menjadi 48 kHz.
- Paralelisme GPU terbatas: lapisan rekuren memproses frame satu demi satu, sehingga model tidak dapat memparalelkan pemrosesan sepanjang waktu pada GPU seperti model konvolusional.
Melampaui DDSP: RAVE, DDSP-CNN-Tiny, dan AFTER
RAVE (2021)
RAVE menggunakan CNN kausal alih-alih RNN, sehingga memberikan pelatihan lebih cepat dan sintesis 48 kHz serta pemodelan timbre lebih baik. RAVE adalah autoencoder variasional yang disempurnakan dengan pelatihan adversarial (diskriminator), dan mencapai fidelitas lebih tinggi dari jumlah data yang serupa.
DDSP-CNN-Tiny (2022)
DDSP-CNN-Tiny mengganti RNN DDSP dengan CNN ringan, sehingga model lebih kecil dan inferensi lebih cepat. Kualitas audio tetap sebanding, dan model berjalan real time pada CPU. Jaringan kecil yang berjalan pada CPU juga merupakan cara kerja plugin ampli gitar neural gratis seperti NAM dan AIDA-X. Václav Volhejn mengembangkannya untuk tesis di ETH Zurich, dan tesisnya tentang DDSP real time merupakan bacaan teknis yang bermanfaat.
AFTER (2024)
Model AFTER menjalankan difusi laten di atas codec audio neural untuk mencapai sintesis berkualitas studio. Komputasinya lebih berat daripada DDSP, tetapi transfer timbrenya menghasilkan jauh lebih sedikit artefak, sehingga lebih cocok untuk produksi profesional.
Pertanyaan Umum tentang DDSP
Apakah Magenta DDSP masih dipelihara?
Sebagian. Pustaka ddsp tidak diarsipkan dan masih menerima commit. Magenta mengarsipkan MIDI DDSP pada Februari 2024 dan DDSP VST pada Oktober 2024, sehingga plugin tidak mendapat pembaruan. Unduhan plugin dan notebook pelatihan masih berfungsi ketika panduan ini diperbarui pada Oktober 2026.
Apakah DDSP VST bekerja di Linux?
Tidak ada build Linux resmi. Anda perlu membangunnya sendiri dari kode sumber.
Bisakah DDSP memainkan akor?
Tidak. Model DDSP monofonik: mengikuti satu tinggi nada pada satu waktu. Untuk kendali MIDI polifonik, lihat AFTER.
DDSP atau RAVE: mana yang sebaiknya saya latih?
Pilih DDSP untuk satu instrumen bernada ketika Anda hanya memiliki sekitar 10 menit audio dan GPU Colab gratis. Pilih RAVE untuk segala jenis suara, termasuk drum, tekstur, dan vokal. RAVE membutuhkan beberapa jam audio dan pelatihan GPU selama berhari-hari. FAQ membandingkan jumlah audio pelatihan yang dibutuhkan DDSP, RAVE, dan AFTER serta plugin yang memainkan setiap model terlatih di DAW Anda.