Model RAVE dari IRCAM: VST, Model Pralatih, dan Pelatihan
Model RAVE dari IRCAM merupakan model audio berbasis jaringan saraf waktu nyata yang mengubah suara apa pun menjadi warna suara yang dipelajarinya saat pelatihan. Anda bisa menggunakan model RAVE pralatih di DAW dengan Neutone FX atau RAVE VST, memuatnya di Max/MSP atau Pure Data dengan nn~, atau melatih model sendiri dengan paket Python acids-rave.
Cara Menggunakan RAVE: Mulai Cepat
| Tujuan | Alat | Yang Anda perlukan |
|---|---|---|
| Menjalankan model RAVE di DAW | Neutone FX (VST/AU gratis) | DAW apa pun. Model pralatih diunduh dari dalam plugin. |
| Menjalankan model RAVE di DAW | RAVE VST (beta) | Unduhan dari IRCAM Forum. Repositori sumber diarsipkan pada Juni 2023, dan versi Windows hanya berupa aplikasi mandiri. |
| Menggunakan RAVE di Max/MSP atau Pure Data | Modul eksternal nn~ | Max atau Pd, serta file model .ts |
| Mengunduh model pralatih | Daftar model RAVE resmi | Ekspor .ts streaming untuk nn~ |
| Melatih model sendiri | acids-rave di Python | GPU NVIDIA dengan memori 5 hingga 32 GB, beberapa jam audio, dan sekitar 3 hari |
Untuk menginstal nn~, unduh rilis terbaru lalu ekstrak ke Documents/Max [your version]/Packages/ untuk Max, atau Documents/Pd/externals/ untuk Pure Data. Letakkan model .ts Anda di folder nn_tilde/models.

Apa Itu IRCAM RAVE untuk Sintesis Audio Waktu Nyata?
RAVE merupakan singkatan Realtime Audio Variational autoEncoder, atau autoencoder variasional audio waktu nyata. Dirilis pada akhir 2021 oleh peneliti IRCAM di Paris, model ini belajar mengodekan suara menjadi representasi ringkas lalu mendekodenya kembali menjadi audio. Bayangkan mengajari komputer membuat sketsa dari apa yang didengarnya, lalu menggambar ulang sketsa itu sebagai tiruan suara asli yang meyakinkan.
Prosesnya cukup cepat untuk berjalan secara waktu nyata di DAW atau perangkat pertunjukan langsung Anda.
Siapa yang Membuat RAVE dan Kapan?
RAVE dikembangkan oleh Antoine Caillon, yang kini bekerja di Google DeepMind, dan Philippe Esling dari tim ACIDS IRCAM di Paris.
Tim tersebut sebelumnya mengeksplorasi model DDSP Google (pemrosesan sinyal digital yang dapat didiferensiasikan), dan mendemonstrasikannya pada Maret 2021. Namun, mereka menginginkan model lebih fleksibel yang bisa menangani semua jenis suara, bukan hanya alat musik.
Tujuannya adalah model yang berjalan pada perangkat keras biasa dengan audio berkualitas studio. Mereka memperkenalkannya dalam makalah 2021, RAVE: Autoencoder variasional untuk sintesis audio berbasis jaringan saraf yang cepat dan berkualitas tinggi.
Arsitektur RAVE: Cara Kerja Autoencoder Variasional Ini
RAVE adalah autoencoder: jaringan saraf yang belajar memampatkan data menjadi “ruang laten” yang ringkas, lalu mendekompresinya kembali.
RAVE: pelatihan dua tahap
Tahap 1: Pembelajaran representasi
Tahap 2: Penyempurnaan adversarial
Diagram pelatihan diadaptasi dari makalah RAVE asli. Tahap 1 melatih enkoder dan dekoder dengan fungsi kerugian spektral multipita. Tahap 2 membekukan enkoder, menghentikan aliran gradien melalui kode laten, lalu melatih dekoder dan diskriminator. Analisis dan sintesis PQMF tetap.
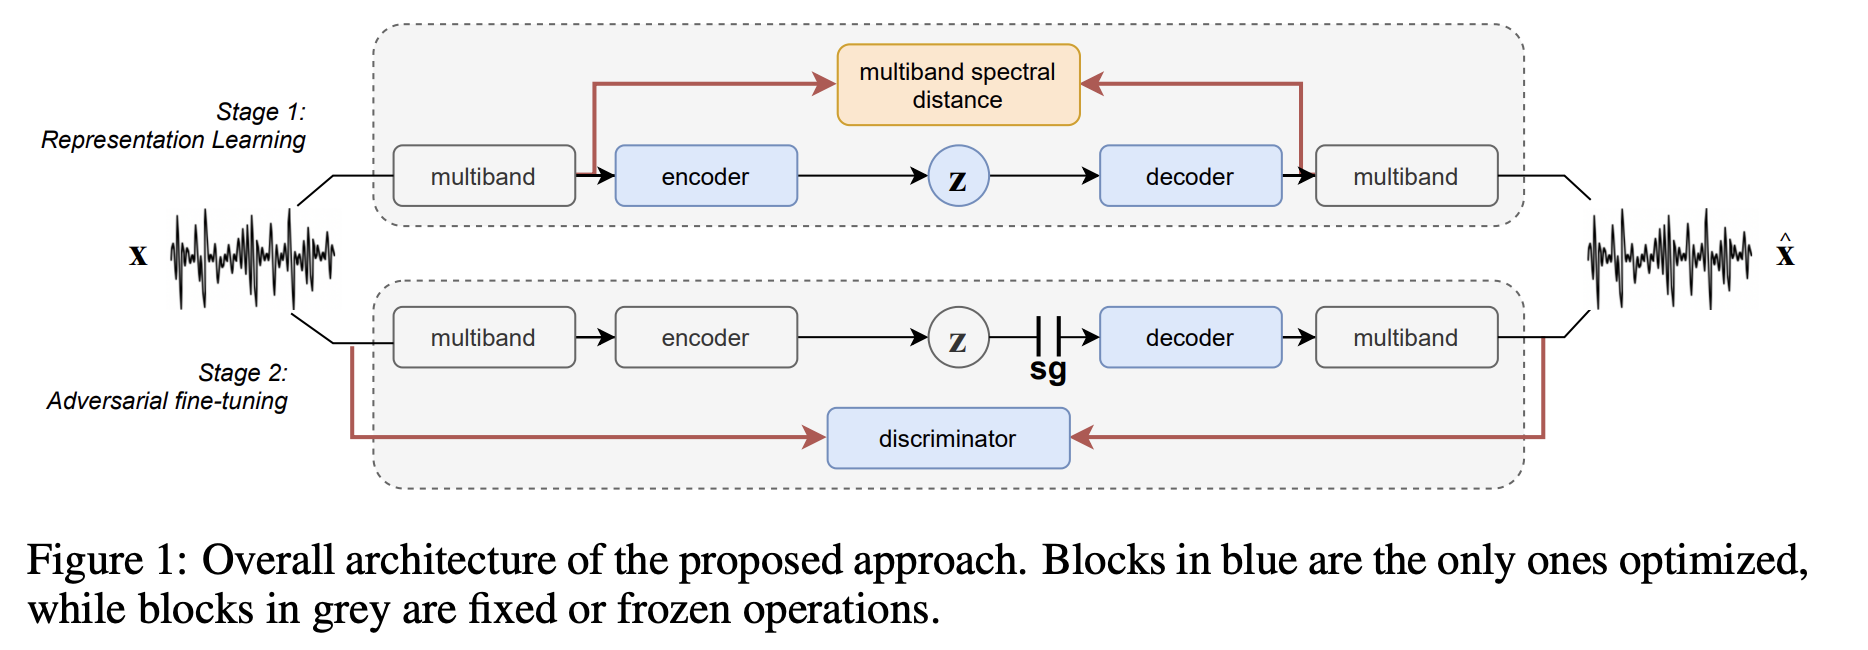
Diagram asli: RAVE: pelatihan dua tahap.
Cara Kerja Pelatihan RAVE dalam Dua Tahap
Bayangkan melatih musisi dalam dua tahap:
-
Tahap 1: Belajar Mendengarkan (Pembelajaran Representasi)
- Enkoder belajar memampatkan audio menjadi sekumpulan angka ringkas (ruang laten)
- Dekoder belajar merekonstruksi audio dari angka tersebut
- Pelatihan memakai fungsi kerugian spektral yang membandingkan kandungan frekuensi audio asli dan hasil rekonstruksi
-
Tahap 2: Belajar Berimprovisasi (Penyempurnaan Adversarial)
- Enkoder dibekukan karena sudah tahu cara mendengarkan
- Jaringan “diskriminator” ditambahkan: penilai yang memutuskan apakah audio rekonstruksi terdengar nyata
- Dekoder belajar dari umpan balik ini untuk menghasilkan audio yang lebih meyakinkan
Komponen Teknis Utama
- Filter PQMF: RAVE memisahkan audio menjadi beberapa subpita frekuensi sebelum pemrosesan agar lebih efisien
- Mode kausal dan nonkausal: mode kausal mengorbankan sebagian kualitas untuk latensi lebih rendah pada penggunaan langsung
- Beragam konfigurasi: dari “raspberry” yang ringan (berjalan pada Raspberry Pi) hingga “v3” berkualitas tinggi
Untuk detail implementasi, lihat repositori GitHub RAVE resmi, yang memuat file konfigurasi dan definisi model.

Cara Melatih Model RAVE dengan Data Audio Sendiri
Ingin model yang mengubah suara Anda menjadi saksofon? Pelatihan model RAVE membutuhkan pengetahuan Python dan GPU. Repositori RAVE resmi mendokumentasikan seluruh prosesnya.
Persyaratan Penyiapan Dataset
Untuk melatih model RAVE, Anda memerlukan:
- 2 hingga 3 jam audio bersih (lebih banyak lebih baik)
- Rekaman berkualitas studio, karena RAVE mempelajari semuanya, termasuk derau dan reverb
- Suara yang beragam jika Anda ingin model serbaguna
Untuk membuat dataset dari campuran musik lengkap, isolasi instrumennya terlebih dahulu dengan pemisahan stem AI berkualitas tinggi. Artefak pemisahan juga masuk ke model, jadi gunakan stem paling bersih yang bisa Anda dapatkan. Panduan pemisahan stem menjelaskan caranya di Neural Analog.
Instal RAVE dan Siapkan Dataset Anda
Instal PyTorch dan TorchAudio untuk GPU Anda terlebih dahulu, lalu RAVE. Anda juga membutuhkan FFmpeg; dalam lingkungan conda, instal dengan conda:
pip install acids-rave
conda install ffmpeg
Prapemrosesan mengonversi file audio Anda menjadi format dataset RAVE:
rave preprocess --input_path /audio/folder --output_path /dataset/path --channels 1Gunakan --channels 1 untuk mono atau --channels 2 untuk stereo. Tambahkan --lazy agar pelatihan langsung memakai file terkompresi seperti MP3, tetapi bersiaplah menghadapi beban CPU yang jauh lebih tinggi selama pelatihan. Untuk semua parameter, lihat dokumentasi penyiapan dataset RAVE.
Proses Pelatihan dan Konfigurasi RAVE
Mulai pelatihan dengan nama konfigurasi:
rave train --config v2 --db_path /dataset/path --out_path /model/out --name my_model --channels 1Pilih konfigurasi yang sesuai dengan GPU Anda. Memori GPU minimum berikut berasal dari README resmi:
| Konfigurasi | Memori GPU min. | Kegunaan |
|---|---|---|
raspberry | 5 GB | Model ringan untuk waktu nyata pada Raspberry Pi 4 |
onnx | 6 GB | Konfigurasi v1 tanpa derau untuk ekspor ONNX |
v1 | 8 GB | Model kontinu asli |
v2_small | 8 GB | Transfer warna suara untuk suara stasioner |
v2 | 16 GB | Model kontinu yang diperbaiki dan pilihan awal yang baik |
discrete | 18 GB | Model diskret seperti SoundStream atau EnCodec |
v3 | 32 GB | Kualitas tertinggi, dengan transfer gaya (AdaIN) |
Anda bisa menggabungkan konfigurasi dengan opsi seperti causal (latensi lebih rendah) atau noise. Notebook Colab komunitas untuk RAVEv2, yang ditautkan dari README, melatih model pada GPU Google jika Anda tidak memiliki GPU.
Yang dapat diharapkan selama pelatihan:
- Tahap 1 (~1 juta langkah): Kualitas audio awalnya kasar dan membaik secara bertahap
- Tahap 2 (pelatihan adversarial): Kualitas membaik dengan cepat
- Waktu total: sekitar 3 hari pada GPU RTX 3080
Notebook pelatihan RAVE sumbangan komunitas memandu prosesnya langkah demi langkah.
Mengekspor Model RAVE untuk Penggunaan Waktu Nyata
Ekspor penting untuk penggunaan waktu nyata. Gunakan flag --streaming untuk mengaktifkan konvolusi yang menggunakan cache, sehingga mencegah artefak bunyi klik:
rave export --run /path/to/your/run --streamingHasilnya adalah file TorchScript .ts yang bisa dimuat oleh nn~. Untuk parameter ekspor dan pemecahan masalah, lihat dokumentasi ekspor RAVE.
Inferensi Model RAVE dan Pilihan Penggunaan Waktu Nyata
Tidak ingin menunggu 3 hari untuk pelatihan? Anda bisa mencoba model RAVE pralatih di beberapa alat. Alat tersebut juga memuat model yang Anda latih sendiri. Jawaban tentang menggunakan model terlatih di DAW mencantumkan plugin untuk setiap jenis model.
Neutone FX: Plugin VST/AU Gratis untuk Model RAVE
Neutone FX adalah plugin VST/AU gratis yang menjalankan model RAVE. Ini plugin Neutone asli dari 2022, yang kini dipelihara sebagai platform terbuka. Instal untuk memuat koleksi model pralatih langsung di DAW Anda (Ableton, Logic, Reaper, dan lainnya).

RAVE VST dari IRCAM (Beta, Diarsipkan)
IRCAM juga merilis RAVE VST, dengan versi VST, AU, dan aplikasi mandiri. Ada dua mode: reconstruction (rekonstruksi), yang memproses audio dari DAW, dan prior, yang menghasilkan suara dengan bergerak sendiri melalui ruang laten. Model Explorer mengunduh model pralatih, dan Anda bisa mengimpor model sendiri jika mengekspornya dengan --stereo true.
Repositori rave_vst diarsipkan pada Juni 2023, jadi jangan mengharapkan perbaikan. Pada Windows, hanya tersedia versi mandiri eksperimental, dan pengguna Mac M1 harus membangunnya sendiri. Pengembang menyarankan nn~ untuk penggunaan waktu nyata.
Integrasi Max/MSP dan Pure Data dengan nn~
Untuk pertunjukan langsung, modul eksternal nn~ memuat model RAVE langsung di Max/MSP dan Pure Data. Modul ini memungkinkan manipulasi ruang laten secara langsung dan normalisasi instans adaptif (Adaptive Instance Normalization) untuk transfer gaya. Modul tersebut juga berjalan pada platform tertanam seperti Raspberry Pi untuk instalasi portabel. Papan yang sama menjalankan plugin amplifier gitar berbasis jaringan saraf seperti ToobAmp dan Stompbox. Jika papan Anda NVIDIA Jetson Nano, perhatikan bahwa papan ini tidak memiliki output audio analog: tambahkan kartu suara I2S seperti Raspiaudio Audio+ terlebih dahulu.
Batasan Performa dan Hal Teknis yang Perlu Diperhatikan pada RAVE
Pahami batasan ini sebelum mengandalkan RAVE:
- Latensi: Bahkan dalam mode kausal, bersiaplah menghadapi jeda yang terasa, termasuk pada Apple Silicon kelas atas. Itu tidak masalah di studio, tetapi uji dengan cermat sebelum memakai RAVE sebagai instrumen dalam pertunjukan langsung.
- Akselerasi GPU: Model memakai banyak konvolusi kecil yang kinerjanya dibatasi akses memori, bukan komputasi, sehingga tidak terparalelisasi dengan baik. Untuk penggunaan waktu nyata, beban tambahan GPU sering lebih besar daripada manfaatnya, kecuali saat memproses secara berkelompok.
- Kualitas audio: RAVE dapat terdengar mengesankan, tetapi ketepatan reproduksi suaranya mungkin tidak menyamai sintesis tradisional atau model jaringan saraf yang lebih canggih seperti model difusi.
- Sulit dilatih: Melatih model RAVE membutuhkan keahlian pembelajaran mesin dan pemrosesan audio, serta perangkat keras yang kuat.
Kelanjutan RAVE: Neutone Morpho dan Model AFTER
Neutone Morpho: Evolusi Komersial RAVE (2024)
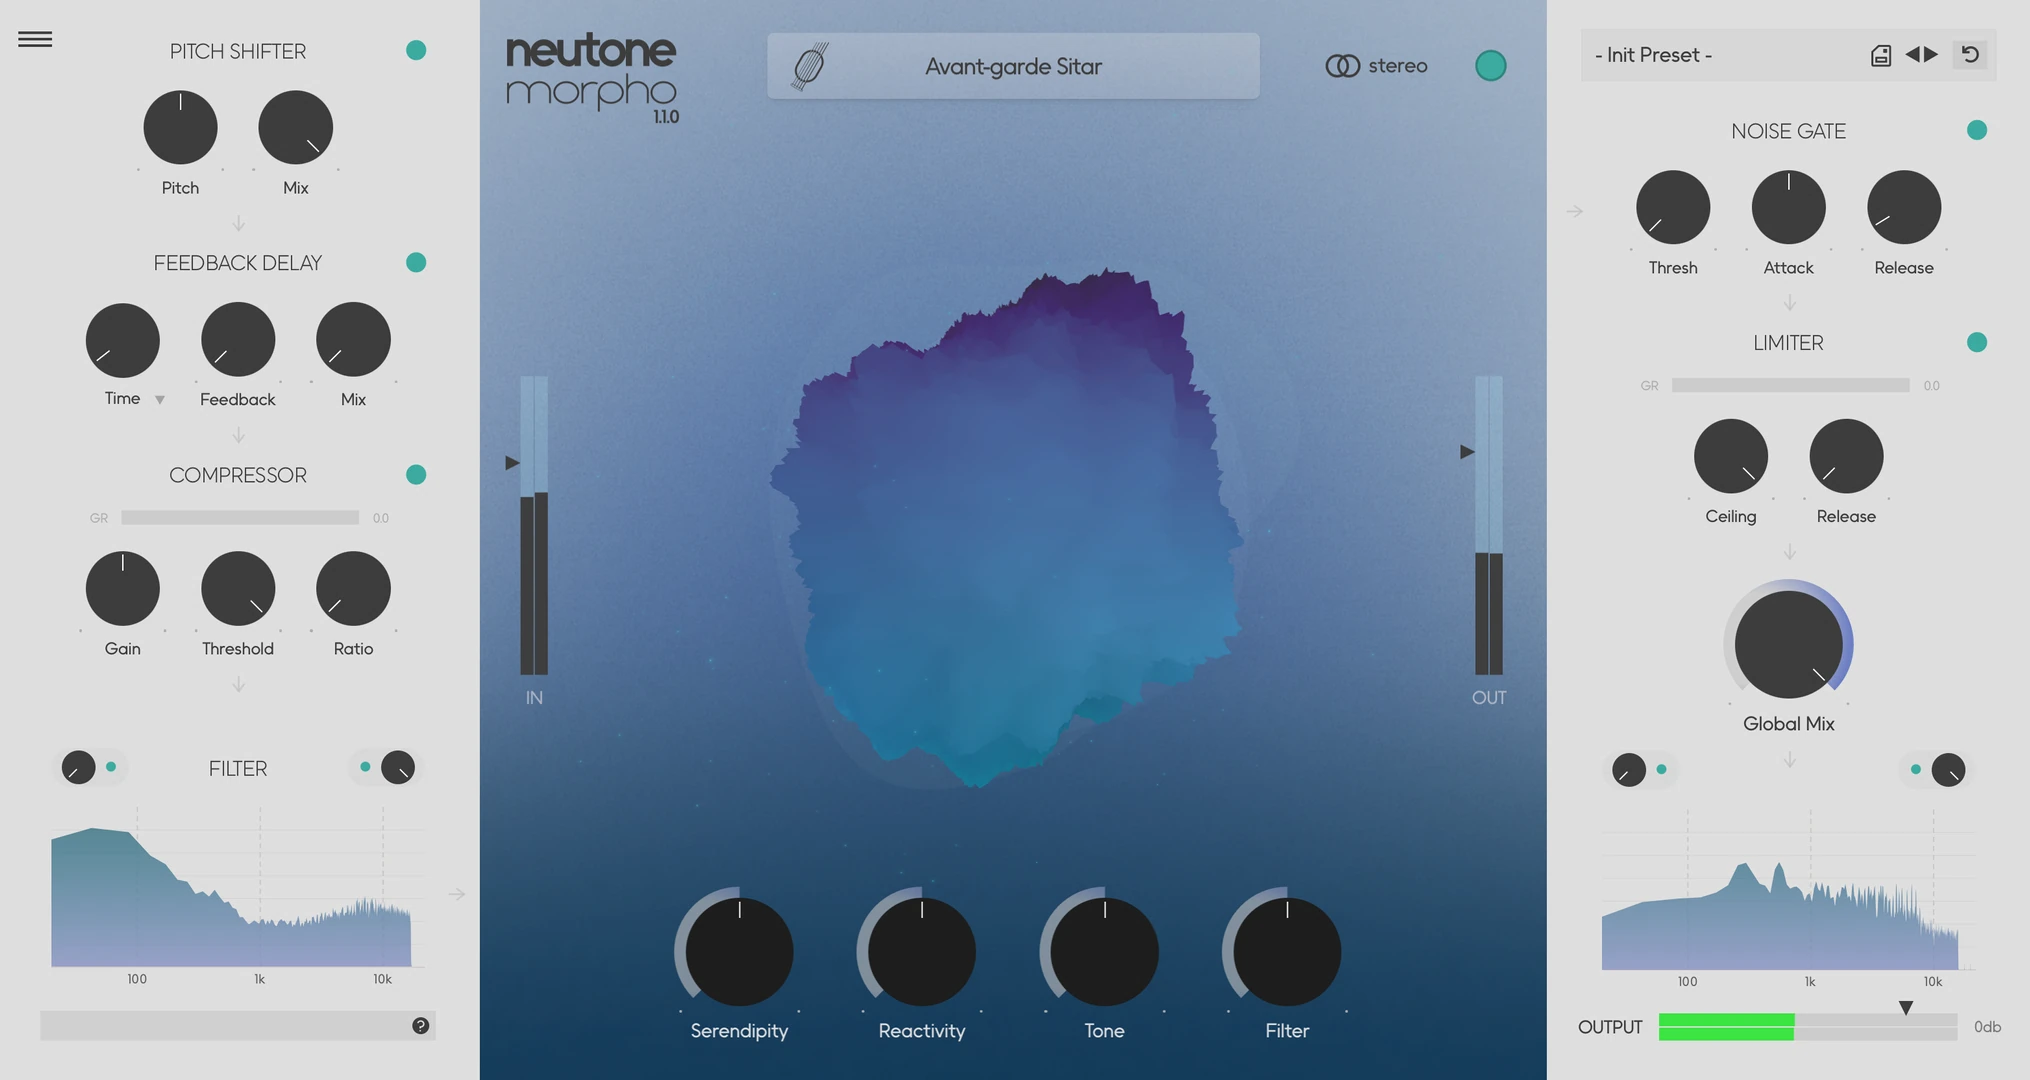
Pada Februari 2024, tim Neutone yang dipimpin Nao Tokui merilis Morpho, penerus komersial plugin FX gratis mereka. RAVE adalah mesin riset sumber terbuka. Morpho mengemas teknologi sejenis menjadi produk matang untuk musisi dan produser, dengan fleksibilitas yang lebih terbatas.
Model AFTER: Alternatif Berbasis Difusi dari IRCAM
Tim ACIDS IRCAM yang sama juga merilis AFTER (Audio Features Transfer and Exploration in Real-time), model berbasis difusi. Tujuannya agar lebih mudah disesuaikan, dengan kontrol warna suara secara waktu nyata seperti penyintesis tradisional.
Untuk mengubah gaya seluruh lagu lewat prompt teks, bukan satu suara, remix AI mempertahankan stem vokal dan menghasilkan ulang instrumental dengan Stable Audio 3.
Pertanyaan Umum tentang RAVE
Di Mana Saya Bisa Mengunduh Model RAVE Pralatih?
IRCAM mencantumkan model streaming pada halaman model RAVE resmi. Neutone FX dan RAVE VST juga bisa mengunduh model dari dalam plugin. Periksa lisensi setiap model sebelum memakainya dalam rilis komersial.
Berapa Banyak Audio yang Dibutuhkan untuk Melatih RAVE?
Siapkan 2 hingga 3 jam audio bersih dari satu sumber. RAVE mempelajari semuanya dalam rekaman, termasuk derau dan reverb ruangan. Untuk angka DDSP dan AFTER, lihat berapa banyak data yang diperlukan untuk melatih model.
Bisakah Saya Melatih RAVE di Mac?
Mac kurang cocok. Panduan RAVE dari UAL Creative Computing Institute meminta GPU NVIDIA yang mendukung CUDA dengan memori setidaknya 8 GB dan tidak menyarankan macOS. Gunakan GPU cloud atau notebook Colab komunitas.
Mengapa Model RAVE Saya Berbunyi Klik di Max?
Model diekspor tanpa --streaming. Ekspor ulang dengan flag tersebut.
RAVE atau DDSP?
DDSP hanya membutuhkan sekitar 10 menit audio, tetapi hanya memodelkan instrumen bernada monofonik. RAVE menangani suara apa pun, termasuk drum, suara manusia, dan tekstur, tetapi membutuhkan berjam-jam audio dan berhari-hari pelatihan.